PyODPS est le kit de développement logiciel (SDK) MaxCompute pour Python. Il offre une interface de programmation simple permettant d'écrire des tâches MaxCompute, d'interroger des tables et des vues, et de gérer des ressources à l'aide de Python. PyODPS propose des fonctionnalités similaires à l'interface de ligne de commande ODPS, telles que le chargement et le téléchargement de fichiers, la création de tables et l'exécution de requêtes SQL ODPS. Il inclut également des fonctionnalités avancées, comme la soumission de tâches MapReduce et l'utilisation de fonctions définies par l'utilisateur (UDF) MaxCompute. Cette rubrique décrit les scénarios d'utilisation, les outils pris en charge et les points importants à considérer lors de l'utilisation de PyODPS.
Introduction aux fonctionnalités
PyODPS est utilisé dans les scénarios suivants :
Outils pris en charge
PyODPS s'exécute dans les environnements locaux, DataWorks et PAI Notebooks.
Quel que soit l'outil utilisé, évitez de télécharger l'intégralité des données sur votre machine locale pour exécuter des tâches PyODPS. Cette approche peut consommer une grande quantité de mémoire et provoquer une erreur d'épuisement de la mémoire (OOM). Soumettez plutôt les tâches à MaxCompute pour une exécution distribuée. Pour une comparaison, consultez la section Remarques : ne pas télécharger l'intégralité des données sur une machine locale et exécuter PyODPS.
Environnement local : vous pouvez installer et utiliser PyODPS dans votre environnement local. Pour plus d'informations, consultez Utilisation de PyODPS dans un environnement local.
DataWorks : PyODPS est préinstallé sur les nœuds PyODPS dans DataWorks. Vous pouvez développer et exécuter périodiquement des tâches PyODPS directement sur ces nœuds. Pour plus d'informations, consultez Utilisation de PyODPS dans DataWorks.
PAI Notebooks : vous pouvez installer et exécuter PyODPS dans l'environnement Python de PAI. PyODPS est préinstallé dans les images PAI intégrées, telles que le composant Python personnalisé de PAI-Designer, et est prêt à l'emploi. L'utilisation de PyODPS dans PAI Notebooks est similaire à son utilisation standard. Pour plus d'informations, consultez Présentation des opérations de base et DataFrame (non recommandé).
Remarques : ne pas télécharger l'intégralité des données sur une machine locale et exécuter PyODPS
PyODPS est un SDK qui s'exécute sur divers clients, notamment les PC, les nœuds PyODPS DataWorks dans Data Studio et les environnements PAI Notebook.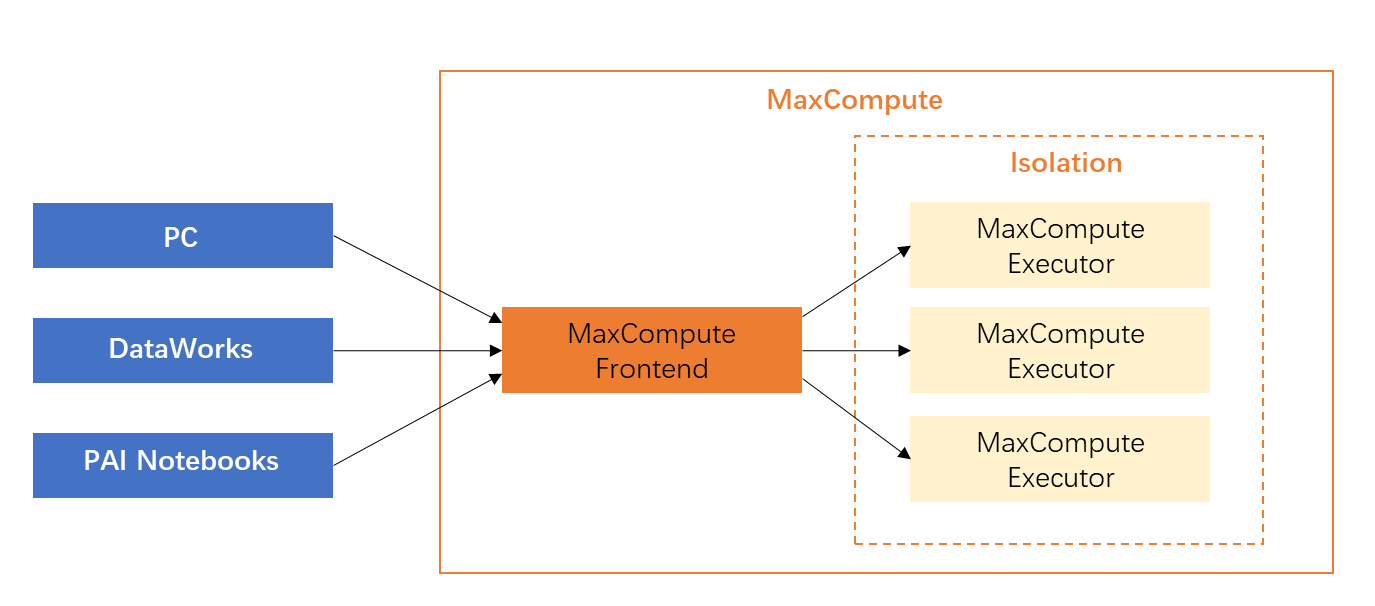 PyODPS fournit plusieurs opérations pratiques pour extraire les données vers une machine locale, telles que
tunnel download, execute et to_pandas. Par conséquent, de nombreux nouveaux utilisateurs tentent d'extraire les données localement, de les traiter, puis de les charger à nouveau dans MaxCompute. Cependant, cette méthode est souvent très inefficace. L'extraction des données localement vous empêche de tirer parti des capacités de calcul parallèle à grande échelle de MaxCompute.
|
Méthode de traitement des données |
Description |
Scénario d'exemple |
|
Extraction des données vers une machine locale pour traitement (non recommandé. Cela peut provoquer des erreurs OOM.) |
Par exemple, un nœud PyODPS dans DataWorks inclut un package PyODPS intégré et l'environnement Python nécessaire. Ce nœud est un conteneur d'exécution client limité en ressources. Il n'utilise pas les ressources de calcul MaxCompute et impose des limites de mémoire strictes. |
PyODPS fournit l'interface |
|
Soumission des tâches à MaxCompute pour une exécution distribuée (recommandé) |
Utilisez la fonctionnalité DataFrame distribuée de PyODPS. Soumettez les calculs principaux à MaxCompute pour une exécution distribuée au lieu de télécharger et de traiter les données sur le nœud client PyODPS. C'est la clé pour utiliser correctement PyODPS. Remarque
Si vous souhaitez convertir les résultats d'exécution SQL en DataFrame, utilisez d'abord l'instruction
|
Utilisez l'interface DataFrame PyODPS pour le traitement des données. Pour les tâches courantes, telles que le traitement de chaque ligne et sa réécriture dans une table, ou la division d'une ligne en plusieurs lignes, utilisez les méthodes Ces interfaces traduisent votre code en SQL pour une exécution distribuée sur le cluster de calcul MaxCompute. Cela ne consomme pratiquement aucune mémoire locale et améliore considérablement les performances par rapport au calcul sur une seule machine. |
L'exemple de tokenisation suivant compare le code des deux méthodes.
-
Scénario d'exemple
Vous devez extraire des informations en analysant des chaînes de journaux quotidiens. Vous disposez d'une table contenant une seule colonne de type chaîne. Vous devez utiliser la bibliothèque jieba pour tokeniser le texte chinois, trouver les mots-clés souhaités et stocker ces mots-clés dans une table d'informations.
-
Démonstration de code de traitement inefficace
import jieba
t = o.get_table('word_split')
out = []
with t.open_reader() as reader:
    for r in reader:
        words = list(jieba.cut(r[0]))
        #
        # Processing logic to generate processed_data
        #
        out.append(processed_data)
out_t = o.get_table('words')
with out_t.open_writer() as writer:
    writer.write(out)
Cette approche suit une logique de traitement sur une seule machine : lire les données ligne par ligne, les traiter ligne par ligne, puis les écrire dans la table de destination ligne par ligne. L'ensemble du processus consomme beaucoup de temps pour le téléchargement et le chargement des données. La machine qui exécute le script a également besoin d'une grande quantité de mémoire pour traiter toutes les données. Pour les utilisateurs des nœuds DataWorks, cette approche peut facilement provoquer une erreur OOM en dépassant la mémoire allouée par défaut.
-
Démonstration de code de traitement efficace
from odps.df import output
out_table = o.get_table('words')
df = o.get_table('word_split').to_df()

# Assume the following fields and types need to be returned
out_names = ["word", "count"]
out_types = ["string", "int"]

@output(out_names, out_types)
def handle(row):
    import jieba
    words = list(jieba.cut(row[0]))
    #
    # Processing logic to generate processed_data
    #
    yield processed_data
df.apply(handle, axis=1).persist(out_table.name)
Utilisez la méthode apply pour une exécution distribuée :
La logique complexe est placée dans la fonction handle. Cette fonction est automatiquement sérialisée côté serveur pour être utilisée comme UDF, où elle est appelée et exécutée. Étant donné que la fonction handle traite également les données ligne par ligne lors de l'exécution côté serveur, la logique est identique. La différence réside dans le fait que lorsque ce programme est soumis à MaxCompute pour exécution, plusieurs machines traitent les données simultanément. Cela permet de gagner beaucoup de temps.
L'appel de l'interface persist écrit les données générées directement dans une autre table MaxCompute. Toute la génération et la consommation de données ont lieu au sein du cluster MaxCompute. Cela permet d'économiser les ressources réseau et mémoire locales.
Cet exemple utilise également un package tiers. MaxCompute prend en charge les packages tiers, tels que
jiebadans cet exemple, dans les UDF. Par conséquent, vous n'avez pas à vous soucier du coût des modifications de code. Vous pouvez tirer parti des capacités de calcul à grande échelle de MaxCompute avec presque aucune modification de votre logique principale.
Limites
En raison des restrictions de sandbox, certains programmes que vous déboguez localement à l'aide du backend de calcul pandas ne peuvent pas être débogués sur MaxCompute.