Fondé sur le Model Context Protocol (MCP), MaxCompute MCP Server (MCMCP) encapsule les métadonnées, les capacités de calcul et la gestion des tables de MaxCompute dans des outils structurés que les agents d'IA peuvent comprendre et invoquer. MCMCP permet aux agents d'IA d'effectuer directement des analyses de données à grande échelle, des transformations de données multimodales ainsi que des opérations et une maintenance intelligentes (O&M). Cette rubrique décrit le serveur MCP distant hébergé (recommandé) et le serveur MCP local.
Pour garantir la sécurité, examinez et respectez les précautions de sécurité avant de commencer.
Si vous avez des questions ou des suggestions, vous pouvez fournir un retour d'information via les canaux suivants.
Présentation
Les agents appellent directement les outils structurés fournis par MCMCP en utilisant le protocole MCP standard. Aucun SDK ni pilote supplémentaire n'est requis. MCMCP couvre l'intégralité du flux de travail des opérations de données, depuis la navigation dans les métadonnées et l'analyse SQL jusqu'à la gestion des tables.
Fonctionnalités principales
Navigation et recherche dans les métadonnées du catalogue : Parcourez hiérarchiquement les projets, schémas, tables, champs et partitions. La recherche en langage naturel est prise en charge.
Gestion des tables et maintenance des métadonnées : Créez des tables (avec options pour le cycle de vie, la clé primaire et les mises à jour partielles de colonnes), insérez de petites quantités de données et mettez à jour les commentaires de table, les tags ou les descriptions de colonne.
Vérifications d'identité et d'autorisations : Consultez l'identité du compte actuel et utilisez les informations d'autorisation MaxCompute pour résoudre les problèmes d'accès.
-
Authentification et autorisation :
Le MCP distant utilise Alibaba Cloud OAuth pour l'autorisation.
Le MCP local prend en charge AccessKey/SecretKey (AK/SK), Security Token Service (STS), Credentials URI, ECS RAM Role et la chaîne d'identification Alibaba Cloud par défaut.
-
Enregistrement côté serveur des clients (Client ID Metadata Documents, CIMD) :
Dans les environnements où cette fonctionnalité est activée, les clients hébergés sur le serveur ou auto-hébergés peuvent utiliser une URL de document de métadonnées HTTPS comme
client_idpour contourner l'enregistrement dynamique des clients (DCR). Toutefois, un consentement explicite reste requis sur la page de confirmation d'autorisation après la connexion. Pour plus d'informations, consultez Configurer les clients côté serveur (Client ID Metadata Documents). -
Analyse et exécution SQL :
Prend en charge la validation des instructions, l'estimation du volume de données analysées et de l'utilisation des unités de calcul (CU), l'exécution de requêtes SQL en lecture seule ou en écriture, les requêtes sur le statut des instances et la récupération des résultats. Les requêtes SQL en écriture et les modifications de métadonnées nécessitent une confirmation de l'utilisateur.
-
Analyse intelligente :
Génère des brouillons SQL en lecture seule à partir du langage naturel, diagnostique les problèmes de jobs et analyse l'utilisation du quota de calcul. Les résultats indiquent la portée des preuves et fournissent des actions recommandées.
-
Analyse des métadonnées de table :
Vérifie les structures de table et les métadonnées de partition sans analyser les données de la table.
-
Gestion SemanticSpec :
Créez et maintenez des brouillons SemanticSpec décrivant la sémantique des données, consultez les versions publiées et utilisez DataScan pour générer et appliquer des recommandations basées sur la découverte sémantique.
-
Recherche dans la base de connaissances et Q&A :
Le MCP distant inclut une base de connaissances intégrée de la documentation MaxCompute qui prend en charge les recherches par mots-clés et les questions-réponses en langage naturel, et renvoie des réponses avec des citations.
Découverte et lecture de compétences (Skills) : Le MCP distant inclut des ressources MCP Skill intégrées. Les clients peuvent utiliser
tools/listpour découvrir et lire le contenu des Skills pour des scénarios tels que l'analyse sémantique Information Schema et les conseils de retour d'information.-
Analyse O&M et gouvernance Information Schema :
Le MCP distant inclut un package sémantique Information Schema intégré.
Le MCP local nécessite l'installation séparée du Skill correspondant.
Informations sur les outils multilingues : Le MCP distant fournit les titres et descriptions des outils en chinois simplifié, chinois traditionnel et anglais dans la sortie
tools/list, et indique si un outil dépend d'un modèle.
Présentation de l'architecture
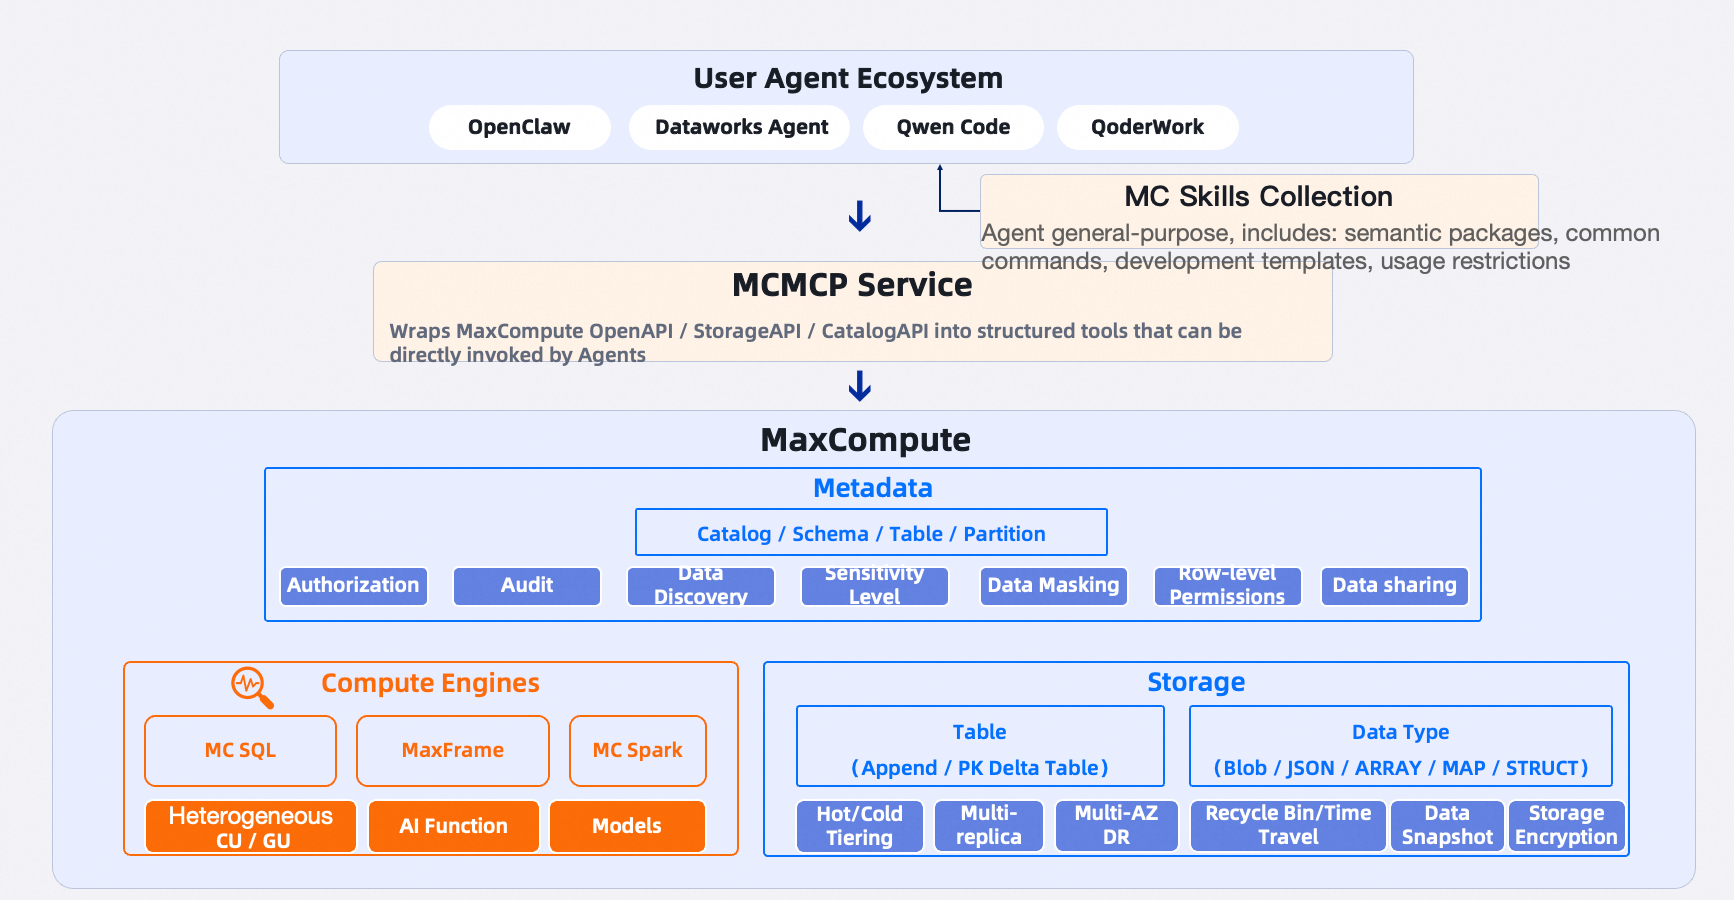
MCMCP possède une architecture en couches avec les niveaux suivants, de haut en bas :
Écosystème d'agents utilisateurs : Prend en charge les connexions depuis des clients MCP tels que Claude Code, Codex, Qwen Code, Cursor et Qoder.
Collection MaxCompute Skills : Les agents peuvent accomplir des tâches plus complexes en utilisant une combinaison de packages sémantiques, de commandes courantes, de modèles de développement et de limites d'utilisation.
Service MCMCP : Encapsule des capacités telles que MaxCompute OpenAPI, StorageAPI et CatalogAPI dans des outils MCP.
Capacités MaxCompute sous-jacentes : Couvre les capacités produit telles que les métadonnées, les moteurs de calcul et le stockage.
Méthodes de connexion
Le serveur MCP distant est la méthode de connexion recommandée. Cette méthode ne nécessite pas de serveur local ni le stockage d'une clé d'accès dans un processus local.
Le serveur local est réservé à l'auto-hébergement, aux entrées/sorties standard (stdio), au développement et au débogage locaux, ou aux scénarios où vous devez contrôler directement les identifiants.
|
Cas d'utilisation |
Méthode de connexion |
Description |
|
Le client MCP prend en charge Streamable HTTP et OAuth basé sur un navigateur. |
Connexion directe au MCP distant |
Ne nécessite pas l'installation d'un service local ni la configuration d'une clé d'accès. |
|
Nécessite une clé d'accès, des identifiants temporaires STS, un URI d'identifiants, un rôle RAM d'instance ECS ou la chaîne d'identifiants par défaut. |
Mode |
Utilise le MCP distant par défaut et revient aux outils SDK locaux si le MCP distant n'est pas disponible. |
|
Doit utiliser exclusivement le service hébergé et ne peut pas revenir aux outils locaux en cas d'échec. |
Mode |
Utilise exclusivement le MCP distant. Renvoie une erreur si le MCP distant n'est pas disponible. |
|
Auto-hébergement, développement et débogage locaux, ou scénarios nécessitant les outils SDK d'origine. |
Mode |
Nécessite l'installation du groupe de dépendances optionnelles |
Si votre client MCP prend en charge OAuth basé sur un navigateur, connectez-vous directement au MCP distant. Si vous utilisez une clé d'accès ou des identifiants temporaires STS, installez le serveur local et utilisez le mode default.
Connexion via OAuth basé sur un navigateur
Le MCP distant fournit des services via Streamable HTTP, une méthode de transport MCP basée sur HTTP. Pour vous connecter directement, votre client doit prendre en charge Streamable HTTP et OAuth basé sur un navigateur.
Sélection d'un endpoint
Sélectionnez un endpoint en fonction du réseau de votre client et du site web de votre compte Alibaba Cloud. L'endpoint MCP doit être cohérent au sein d'une même configuration client. Ne mélangez pas les endpoints de réseau public et de Virtual Private Cloud (VPC).
Endpoint public
-
Si vous n'avez pas besoin d'épingler le service à une région spécifique, sélectionnez l'endpoint par défaut correspondant à votre site web de compte :
Site web du compte
Endpoint MCP
Site web Alibaba Cloud Chine
https://mcp.maxcompute.aliyun.com/mcpSite web Alibaba Cloud International
https://mcp-intl.maxcompute.aliyun.com/mcp -
Si vous devez épingler le service à une région spécifique, générez l'endpoint en utilisant votre site web de compte et l'ID de région :
Site web du compte
Endpoint MCP public épinglé à la région
Site web Alibaba Cloud Chine
https://mcp.<regionId>.maxcompute.aliyun.com/mcpSite web Alibaba Cloud International
https://mcp-intl.<regionId>.maxcompute.aliyun.com/mcp
Les règles de nom de domaine servent uniquement à générer des endpoints et ne peuvent pas être utilisées pour vérifier si le service est disponible dans une région spécifique. Sélectionnez une région où le service est disponible. Pour accéder aux projets d'autres régions, vous devez spécifier l'ID de région cible dans la conversation ou les paramètres de l'outil.
La sélection du site web du compte s'applique uniquement aux connexions directes utilisant OAuth basé sur un navigateur. Le serveur local ne nécessite pas de configuration du site web du compte. Vous devez uniquement configurer la région et le type de réseau.
Endpoint VPC
Dans les régions où le service VPC est disponible, générez l'endpoint en fonction de votre site web de compte :
|
Site web du compte |
Endpoint MCP VPC épinglé à la région |
|
Site web Alibaba Cloud Chine |
|
|
Site web Alibaba Cloud International |
|
Que vous utilisiez un endpoint public ou VPC, si vous ne spécifiez pas de région dans la conversation ou les paramètres de l'outil, le service utilise par défaut la région de l'endpoint actuel. Par exemple, si vous vous connectez à l'endpoint cn-hangzhou, la région par défaut est cn-hangzhou. Si vous vous connectez à l'endpoint cn-hongkong, la région par défaut est cn-hongkong.
Prérequis
Un environnement réseau capable d'accéder aux noms de domaine des endpoints précédents.
Un client MCP prenant en charge MCP Streamable HTTP et l'autorisation OAuth basée sur un navigateur.
Un compte Alibaba Cloud disposant des autorisations nécessaires pour accéder à MaxCompute.
Limitations
Portée des autorisations : Vos autorisations MaxCompute et Resource Access Management (RAM) déterminent les projets, schémas, tables et instances auxquels vous pouvez accéder.
Confirmation des opérations d'écriture : Les opérations d'écriture nécessitent une confirmation explicite de l'utilisateur côté client. La passerelle ne fournit pas de deuxième invite de confirmation.
Configuration du client
Différents clients MCP peuvent utiliser des noms différents pour les champs de configuration. Définissez l'endpoint MCP sur l'endpoint de votre choix. L'exemple suivant utilise l'endpoint public pour le site web Alibaba Cloud Chine sans région spécifiée.
Pour épingler le service à une région spécifique, sélectionnez une adresse dans le tableau endpoint public correspondant à votre région de service et à votre site web de compte.
Si votre client s'exécute dans un environnement VPC, utilisez l'adresse
/mcpde la section endpoint VPC.
La configuration générale est la suivante.
{
  "mcpServers": {
    "maxcompute-mcp": {
      "type": "streamable-http",
      "url": "https://mcp.cn-hangzhou.maxcompute.aliyun.com/mcp"
    }
  }
}
Si votre client utilise des noms de champs tels que endpoint, server_url ou transport, configurez-les conformément à la documentation du client. L'URL doit toujours être l'adresse /mcp issue des tableaux ci-dessus.
Claude Code
Nous vous recommandons d'ajouter le serveur HTTP MCP depuis la ligne de commande :
claude mcp add --transport http --scope user maxcompute-mcp \
  https://mcp.cn-hangzhou.maxcompute.aliyun.com/mcp
Après avoir ajouté le serveur, vérifiez l'état de la connexion :
claude mcp list
claude mcp login maxcompute-mcp
Vous pouvez également saisir /mcp dans une session Claude Code pour afficher l'état et déclencher la connexion. Pour utiliser ce serveur uniquement pour le projet actuel, remplacez --scope user par --scope local ou utilisez une étendue de projet selon les exigences de votre équipe.
Codex
Nous vous recommandons d'ajouter le serveur MCP Streamable HTTP depuis la ligne de commande :
codex mcp add maxcompute-mcp \
  --url https://mcp.cn-hangzhou.maxcompute.aliyun.com/mcp
Après avoir ajouté le service, affichez la liste des services et initiez la connexion :
codex mcp list
codex mcp login maxcompute-mcp
Pour le configurer manuellement, ajoutez les éléments suivants à ~/.codex/config.toml :
[mcp_servers."maxcompute-mcp"]
url = "https://mcp.cn-hangzhou.maxcompute.aliyun.com/mcp"
Qwen Code
Nous vous recommandons d'ajouter le serveur HTTP MCP depuis la ligne de commande :
qwen mcp add --transport http --scope user maxcompute-mcp \
  https://mcp.cn-hangzhou.maxcompute.aliyun.com/mcp
Si votre distribution client utilise un nom de commande différent, remplacez qwen ci-dessus par le nom de commande réel. Après avoir ajouté le serveur, démarrez Qwen Code et saisissez /mcp dans une session pour vérifier l'état de la connexion et les outils disponibles. Vous pouvez également l'ajouter manuellement dans ~/.qwen/settings.json :
{
  "mcpServers": {
    "maxcompute-mcp": {
      "httpUrl": "https://mcp.cn-hangzhou.maxcompute.aliyun.com/mcp"
    }
  }
}
Si le fichier contient déjà d'autres configurations, fusionnez uniquement la section mcpServers. Ne remplacez pas les paramètres existants. Sauf si votre client ou environnement d'entreprise a d'autres exigences, vous n'avez pas besoin de configurer manuellement l'en-tête Authorization. Le client termine le processus de connexion via le flux OAuth lors de la première connexion.
Première connexion et autorisation OAuth
Lors de la première connexion, le client MCP démarre automatiquement le flux d'autorisation OAuth et ouvre la page d'autorisation Alibaba Cloud dans un navigateur.
Flux d'autorisation
-
Autorisez l'application tierce lors de la première connexion.
Portée de l'autorisation : Cette autorisation concerne l'application OAuth
maxcompute-mcp, et non l'octroi d'autorisations sur les données dans MaxCompute.Compte d'autorisation : Cette opération doit être effectuée par un compte racine ou un administrateur RAM disposant de l'autorisation
AliyunRAMFullAccess. L'autorisation administrative est utilisée uniquement pour autoriser l'application tierce et ne doit pas servir d'identité d'exécution pour l'accès quotidien aux données MaxCompute. Les projets, schémas, tables et instances auxquels chaque identité connectée peut accéder sont toujours déterminés par leurs propres autorisations MaxCompute et RAM.Une fois qu'un compte racine a autorisé l'application, les autres utilisateurs RAM sous ce compte peuvent se connecter et terminer leur propre authentification OAuth. Tous les utilisateurs RAM n'ont pas besoin de l'autorisation
AliyunRAMFullAccess.
Ajoutez MaxCompute MCP Server dans votre client MCP et initiez une connexion. Cela se produit lors de la première connexion à
/mcp, ou lors du premier appel à un outil tel quetools/list.Le client détecte la nécessité de se connecter et ouvre automatiquement un navigateur vers la page OAuth Alibaba Cloud.
Confirmez que le compte et les informations d'autorisation sur la page sont corrects, puis cliquez sur Accepter ou Autoriser.
Le navigateur termine le rappel. Le client enregistre le jeton et se reconnecte automatiquement au service MCP. Vous n'avez généralement pas besoin de vous autoriser à nouveau au cours de la même session.
Remarques d'utilisation
Vérifiez la source de la page : La page OAuth doit provenir d'un domaine officiel Alibaba Cloud. Si le nom de domaine, le compte ou les informations d'autorisation semblent inhabituels, ne poursuivez pas.
Utilisez le bon compte : Effectuez l'autorisation avec le compte Alibaba Cloud disposant des autorisations nécessaires pour accéder aux données MaxCompute cibles. Ce compte détermine quels projets et tables sont accessibles. Les résultats peuvent différer si vous changez de compte.
Protégez les informations sensibles : Ne partagez pas votre jeton d'accès, votre jeton d'actualisation, votre code d'autorisation ou les paramètres de l'URL de rappel avec d'autres personnes.
Si la page d'autorisation affiche un message « Call not authorized » et indique que l'autorisation actuelle nécessite un administrateur disposant de l'autorisation
AliyunRAMFullAccess, cela signifie que l'utilisateur RAM actuel ne peut pas autoriser les applications tierces pour le compte racine. Dans ce cas, demandez au propriétaire du compte racine ou à un administrateur RAM disposant de cette autorisation de se reconnecter à MaxCompute MCP Server et de cliquer sur Autoriser. Si la page affiche toujours le statut d'autorisation précédent ayant échoué, l'administrateur doit supprimer l'application dans la section de gestion des applications OAuth de la console Resource Access Management (RAM), puis initier à nouveau la connexion et l'autorisation depuis le client MCP. N'accordez pas l'autorisationAliyunRAMFullAccessà un compte d'utilisation quotidienne à long terme simplement pour contourner cette invite.
Sélection de compte pour les systèmes d'entreprise partagés
Lorsque vous connectez Remote MCP à un agent d'entreprise interne ou à un autre système partagé multi-utilisateurs, déterminez d'abord s'il faut préserver l'identité de l'utilisateur final :
Pour isoler les données en fonction des autorisations des employés et conserver l'audit au niveau utilisateur, faites en sorte que chaque utilisateur effectue séparément la connexion OAuth. Les appels MCP utilisent leurs identités Alibaba Cloud individuelles, et leurs autorisations MaxCompute et RAM respectives déterminent les données auxquelles ils peuvent accéder.
Si le système ne peut utiliser qu'une seule identité de connexion partagée, créez un utilisateur RAM dédié et accordez-lui uniquement les autorisations MaxCompute minimales requises. Dans ce cas, toutes les requêtes partagent les autorisations et le principal d'audit de cette identité. Le système lui-même est responsable de l'authentification des utilisateurs, de l'isolation des sessions et de l'audit des opérations.
N'utilisez pas un compte racine ou un compte administrateur disposant de
AliyunRAMFullAccesscomme identité d'exécution à long terme pour un LLM, un agent d'entreprise interne ou un client MCP partagé. L'autorisation initiale de l'application et l'accès quotidien aux données doivent utiliser des périmètres d'autorisation différents.
Configuration des clients côté serveur (documents de métadonnées d'ID client)
Les plateformes d'agents internes aux entreprises, les services web ou autres clients MCP côté serveur ne disposent généralement pas de capacité de rappel locale en dehors d'un navigateur et ne se prêtent pas à l'enregistrement dynamique de client (DCR) pour chaque instance de déploiement. Pour les environnements prenant en charge la fonctionnalité Client ID Metadata Documents (CIMD), ces clients peuvent utiliser directement une URL de document de métadonnées HTTPS comme client_id :
-
Hébergez un document de métadonnées client à une adresse HTTPS publique accessible de manière constante par le client. Le champ
client_iddu document doit être identique à cette URL, etredirect_urisdoit répertorier toutes les URL de rappel effectivement utilisées :{ "client_id": "https://client.example.com/oauth/client.json", "client_name": "Sample Enterprise Agent", "redirect_uris": ["https://client.example.com/oauth/callback"] } -
Dans la configuration OAuth du client MCP, définissez l'URL du document comme
client_id(le nom du champ peut varier selon le client).Les clients prenant en charge CIMD ignorent DCR et initient l'autorisation directement avec l'URL du document.
Les clients ne prenant pas en charge CIMD fonctionnent en utilisant leur méthode d'enregistrement d'origine.
Lorsqu'un utilisateur initie une connexion, il effectue toujours la connexion OAuth Alibaba Cloud dans un navigateur. Après la connexion, le service affiche une page de confirmation d'autorisation qui répertorie le nom de l'application, l'URL
client_idet le domaine de rappel déclarés dans le document. Le service n'émet un code d'autorisation qu'après que l'utilisateur a explicitement cliqué sur Agree.Le service revalide le document lors de chaque tentative d'autorisation. Le document doit être accessible via HTTPS,
client_iddoit correspondre à l'URL de la requête et l'URL de rappel doit correspondre exactement à l'une desredirect_uris. Si l'une de ces conditions n'est pas remplie, le service rejette l'autorisation.
Contraintes et notes :
Cette fonctionnalité est disponible selon l'environnement. Un client peut vérifier le champ
client_id_metadata_document_supporteddans la réponse/.well-known/oauth-authorization-serverpour déterminer si le point d'entrée actuel la prend en charge. Si le champ n'existe pas, le client revient automatiquement à DCR ou à l'enregistrement manuel.Cette méthode prend uniquement en charge les clients publics. Le document ne doit pas contenir de configurations confidentielles telles que
client_secretet le client doit utiliser PKCE.Dans un modèle de participation ouverte, la page de confirmation d'autorisation constitue la limite de confiance. Ne cliquez pas sur Agree à la place d'autres personnes et ne transférez pas la page de confirmation ou l'URL de rappel à des tiers.
Le document de métadonnées est une information publique. N'incluez pas de jetons, de clés, de noms de domaine internes ou d'adresses réseau internes dans le document.
Vérification de la connexion
Une fois l'autorisation terminée, nous vous recommandons de vérifier la connexion et les autorisations en suivant ces étapes.
Dans votre AI Agent, saisissez les invites suivantes dans l'ordre :
« Check the status of the MaxCompute MCP connection. »
« List the MaxCompute projects visible to the current identity. Return the first 10. »
« Check what schemas and tables are under the
<project>project. »
Si la liste des projets est vide ou si vous recevez une erreur d'autorisation, vérifiez si votre compte Alibaba Cloud dispose des autorisations requises pour le projet MaxCompute cible.
Connexion à l'aide du serveur local
Le serveur local convient aux clients MCP qui prennent uniquement en charge l'entrée/sortie standard (stdio), aux scénarios nécessitant un service Streamable HTTP local ou aux scénarios où vous devez utiliser une clé d'accès, des informations d'identification temporaires STS, un URI d'informations d'identification, un rôle RAM d'instance ECS ou la chaîne d'informations d'identification par défaut d'Alibaba Cloud.
Modes d'exécution
|
Mode |
Comportement |
Cas d'utilisation |
|
|
Utilise Remote MCP par défaut. Reviens aux outils SDK locaux si Remote MCP n'est pas disponible. |
La plupart des scénarios utilisant une clé d'accès ou des informations d'identification temporaires STS. |
|
|
Utilise exclusivement Remote MCP. Renvoie une erreur s'il n'est pas disponible. |
Scénarios ne devant pas revenir aux outils locaux. |
|
|
Utilise exclusivement les outils SDK locaux. |
Hébergement autonome et développement et débogage locaux. |
Les trois modes prennent en charge stdio et Streamable HTTP.
Vous pouvez sélectionner un mode en utilisant l'option CLI --mode, la variable d'environnement MAXCOMPUTE_MCP_MODE ou le champ mode de niveau supérieur dans la configuration JSON. Si vous ne configurez pas de mode, le serveur utilise default.
Installation
Nécessite Python 3.10 ou version ultérieure.
-
Utilisez
pipouuvpour installer le package de base depuis Python Package Index (PyPI).-
Pour installer en utilisant
pip, exécutez la commande suivante :python -m pip install alibabacloud-maxcompute-mcp-server -
Pour installer dans un environnement isolé en utilisant
uv, exécutez la commande suivante :uv tool install alibabacloud-maxcompute-mcp-server
Vérifiez le point d'entrée de ligne de commande :
alibabacloud-maxcompute-mcp-server --help -
-
Pour utiliser le mode
localou la fonctionnalité de repli local du modedefault, vous devez installer les dépendances facultativeslocal.-
Pour installer en utilisant
pip, exécutez la commande suivante :python -m pip install "alibabacloud-maxcompute-mcp-server[local]" -
Pour installer dans un environnement isolé en utilisant
uv, exécutez la commande suivante :uv tool install "alibabacloud-maxcompute-mcp-server[local]"
-
Configuration de la région, du réseau et des informations d'identification
Configuration minimale
Vous devez uniquement spécifier la région et le type de réseau.
{
  "maxcompute": {
    "region": "cn-hangzhou",
    "network": "public"
  }
}
Le paramètre network prend en charge public et vpc. Le paramètre defaultProject spécifie un projet par défaut facultatif. Pour vous connecter à Remote MCP, vous n'avez pas besoin de configurer protocol, namespaceId ni l'adresse Remote MCP.
Fichier de configuration
Enregistrez la configuration dans un chemin protégé sur votre machine locale et spécifiez-la en utilisant l'option --config ou la variable d'environnement MAXCOMPUTE_CATALOG_CONFIG. Vous pouvez également utiliser des variables d'environnement au lieu de créer un fichier JSON : MAXCOMPUTE_REGION, MAXCOMPUTE_NETWORK et MAXCOMPUTE_DEFAULT_PROJECT (facultatif).
Configuration des informations d'identification
Fournissez les informations d'identification depuis l'environnement du processus MCP ou la chaîne d'informations d'identification par défaut d'Alibaba Cloud. Utilisez des clés d'accès statiques uniquement à des fins de développement et de débogage :
export ALIBABA_CLOUD_ACCESS_KEY_ID="<accessKeyId>"
export ALIBABA_CLOUD_ACCESS_KEY_SECRET="<accessKeySecret>"

# If using STS, also set the following variable
export ALIBABA_CLOUD_SECURITY_TOKEN="<securityToken>"

# A dynamic credentials service can be used instead of the preceding static environment variables
export ALIBABA_CLOUD_CREDENTIALS_URI="<credentialsUri>"
Pour les environnements tels que les rôles RAM d'instance ECS, vous pouvez utiliser directement la chaîne d'informations d'identification par défaut d'Alibaba Cloud.
Rappel de sécurité
Ne placez pas de clés d'accès, d'informations d'identification temporaires STS, d'URI d'informations d'identification ou de jetons d'accès dans les args du client MCP et ne validez pas ces informations d'identification dans un référentiel de code.
Rétrocompatibilité avec les configurations précédentes
Les configurations MaxCompute de niveau supérieur précédentes, les configurations ODPS de niveau supérieur, les configurations nommées et les configurations basées uniquement sur des variables d'environnement restent valides. Le serveur local peut identifier la région et le type de réseau à partir des points de terminaison Front End (FE) ou CatalogAPI standards :
Un point de terminaison public correspond à un MCP public dans la même région.
Un point de terminaison VPC correspond à un MCP VPC dans la même région.
Si la région ou le type de réseau dans la configuration ne correspond pas à l'environnement réel, le serveur local renvoie une erreur de configuration.
Règles relatives aux régions et aux noms de domaine : Lorsque vous utilisez les configurations de région et de réseau, le serveur local génère automatiquement les points de terminaison FE, CatalogAPI et MCP pour la région spécifiée.
Les régions situées en Chine continentale utilisent le domaine mcp.
La région Chine (Hong Kong) et les autres régions hors de Chine continentale utilisent le domaine mcp-intl. Vous n'avez pas besoin de configurer manuellement le site web du compte.
Remarque : Vous ne pouvez pas utiliser les règles de nom de domaine pour vérifier si le service est disponible dans une région spécifique. Sélectionnez une région où le service est disponible.
Configuration du client MCP
Pour démarrer le mode default en utilisant un fichier de configuration :
{
  "mcpServers": {
    "maxcompute-mcp": {
      "command": "alibabacloud-maxcompute-mcp-server",
      "args": [
        "--config",
        "/path/to/config.json"
      ]
    }
  }
}
Si le fichier exécutable ne se trouve pas dans le PATH du client MCP, modifiez le paramètre command pour indiquer le chemin d'installation réel.
Changement du mode d'exécution
Dans le paramètre args, spécifiez le mode d'exécution en utilisant l'option --mode :
--mode remote: Force l'utilisation de Remote MCP.--mode local: Force l'utilisation des outils SDK locaux. Vous devez d'abord installer le groupe de dépendances facultativeslocal.
Transport Streamable HTTP
alibabacloud-maxcompute-mcp-server \
  --config /path/to/config.json \
  --mode default \
  --transport streamable-http \
  --host 127.0.0.1 \
  --port 8000
Après le démarrage, définissez le point de terminaison du client MCP sur http://127.0.0.1:8000/mcp. Par défaut, le serveur local écoute sur l'adresse de bouclage local 127.0.0.1. Modifiez l'adresse d'écoute uniquement si d'autres hôtes approuvés doivent accéder à ce processus.
Fonctionnalités des outils MCP
Il n'est généralement pas nécessaire de spécifier manuellement les paramètres des outils. Décrivez simplement votre objectif en langage naturel.
Les connexions directes OAuth via navigateur et le mode Remote MCP du lanceur local publient le même ensemble d'outils. Seul le mode local publie les outils SDK locaux d'origine. Bien que les ensembles d'outils portent des noms différents, leurs fonctionnalités et cas d'utilisation se chevauchent largement.
Utilisez le tableau suivant pour sélectionner un outil. Pour obtenir les paramètres détaillés, les champs de résultat complets et les workflows avancés, consultez les définitions d'outils renvoyées par tools/list ainsi que les descriptions fournies plus loin dans cette rubrique.
Fonctionnalité | Outil Remote MCP | Outil Local MCP | Principales limites d'utilisation |
Vérification de la connexion |
| Vérifiez avec | La réponse de |
Fonctionnalités de la passerelle |
| Non applicable | Consultez la version de la passerelle, les versions du protocole MCP prises en charge, ainsi que les plug-ins et outils disponibles. |
Affichage des projets et schémas |
|
| Les autorisations MaxCompute et RAM de l'identité actuelle déterminent l'étendue visible. Pour les projets traditionnels à deux niveaux, vous pouvez généralement omettre le paramètre |
Métadonnées de table et de partition |
|
| Recherchez d'abord les tables candidates, puis lisez les informations relatives à leurs champs et partitions. Pour les recherches dans le catalogue, vous devez spécifier l'objet En mode Pour trouver la partition de premier niveau la plus volumineuse contenant des données, utilisez directement |
Analyse SQL et instances |
|
| Avant d'exécuter une requête, validez ou estimez le volume de données analysées et l'utilisation des CU.
Les échecs internes MaxCompute, tels qu'une tâche d'estimation de l'utilisation des ressources ayant échoué, renvoient des erreurs d'outil catégorisées et ne sont pas signalés à tort comme du SQL invalide. Un Remote MCP doit utiliser explicitement Dans Local MCP,
|
Ébauches SQL en langage naturel |
| Non applicable | Vous devez transmettre la Le paramètre L'analyse par modèle peut consommer des crédits MaxAgent. |
Diagnostic de job |
| Non applicable | Spécifiez un job en utilisant son L'outil fournit des suggestions de diagnostic basées sur l'état du job, les détails d'exécution et les journaux. Il n'exécute, ne relance ni n'annule le job. Si les preuves sont incomplètes, l'outil renvoie |
Affichage des quotas |
| Non applicable | Cet outil renvoie la liste et les détails des quotas de calcul que l'identité actuelle peut afficher via son endpoint FE associé. Cet outil ne modifie pas les quotas. |
Analyse des quotas |
| Non applicable | Analyse la consommation des quotas et des ressources des jobs au cours des 7 derniers jours dans la région sélectionnée. Seuls les quotas secondaires d'abonnement avec capacité fixe renvoient l'utilisation de la capacité. Les quotas Paiement à l'utilisation et Spot ne renvoient pas de pourcentage de capacité. Cet outil est en lecture seule. L'analyse par modèle peut consommer des crédits MaxAgent. |
Analyse de l'intégrité des métadonnées de table |
| Non applicable | Lit uniquement les métadonnées de table et de partition auxquelles l'identité actuelle peut accéder. Il n'analyse pas les données de la table, n'appelle pas le modèle et ne consomme pas de crédits MaxAgent. Les conclusions qui ne peuvent pas être étayées par les métadonnées sont répertoriées dans |
Vérifications du compte et des autorisations |
|
| Vérifie uniquement l'identité actuelle et les autorisations existantes. Il n'accorde ni ne modifie les autorisations. |
CRUDL SemanticSpec |
| Aucun outil correspondant | Le namespace est défini sur l' Les outils de révision publiée lisent uniquement les révisions publiées immuables. La création, la mise à jour et la suppression sont des opérations d'écriture. Les mises à jour du contenu brouillon utilisent des révisions pour le contrôle de concurrence. |
Suggestions et publication SemanticSpec |
| Aucun outil correspondant | L'actualisation déclenche uniquement DataScan et n'applique ni ne publie automatiquement. L'application et la publication nécessitent des appels explicites et doivent être confirmées par l'utilisateur en tant qu'opérations d'écriture. |
Gestion des tables et maintenance des métadonnées |
|
| Ces opérations modifient les ressources ou les métadonnées MaxCompute. Avant de les appeler, affichez le projet et la table cibles, résumez les modifications et obtenez la confirmation explicite de l'utilisateur. |
Recherche dans la base de connaissances et Q&R |
| Non applicable | Recherchez des extraits de documentation MaxCompute ou récupérez des informations à partir de documents pour répondre aux questions. Vous pouvez spécifier une |
Découverte et lecture de compétences (Skills) |
| Non applicable | La disponibilité des compétences dépend de la configuration actuelle du service et de la réponse de |
Analyse sémantique Information Schema | Package sémantique Information Schema intégré | Nécessite l'installation séparée de la compétence | Nécessite des autorisations Information Schema au niveau du locataire et un projet exécutable dans la même région. Les vues historiques présentent des limitations en termes de latence et d'étendue des requêtes et ne doivent pas être utilisées pour déterminer l'état en temps réel. |
Configuration de session locale | Non applicable |
| Le changement de configuration affecte le processus Local MCP et convient mieux à stdio ou à une utilisation par client unique. |
Informations d'affichage de la liste des outils
-
Informations d'affichage multilingues des outils
Remote MCP fournit des informations d'affichage multilingues pour chaque objet d'outil dans la réponse tools/list. Les clients prenant en charge cette extension peuvent lire
_meta["com.aliyun.maxcompute/display"]et afficher le titre et la description en chinois simplifié (zh-CN), en chinois traditionnel (zh-TW) ou en anglais (en) selon la langue de l'interface.Les clients doivent s'appuyer sur l'ensemble d'outils renvoyé par chaque appel
tools/listet ne pas maintenir un catalogue d'outils distinct. Si la langue sélectionnée est manquante ou si la version de l'extension n'est pas prise en charge, utilisez les champs standardstitle,nameetdescriptioncomme solution de repli. Pour indiquer une dépendance au modèle, marquez un outil comme étant pris en charge par MaxAgent uniquement si_meta["com.aliyun.maxcompute/model_backed"]a la valeurtrue. Les informations d'affichage sont destinées uniquement à la présentation de l'interface utilisateur et ne doivent pas être utilisées pour les décisions relatives aux autorisations, à la facturation ou à la sécurité. -
Fonctionnalités d'analyse intelligente
Le SQL en langage naturel, le diagnostic de job et l'analyse des quotas constituent les trois outils d'analyse intelligente de Remote MCP. Tous sont en lecture seule. Ils n'exécutent pas automatiquement le SQL généré, ne relancent ni n'annulent les jobs, et ne modifient pas la capacité des quotas ni les configurations de planification.
L'analyse par modèle peut consommer des crédits MaxAgent, et un seul appel d'outil peut déclencher plusieurs appels au modèle. Lorsque les capacités du modèle ou les preuves requises ne sont pas disponibles, l'outil peut renvoyer un résultat
partial. Utilisez les champswarningsetmissing_evidencepour évaluer la fiabilité des conclusions.
Prérequis pour l'analyse intelligente
Le client MCP est connecté à Remote MCP via OAuth basé sur un navigateur ou le lanceur local.
L'identité authentifiée actuelle dispose des autorisations requises pour le projet, le job ou le quota MaxCompute cible.
La région indiquée dans la requête correspond à la région où se trouvent les ressources cibles.
Lorsque vous utilisez les capacités du modèle MaxAgent, l'identité actuelle doit disposer d'un quota MaxAgent valide et de crédits MaxAgent suffisants dans la région sélectionnée.
Pour interroger les métadonnées du locataire ou les jobs historiques à l'aide de l'outil Generate SQL, l'identité actuelle doit satisfaire aux exigences Information Schema.
Si vous avez besoin de données historiques sur l'utilisation de la capacité des quotas ou la consommation des jobs, les capacités d'observation historique correspondantes doivent être disponibles dans la région de service cible.
L'analyse des quotas ne nécessite pas d'autorisations Information Schema ni de projet exécutable.
Si les capacités du modèle ne sont pas disponibles, l'outil peut renvoyer un résultat
partialmais conservera toutes les preuves déterministes déjà collectées.
En général, il vous suffit d'énoncer votre objectif dans la conversation, et l'Agent sélectionne l'outil et renseigne ses paramètres. Vous pouvez également appeler l'outil MCP directement en utilisant les exemples JSON fournis dans cette rubrique.
Résultats de l'analyse intelligente
Les trois outils renvoient des résultats MCP structurés. Accordez une attention particulière aux champs suivants :
ok: Indique si l'appel de l'outil via le protocole s'est terminé avec succès.ok=truene garantit pas que les preuves sont complètes.data: Contient les données métier, telles que les ébauches SQL, les résultats de diagnostic ou les observations sur les quotas.meta.outcomeoumetadata.outcome: Le statut du résultat métier.warnings: Décrit les limitations non fatales, les dégradations ou les comportements de repli.missing_evidence: Répertorie les preuves qui n'ont pas pu être obtenues et les raisons de cet échec.usage: Affiche le nombre d'appels au modèle et l'utilisation des jetons signalée par le modèle.
Valeurs courantes de outcome :
|
Statut |
Description |
|
|
L'outil a obtenu suffisamment de preuves et a terminé l'analyse. |
|
|
L'outil s'est exécuté avec succès, mais certaines preuves, telles que les plans d'exécution, les journaux, les données historiques ou les détails des autorisations, n'étaient pas disponibles. Vous pouvez toujours utiliser les faits renvoyés. |
|
|
La question ou l'étendue des données est trop large et nécessite davantage d'informations de la part de l'utilisateur. |
|
|
L'entrée, l'étendue des autorisations ou le contenu généré viole les contraintes de sécurité en lecture seule. |
|
|
Le délai d'attente du modèle ou de la requête MaxCompute a été atteint. |
|
|
Un appel backend ou au modèle a échoué, et aucun résultat utilisable n'a été généré. |
Ne considérez pas un résultat partial comme un échec d'appel API. Utilisez le champ missing_evidence pour déterminer quelles questions les conclusions actuelles peuvent répondre et si vous devez compléter les autorisations, l'étendue ou effectuer un diagnostic plus approfondi. Lors du dépannage, ne copiez pas les informations d'authentification ni les réponses backend complètes.
Generate SQL
Cas d'utilisation
Générez une requête SQL basée sur une question métier.
Générez une requête SQL qui joint des tables across plusieurs projets ou schémas.
Vérifiez les références de champs et de tables, les propriétés en lecture seule et le dialecte MaxCompute avant l'exécution.
Effectuez simultanément la validation SQLCost backend et l'estimation de l'utilisation des ressources lorsque le projet d'exécution est connu.
Générez des requêtes SQL Information Schema au niveau du locataire basées sur les métadonnées, l'historique des jobs, l'utilisation des quotas ou les problèmes d'autorisation et de gouvernance.
Paramètres
|
Paramètre |
Obligatoire |
Description |
|
|
Oui |
La question originale de l'utilisateur, avec un maximum de 2 000 caractères. Ne concaténez pas d'instructions DDL, de schémas de table ou d'invites supplémentaires. |
|
|
Non |
Une région MaxCompute. Si elle est omise, la région par défaut du service est utilisée. |
|
|
Non |
Une étendue stricte pour la découverte de données, avec un maximum de 16 éléments. Vous pouvez la limiter à un projet, un projet/schéma ou des tables spécifiques. Across toutes les sources, vous pouvez spécifier un maximum de 20 tables exactes au total. |
|
|
Non |
Le contexte d'exécution où l'appelant dispose de l'autorisation de créer une instance de requête. Pour le SQL de table métier, il est utilisé pour la validation SQLCost backend. Pour le SQL Information Schema, il sert à former des paramètres réutilisables pour l'exécution ultérieure. Il ne définit pas l'étendue de la découverte de données. |
Le paramètre sources est une contrainte d'étendue, pas une indication de récupération. Lorsque sources est fourni, l'outil interroge uniquement dans les projets, schémas ou tables spécifiés et ne recherchera pas de données en dehors de ces limites. Si une question peut s'étendre à plusieurs projets ou schémas, vous pouvez fournir plusieurs sources, mais elles doivent toutes se trouver dans la même région.
Si sources est omis, l'outil détermine automatiquement s'il doit découvrir des tables métier ou lire les vues Information Schema prises en charge au niveau du locataire en fonction de la sémantique de la question. L'outil n'accorde pas automatiquement l'accès aux vues système en fonction des correspondances de mots-clés ou des paramètres de l'appelant.
Exemple : Étendue de données connue
Invite en langage naturel :
In sales_dw.dwd in the China (Shanghai) region, generate an SQL query to count the number of paid orders and the total payment amount for each channel over the last 30 days, sorted by payment amount in descending order. Only generate and validate the SQL, do not execute it yet.Arguments d'outil équivalents :
{
  "question": "Count the number of paid orders and the total payment amount for each channel over the last 30 days, sorted by payment amount in descending order",
  "region": "cn-shanghai",
  "sources": [
    {
      "project": "sales_dw",
      "schema": "dwd"
    }
  ],
  "analysis_context": {
    "project": "sales_dw",
    "schema": "dwd"
  }
}
Exemple : Restriction à des tables spécifiques
{
  "question": "Find the team with the highest points in each race and calculate their cumulative season points",
  "region": "cn-shanghai",
  "sources": [
    {
      "project": "analytics",
      "schema": "formula_1",
      "tables": ["constructors", "constructorresults", "races"]
    }
  ]
}
Exemple : Analyse SQL des jobs historiques
{
  "question": "Query the 20 jobs with the highest CU consumption in the last 7 days. Return the instance ID, project, submitter, and CU hours",
  "region": "cn-shanghai",
  "analysis_context": {
    "project": "<A project where the current identity can create query instances in this region>"
  }
}
Dans ce scénario, ne transmettez pas le paramètre sources. L'outil charge la compétence Information Schema intégrée ainsi que la documentation des champs pour les vues cibles. Il génère une requête ciblant SYSTEM_CATALOG.INFORMATION_SCHEMA.TASKS_HISTORY et applique une fenêtre de partition ds n'excédant pas 14 jours, accompagnée d'une clause LIMIT (plage : 1 à 100).
Le code SQL généré doit passer une vérification par liste blanche (vues système autorisées, lecture seule, instruction unique, nom entièrement qualifié et restrictions de portée). Si la validation réussit, l'outil renvoie une ébauche SQL et les arguments d'exécution optionnels execute_args.
Étant donné que MaxCompute SQLCost ne prend pas encore en charge Information Schema au niveau du locataire, ce mode ignore explicitement l'estimation de l'utilisation des ressources. Lors de l'exécution réelle, maxcompute_sql_execute effectue à nouveau les mêmes contrôles de sécurité.
Résultats et exécution ultérieure
L'outil renvoie les éléments suivants : query_domain, un code SQL en lecture seule validé structurellement, les tables physiques ou vues système utilisées, les hypothèses, les avertissements et, le cas échéant, une estimation de l'utilisation des ressources. L'outil n'exécute pas le code SQL. Si le résultat inclut execute_args, vous pouvez les transmettre sans modification à maxcompute_sql_execute après confirmation de l'utilisateur.
Le client n'a pas besoin de construire ni d'interpréter les paramètres d'exécution internes pour Information Schema. L'outil d'exécution reconnaît automatiquement les vues système, ajoute les paramètres serveur nécessaires et valide à nouveau le code SQL de manière indépendante. La politique OBO définie dans la requête SQL constitue la limite supérieure de l'autorisation déléguée. Toutes les requêtes sont soumises sous l'identité MaxCompute de l'appelant MCP actuel, et MaxCompute les valide en fonction des autorisations réelles.
Flux de travail recommandé
Générez et examinez d'abord le code SQL. Vérifiez les hypothèses, la logique de sélection des tables et les résultats de la validation.
Pour les requêtes gourmandes en ressources ou couvrant une large portée, contrôlez le volume de données analysées estimé et l'utilisation des CU.
Exécutez la requête uniquement après avoir obtenu le consentement explicite de l'utilisateur.
FAQ
-
Aucun code SQL n'a été généré pour une question portant sur une table métier
La requête est trop vaste et le paramètre
sourcesn'est pas fourni. Spécifiez le projet, le schéma ou une table précise. Pour les requêtes Information Schema, n'ajoutez pas de table métier comme source pour contourner un échec de découverte. Vous devez plutôt spécifier l'objet à analyser, les métriques et la fenêtre temporelle. -
Plusieurs jeux de données similaires ont été trouvés
Ne laissez pas l'Agent deviner. Sélectionnez explicitement la portée de données correcte.
-
SQLCost ne s'est pas exécuté
En mode table métier, cela est généralement dû à l'absence de
analysis_context. En mode Information Schema, l'outil l'ignore systématiquement car MaxCompute SQLCost ne prend pas encore en charge les vues système au niveau du locataire. Le résultat de l'estimation de l'utilisation des ressources seraunavailable. -
L'outil a renvoyé
rejected:Le contenu généré contient des opérations d'écriture, plusieurs instructions ou des références de tables qui contournent
sources. -
Le code SQL Information Schema a été rejeté :
La requête utilise des tables physiques inconnues ou mixtes, n'utilise pas le nom complet de la vue système, omet la clause
LIMITou s'exécute sur une vue historique dépourvue de la fenêtre standarddsde 1 à 14 jours.
Diagnostic des jobs
Scénarios
Identifiez les erreurs de compilation SQL, les colonnes manquantes ou les erreurs de syntaxe.
Analysez les jobs ayant échoué, ceux dont l'exécution est longue ou présentant une utilisation anormale des ressources.
Examinez les plans d'exécution, la progression des étapes, les résumés de l'utilisation des ressources et les signaux d'erreur dans la chronologie.
Approfondissez l'analyse en consultant les journaux des workers ayant échoué ou d'autres preuves si l'analyse initiale reste inconclusive.
Entrées
Pour chaque appel, spécifiez le job à l'aide de l'une des méthodes suivantes :
Les paramètres
instance_idetproject. ouUne URL Logview HTTPS prise en charge.
|
Paramètre |
Obligatoire |
Description |
|
|
Conditionnel |
L'ID de l'instance MaxCompute. Si vous utilisez ce paramètre, spécifiez également |
|
|
Conditionnel |
Le projet contenant l'instance. Vous pouvez omettre ce paramètre si l'URL Logview inclut le nom du projet. |
|
|
Conditionnel |
Une URL Logview prise en charge. Le service analyse cette URL localement. Il n'envoie aucune requête vers l'URL et n'effectue aucune redirection. |
|
|
Non |
Le schéma d'exécution du job. Ce paramètre est généralement omis pour les projets traditionnels à deux niveaux. |
|
|
Non |
La région dans laquelle le job s'exécute. |
|
|
Non |
La fenêtre temporelle pour la comparaison historique. La valeur par défaut est de 7 jours. La plage autorisée va de 1 à 30 jours. |
|
|
Non |
|
N'incluez pas les journaux bruts, les plans d'exécution, les résultats de diagnostic existants ou les jetons Logview en tant que paramètres distincts. Le jeton temporaire présent dans une URL Logview constitue une information sensible. Ne le copiez pas dans les tickets, la documentation ou les journaux de discussion.
Exemple : Diagnostic d'un job ayant échoué
{
  "instance_id": "<INSTANCE_ID>",
  "project": "sales_dw",
  "region": "cn-shanghai",
  "depth": "standard"
}
Invite en langage naturel :
Diagnose job <INSTANCE_ID> in sales_dw. First, identify the failed stage and the most likely cause.
Provide actionable recommendations for a fix. Do not rerun or cancel the job.
Exemple : Réalisation d'une analyse approfondie
Perform a deep dive on this job. The initial analysis did not explain the root cause.
Check the available logs from failed workers and stage evidence.
Distinguish between confirmed facts, inferences, and missing evidence.
Lors de l'appel suivant, l'agent doit utiliser la même référence de job et définir depth=deep. L'analyse approfondie reste soumise aux limites imposées sur le nombre de lectures, la taille des journaux et les délais d'expiration. Elle ne lira pas les journaux indéfiniment.
Interprétation des résultats
root_cause.kind: La catégorie de cause principale, telle qu'une erreur de syntaxe SQL, une distorsion des données, un balayage complet de table, une UDF lente, une contention des ressources, un job de longue durée ou des frais généraux d'exécution.root_cause.confidence: Le niveau de confiance basé sur les preuves disponibles. Il ne s'agit pas d'une probabilité de succès.findings: Les problèmes identifiés et leurs niveaux de gravité.recommendations: Des recommandations en lecture seule pour les corrections, telles que la modification du code SQL, la vérification de la distribution des données ou l'ajustement du planning d'exécution.evidence: Les preuves étayantes issues des données d'état, de plan, d'étape, de journal et de chronologie.missing_evidence: Une déclaration explicite indiquant que le plan, la progression des étapes, les journaux des workers ou les données de comparaison historique ne sont pas disponibles.
La réussite d'un job ne signifie pas l'absence de problèmes. Le coût d'un job réussi de petite taille peut être dominé par les frais généraux liés à la compilation, à la planification et au démarrage. Dans ce cas, l'outil peut signaler que « les frais généraux d'exécution sont dominants » au lieu d'inventer un goulot d'étranglement au niveau des ressources.
Analyse des quotas
Scénarios
Consultez l'utilisation actuelle du CPU et l'utilisation historique de la capacité des quotas Subscription de niveau 2.
Recherchez les quotas de calcul associés à des jobs actifs au cours des 7 derniers jours, y compris les quotas Subscription, Pay-As-You-Go et Spot.
Comparez les quotas en fonction de la consommation réelle des jobs et identifiez ceux présentant une utilisation élevée du CPU.
Analysez le niveau de capacité des quotas Subscription. Pour les quotas Pay-As-You-Go et Spot, analysez uniquement la consommation des jobs et les jobs anormaux.
Effectuez des diagnostics de jobs supplémentaires sur les jobs à forte consommation ou anormaux.
Paramètres d'entrée
|
Paramètre |
Obligatoire |
Description |
|
|
Non |
La région où se trouve le quota. |
|
|
Non |
Le surnom exact, visible par l'utilisateur, du quota de calcul. Si vous omettez ce paramètre, l'outil recherche les quotas associés à des jobs actifs dans la région sélectionnée au cours des 7 derniers jours. |
|
|
Non |
Le problème de ressource à analyser. Si vous omettez ce paramètre, l'outil identifie les jobs présentant la consommation de ressources la plus élevée. |
L'outil accepte uniquement les trois paramètres optionnels listés ci-dessus. Il n'accepte pas les projets, les utilisateurs, les structures de table, le code SQL pré-généré, les seuils ou le contexte de diagnostic. L'outil ne soumet pas de requêtes SQL Information Schema. Il ne nécessite pas que l'identité actuelle dispose d'autorisations Information Schema ou d'autorisations pour exécuter des projets.
La fenêtre d'analyse des jobs est limitée à un maximum de 7 jours. Les résultats couvrent uniquement la portée des jobs renvoyés dans la réponse. Si les preuves sont incomplètes, l'outil indique les informations manquantes à l'aide des champs partial, warnings ou missing_evidence. L'utilisation historique de la capacité s'applique uniquement aux quotas Subscription de niveau 2 disposant d'une capacité fixe. Les quotas Pay-As-You-Go et Spot n'ayant pas de dénominateur de capacité fixe, l'outil ne renvoie ni pourcentages de capacité ni recommandations de planification de capacité pour ces derniers.
Nom et surnom du quota
Les quotas MaxCompute possèdent deux identifiants :
Surnom : Le nom visible par l'utilisateur. Cette valeur est utilisée pour le paramètre
quota_nicknameet pour la sélection d'un quota lors de l'exécution SQL, par exempleteam_etl_quota.Nom : Le nom physique interne renvoyé par l'API de quota. Il identifie l'objet quota et ne peut pas être utilisé comme valeur pour
quota_nickname.
Lorsque vous spécifiez quota_nickname, transmettez le surnom exact. Si vous omettez ce paramètre, l'outil recherche les quotas utilisés par des jobs au cours des 7 derniers jours. Si la portée des résultats est limitée, la sortie indique clairement ce qui n'est pas couvert.
Exemple : Analyse d'un quota
{
  "region": "cn-shanghai",
  "quota_nickname": "team_etl_quota",
  "question": "Analyze the 10 jobs with the highest CPU usage in the last 7 days and describe any verifiable abnormal signals"
}
Requête en langage naturel :
Analyze team_etl_quota in cn-shanghai. Find the jobs with the highest CPU consumption in the last 7 days. Attribute a job as abnormal only if there are direct abnormal signals for the job. Otherwise, state that the cause is unknown. Provide only recommendations. Do not modify quotas or jobs.Exemple : Comparaison des quotas actifs dans la fenêtre
Omettez quota_nickname :
{
  "region": "cn-shanghai",
  "question": "Compare compute quotas with active jobs in the last 7 days, sorted by job CPU usage. List capacity utilization separately for Subscription quotas, but do not calculate capacity percentages for Pay-As-You-Go and Spot quotas"
}
Requête en langage naturel :
Compare my compute quotas in cn-shanghai that had active jobs in the last 7 days, including Subscription, Pay-As-You-Go, and Spot.
Sort them by job CPU usage and list high-consumption jobs. Add capacity utilization only for Subscription quotas.
Instantané actuel, consommation historique et utilisation historique
Ces trois concepts ne doivent pas être confondus :
|
Données |
Signification |
Prise en charge actuelle |
|
|
L'utilisation actuelle du CPU. Il ne s'agit pas d'un pourcentage compris entre 0 et 1. |
S'applique uniquement aux quotas Subscription et n'est valide que lorsque |
|
Jobs à forte consommation |
La consommation cumulée de CPU et de mémoire des jobs au cours des 7 derniers jours. |
Prend en charge les quotas Subscription, Pay-As-You-Go et Spot. Les valeurs inconnues ne sont pas incluses dans le tri ou l'agrégation. |
|
Utilisation historique du quota |
Les niveaux moyens, de pointe et P90 d'une capacité fixe au fil du temps. |
S'applique uniquement aux quotas Subscription de niveau 2 disposant d'une capacité fixe. |
La consommation cumulée de CPU et de mémoire des jobs n'est pas identique à l'utilisation historique d'un quota. Si un quota ne dispose d'aucune capacité fixe ou de données historiques, l'outil ne déduit pas le niveau moyen, le pic ou le P90 à partir de la consommation des jobs. L'outil ne génère pas non plus de recommandations de planification de capacité pour les quotas Pay-As-You-Go ou Spot.
Exigences relatives à Information Schema
Generate SQL peut utiliser les vues Information Schema au niveau du locataire. L'analyse des quotas pour l'utilisation de la capacité et les preuves liées aux jobs n'utilise pas Information Schema. Generate SQL autorise uniquement les vues figurant sur la liste blanche côté serveur, telles que :
SYSTEM_CATALOG.INFORMATION_SCHEMA.TASKSSYSTEM_CATALOG.INFORMATION_SCHEMA.TASKS_HISTORY
Lorsque Generate SQL utilise ces vues, il doit respecter les conditions suivantes :
L'identité actuellement authentifiée doit disposer d'autorisations de lecture pour Information Schema au niveau du locataire. Les comptes Root disposent généralement de cet accès par défaut. L'accès pour les utilisateurs RAM ou les rôles RAM dépend de la configuration définie par l'administrateur du locataire.
L'identité actuelle doit disposer d'au moins un projet MaxCompute visible dans la région cible. Ce projet est utilisé pour soumettre des requêtes SQL Information Schema en lecture seule. L'identité doit également disposer des autorisations requises pour créer des instances de requête.
La région cible doit fournir les vues au niveau du locataire mentionnées ci-dessus ainsi que leurs dépendances backend.
Limitations de sécurité et de portée :
Generate SQL lit les vues au niveau du locataire enregistrées par les compétences intégrées, mais il ne peut pas interroger des vues système inconnues ni mixer des requêtes avec des tables physiques.
Avant que le modèle ne sélectionne une vue système, Generate SQL charge la compétence racine d'Information Schema. Il utilise la granularité des données, l'actualité et les colonnes de la vue pour déterminer la source de faits requise. Une fois la vue sélectionnée, Generate SQL charge la documentation complète des colonnes pour cette vue.
Les ébauches de vues système pour Generate SQL doivent inclure une plage temporelle et une clause
LIMIT.Les requêtes sont toujours en lecture seule. Elles ne modifient ni les quotas, ni les configurations de planification, ni les jobs.
Latence des données
TASKS_HISTORY n'est pas une interface en temps réel. Elle présente généralement un délai de synchronisation des données d'environ 5 minutes. Les jobs venant de se terminer peuvent ne pas être immédiatement disponibles. Réessayez ultérieurement. Le délai peut être plus long selon la région, la vue et le volume de données. Par conséquent, n'utilisez pas les vues historiques pour vérifier l'état en temps réel à la seconde près. Pour vérifier l'état en temps réel d'un job, utilisez l'état de l'instance SQL ou un outil de diagnostic de job.
Erreurs d'autorisation et de vue
L'appelant ne dispose pas d'autorisations au niveau du locataire : Generate SQL renvoie explicitement une erreur d'autorisation Information Schema.
Aucun projet d'exécution dans la même région : Generate SQL renvoie un message indiquant qu'il manque un projet visible par l'appelant pour exécuter la requête Information Schema.
La dépendance backend d'une vue système n'est pas disponible : Le résultat indique que la vue n'est pas disponible. Le texte d'erreur peut montrer que le propriétaire de la vue système n'est pas identique à l'identité actuellement authentifiée. N'attribuez pas à tort le problème au compte de l'appelant sur la base de cette information.
Cas d'utilisation des outils d'analyse intelligente
Du problème métier à l'exécution et au diagnostic
1. Use maxcompute_generate_sql to generate and validate the SQL for channel revenue over the last 30 days.
2. After reviewing and confirming the SQL, use maxcompute_sql_execute to run execute_args.
3. If the job fails or slows down significantly, use maxcompute_diagnose_job to analyze the instance.
Des points chauds des quotas aux causes profondes des jobs
1. Omit quota_nickname and use maxcompute_analyze_quota_usage to find compute quotas that have had jobs in the last 7 days.
2. Find high-consumption jobs based on actual job consumption. Check capacity utilization only for Subscription quotas.
3. Call maxcompute_diagnose_job for instances with abnormal signals.
4. Optimize the SQL or scheduling based on job evidence. Do not automatically scale up based only on historical consumption.
Analyse des jobs historiques pour un quota connu
Analyze the owner distribution and CPU consumption of failed jobs for team_etl_quota over the last 7 days.
Investigate the cause for the failed instance with the highest CPU consumption.
L'analyse des quotas ne génère ni n'exécute de code SQL Information Schema. Les résultats peuvent ne couvrir que certains jobs à forte consommation et ne peuvent pas être utilisés pour calculer le nombre total de jobs ayant échoué. Pour analyser davantage une instance, appelez l'outil de diagnostic de job.
Recommandations pour l'utilisation de l'outil d'analyse intelligente
Fournissez uniquement les champs de portée pris en charge par l'outil actuel. Pour la génération SQL, utilisez
region,sourceset le paramètre optionnelanalysis_context. Pour le diagnostic de job, utilisez le projet et l'ID d'instance ou une URL Logview. Pour l'analyse des quotas, utilisezregionet le surnom exact du quota. N'incluez pas de champs de contexte provenant d'autres outils dans l'appel actuel.Pour générer du code SQL pour une portée de données connue, fournissez
sources. Cela évite un processus de découverte trop large qui pourrait ne renvoyer aucun candidat ou plusieurs jeux de données ambigus.Pour le diagnostic de job, utilisez d'abord
standard. N'utilisezdeepque lorsque les résultats sont inconclusifs ou qu'une investigation plus poussée est nécessaire.Pour l'analyse des quotas, comparez d'abord les données de consommation des jobs renvoyées. Ensuite, examinez en détail quelques quotas et instances à forte demande. Ne considérez pas les résultats partiels comme une liste exhaustive.
Distinguez toujours les faits confirmés, les jugements du modèle et
missing_evidence.Les utilisateurs doivent confirmer séparément toute opération de mise à l'échelle, de planification, de migration, d'exécution SQL, de relance ou d'annulation.
Règles générales d'appel
Les outils peuvent accéder uniquement aux ressources MaxCompute pour lesquelles l'identité actuelle dispose d'une autorisation. Ne confondez pas la visibilité des outils avec l'autorisation d'accès aux ressources.
Après avoir identifié les tables candidates, consultez la structure exacte de la table avant de générer ou d'exécuter du code SQL. Ne devinez ni les colonnes, ni les partitions, ni le schéma en vous basant uniquement sur le nom de la table.
Le client doit obtenir une confirmation explicite de l'utilisateur avant d'effectuer des opérations d'écriture. Ces opérations incluent l'écriture de code SQL, la création de tables, l'insertion de données, la mise à jour des métadonnées et la modification de SemanticSpec. La passerelle n'effectue pas de confirmation secondaire interactive pour le client.
Pour les jeux de résultats volumineux, utilisez la pagination, réduisez la portée de la requête ou lisez les données depuis une instance asynchrone. Local MCP peut également écrire dans un fichier local via
file://output_uri. Ce chemin fait référence à la machine où s'exécute Local MCP, et non à la machine cliente MCP.Le paramètre
execution_modedemaxcompute_sql_executeest défini par défaut surwlm. Lorsque vous utilisez MaxQA (MCQA v2), transmettez explicitementexecution_mode=maxqaainsi que lequota_nameinteractif. Ne transmettez pas simultanémentsettings.odps.task.wlm.quota. Pour les appels ultérieurs concernant l'état, les résultats ou l'annulation, transmettez uniquement leprojectet l'instance_id. Ne transmettez ni n'enregistrez la connexion MaxQA côté serveur ni les cookies associés.
Cas d'utilisation
-
Parcourir les projets et les tables
List the MaxCompute projects I can access, and see what schemas are in my_project. View the columns, partition keys, and table comment for the user_info table in the default schema of my_project. -
Exécuter des requêtes SQL en toute sécurité
First, view the structure of the orders table, and then estimate the scanned data volume and CU usage for this SQL query:
SELECT COUNT(*) FROM orders WHERE dt='2026-05-01'
Run a read-only query in my_project: SELECT * FROM default.orders WHERE dt='2026-05-01' LIMIT 100 -
Traiter les requêtes volumineuses de manière asynchrone
Run this query asynchronously. After the instanceId is returned, poll its status and read the first 100 rows of the result upon completion. -
Exporter des résultats volumineux (Local MCP uniquement)
Run this query synchronously and write the full result to file:///tmp/maxcompute-result/orders.jsonl;
In the response, return only a preview and the final outputPath.
L'
output_uriécrit dans le système de fichiers local de la machine exécutant Local MCP, et non sur la machine cliente. Remote MCP ne prend pas en charge l'écriture dans des fichiers locaux sur le serveur. Utilisez les paramètres de pagination demaxcompute_sql_fetch_resultpour lire les résultats page par page. -
Vérifier l'identité et les autorisations
View the current MaxCompute identity used by MCP, and list my permissions in my_project. -
Rechercher des métadonnées
Search for tables in my_project whose names contain 'orders'. -
Consulter les quotas
List the MaxCompute quotas available to my current identity, and view the details of the default quota. -
Recherche dans la base de connaissances et questions-réponses
How do I use dynamic partition inserts in MaxCompute? Search the documentation and provide an answer with citations.What is the difference between ODPS clustered tables and regular tables? When is it appropriate to use a clustered table? -
Utiliser Information Schema pour la gouvernance et l'analyse O&M
Analyze the top 10 tables that consume the most storage in the current tenant.Which tasks consumed the most compute resources in the last week? Summarize by owner and project.Remote MCP intègre un package sémantique Information Schema, ce qui vous permet d'utiliser directement ces invites. Pour Local MCP, vous devez d'abord installer le Skill correspondant dans votre environnement client ou Agent afin d'activer ces scénarios.
-
Gérer les métadonnées métier des tables
First, read the current structure of default.orders, then change the table comment to "Orders fact table",
and change the comment for the buyer_id column to "Buyer ID".
L'outil
update_tableprend en charge les modifications suivantes :Commentaire de table :
description.Libellés :
labels.Cycle de vie :
expiration.days,expiration.partitionDays.Commentaires de colonne :
columns.setComments.Passer une colonne de premier niveau de NOT NULL à NULL :
columns.setNullable.Ajouter de nouvelles colonnes :
columns.add.
Cet outil ne permet pas de supprimer des colonnes, de modifier les types de colonnes, de réorganiser les colonnes, d'insérer des colonnes au milieu, de passer une colonne nullable à NOT NULL ou de modifier la nullabilité des colonnes imbriquées.
-
Créer une table et insérer un petit volume de données
Create a test table demo_user in my_project.default, with columns id BIGINT and name STRING, a partition column dt STRING, and a 7-day lifecycle.Insert two rows of test data into the demo_user table, in the dt='2026-05-18' partition.Ces opérations modifient les ressources MaxCompute. Accordez des autorisations uniquement sur un projet de test ou un projet contrôlé.
-
Gérer SemanticSpec
Create a SemanticSpec named sales_metrics that references my_project.default.orders.
Set the description to "Sales metrics semantic layer" and add a "certified" label.
Read the dataReferences, semanticModel, and metricDefinitions from the USER_DRAFT of sales_metrics. Then, use the returned revision_id as the expected_draft_revision_id to update the metric definitions.Pour mettre à jour le contenu d'un SemanticSpec, utilisez la révision actuelle issue du résultat de lecture afin d'éviter d'écraser des modifications concurrentes. Nous recommandons de générer, d'appliquer et de publier les modifications en trois étapes distinctes. L'action d'actualisation déclenche uniquement un DataScan et n'applique ni ne publie automatiquement les modifications.
Le Skill
maxcompute-semantic-specdans Remote MCP fournit des règles pour le format complet de la section, la gestion des conflits de révision et l'interrogation de l'état DataScan. Si le client ne charge pas automatiquement les ressources Skill, appelez d'abordmaxcompute_skill_listpour vérifier la disponibilité du Skill, puis appelezmaxcompute_skill_readpour lire le point d'entrée et les fichiers de référence. La réponse detools/listconfirme la disponibilité effective d'un Skill.
Dépannage
Si un message d'erreur inclut un ID de requête, notez l'ID de requête, le nom de l'outil, l'horodatage avec fuseau horaire et le code d'erreur expurgé pour le dépannage. N'enregistrez ni ne diffusez de jetons, de codes d'autorisation, de code SQL métier sensible, d'informations de compte sensibles ou de tout contenu Logview qui ne doit pas être partagé en externe.
Le client MCP ne trouve pas les outils
Pour les connexions OAuth directes via navigateur, assurez-vous que le point de terminaison du service Remote MCP inclut
/mcpet que la même configuration client ne mélange pas les points de terminaison réseau public et VPC.Vérifiez que le client utilisé pour la connexion directe OAuth via navigateur prend en charge Streamable HTTP, OAuth et
tools/list.Vérifiez si la
commanddu lanceur local pointe versalibabacloud-maxcompute-mcp-serverinstallé, et sialibabacloud-maxcompute-mcp-server --helps'exécute correctement dans le même environnement d'exécution.Vérifiez si
MAXCOMPUTE_CATALOG_CONFIGpointe vers un fichier de configuration lisible, ou siMAXCOMPUTE_REGIONetMAXCOMPUTE_NETWORKsont tous deux définis.Vérifiez si
defaulta sélectionnélocalcar Remote MCP n'est pas disponible. Si les dépendances locales sont manquantes, installezalibabacloud-maxcompute-mcp-server[local]comme indiqué dans le message d'erreur.Vérifiez si la liste des outils disponibles inclut l'outil cible. Remote MCP utilise les noms d'outils
maxcompute_*, tandis que le modelocalutilise les noms d'outils SDK d'origine. Les deux ne sont pas directement interchangeables.Après avoir modifié la configuration, redémarrez Cursor, Claude Code ou le client MCP correspondant.
Échecs d'authentification, de connexion ou d'autorisation
Pour les connexions directes OAuth via navigateur, vérifiez que l'utilisateur a terminé l'autorisation OAuth Alibaba Cloud. Si la page OAuth ne s'ouvre pas, vérifiez si le client prend en charge MCP OAuth et si le navigateur local ou le port de rappel est bloqué.
Si vous recevez une erreur 401 avec une connexion directe OAuth via navigateur, réautorisez l'accès et vérifiez que le jeton d'accès enregistré par le client est valide.
Vérifiez que le lanceur local a obtenu un AccessKey valide, des informations d'identification temporaires STS, un URI d'informations d'identification ou des informations d'identification issues de la chaîne d'informations d'identification par défaut. Assurez-vous que le jeton de sécurité STS n'a pas expiré. Le lanceur local ne nécessite pas d'OAuth via navigateur.
Vérifiez que la
regionet lenetworkcorrespondent à l'environnement MaxCompute cible et que les adresses de service FE et CatalogAPI dans la configuration d'origine pointent vers la même région et le même type de réseau.Vérifiez que votre environnement VPC peut accéder au point de terminaison VPC CatalogAPI et au point de terminaison VPC MCP dans la même région. Une configuration VPC ne peut pas être utilisée pour se connecter à un point de terminaison MCP réseau public.
Le mode
remoterenvoie une erreur lorsque Remote MCP n'est pas disponible. Le modedefaulttente d'utiliser l'outil SDK local.En cas d'erreur 403, assurez-vous que le compte Alibaba Cloud actuel dispose des autorisations MaxCompute et RAM pour le projet cible.
Vérifiez que l'ID de région cible dans la conversation ou les paramètres de l'outil est correct. S'il n'est pas spécifié explicitement, le service utilise la région par défaut du point d'entrée actuel.
Lorsque vous utilisez un URI d'informations d'identification, assurez-vous que la machine exécutant le lanceur peut accéder à
ALIBABA_CLOUD_CREDENTIALS_URI.Utilisez
maxcompute_access_checkde Remote MCP oucheck_accessdu modelocalpour vérifier votre identité actuelle avant de procéder au dépannage de l'outil spécifique.
Échecs de recherche de métadonnées
Le maxcompute_schema_search_metadata pour Remote MCP et le search_meta_data pour le mode local utilisent la même syntaxe de requête Catalog. Les causes d'erreur courantes incluent :
Vous utilisez
search_meta_dataen modelocal, maisnamespaceIdouMAXCOMPUTE_NAMESPACE_IDn'est pas configuré. Remote MCP ne nécessite pas cette configuration.L'instruction de requête omet
type=TABLE,type=RESOURCEoutype=SCHEMA.Utilisation de conditions de projet et de région incompatibles dans la même requête.
Échecs d'analyse, d'exécution ou de récupération des résultats SQL
Si la résolution du nom de table SQL échoue, utilisez d'abord maxcompute_schema_describe_table de Remote MCP ou get_table_schema de Local MCP pour lire le schéma de la table, afin que l'agent puisse utiliser la référence de table précise renvoyée. Les formats de nom de table courants sont schema.table ou project.schema.table pour un modèle à trois couches, et table ou project.table pour un modèle à deux couches.
Si Remote MCP rejette une instruction SQL en tant qu'opération d'écriture, confirmez que l'utilisateur a l'intention d'effectuer l'écriture et utilisez explicitement mode=write après avoir reçu la confirmation. Ne modifiez pas le mode pour contourner la vérification en lecture seule.
Si l'exécution SQL expire ou si le résultat est tronqué :
-
Privilégiez l'exécution asynchrone.
Remote MCP utilise
maxcompute_sql_get_statusetmaxcompute_sql_fetch_resultpour poursuivre l'interrogation.Local MCP effectue les requêtes de suivi en utilisant
get_instance_statusetget_instance.
Remote MCP utilise
limitetcursorpour paginer et réduire la portée de la requête. Local MCP peut également utiliseroutput_uri=file:///path/to/result.jsonlpour écrire sur la machine où s'exécute Local MCP.Avant d'exécuter l'opération, appelez l'outil d'estimation d'utilisation des ressources correspondant et limitez la consommation de ressources en fonction des définitions de paramètres dans
tools/list.
Package sémantique Information Schema
Le package sémantique Information Schema est conçu pour les opérations système et la gouvernance. Il utilise les vues de métadonnées INFORMATION_SCHEMA au niveau du locataire de MaxCompute pour transformer les métadonnées de bas niveau en métriques, entités et procédures opérationnelles qu'un agent peut interroger directement.
Remote MCP intègre un package sémantique Information Schema. Après vous être connecté à Remote MCP, vous pouvez poser à l'agent des questions sur la gouvernance et les opérations, telles que le stockage, les coûts, les autorisations et les jobs, sans installer de Skills supplémentaires. L'analyse des quotas utilise un chemin de données distinct en lecture seule et n'exécute pas de code SQL Information Schema.
Local MCP fournit uniquement des outils MaxCompute MCP locaux. Pour utiliser ces scénarios sémantiques avec Local MCP, vous devez installer le Skill suivant dans votre environnement client ou agent :
https://skills.alibabacloud.com/skills/alibabacloud-odps-information-schema
Les scénarios typiques incluent :
|
Scénario |
Fonctionnalité |
|
Diagnostic de la pression de stockage |
Identifie les tables consommant le plus de stockage, les risques de gonflement des partitions et les problèmes de fraîcheur des données. |
|
Diagnostic de la pression des coûts |
Ventile la consommation de calcul par propriétaire, projet et type de job pour identifier les jobs à forte consommation. |
|
Analyse de la hausse des échecs de jobs |
Analyse en profondeur les jobs ayant échoué par type, propriétaire et projet pour aider à identifier les causes racines. |
|
Audit de l'exposition des autorisations |
Audite la distribution des octrois au niveau des tables pour identifier les comptes à privilèges élevés et les risques de sur-octroi. |
|
Surveillance des tables fréquemment consultées |
Identifie les tables fréquemment consultées et repère les tables obsolètes en fonction de leur dernier accès. |
|
Analyse des lacunes en matière de gouvernance des métadonnées |
Mesure la couverture des commentaires de tables et de colonnes pour identifier les lacunes de gouvernance. |
|
Analyse des performances des jobs |
Analyse la durée moyenne et P99 des jobs pour identifier les jobs lents à longue traîne et les anomalies de mise en file d'attente. |
|
Audit Data Tunnel |
Suit les volumes de téléchargement et de téléversement Tunnel pour détecter les comportements de transfert anormaux. |
|
Audit des rôles utilisateur |
Examine les mappages utilisateur-rôle pour vérifier les attributions de rôles administrateur. |
|
Analyse du cycle de vie des partitions |
Surveille les tendances de croissance du nombre de partitions et vérifie que les politiques de cycle de vie sont appliquées. |
Précautions de sécurité
Les utilisateurs généraux doivent utiliser le serveur MCP distant. Ne configurez pas d'AccessKey à long terme sur un serveur MCP local à des fins d'essai.
-
Utiliser des clients de confiance
Configurez et accédez aux points de terminaison de production uniquement via des clients MCP de confiance. N'effectuez pas de requêtes MCP depuis des pages non fiables.
-
Effectuer vous-même l'autorisation OAuth
Effectuez vous-même les étapes sur la page de confirmation OAuth. Ne laissez pas d'autres personnes le faire à votre place.
-
Utiliser un compte avec le moindre privilège
Les autorisations d'un compte déterminent les ressources MaxCompute auxquelles MCP peut accéder. Utilisez un compte disposant uniquement des autorisations nécessaires.
-
Ne pas divulguer d'informations d'identification sensibles
Ne partagez pas de jetons, de jetons d'actualisation, de codes d'autorisation, de clés ou d'URL de rappel dans des conversations, tickets, documents ou captures d'écran.
Ne commitez pas votre AccessKey, votre jeton STS,
config.jsonou votre URI Credentials dans Git.
-
Confirmer explicitement les opérations d'écriture
Avant d'exécuter une opération d'écriture, confirmez que le client affiche le projet cible, la table, le code SQL ou un résumé des modifications. Vérifiez que les informations sont correctes avant de continuer.
Canaux de feedback
Pour fournir un feedback sur le service Remote MCP, la compatibilité client, les erreurs d'outil, les problèmes de documentation ou les suggestions de fonctionnalités, utilisez les canaux suivants :
Vous pouvez également demander à l'agent de lire skill://maxcompute-mcp-feedback/SKILL.md pour obtenir le lien vers le modèle de problème, les champs de diagnostic suggérés et les règles d'expurgation. Cette ressource ne crée pas de problème GitHub, ne télécharge pas de journaux et n'enregistre pas votre feedback.
Avant de soumettre, assurez-vous que le problème ne contient aucun des éléments suivants : jetons, cookies, AccessKeys, URL de rappel OAuth avec paramètres de requête, code SQL sensible, données client ou contenu Logview sensible.
Pour les problèmes liés aux autorisations au niveau du compte, à la facturation, aux accords de niveau de service (SLA), aux pannes de production, aux vulnérabilités de sécurité ou aux données confidentielles, contactez le support officiel Alibaba Cloud ou les canaux de sécurité. Ne signalez pas ces problèmes dans un ticket public.