Présentation
Le type de données Blob (Binary Large Object) dans MaxCompute permet de stocker directement dans des tables de grands objets binaires non structurés, tels que des images, des fichiers audio, des vidéos et des documents. L'utilisation du type Blob permet de regrouper les fichiers bruts, les métadonnées et les données d'annotation des données multimodales au sein d'une seule table MaxCompute. Vous pouvez ainsi utiliser SQL pour des requêtes et une maintenance unifiées, et effectuer un traitement par lots avec MaxFrame et des fonctions définies par l'utilisateur (UDF) SQL.
Cas d'utilisation
Gestion des jeux de données d'entraînement IA : Stockez des images, des fichiers audio ou vidéo ainsi que leurs libellés et annotations correspondants dans une seule table, et utilisez SQL pour filtrer des échantillons de données spécifiques.
Pipelines de traitement de données multimodales : Unifiez le stockage des résultats intermédiaires et finaux issus de pipelines en plusieurs étapes, tels que l'extraction d'images vidéo, la transcription audio-texte et l'étiquetage du contenu.
Couche de cache pour le traitement multimodal : Servez de couche de mise en cache pour des sources de données telles que le stockage d'objets afin d'améliorer le débit du calcul parallèle à grande échelle avec MaxFrame et SQL, en contournant les limites de QPS associées aux demandes par lots de petits fichiers.
Ingestion de données non structurées : Importez des fichiers depuis divers systèmes de stockage externes vers MaxCompute et enrichissez-les avec des métadonnées pour créer une bibliothèque d'actifs non structurés de niveau entreprise, en tirant parti des garanties transactionnelles et du contrôle d'accès unifié.
Spécifications
Fonctionnalité | Description |
Limite de taille | Jusqu'à 5 Go par objet Blob dans une cellule. |
Format de stockage | Format binaire |
Format de table pris en charge pour Blob | Ajoutez Delta Table. Les colonnes Blob héritent des fonctionnalités du format de table, y compris les transactions ACID, la hiérarchisation du stockage et les snapshots. |
Services d'optimisation Blob |
|
Limitations
Activez les types de données MaxCompute 2.0 :
SET odps.sql.type.system.odps2=true;.Le type Blob ne peut pas être imbriqué dans des types complexes tels que ARRAY, MAP ou STRUCT.
Une colonne Blob ne peut pas servir de clé primaire ou de clé de partition.
Une colonne Blob ne peut pas être utilisée dans les clauses ORDER BY, GROUP BY ou JOIN ON.
Stockage multimodal unifié
La figure suivante compare une architecture de stockage distribuée traditionnelle à l'architecture de stockage multimodal unifiée dans MaxCompute.
À gauche, l'approche traditionnelle stocke les fichiers bruts dans le stockage d'objets, tandis que les métadonnées et annotations sont dispersées dans différents entrepôts et lacs de données. L'interrogation et le traitement de ces données nécessitent une coordination entre plusieurs systèmes.
À droite, l'approche MaxCompute utilise le type de colonne Blob pour stocker des fichiers binaires (images, audio, vidéos) ainsi que leurs métadonnées structurées dans une seule table. Cela permet des requêtes SQL, un traitement par lots MaxFrame et des importations de données via SDK.
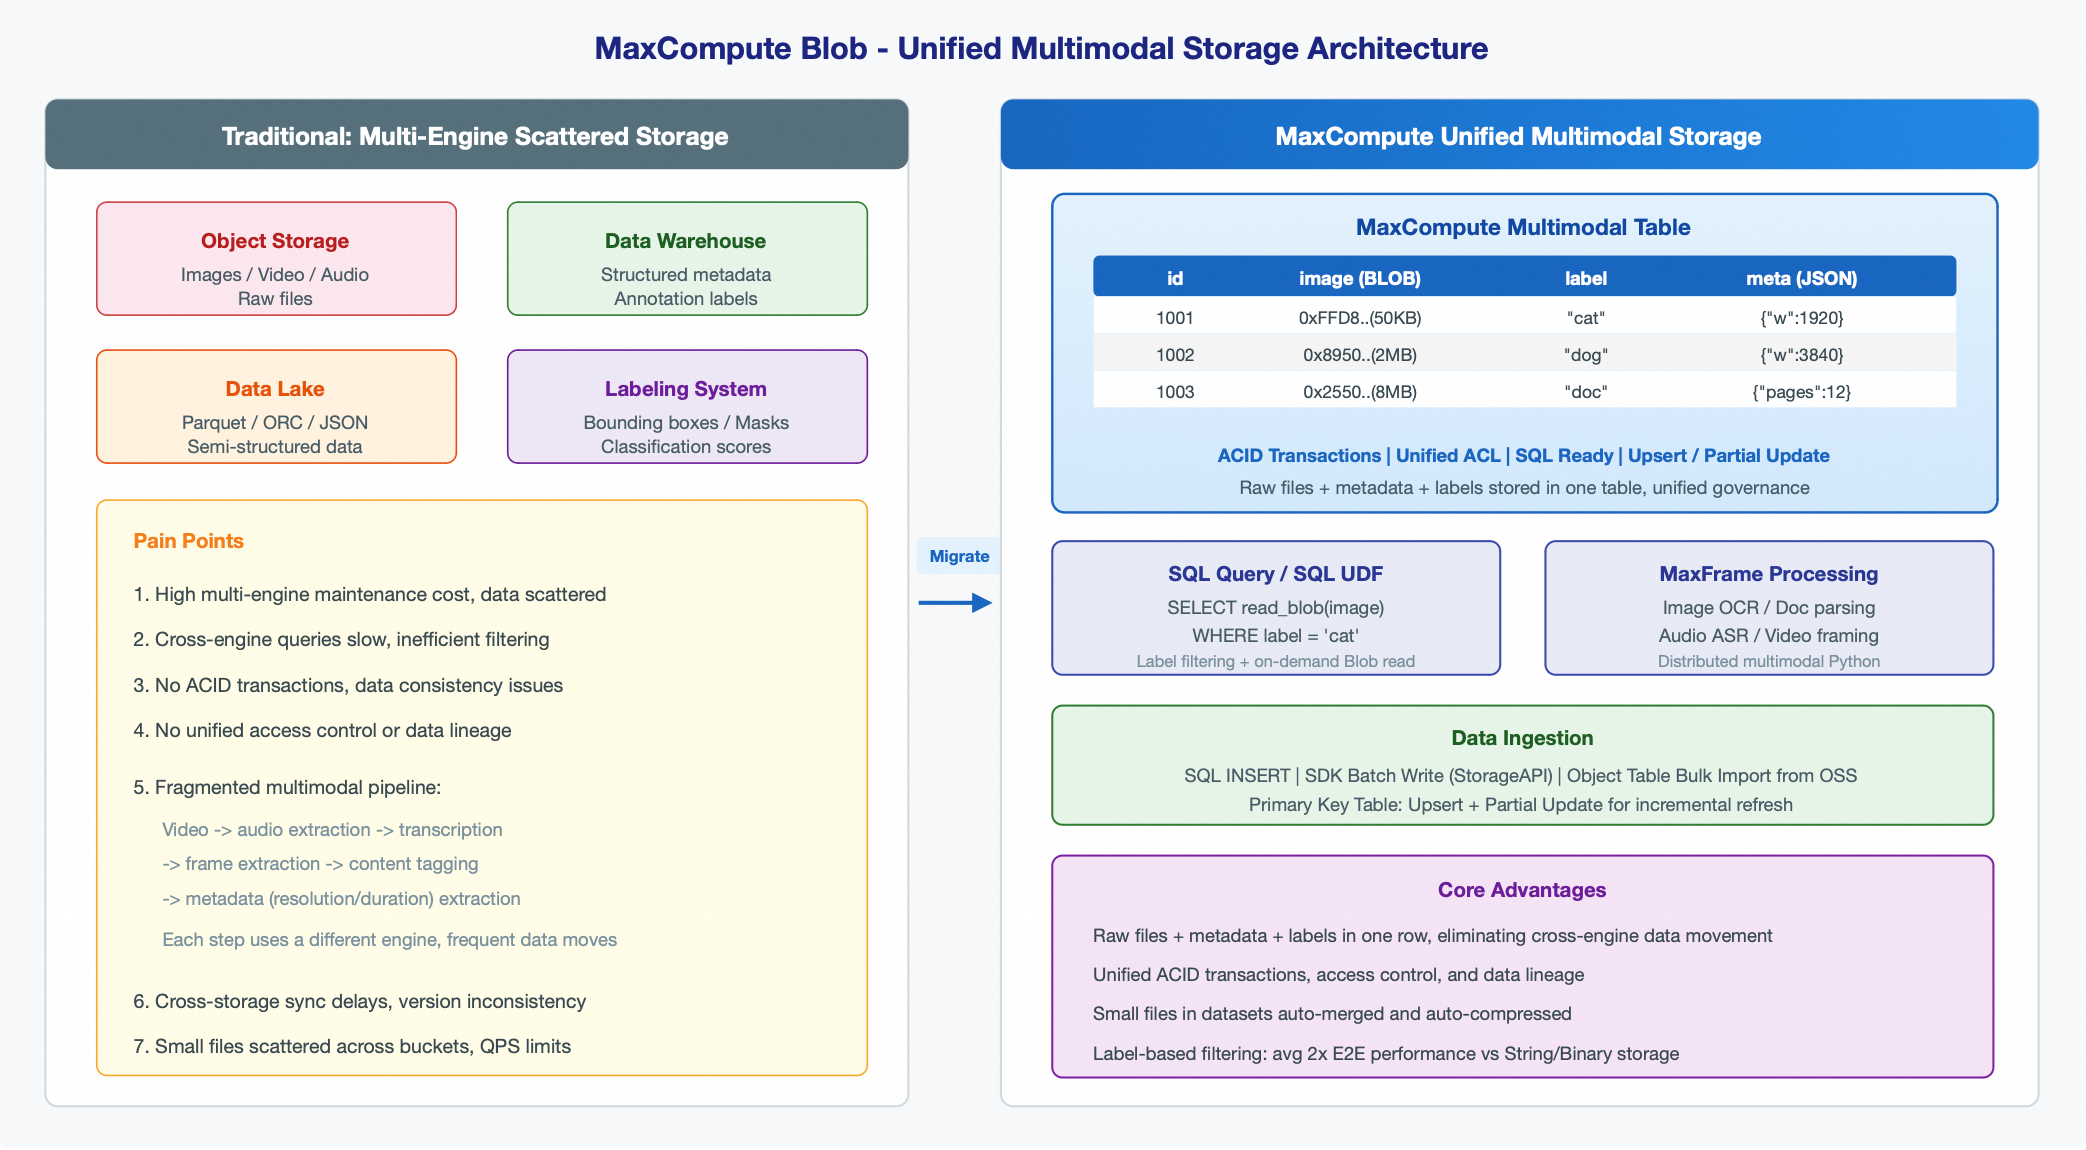
MaxCompute prend nativement en charge le type de colonne Blob, ce qui vous permet de stocker toutes les données, y compris les fichiers bruts, les métadonnées et les annotations, dans une seule table :
-- Example of a multimodal dataset table
CREATE TABLE multimodal_dataset (
    id          BIGINT NOT NULL,
    image       BLOB,                       -- Raw image binary
    label       STRING,                     -- Classification label
    bbox        STRING,                     -- Annotation bounding box (JSON)
    resolution  STRING,                     -- Resolution metadata
    created_at  DATETIME                    -- Ingestion time
) TBLPROPERTIES("table.format.version"="2");
Comparaison entre les approches traditionnelles et MaxCompute pour le multimodal
Les architectures traditionnelles répartissent les données multimodales (fichiers bruts, métadonnées, annotations) sur divers systèmes comme le stockage d'objets, les entrepôts de données et les lacs de données. MaxCompute résout ces défis en utilisant le type de colonne Blob pour unifier toutes les données dans une seule table :
|
Approche traditionnelle |
Solution MaxCompute |
|
Coûts de maintenance élevés : Une architecture multi-moteurs disperse les données, ce qui rend la gestion unifiée difficile. |
Stockage et gestion unifiés : Les fichiers bruts, les métadonnées et les annotations sont stockés dans une seule table, éliminant le besoin de maintenir plusieurs systèmes. |
|
Latence élevée pour les requêtes inter-moteurs : Le filtrage des images par libellé nécessite plusieurs étapes, telles que l'interrogation d'une base de données pour les métadonnées avant de récupérer les fichiers depuis le stockage d'objets. |
Filtrage direct avec SQL : Interrogez les données en fonction de conditions telles que les libellés ou les horodatages sans nécessiter d'accès en plusieurs sauts entre les systèmes. |
|
Absence de garanties ACID unifiées : La cohérence des données, les autorisations d'accès et la traçabilité des données ne peuvent pas être gérées de manière centralisée. |
Transactions ACID complètes et contrôle d'accès unifié : Chaque opération d'écriture est atomique et cohérente, et toutes les données sont gérées par le système d'autorisations MaxCompute. |
|
Pipelines de traitement fragmentés : Un flux de travail multimodal typique (extraction audio vidéo, transcription, découpage d'images, étiquetage du contenu et extraction de métadonnées) s'étend sur plusieurs systèmes, entraînant des mouvements de données fréquents. |
Pipeline de traitement unifié : Les résultats intermédiaires et finaux des pipelines en plusieurs étapes sont centralisés dans une seule table, éliminant les mouvements de données entre les systèmes. |
Modèle de stockage et avantages en matière de performances
Modèle de stockage
MaxCompute Blob utilise un modèle de stockage séparant la référence de l'entité, qui sépare les colonnes de données structurées des colonnes d'objets volumineux Blob en fichiers physiques distincts. Comme illustré dans la figure suivante, l'architecture comporte trois couches :
La couche d'accès fournit plusieurs méthodes d'accès, notamment SQL, MaxFrame, odpscmd, SDK et l'API Storage.
La couche de service gère la compaction, le routage des références Blob, la gestion des transactions ACID, la hiérarchisation du stockage et les sauvegardes.
-
La couche de stockage divise les données en :
Data File (fichier de données structurées) : Stocke les données des colonnes non-Blob (telles que id, label et metadata) et un pointeur de référence (Reference) vers la colonne Blob. Ces fichiers utilisent un format de stockage colonnaire standard qui prend en charge le pushdown de prédicats efficace et l'élagage de colonnes.
Blob File (fichier d'objet volumineux) : Stocke le contenu binaire brut des objets Blob, ainsi que les sommes de contrôle des données et les informations d'index. Les fichiers de stockage sont dynamiquement fractionnés ou fusionnés en fonction de la taille de chaque objet Blob.
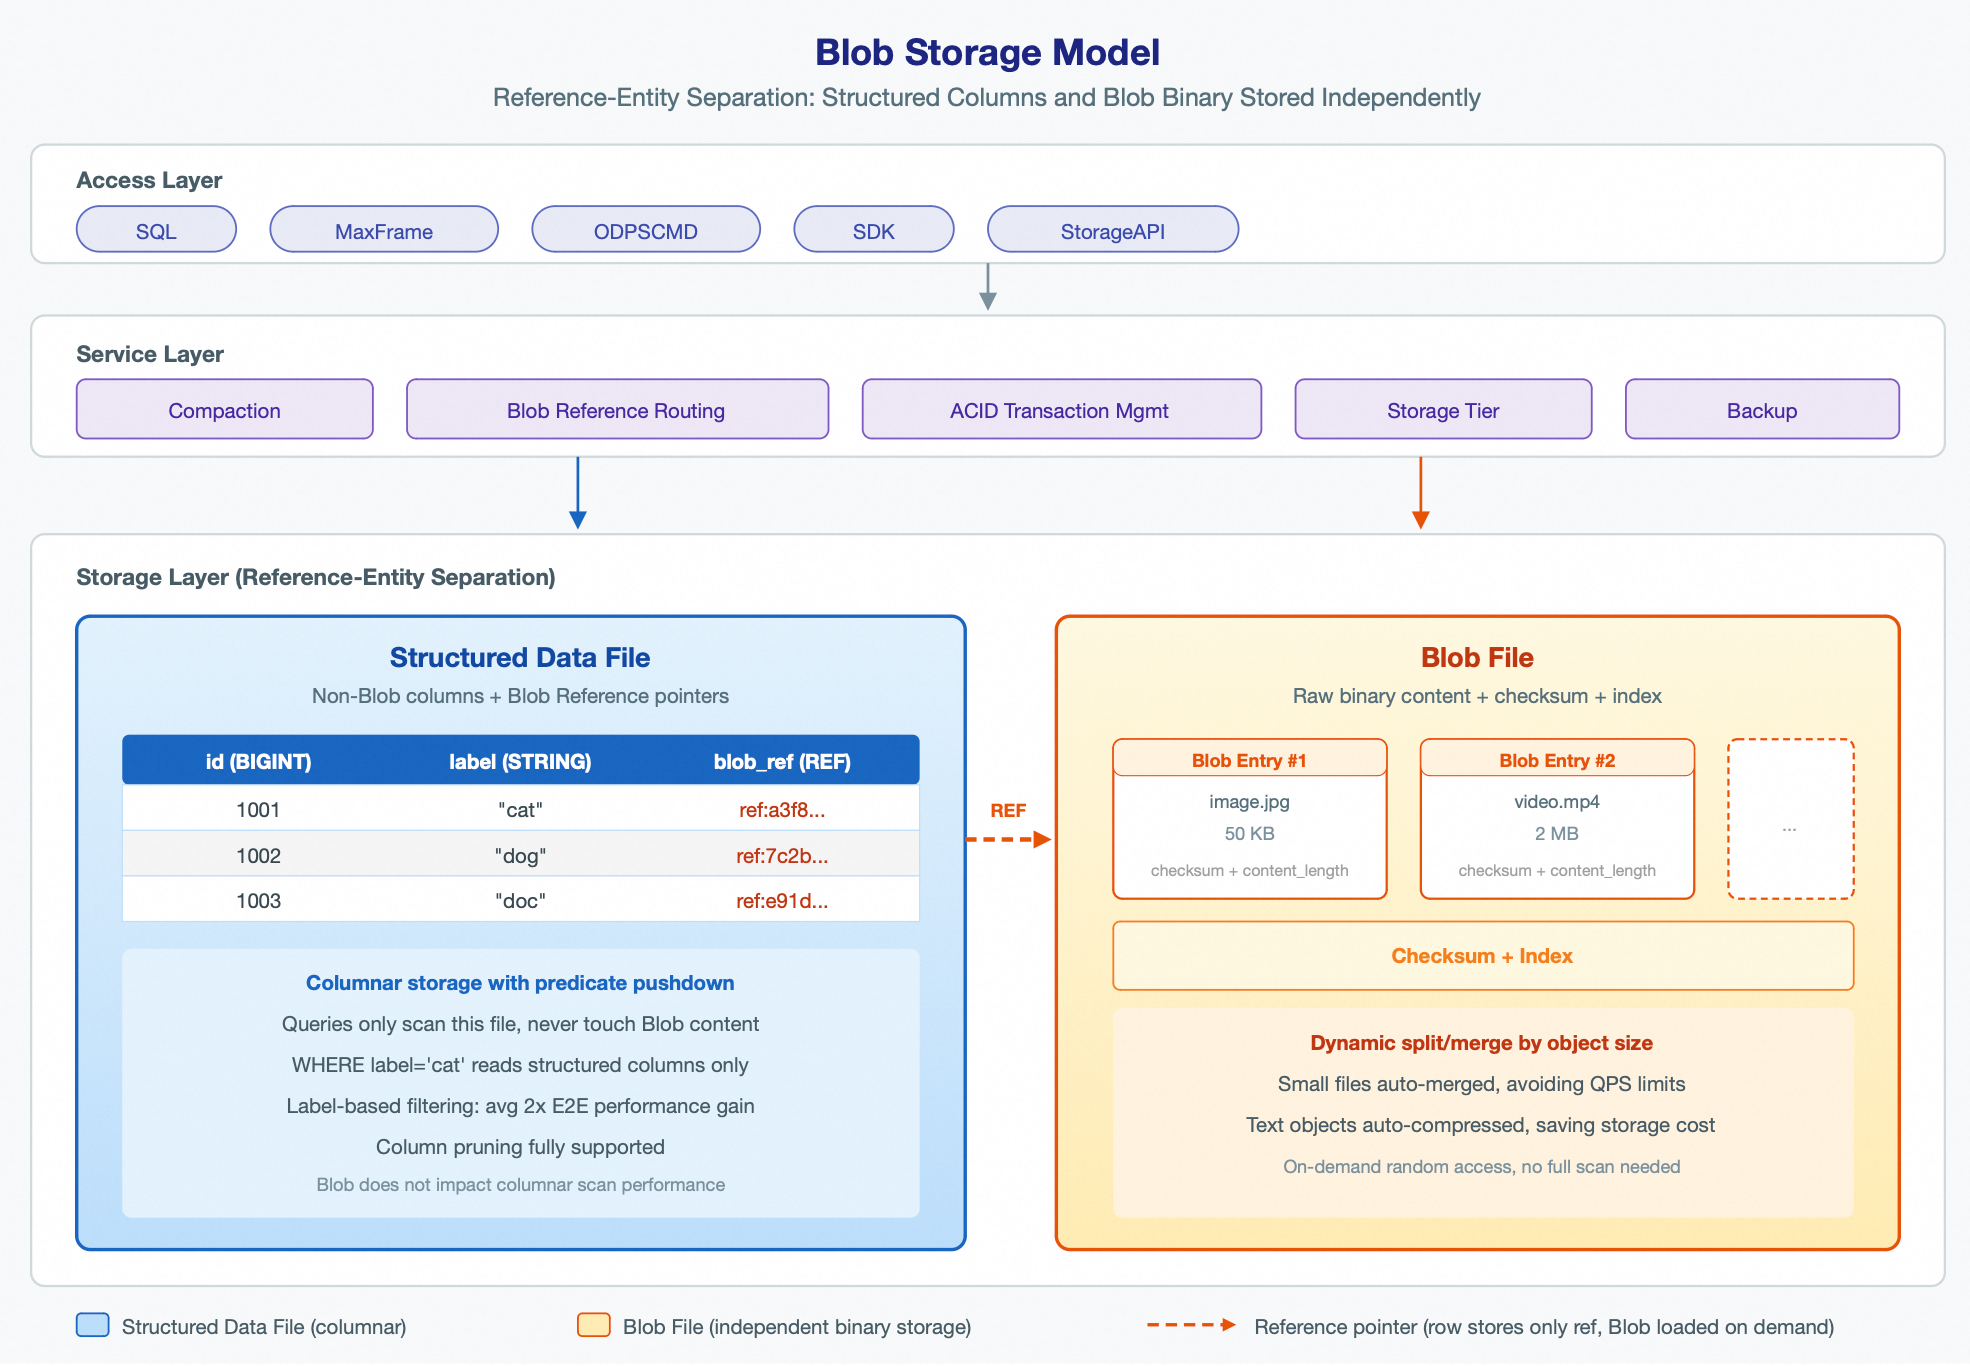
Lors de l'écriture des données, le système télécharge le contenu binaire vers un fichier Blob et écrit un pointeur de référence dans le fichier de données structuré. Lors de la lecture des données, le système récupère d'abord le pointeur de référence de la colonne structurée, puis charge le contenu binaire du fichier Blob selon les besoins. Le téléchargement Blob et l'écriture de référence sont effectués de manière atomique lors d'un seul commit de session, et MaxCompute gère les opérations de lecture/écriture comme une seule transaction pour garantir l'atomicité.
Ce processus est transparent pour vous et ne nécessite aucune manipulation spéciale.
Avantages en matière de performances
-
Fusion et compression des petits fichiers
Le stockage Blob fusionne automatiquement de nombreux petits objets (tels que des images, des extraits HTML et des journaux de session JSON) en fichiers Blob plus grands, prenant en charge les opérations de lecture et d'écriture par lots. Cela résout les limitations de QPS associées aux demandes pour un grand nombre de petits fichiers.
Les objets basés sur du texte sont automatiquement compressés à l'écriture et décompressés à la lecture. Par exemple, pour les extraits HTML et le texte JSON, cela peut réduire l'espace de stockage de 50 % en moyenne, diminuant ainsi les coûts de stockage.
-
Filtrage efficace sur les métadonnées sans analyser les grands objets fichiers
Lors du filtrage des données en fonction des colonnes de métadonnées ou de libellés (par exemple, pour trouver des échantillons avec un libellé spécifique), le stockage des objets en tant que type Blob au lieu des types STRING ou BINARY peut doubler les performances de bout en bout en moyenne.
Par exemple, considérons un jeu de données de 1 million d'images d'une taille moyenne de 1,4 Mo. Le tableau suivant compare la surcharge de requête du stockage de l'image en tant que type BINARY par rapport à un type Blob :
Méthode de stockage
Données analysées
Image stockée dans une colonne BINARY
Environ 1 400 Go (analyse complète de la table)
Image stockée dans une colonne BLOB
Environ 30 Go (fichier Data File uniquement)
Lorsque vous exécutez la requête de filtrage par libellé suivante, la table avec le type BINARY effectue une analyse complète de la table de 1 400 Go. En revanche, la table avec le type Blob n'analyse que 30 Go de données, soit une réduction de 45 fois.
-- Image stored as BINARY type
SELECT id, image FROM multimodal_dataset_binary Where label = "cat";
-- Image stored as Blob type
SELECT id, read_blob(image) FROM multimodal_dataset_blob Where label = "cat";
Importation et exportation de données
SDK
Utilisez cette méthode pour la lecture et l'écriture par lots à haut débit de données à grande échelle. Vous devez utiliser la version 0.57.1-public ou ultérieure du SDK MaxCompute Java SDK.
Pour les objets Blob inférieurs à 1 Mo, utilisez l'interface de téléchargement par lots. Le SDK regroupe automatiquement les objets par lots de 64 Mo pour le téléchargement.
<dependency>
    <groupId>com.aliyun.odps</groupId>
    <artifactId>odps-sdk-storage-api</artifactId>
    <version>0.57.1-public</version>
</dependency>
Object table
Utilisez cette méthode pour importer de nombreux fichiers non structurés existants (tels que des images, de l'audio, des vidéos et des documents) depuis OSS vers une table MaxCompute avec une colonne Blob. Créez une Object Table pour accéder aux objets et aux métadonnées dans un bucket OSS, puis insérez-les en masse dans une table multimodale MaxCompute. Ce processus ne nécessite aucune étape intermédiaire.
Exemple :
-- Step 1: Create an Object Table to associate with OSS data
SET odps.namespace.schema=true;
SET odps.sql.type.system.odps2 = true;
CREATE OBJECT TABLE oss_images
LOCATION 'oss://<accessKeyId>:<accessKeySecret>@<endpoint>/<bucket>/<path>/';

-- Refresh metadata
ALTER TABLE oss_images REFRESH METADATA;

-- Step 2: Create a multimodal table that contains a Blob column
CREATE TABLE ods_dataset_images (
  key VARCHAR(2048) COMMENT 'Object key',
  size BIGINT COMMENT 'Object size',
  type VARCHAR(32) COMMENT 'Object type',
  last_modified TIMESTAMP_NTZ COMMENT 'Last modified time',
  storage_class VARCHAR(32) COMMENT 'Storage class',
  etag VARCHAR(64) COMMENT 'ETag information',
  restore_info VARCHAR(256) COMMENT 'Restore information',
  owner_id BIGINT COMMENT 'Owner ID',
  owner_display_name VARCHAR(256) COMMENT 'Owner display name',
  data_file BLOB COMMENT 'Data file'
) COMMENT 'Multimodal table'
tblproperties ('table.format.version'='2') ;

-- Step 3: Bulk import data into the Blob table
INSERT OVERWRITE ods_dataset_images
SELECT key, size, type, last_modified, storage_class, etag, restore_info, owner_id, owner_display_name,
  to_blob(get_data_from_oss('<project_name>.default.oss_images', key)) AS data_file
  FROM oss_images;
Syntaxe SQL
DDL
Vous pouvez définir plusieurs colonnes Blob dans une instruction CREATE TABLE.
CREATE TABLE video_dataset (
    id        BIGINT,
    video     BLOB,
    thumbnail BLOB,
    title     STRING
) TBLPROPERTIES('table.format.version'='2');
Fonctions Blob
to_blob()
La fonction to_blob() convertit des données de type string ou binary en un objet Blob.
|
Fonction |
Description |
|
|
Convertit la chaîne entière en un Blob. |
|
|
Convertit la valeur binaire entière en un Blob. |
|
|
Crée un Blob à partir d'une sous-chaîne commençant à l' |
|
|
Crée un Blob à partir d'une sous-chaîne binaire commençant à l' |
|
|
Crée un Blob à partir d'une sous-chaîne d'une longueur spécifiée, commençant à l' |
|
|
Crée un Blob à partir d'une sous-chaîne binaire d'une longueur spécifiée, commençant à l' |
-- Create a Blob from a string
SELECT to_blob('hello world'); -- Returns: Blob{reference=CAEQAxqqAgEAAAAJA...}

-- Create a Blob from hexadecimal binary data
SELECT to_blob(X'89504E47');   -- PNG file header

-- Substring with an offset
SELECT to_blob('hello world', 6);           -- Result: 'world'
SELECT to_blob('hello world', 0, 5);        -- Result: 'hello'
read_blob()
La fonction read_blob() renvoie le contenu d'un objet Blob sous forme de STRING ou BINARY.
|
Fonction |
Description |
|
|
Lit le contenu complet du Blob sous forme de STRING. |
|
|
Lit le contenu à partir de l' |
|
|
Lit une longueur de contenu spécifiée à partir de l' |
-- Read the content of a Blob
SELECT id, read_blob(image) FROM image_dataset WHERE label = 'cat' LIMIT 10;

-- Read partial content (for example, to check the file header)
SELECT id, read_blob(content, 0, 4) AS file_header FROM media_library;

-- Nested usage
SELECT read_blob(to_blob('hello world'));  -- Returns 'hello world'
length()
-- Gets the length of a Blob in bytes
SELECT id, length(read_blob(image)) AS image_size FROM image_dataset;
Démarrage rapide
-- Create a table with a Blob column
CREATE TABLE blob_table (col1 BLOB)
TBLPROPERTIES (
  "table.format.version"="2"
);

-- Write data
INSERT INTO blob_table VALUES (to_blob("hello world"));

-- Read data
SELECT read_blob(col1) FROM blob_table;