Cette rubrique explique comment écrire une fonction d'agrégation définie par l'utilisateur (UDAF) en Java.
Structure du code de l'UDAF
Vous pouvez écrire une UDAF Java dans IntelliJ IDEA avec Maven ou MaxCompute Studio. Le code doit inclure les composants suivants :
-
Package Java : facultatif.
Regroupez les classes Java que vous définissez afin de faciliter leur recherche et leur réutilisation.
-
Classes et annotations requises : obligatoire.
Importez la classe
com.aliyun.odps.udf.Aggregatoret utilisez l'annotation@Resolve(com.aliyun.odps.udf.annotation.Resolve). La classecom.aliyun.odps.udf.UDFExceptionest facultative et sert à la gestion des erreurs. Si vous devez utiliser d'autres classes liées aux UDAF ou des types de données complexes, importez les classes requises comme décrit dans la section Présentation des UDF MaxCompute. -
Annotation
@Resolve: obligatoire.Le format est
@Resolve(<signature>), oùsignaturereprésente la signature de la fonction qui définit les types de données des paramètres d'entrée et de la valeur de retour. La signature d'une fonction UDAF ne peut pas être déterminée par réflexion ; elle ne peut être obtenue qu'à l'aide de l'annotation@Resolve, par exemple@Resolve("smallint->varchar(10)"). Pour plus d'informations sur l'annotation@Resolve, consultez la section Annotation @Resolve. -
Classe Java personnalisée : obligatoire.
Cette classe constitue l'unité organisationnelle du code de l'UDAF. Elle définit les variables et les méthodes qui implémentent votre logique métier.
-
Méthodes de la classe Java : obligatoire.
Votre classe Java doit étendre la classe
com.aliyun.odps.udf.Aggregatoret implémenter les méthodes suivantes.import com.aliyun.odps.udf.ContextFunction; import com.aliyun.odps.udf.ExecutionContext; import com.aliyun.odps.udf.UDFException; public abstract class Aggregator implements ContextFunction { // The initialization method. @Override public void setup(ExecutionContext ctx) throws UDFException { } // The termination method. @Override public void close() throws UDFException { } // Creates an aggregation buffer. abstract public Writable newBuffer(); // The iterate method. // buffer is an aggregation buffer that holds intermediate, summarized data. In map tasks, it aggregates data for a group, and this method is executed once for each row. // Writable[] represents a row of data, which refers to the input columns in the code. For example, writable[0] refers to the first column, and writable[1] refers to the second column. // args are the parameters specified when calling the UDAF in SQL. The args array itself cannot be null, but its elements can be null, which indicates that the corresponding input data is null. abstract public void iterate(Writable buffer, Writable[] args) throws UDFException; // The terminate method. abstract public Writable terminate(Writable buffer) throws UDFException; // The merge method. abstract public void merge(Writable buffer, Writable partial) throws UDFException; }Les méthodes
iterate,mergeetterminatesont les trois méthodes principales qui implémentent la logique centrale d'une UDAF. Vous devez également implémenter un tampon inscriptible personnalisé.Un tampon inscriptible convertit les objets en mémoire en une séquence d'octets (ou un autre protocole de transfert de données) afin de faciliter la persistance sur disque et la transmission réseau. Étant donné que MaxCompute utilise le calcul distribué pour traiter les fonctions d'agrégation, il doit sérialiser et désérialiser les données pour les transférer entre les nœuds de travail.
Lorsque vous écrivez une UDAF Java, vous pouvez utiliser des types Java ou des types Java Writable. Pour plus d'informations sur les correspondances entre les types de données pris en charge par MaxCompute et les types de données Java, consultez la section Types de données.
Le code suivant fournit un exemple d'UDAF.
// Package the defined Java class in org.alidata.odps.udaf.examples.
package org.alidata.odps.udaf.examples;
// Import the required base classes.
import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;
import com.aliyun.odps.io.DoubleWritable;
import com.aliyun.odps.io.Writable;
import com.aliyun.odps.udf.Aggregator;
import com.aliyun.odps.udf.UDFException;
import com.aliyun.odps.udf.annotation.Resolve;
// Define the custom Java class.
// Specify the @Resolve annotation.
@Resolve("double->double")
public class AggrAvg extends Aggregator {
// Implement the methods for the Java class.
  private static class AvgBuffer implements Writable {
    private double sum = 0;
    private long count = 0;
    @Override
    public void write(DataOutput out) throws IOException {
      out.writeDouble(sum);
      out.writeLong(count);
    }
    @Override
    public void readFields(DataInput in) throws IOException {
      sum = in.readDouble();
      count = in.readLong();
    }
  }
  private DoubleWritable ret = new DoubleWritable();
  @Override
  public Writable newBuffer() {
    return new AvgBuffer();
  }
  @Override
  public void iterate(Writable buffer, Writable[] args) throws UDFException {
    DoubleWritable arg = (DoubleWritable) args[0];
    AvgBuffer buf = (AvgBuffer) buffer;
    if (arg != null) {
      buf.count += 1;
      buf.sum += arg.get();
    }
  }
  @Override
  public Writable terminate(Writable buffer) throws UDFException {
    AvgBuffer buf = (AvgBuffer) buffer;
    if (buf.count == 0) {
      ret.set(0);
    } else {
      ret.set(buf.sum / buf.count);
    }
    return ret;
  }
  @Override
  public void merge(Writable buffer, Writable partial) throws UDFException {
    AvgBuffer buf = (AvgBuffer) buffer;
    AvgBuffer p = (AvgBuffer) partial;
    buf.sum += p.sum;
    buf.count += p.count;
  }
}Dans le code UDAF précédent, le tampon utilisé dans les méthodes iterate et merge est réutilisable. Il agrège les lignes d'entrée dans le tampon selon votre implémentation.
Limites
-
Accéder à Internet via des UDF
Par défaut, MaxCompute n'autorise pas l'accès à Internet via des UDF. Si vous souhaitez accéder à Internet via des UDF, remplissez le formulaire de demande de connexion réseau en fonction de vos besoins métier et soumettez la demande. L'équipe de support technique MaxCompute vous contactera rapidement pour activer la connectivité réseau. Pour plus d'informations sur la manière de remplir le formulaire de demande de connexion réseau, consultez la section Processus de connexion réseau.
-
Accéder à un VPC via des UDF
Par défaut, MaxCompute n'autorise pas l'accès aux ressources des VPC via des UDF. Pour utiliser des UDF afin d'accéder aux ressources d'un VPC, vous devez établir une connexion réseau entre MaxCompute et le VPC. Pour plus d'informations sur les opérations associées, consultez la section Accéder aux ressources VPC depuis une UDF.
-
Lire les données de table via des UDF, UDAF ou UDTF
Vous ne pouvez pas utiliser des UDF, UDAF ou UDTF pour lire les données des types de tables suivants :
Table sur laquelle une évolution de schéma est effectuée
Table contenant des types de données complexes
Table contenant des types de données JSON
Table transactionnelle
Remarques relatives à l'utilisation
Lorsque vous écrivez une UDAF Java, tenez compte des points suivants :
L'inclusion de classes portant le même nom mais ayant une logique différente dans les fichiers JAR de différentes UDAF peut entraîner des résultats inattendus ou des échecs de compilation. Par exemple, supposons que UDAF1 et UDAF2 correspondent respectivement aux fichiers JAR de ressources udaf1.jar et udaf2.jar. Si les deux fichiers JAR contiennent une classe nommée
com.aliyun.UserFunction.classmais avec des implémentations différentes, MaxCompute chargera l'une des classes de manière imprévisible lorsque UDAF1 et UDAF2 seront appelées dans la même instruction SQL.Dans une UDAF Java, les paramètres d'entrée et la valeur de retour doivent être des types d'objet, tels que String et Long, et non des types primitifs.
Les valeurs NULL en SQL sont représentées par NULL en Java. Les types primitifs Java ne peuvent pas représenter les valeurs NULL en SQL et ne sont pas autorisés.
Annotation @Resolve
Le format de l'annotation @Resolve est le suivant.
@Resolve(<signature>)La signature est une chaîne qui identifie les types de données des paramètres d'entrée et de la valeur de retour. Lors de l'exécution d'une UDAF, les types de ses paramètres d'entrée et de sa valeur de retour doivent correspondre aux types spécifiés dans la signature de la fonction. Lors de l'analyse sémantique, le système vérifie les utilisations qui ne sont pas conformes à la signature de la fonction et signale une erreur en cas d'incompatibilité de type. Le format spécifique est le suivant.
'arg_type_list -> type'Description :
-
arg_type_list: représente les types de données des paramètres d'entrée. Plusieurs paramètres d'entrée peuvent être spécifiés, séparés par des virgules (,). Les types de données pris en charge sont BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), CHAR, VARCHAR, les types de données complexes (ARRAY, MAP, STRUCT) et les types de données complexes imbriqués.arg_type_listprend également en charge un astérisque (*) ou une chaîne vide ('').Si
arg_type_listest un astérisque (*), cela indique que la fonction accepte n'importe quel nombre de paramètres d'entrée.Si
arg_type_listest une chaîne vide (''), cela indique que la fonction n'a aucun paramètre d'entrée.
Pour plus d'informations sur la syntaxe étendue de l'annotation Resolve, consultez la section Paramètres dynamiques pour les UDAF et UDTF.
type: représente le type de données de la valeur de retour. Une UDAF renvoie une seule colonne. Les types de données pris en charge incluent BIGINT, STRING, DOUBLE, BOOLEAN, DATETIME, DECIMAL, FLOAT, BINARY, DATE, DECIMAL(precision,scale), les types de données complexes (ARRAY, MAP, STRUCT) et les types de données complexes imbriqués.
Lorsque vous écrivez le code UDAF, vous pouvez sélectionner les types de données appropriés en fonction de l'édition de type de données de votre projet MaxCompute. Pour plus d'informations sur les éditions de types de données et les types de données pris en charge par chaque édition, consultez la section Versions des types de données.
Voici des exemples d'annotations @Resolve valides.
|
Exemple @Resolve |
Description |
|
|
Les types de paramètres d'entrée sont BIGINT et DOUBLE, et le type de valeur de retour est STRING. |
|
|
Accepte n'importe quel nombre de paramètres d'entrée, et le type de valeur de retour est STRING. |
|
|
N'accepte aucun paramètre d'entrée, et le type de valeur de retour est DOUBLE. |
|
|
Le type de paramètre d'entrée est ARRAY<BIGINT>, et le type de valeur de retour est STRUCT<x:STRING, y:INT>. |
Types de données
Les types de données pris en charge par MaxCompute varient selon l'édition de type de données. À partir de MaxCompute 2.0, des types de données supplémentaires sont disponibles, notamment des types complexes tels que ARRAY, MAP et STRUCT. Pour plus d'informations, consultez la section Éditions de types de données.
Votre UDAF Java doit utiliser des types de données qui correspondent à ceux de MaxCompute. Le tableau suivant décrit ces correspondances.
|
Type MaxCompute |
Type Java |
Type Java Writable |
|
TINYINT |
java.lang.Byte |
ByteWritable |
|
SMALLINT |
java.lang.Short |
ShortWritable |
|
INT |
java.lang.Integer |
IntWritable |
|
BIGINT |
java.lang.Long |
LongWritable |
|
FLOAT |
java.lang.Float |
FloatWritable |
|
DOUBLE |
java.lang.Double |
DoubleWritable |
|
DECIMAL |
java.math.BigDecimal |
BigDecimalWritable |
|
BOOLEAN |
java.lang.Boolean |
BooleanWritable |
|
STRING |
java.lang.String |
Text |
|
VARCHAR |
com.aliyun.odps.data.Varchar |
VarcharWritable |
|
BINARY |
com.aliyun.odps.data.Binary |
BytesWritable |
|
DATE |
java.sql.Date |
DateWritable |
|
DATETIME |
java.util.Date |
DatetimeWritable |
|
TIMESTAMP |
java.sql.Timestamp |
TimestampWritable |
|
INTERVAL_YEAR_MONTH |
N/A |
IntervalYearMonthWritable |
|
INTERVAL_DAY_TIME |
N/A |
IntervalDayTimeWritable |
|
ARRAY |
java.util.List |
N/A |
|
MAP |
java.util.Map |
N/A |
|
STRUCT |
com.aliyun.odps.data.Struct |
N/A |
Les paramètres d'entrée ou la valeur de retour d'une UDAF peuvent utiliser le type Java Writable uniquement si votre projet MaxCompute utilise l'édition de type de données MaxCompute V2.0.
Utilisation
Après avoir développé l'UDAF Java en suivant le processus de développement, vous pouvez l'appeler dans MaxCompute SQL comme suit :
Utiliser une UDF dans un projet MaxCompute : la méthode est similaire à celle de l'utilisation des fonctions intégrées. Vous pouvez utiliser une fonction définie par l'utilisateur de la même manière qu'une fonction intégrée.
Utiliser une UDF entre projets : utilisez une UDF du projet B dans le projet A. L'instruction suivante montre un exemple :
select B:udf_in_other_project(arg0, arg1) as res from table_t;. Pour plus d'informations sur le partage entre projets, consultez la section Accès aux ressources entre projets basé sur les packages.
Pour un exemple complet de développement et d'appel d'une UDAF Java à l'aide de MaxCompute Studio, consultez la section Exemple.
Exemple
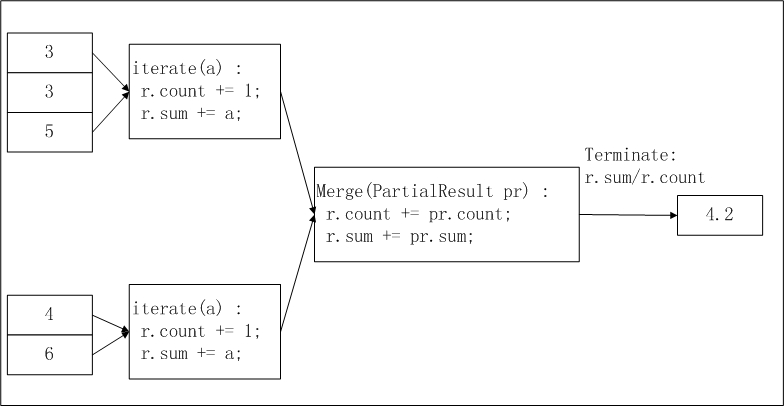
Cet exemple montre comment utiliser MaxCompute Studio pour développer une UDAF nommée AggrAvg qui calcule une valeur moyenne. La figure suivante illustre la logique.
-
Découpage des données d'entrée : MaxCompute suit le flux de traitement MapReduce pour diviser les données d'entrée en tranches qu'un nœud de travail peut traiter efficacement.
Configurez la taille de la tranche à l'aide du paramètre
odps.stage.mapper.split.size. Première phase du calcul de la moyenne : chaque nœud de travail compte le nombre d'enregistrements de données et calcule leur somme au sein de sa tranche. Le comptage et la somme de chaque tranche sont considérés comme un résultat intermédiaire.
Deuxième phase du calcul de la moyenne : les résultats intermédiaires de chaque tranche de la première phase sont agrégés.
Sortie finale :
r.sum/r.countreprésente la moyenne de toutes les données d'entrée.
Les étapes suivantes décrivent comment développer et appeler l'UDAF Java :
-
Préparez l'environnement.
Avant de pouvoir développer et déboguer une UDF dans MaxCompute Studio, installez MaxCompute Studio et connectez-le à un projet MaxCompute. Pour plus d'informations, consultez les rubriques suivantes :
-
Écrire le code UDAF
Dans l'explorateur Project, cliquez avec le bouton droit sur le répertoire source du module () et sélectionnez .
-
Dans la boîte de dialogue Create new MaxCompute java class, cliquez sur UDAF, saisissez un nom dans le champ Name et appuyez sur Entrée. Pour cet exemple, nommez la classe Java AggrAvg.
Le Name correspond au nom de la classe Java MaxCompute. Si vous n'avez pas créé de package, saisissez le nom au format packagename.classname. Un package est automatiquement généré.
-
Dans l'éditeur de code, collez le code UDAF suivant.
import java.io.DataInput;
import java.io.DataOutput;
import java.io.IOException;
import com.aliyun.odps.io.DoubleWritable;
import com.aliyun.odps.io.Writable;
import com.aliyun.odps.udf.Aggregator;
import com.aliyun.odps.udf.UDFException;
import com.aliyun.odps.udf.annotation.Resolve;
@Resolve("double->double")
public class AggrAvg extends Aggregator {
  private static class AvgBuffer implements Writable {
    private double sum = 0;
    private long count = 0;
    @Override
    public void write(DataOutput out) throws IOException {
      out.writeDouble(sum);
      out.writeLong(count);
    }
    @Override
    public void readFields(DataInput in) throws IOException {
      sum = in.readDouble();
      count = in.readLong();
    }
  }
  private DoubleWritable ret = new DoubleWritable();
  @Override
  public Writable newBuffer() {
    return new AvgBuffer();
  }
  @Override
  public void iterate(Writable buffer, Writable[] args) throws UDFException {
    DoubleWritable arg = (DoubleWritable) args[0];
    AvgBuffer buf = (AvgBuffer) buffer;
    if (arg != null) {
      buf.count += 1;
      buf.sum += arg.get();
    }
  }
  @Override
  public Writable terminate(Writable buffer) throws UDFException {
    AvgBuffer buf = (AvgBuffer) buffer;
    if (buf.count == 0) {
      ret.set(0);
    } else {
      ret.set(buf.sum / buf.count);
    }
    return ret;
  }
  @Override
  public void merge(Writable buffer, Writable partial) throws UDFException {
    AvgBuffer buf = (AvgBuffer) buffer;
    AvgBuffer p = (AvgBuffer) partial;
    buf.sum += p.sum;
    buf.count += p.count;
  }
}
-
Déboguer l'UDAF localement
Pour plus d'opérations de débogage, consultez la section Déboguer les UDF en les exécutant localement.
Cliquez avec le bouton droit sur le fichier AggrAvg.java dans votre projet et choisissez Run 'AggrAvg.main()'. Dans la boîte de dialogue Run/Debug Configurations qui s'affiche, configurez les paramètres suivants : MaxCompute project sur
local, MaxCompute table surkmeans_in, Table columns surdim1,dim2, Download Record limit sur100et Data Column Separator sur une virgule. Ensuite, cliquez sur OK.RemarqueVous pouvez utiliser les données présentées dans la figure comme référence pour les paramètres d'exécution.
-
Empaquetez l'UDAF que vous avez créée dans un fichier JAR, téléchargez le fichier JAR dans un projet MaxCompute et enregistrez la fonction. Par exemple, la fonction est nommée
user_udaf.Pour plus d'informations sur les opérations d'empaquetage, consultez la section Étapes.
Dans IntelliJ IDEA, cliquez avec le bouton droit sur le fichier Java contenant l'UDAF et choisissez Deploy to server.... Dans la boîte de dialogue Package a jar, submit resource and register function, configurez MaxCompute project, Resource name, Main class (saisissez le nom de la classe UDAF) et Function name. Cochez la case Force update if already exists et cliquez sur OK pour terminer le déploiement.
-
Dans le volet de navigation de gauche de MaxCompute Studio, cliquez sur Project Explorer, cliquez avec le bouton droit sur le projet MaxCompute cible, démarrez le client MaxCompute et exécutez une commande SQL pour appeler l'UDAF nouvellement créée.
Supposons que la table cible
my_tablepossède le schéma et les données suivants.+------------+------------+ | col0 | col1 | +------------+------------+ | 1.2 | 2.0 | | 1.6 | 2.1 | +------------+------------+Exécutez l'instruction SQL suivante pour appeler l'UDAF.
select user_udaf(col0) as c0 from my_table;Le résultat suivant est renvoyé.
+----+
| c0 |
+----+
| 1.4|
+----+