Les tables Hash Clustering utilisent des propriétés de brassage (shuffle) et de tri pour organiser les données. MaxCompute exploite ces propriétés pour optimiser les plans d'exécution, améliorant ainsi l'efficacité et économisant des ressources. Cette rubrique décrit comment utiliser les tables Hash Clustering dans MaxCompute.
Informations générales
La jointure de tables est un scénario courant dans les requêtes MaxCompute. Par exemple, la requête suivante effectue une jointure interne simple. Elle joint la table t1 et la table t2 sur la colonne id.
SELECT t1.a, t2.b FROM t1 JOIN t2 ON t1.id = t2.id;MaxCompute utilise trois méthodes principales pour implémenter les jointures :
-
Broadcast Hash Join
Lorsque l'une des tables d'une jointure est de petite taille, MaxCompute utilise cette méthode pour diffuser la petite table vers toutes les instances de tâche de jointure. Ensuite, il effectue une jointure par hachage avec la grande table.
-
Shuffle Hash Join
Si les tables de jointure sont volumineuses, elles ne peuvent pas être diffusées. À la place, MaxCompute effectue un brassage par hachage (hash shuffle) sur les deux tables en fonction de la clé de jointure. Les enregistrements ayant la même valeur de clé produisent le même résultat de hachage, ce qui garantit que les enregistrements partageant la même clé sont envoyés à la même instance de tâche de jointure. Chaque instance construit ensuite une table de hachage pour l'ensemble de données le plus petit et effectue une jointure par lecture séquentielle avec l'ensemble de données le plus grand.
-
Sort Merge Join
La méthode Shuffle Hash Join ne peut pas être utilisée si les tables de jointure sont trop volumineuses, car la mémoire disponible est insuffisante pour construire une table de hachage. Cette méthode effectue d'abord un brassage par hachage sur la clé de jointure, trie les données selon cette clé, puis fusionne les deux côtés de la jointure. La figure suivante illustre ce processus.
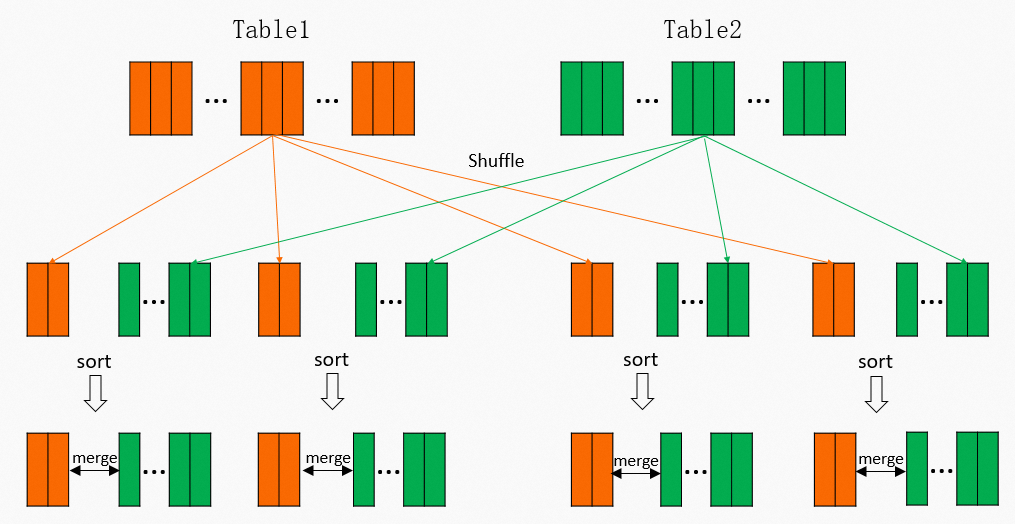 Pour les volumes de données et l'échelle courants dans MaxCompute, Sort Merge Join est utilisé dans la plupart des cas. Cependant, il s'agit d'une opération très coûteuse. Comme le montre la figure, l'opération de brassage nécessite un calcul et les résultats intermédiaires doivent être écrits sur le disque. Le réducteur suivant doit ensuite lire et trier ces données. Pour un scénario comportant
Mmappeurs etRréducteurs, cela entraîneM × Ropérations de lecture E/S. Le plan d'exécution physique Fuxi correspondant est présenté ci-dessous. Il nécessite deux étapes Mapper et une étape Join. Les parties en rouge indiquent les opérations de brassage et de tri.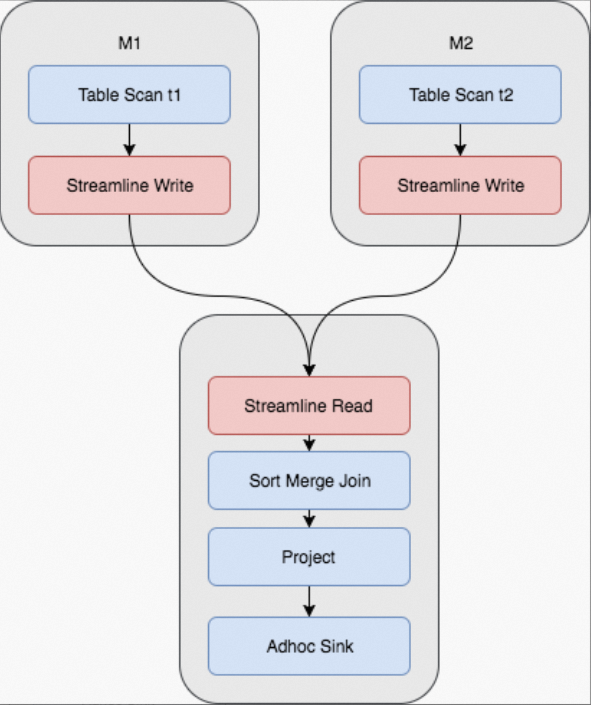 De plus, certaines jointures peuvent se produire de manière répétée. Par exemple, si la requête est modifiée comme suit :
SELECT t1.c, t2.d FROM t1 JOIN t2 ON t1.id = t2.id;Bien que les colonnes sélectionnées soient différentes, l'opération de jointure reste identique. L'ensemble du processus de brassage et de tri est également le même.
Ou encore, si la requête est modifiée comme suit :
SELECT t1.c, t3.d FROM t1 JOIN t3 ON t1.id = t3.id;Cela joint la table t1 et la table t3. Pour la table t1, l'ensemble du processus de brassage et de tri reste inchangé.
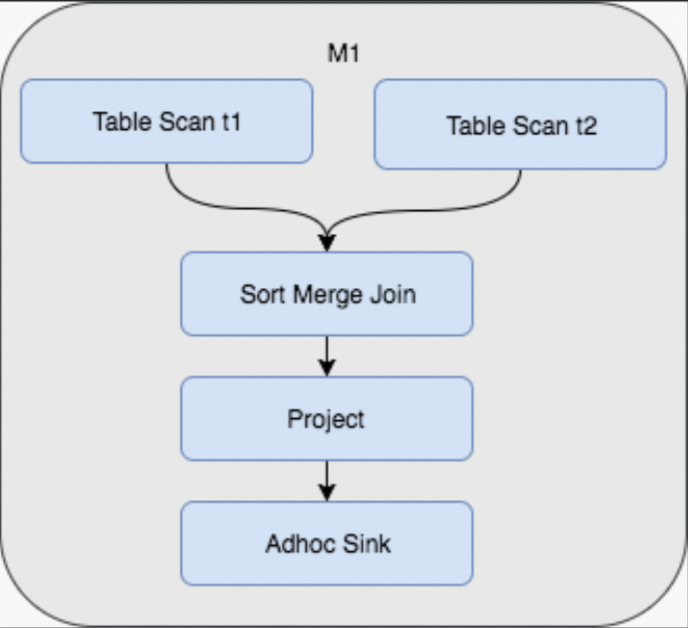
Par conséquent, si les données initiales de la table sont stockées à l'aide d'une méthode de brassage par hachage et de tri, les requêtes ultérieures peuvent éviter de brasser et de trier à nouveau les données. L'avantage réside dans le fait qu'un coût unique lors de la création de la table permet d'économiser les coûts répétés de brassage et de jointure dans les requêtes suivantes. Le plan d'exécution physique Fuxi pour la jointure change alors comme illustré dans la figure suivante. Cette modification permet non seulement d'économiser les opérations de brassage et de tri, mais réduit également la requête de trois étapes à une seule.
Remarques d'utilisation
Créer une table Hash Clustering
Utilisez l'instruction suivante pour créer une table Hash Clustering. Vous devez spécifier une clé de cluster, qui correspond à la clé de hachage, ainsi que le nombre de compartiments de hachage (buckets). Le tri est facultatif. Toutefois, pour des performances optimales, vous devez définir la clé de tri identique à la clé de cluster dans la plupart des cas.
-
Syntaxe
CREATE TABLE [IF NOT EXISTS] <table_name> [(<col_name> <data_type> [comment <col_comment>], ...)] [comment <table_comment>] [PARTITIONED BY (<col_name> <data_type> [comment <col_comment>], ...)] [CLUSTERED BY (<col_name> [, <col_name>, ...]) [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> BUCKETS] [AS <select_statement>] -
Exemples
-
Table non partitionnée
CREATE TABLE T1 (a string, b string, c bigint) CLUSTERED BY (c) SORTED by (c) INTO 1024 BUCKETS; -
Table partitionnée
CREATE TABLE T1 (a string, b string, c bigint)
       PARTITIONED BY (dt string)
       CLUSTERED BY (c)
       SORTED by (c) INTO 1024 BUCKETS;
-
-
Propriétés
-
CLUSTERED BY
Spécifie la clé de hachage. MaxCompute effectue une opération de hachage sur les colonnes spécifiées et distribue les données dans des compartiments en fonction des valeurs de hachage. Pour éviter le déséquilibre des données (data skew), prévenir les points chauds et assurer une bonne exécution parallèle, sélectionnez des colonnes présentant une large plage de valeurs et peu de valeurs de clé dupliquées pour la clause
CLUSTERED BY. Pour optimiser les jointures, vous pouvez également sélectionner des clés de jointure ou d'agrégation fréquemment utilisées, similaires aux clés primaires dans les bases de données traditionnelles. -
SORTED BY
Spécifie l'ordre de tri des champs au sein d'un compartiment. Pour de meilleures performances, définissez la clé
SORTED BYidentique à la cléCLUSTERED BY. Lorsque la clauseSORTED BYest spécifiée, MaxCompute crée automatiquement un index et l'utilise pour accélérer les requêtes. -
INTO number_of_buckets BUCKETS
Spécifie le nombre de compartiments de hachage. Ce nombre est obligatoire et dépend du volume de données. Un nombre plus élevé de compartiments augmente la concurrence et peut réduire la durée d'exécution des tâches. Cependant, un nombre excessif de compartiments peut générer un trop grand nombre de petits fichiers, et une concurrence élevée peut augmenter le temps CPU. Vous devez définir le nombre de compartiments de sorte que chaque compartiment ait une taille comprise entre 500 Mo et 1 Go. Pour les tables très volumineuses, ce nombre peut être plus élevé. Pour optimiser les jointures en supprimant les étapes de brassage et de tri, le nombre de compartiments des deux tables doit être multiple l'un de l'autre, par exemple
256et512. Utilisez une puissance de 2 pour le nombre de compartiments, telle que 512, 1024, 2048 ou 4096. Cela permet au système de diviser et de fusionner automatiquement les compartiments de hachage et de supprimer les étapes de brassage et de tri.
-
Modifier les propriétés Hash Clustering d'une table
Utilisez l'instruction ALTER TABLE pour ajouter ou supprimer les propriétés Hash Clustering d'une table partitionnée.
-
Instructions
-- Change the table to a Hash Clustering table ALTER TABLE <table_name> [CLUSTERED BY (<col_name> [, <col_name>, ...]) [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> BUCKETS]; -- Change a Hash Clustering table to a non-Hash Clustering table ALTER TABLE <table_name> NOT CLUSTERED; -
Remarques
L'instruction
ALTER TABLEmodifie les propriétés de clustering uniquement pour les tables partitionnées. Pour les tables non partitionnées, les propriétés de clustering ne peuvent pas être modifiées après leur définition.L'instruction
ALTER TABLEaffecte uniquement les nouvelles partitions d'une table partitionnée, y compris les partitions générées parINSERT OVERWRITE. Les nouvelles partitions sont stockées avec les nouvelles propriétés de clustering. Les partitions de données existantes restent inchangées.Ne spécifiez pas la clause
PARTITIONdans l'instruction, car celle-ci n'affecte que les nouvelles partitions.
L'instruction ALTER TABLE convient aux tables existantes. Après avoir ajouté de nouvelles propriétés de clustering, les nouvelles partitions sont stockées à l'aide de Hash Clustering.
Vérifier les propriétés de la table
Après avoir créé une table Hash Clustering, exécutez la commande suivante pour consulter ses propriétés. Les propriétés Hash Clustering sont affichées dans la section Extended Info.
DESC EXTENDED <table_name>;Voici un exemple du résultat renvoyé.
| Owner: ALIYUN$                          | Project:
| TableComment:
|
| CreateTime:               2017-06-19 14:10:55
| LastDDLTime:              2017-06-19 14:10:55
| LastModifiedTime:         2017-06-19 14:13:13
|
| InternalTable: YES    | Size: 21680295746
|
| Native Columns:
|
| Field           | Type    | Label | Comment
|
| l_orderkey      | bigint  |       |
| l_partkey       | bigint  |       |
| l_suppkey       | bigint  |       |
| l_linenumber    | bigint  |       |
| l_quantity      | double  |       |
| l_extendedprice | double  |       |
| l_discount      | double  |       |
| l_tax           | double  |       |
| l_returnflag    | string  |       |
| l_linestatus    | string  |       |
| l_shipdate      | string  |       |
| l_commitdate    | string  |       |
| l_receiptdate   | string  |       |
| l_shipinstruct  | string  |       |
| l_shipmode      | string  |       |
| l_comment       | string  |       |
|
| Extended Info:
|
| TableID:
| IsArchived:          false
| PhysicalSize:        65040887238
| FileNum:             1001
| ClusterType:         hash
| BucketNum:           1000
| ClusterColumns:      [l_orderkey]
| SortColumns:         [l_orderkey ASC]
Pour une table partitionnée, après avoir consulté les propriétés de la table, exécutez la commande suivante pour afficher les propriétés de la partition.
DESC EXTENDED <table_name> partition(<pt_spec>);Voici un exemple du résultat renvoyé.
| PartitionSize: 754

| CreateTime:               2017-07-07 14:01:03
| LastDDLTime:              2017-07-07 14:01:03
| LastModifiedTime:         2017-07-07 14:01:03

| IsExstore:                false
| IsArchived:               false
| PhysicalSize:             2262
| FileNum:                  2
| ClusterType:              hash
| BucketNum:                500
| ClusterColumns:           [c1]
| SortColumns:              [c1 ASC]
Avantages de Hash Clustering
Élagage des compartiments (Bucket pruning) et optimisation des index
CREATE TABLE t1 (id bigint,
                 a string,
                 b string)
             CLUSTERED BY (id)
             SORTED BY (id) into 1000 BUCKETS;
...
SELECT t1.a, t1.b FROM t1 WHERE t1.id=12345;idid
La requête identifie le compartiment de hachage correspondant à la valeur
12345. Cela nécessite l'analyse d'un seul compartiment au lieu des 1 000 compartiments. Ce processus est connu sous le nom d'élagage des compartiments (bucket pruning).Étant donné que les données au sein du compartiment sont triées par
id, MaxCompute crée automatiquement un index. MaxCompute utilise ensuite une recherche d'index pour localiser directement les enregistrements pertinents.
Cette optimisation réduit considérablement le nombre de mappeurs et permet à ces derniers de localiser directement la page de données à l'aide de l'index. Cela réduit significativement la quantité de données chargées et lues.
Par exemple, une tâche Big Data a démarré 1 111 mappeurs et a lu 42,7 milliards d'enregistrements pour trouver 26 enregistrements correspondants. La durée totale d'exécution était de 1 minute et 48 secondes. Avec une table Hash Clustering, la même requête sur les mêmes données peut localiser directement un seul compartiment et utiliser un index pour lire uniquement les pages contenant les données de la requête. Ce processus utilise seulement 4 mappeurs, lit 10 000 enregistrements et ne prend que 6 secondes.
Optimisation de l'agrégation
Pour la requête suivante :
SELECT department, SUM(salary) FROM employee GROUP BY (department);Généralement, cette requête brasse et trie les données de la colonne department puis effectue une agrégation en flux pour compter chaque groupe department. Toutefois, si les données de la table sont déjà regroupées et triées par department, les opérations de brassage et de tri ne sont plus nécessaires.
Optimisation du stockage
Même sans tenir compte des optimisations de calcul, le simple fait de brasser et de trier les données de la table pour le stockage permet d'économiser considérablement de l'espace. MaxCompute utilise un stockage en colonnes au niveau inférieur. Le tri regroupe les enregistrements ayant des valeurs de clé identiques ou similaires. Cela améliore l'efficacité de la compression et de l'encodage, ce qui conduit à des taux de compression plus élevés. Lors des tests, une table triée peut utiliser jusqu'à 50 % d'espace de stockage en moins qu'une table non triée dans certains cas extrêmes. Pour les tables ayant un cycle de vie long, l'utilisation de Hash Clustering pour le stockage constitue une optimisation worthwhile.
L'expérience suivante utilise la table lineitem de 100 Go issue de l'ensemble de données TPC-H. La table contient divers types de données, tels que int, double et string. Avec les mêmes données et la même méthode de compression, nous avons comparé la taille de stockage d'une table avec et sans Hash Clustering. La table avec Hash Clustering utilisait environ 10% d'espace de stockage en moins, comme le montrent les figures suivantes.
-
Sans Hash Clustering
odps@xxx>desc tpch_lineitem; +------------------------------------------------------------------------------------+ | Owner: xxx | Project: xxx | | TableComment: | +------------------------------------------------------------------------------------+ | CreateTime: 2016-04-17 21:48:08 | | LastDDLTime: 2016-04-17 21:48:08 | | LastModifiedTime: 2016-04-17 21:50:10 | +------------------------------------------------------------------------------------+ | InternalTable: YES | Size: 23573055432 | +------------------------------------------------------------------------------------+ | Native Columns: | +------------------------------------------------------------------------------------+ | Field | Type | Label | Comment | +------------------------------------------------------------------------------------+ | l_orderkey | bigint | | | | l_partkey | bigint | | | | l_suppkey | bigint | | | | l_linenumber | bigint | | | | l_quantity | double | | | | l_extendedprice | double | | | | l_discount | double | | | | l_tax | double | | | | l_returnflag | string | | | | l_linestatus | string | | | | l_shipdate | string | | | | l_commitdate | string | | | | l_receiptdate | string | | | | l_shipinstruct | string | | | | l_shipmode | string | | | | l_comment | string | | | +------------------------------------------------------------------------------------+ -
Avec Hash Clustering
odps@ xxx      >desc tpch_lineitem_hash_500;

| Owner:          xxx               | Project:    xxx
| TableComment:

| CreateTime:          2017-07-13 14:40:11
| LastDDLTime:         2017-07-13 14:40:11
| LastModifiedTime:    2017-07-13 15:05:04

| InternalTable: YES  | Size: 21658913950

| Native Columns:

| Field            | Type      | Label | Comment

| l_orderkey       | bigint    |       |
| l_partkey        | bigint    |       |
| l_suppkey        | bigint    |       |
| l_linenumber     | bigint    |       |
| l_quantity       | double    |       |
| l_extendedprice  | double    |       |
| l_discount       | double    |       |
| l_tax            | double    |       |
| l_returnflag     | string    |       |
| l_linestatus     | string    |       |
| l_shipdate       | string    |       |
| l_commitdate     | string    |       |
| l_receiptdate    | string    |       |
| l_shipinstruct   | string    |       |
| l_shipmode       | string    |       |
| l_comment        | string    |       |
Données de test et analyse
Les avantages globaux en termes de performances de Hash Clustering ont été mesurés à l'aide de l'ensemble de test standard TPC-H. Le test a utilisé 1 To de données et 500 compartiments pour toutes les tables. À l'exception des deux petites tables, nation et region, toutes les autres tables utilisaient la première colonne comme clé de cluster et de tri. Les résultats globaux des tests montrent qu'après l'utilisation de Hash Clustering, le temps CPU total a été réduit d'environ 17.3% et la durée totale d'exécution des tâches a été réduite d'environ 12.8%.
Notez que toutes les requêtes de TPC-H ne peuvent pas utiliser la propriété de clustering. En particulier, les deux requêtes les plus longues ne peuvent pas utiliser cette propriété. Par conséquent, l'amélioration globale de l'efficacité n'est pas spectaculaire. Cependant, pour les requêtes pouvant tirer parti de la propriété de clustering, les avantages sont significatifs. Par exemple, Q4 était environ 68% plus rapide, Q12 environ 62% plus rapide et Q10 environ 47% plus rapide.
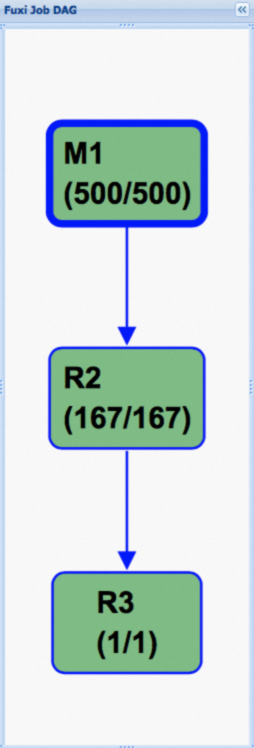
La figure suivante montre le plan d'exécution Fuxi pour TPC-H Q4 sur une table standard :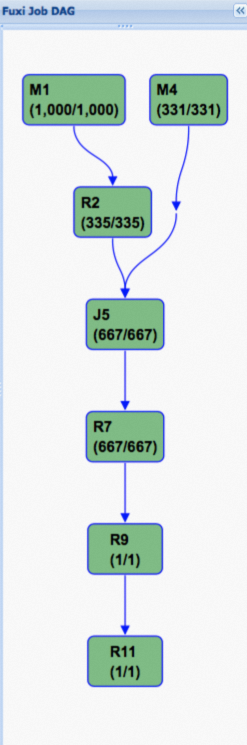 La figure suivante montre le plan d'exécution après l'utilisation de Hash Clustering. Comme vous pouvez le constater, le graphe orienté acyclique (DAG) est grandement simplifié. C'est la raison principale de l'amélioration significative des performances.