Foire aux questions (FAQ) concernant l'installation, l'importation et l'utilisation de PyODPS.
Erreur lors de l'installation : « Warning: XXX not installed »
Cause : Un composant requis est manquant. Solution : Identifiez le composant manquant indiqué à la place du marqueur XXX dans le message d'erreur, puis installez-le en exécutant la commande pip.
Erreur lors de l'installation : « Project Not Found »
Cette erreur survient pour l'une des raisons suivantes :
Configuration d'endpoint incorrecte : L'endpoint configuré n'est pas valide. Utilisez l'endpoint correspondant au projet de destination. Pour plus d'informations sur les endpoints, consultez Endpoints.
Position des paramètres incorrecte : Les paramètres de l'objet d'entrée MaxCompute sont spécifiés dans le mauvais ordre. Vérifiez que les paramètres sont saisis correctement. Pour plus d'informations sur les paramètres d'un objet d'entrée MaxCompute, consultez Migrer des nœuds PyODPS de DataWorks vers un environnement on-premises.
Erreur lors de l'installation : « Syntax Error »
Cette erreur indique que la version de Python est trop ancienne. PyODPS nécessite Python 2.6, 2.7.6 ou ultérieur, ou bien 3,3 ou ultérieur. Python 2.5 et les versions antérieures ne sont pas pris en charge.
Erreur d'installation sur macOS : « Permission Denied »
Exécutez la commande suivante pour installer PyODPS : sudo pip install pyodps.
Erreur d'installation sur macOS : « Operation Not Permitted »
Cette erreur provient de la protection System Integrity Protection (SIP). Pour la corriger, redémarrez votre appareil et appuyez sur ⌘+R pendant le démarrage afin d'accéder au mode de récupération. Ouvrez ensuite le Terminal et exécutez les commandes suivantes.
csrutil disable
reboot
Pour plus d'informations, consultez Operation Not Permitted when on root - El Capitan (rootless disabled).
Erreur d'importation : « No Module Named ODPS »
Le package ODPS ne peut pas être chargé. Causes possibles :
-
Cause 1 : Conflit de nom dans le chemin de recherche
Le chemin de recherche, généralement le répertoire courant, contient un fichier nommé
odps.pyouinit.py, ou encore un dossier nommé odps. Cela crée un conflit avec le package PyODPS installé. Solution :Si un dossier porte un nom conflictuel, renommez-le.
Si vous avez précédemment installé un autre package Python nommé odps, désinstallez-le en exécutant
sudo pip uninstall odps.
-
Cause 2 : Plusieurs versions de Python sont installées
Vous exécutez peut-être votre script dans un environnement Python où PyODPS n'est pas installé. Solution : Assurez-vous d'utiliser l'interpréteur Python correct où PyODPS est installé, ou installez PyODPS pour la version que vous utilisez actuellement.
-
Cause 3 : PyODPS n'est pas installé
Le package n'a jamais été installé dans l'environnement Python actuel. Solution : Installez PyODPS. Pour plus d'informations, consultez Installer PyODPS.
Erreur d'importation : « Cannot Import Name ODPS »
Vérifiez si un fichier nommé odps.py existe dans votre répertoire de travail actuel. Si c'est le cas, renommez-le avant d'exécuter à nouveau l'instruction d'importation.
Erreur d'importation : « Cannot Import Module odps »
Cette erreur signale généralement un problème de dépendance lié à votre installation PyODPS. Cliquez sur ce lien pour rejoindre le groupe de support technique DingTalk PyODPS et contactez l'administrateur du groupe pour obtenir de l'aide.
Erreur « ImportError » dans IPython ou Jupyter
Essayez d'ajouter from odps import errors au début de votre code. Si le problème persiste, cela peut provenir d'une dépendance IPython manquante. Exécutez sudo pip install -U jupyter pour résoudre le problème.
L'attribut size
L'attribut size représente la taille physique de la table.
Comment définir un endpoint Tunnel ?
Utilisez options.tunnel.endpoint pour définir l'endpoint du tunnel. Pour plus d'informations, consultez la documentation des options aliyun-odps-python-sdk.
Utiliser des packages tiers CPython
Il est recommandé de les empaqueter au format Wheel. Pour plus d'informations, consultez How to create a crcmod package that can be used in MaxCompute.
Limite de traitement des données d'un DataFrame
Un DataFrame PyODPS n'a aucune limite quant au volume de données traitées, car les opérations sont converties en tâches MaxCompute. En revanche, un DataFrame pandas local est limité par la mémoire disponible sur votre machine.
Comment utiliser max_pt dans un DataFrame ?
Utilisez le module odps.df.func pour appeler les fonctions intégrées de MaxCompute.
from odps.df import func
df = o.get_table('your_table').to_df()
df[df.ds == func.max_pt('your_project.your_table')]  # ds is a partition column.
Quelle est la différence entre open_writer() et write_table() ?
Chaque appel à write_table() crée un nouveau fichier sur le serveur, ce qui engendre une surcharge importante. Un trop grand nombre de petits fichiers dégrade les performances des requêtes et peut provoquer des erreurs de mémoire insuffisante sur le serveur. Il est préférable d'écrire plusieurs lots de données en une seule fois ou de transmettre un objet générateur. Pour un exemple, consultez Écrire des données dans une table.
En revanche, open_writer() crée une session permettant d'écrire des données par blocs, ce qui s'avère plus efficace pour les chargements en streaming ou itératifs.
Écart de données entre DataWorks et un script local
Par défaut, Instance Tunnel est désactivé sur DataWorks. Par conséquent, instance.open_reader utilise l'API Result, limitée à 10 000 enregistrements.
Une fois Instance Tunnel activé, vous pouvez utiliser reader.count pour obtenir le nombre total d'enregistrements. Pour parcourir toutes les données, vous devez désactiver cette limite en définissant options.tunnel.limit_instance_tunnel = False.
Comment obtenir le nombre réel d'enregistrements depuis un DataFrame ?
-
Après avoir installé PyODPS, exécutez la commande suivante dans votre environnement Python pour créer un DataFrame à partir d'une table MaxCompute.
iris = DataFrame(o.get_table('pyodps_iris')) -
Appelez la méthode
count()sur le DataFrame pour obtenir le nombre total de lignes.iris.count() -
Les opérations sur un DataFrame sont exécutées de manière différée. Elles ne s'exécutent que lorsque vous appelez explicitement une méthode d'action telle que
execute(). Pour forcer l'exécution immédiate de l'opérationcount(), enchaînez-la avec la méthodeexecute().df.count().execute()
Pour plus d'informations sur les méthodes retournant des valeurs réelles, consultez Opérations d'agrégation. Pour plus d'informations sur l'exécution différée dans PyODPS, consultez Exécuter et obtenir des résultats.
Erreur « sourceIP is not in the white list »
Le projet MaxCompute auquel vous tentez d'accéder est protégé par une liste d'autorisation IP. Contactez le propriétaire du projet pour ajouter l'adresse IP de votre machine à cette liste. Pour plus d'informations, consultez Gérer une liste d'autorisation IP.
Échec de la configuration de l'environnement avec options.sql.settings
-
Symptôme
Avant d'exécuter une requête SQL avec PyODPS, vous utilisez le code suivant pour configurer l'environnement d'exécution MaxCompute.
from odps import options
options.sql.settings = {'odps.sql.mapper.split.size': 32}
Après l'exécution de la tâche, seuls six mappers sont lancés, ce qui indique que le paramètre n'a pas pris effet. Lorsque vous exécutez
set odps.stage.mapper.split.size=32dans le client, la tâche se termine en moins d'une minute. -
Cause
Le nom du paramètre utilisé dans PyODPS diffère de celui utilisé dans le client. Le paramètre du client est
odps.stage.mapper.split.size, tandis que le paramètre PyODPS estodps.sql.mapper.split.size. -
Solution
Modifiez le nom du paramètre dans votre code pour utiliser
odps.stage.mapper.split.size.
Erreur « IndexError » lors de l'appel de head()
Cette erreur survient parce que list[index] n'existe pas ou que list[index] est hors limites.
Erreur lors du chargement d'un DataFrame pandas vers MaxCompute : « ODPSError »
-
Symptôme
Lorsque vous chargez un DataFrame pandas vers MaxCompute, l'erreur suivante est retournée.
ODPSError: ODPS entrance should be provided. -
Cause
Un point d'entrée global d'objet MaxCompute est manquant.
-
Solution
Utilisez le mécanisme Room
%enter, qui configure un point d'entrée global.Appelez la méthode
to_global()sur votre point d'entrée d'objet MaxCompute.Transmettez directement l'objet ODPS en tant que paramètre :
DataFrame(pd_df).persist('your_table', odps=odps).
Erreur « lifecycle is not specified »
-
Symptôme
Lorsque vous écrivez des données dans une table à l'aide d'un DataFrame, l'erreur suivante est retournée.
table lifecycle is not specified in mandatory mode -
Cause
Le projet de destination exige qu'un cycle de vie soit spécifié pour toutes les tables, mais vous n'en avez défini aucun.
-
Solution
Spécifiez le cycle de vie de la table dans votre script avant d'effectuer l'opération d'écriture.
from odps import options
options.lifecycle = 7  # Specify the lifecycle value. The value is an integer in days.
Erreur « datastream from server is crushed »
Cette erreur résulte généralement de données corrompues. Vérifiez que vos données comportent le même nombre de colonnes que la table de destination.
Erreur « Project is protected »
Une politique de sécurité du projet empêche la lecture des données de la table. Pour accéder à l'ensemble du jeu de données, utilisez l'une des méthodes suivantes :
Contactez le propriétaire du projet afin qu'il ajoute une règle d'exception pour votre accès.
Utilisez DataWorks ou un autre outil pour désensibiliser les données, exportez-les vers un projet non protégé, puis lisez-les depuis ce dernier.
Pour consulter uniquement un sous-ensemble des données, employez l'une des méthodes ci-dessous (dans la limite de 10 000 enregistrements) :
Recourez à la méthode execute_sql :
o.execute_sql('select * from <table_name>').open_reader().Convertissez la table en DataFrame :
o.get_table('<table_name>').to_df().
Échec intermittent « ConnectionError: timed out »
Cette erreur peut provenir des causes suivantes :
-
Délai d'expiration de la connexion : le délai d'attente par défaut de PyODPS est de 5 secondes. Si le réseau est instable, la connexion risque d'échouer. Vous pouvez appliquer l'une des solutions suivantes :
-
Augmentez le délai d'expiration en ajoutant le code suivant au début de votre script.
# Workaround to increase timeout
from odps import options
options.connect_timeout = 30
Implémentez un mécanisme de nouvelle tentative dans votre code pour gérer l'exception.
-
Restrictions du bac à sable : les environnements de type bac à sable peuvent imposer des restrictions d'accès réseau. Pour résoudre ce problème, nous vous recommandons d'utiliser un groupe de ressources de planification exclusif pour exécuter la tâche.
Erreur « is not defined » pour get_sql_task_cost()
-
Symptôme
Lorsque vous exécutez la fonction get_sql_task_cost, l'erreur suivante est renvoyée.
NameError: name 'get_task_cost' is not defined. -
Cause
Le nom de la fonction est incorrect.
-
Solution
Utilisez execute_sql_cost au lieu de get_sql_task_cost.
Comment afficher correctement les caractères chinois dans les journaux PyODPS ?
Vous pouvez résoudre ce problème en utilisant une chaîne de formatage d'impression, par exemple print ("My name is %s" % ('abc')). Ce problème survient généralement uniquement avec Python 2.
DATETIME devient STRING lorsque Instance Tunnel est désactivé
Lorsque Open_Reader est appelé, PyODPS utilise par défaut l'interface Result héritée. Par conséquent, les données renvoyées par le serveur sont au format CSV et toutes les valeurs DATETIME sont de type STRING.
Pour y remédier, activez Instance Tunnel en définissant options.tunnel.use_instance_tunnel = True. Cela permet à PyODPS d'utiliser le service Instance Tunnel, qui préserve les types de données d'origine.
Mettre en œuvre des fonctionnalités avancées avec Python
-
Écrire des fonctions Python réutilisables
Vous pouvez définir une série de fonctions pour des calculs courants, comme le calcul de la distance entre deux points selon différentes méthodes (distance euclidienne ou de Manhattan). Appelez ensuite la fonction appropriée selon vos besoins.
def euclidean_distance(from_x, from_y, to_x, to_y):
    return ((from_x - to_x) ** 2 + (from_y - to_y) ** 2).sqrt()

def manhattan_distance(from_x, from_y, to_x, to_y):
   return (from_x - to_x).abs() + (from_y - to_y).abs()
Exemple d'appel :
In [42]: df from_x from_y to_x to_y 0 0.393094 0.427736 0.463035 0.105007 1 0.629571 0.364047 0.972390 0.081533 2 0.460626 0.530383 0.443177 0.706774 3 0.647776 0.192169 0.244621 0.447979 4 0.846044 0.153819 0.873813 0.257627 5 0.702269 0.363977 0.440960 0.639756 6 0.596976 0.978124 0.669283 0.936233 7 0.376831 0.461660 0.707208 0.216863 8 0.632239 0.519418 0.881574 0.972641 9 0.071466 0.294414 0.012949 0.368514 In [43]: euclidean_distance(df.from_x, df.from_y, df.to_x, df.to_y).rename('distance') distance 0 0.330221 1 0.444229 2 0.177253 3 0.477465 4 0.107458 5 0.379916 6 0.083565 7 0.411187 8 0.517280 9 0.094420 In [44]: manhattan_distance(df.from_x, df.from_y, df.to_x, df.to_y).rename('distance') distance 0 0.392670 1 0.625334 2 0.193841 3 0.658966 4 0.131577 5 0.537088 6 0.114198 7 0.575175 8 0.702558 9 0.132617 -
Utiliser les instructions conditionnelles et les boucles de Python
Traiter des champs de table selon une configuration, puis effectuer une UNION ou une JOIN sur l'ensemble des tables, peut s'avérer complexe en SQL. Les DataFrames PyODPS simplifient cette opération.
Par exemple, pour combiner 30 tables en une seule, il faudrait normalement écrire une requête SQL comportant 30 clauses UNION ALL. Avec PyODPS, vous obtenez le même résultat avec le code suivant.
table_names = ['table1', ..., 'tableN']
dfs = [o.get_table(tn).to_df() for tn in table_names]
reduce(lambda x, y: x.union(y), dfs)

# The reduce statement is equivalent to the following code.
df = dfs[0]
for other_df in dfs[1:]:
    df = df.union(other_df)
Comment déboguer localement à l'aide du backend pandas ?
Le débogage local peut s'effectuer de deux manières. La méthode d'initialisation diffère, mais le code ultérieur reste identique :
Un DataFrame PyODPS créé à partir d'un DataFrame pandas peut effectuer des calculs locaux via pandas.
Un DataFrame créé à partir d'une table MaxCompute s'exécute sur MaxCompute.
L'exemple de code suivant montre comment basculer entre le débogage local et l'exécution complète sur MaxCompute.
df = o.get_table('movielens_ratings').to_df()
DEBUG = True
if DEBUG:
    # Use a small subset of data for local debugging
    df = df[:100].to_pandas(wrap=True)
Après avoir écrit votre code, testez-le localement pour itérer rapidement. Une fois les tests terminés, changez la valeur de DEBUG en False pour lancer le calcul complet sur MaxCompute.
Nous recommandons d'utiliser MaxCompute Studio pour déboguer les programmes PyODPS en local.
Comment éviter une exécution lente dans les boucles imbriquées ?
Collectez les résultats de la boucle dans un dict ou une liste Python, puis créez l'objet DataFrame en dehors de la boucle. Placer le code de création du DataFrame, tel que df=XXX, à l'intérieur de la boucle externe génère un nouvel objet DataFrame à chaque itération, ce qui ralentit considérablement l'exécution.
Comment éviter de télécharger des données sur votre machine locale ?
Pour plus d'informations, consultez Utiliser un nœud PyODPS pour éviter de télécharger des données sur une machine locale.
Quand télécharger des données pour un traitement local
Téléchargez les données PyODPS pour un traitement local dans les scénarios suivants :
Le volume de données est faible et tient dans la mémoire de votre machine locale.
-
Vous devez effectuer des opérations ligne par ligne qui étendent une ligne en plusieurs lignes, ou appliquer une fonction Python complexe à chaque ligne. Un DataFrame PyODPS gère cela efficacement en tirant parti du calcul parallèle de MaxCompute.
Par exemple, si vous disposez d'une colonne contenant des chaînes JSON et que vous souhaitez développer chaque objet JSON en plusieurs lignes selon ses paires clé-valeur, utilisez le code suivant.
In [12]: df
               json
0  {"a": 1, "b": 2}
1  {"c": 4, "b": 3}

In [14]: from odps.df import output

In [16]: @output(['k', 'v'], ['string', 'int'])
    ...: def h(row):
    ...:     import json
    ...:     for k, v in json.loads(row.json).items():
    ...:         yield k, v
    ...:

In [21]: df.apply(h, axis=1)
   k  v
0  a  1
1  b  2
2  c  4
3  b  3
Comment récupérer plus de 10 000 enregistrements avec open_reader ?
Utilisez CREATE TABLE ... AS SELECT ... pour enregistrer le résultat d'une requête SQL dans une nouvelle table, puis servez-vous de table.open_reader pour lire l'intégralité des données de cette table.
Opérateurs intégrés contre UDF
Une fonction définie par l'utilisateur (UDF) est beaucoup plus lente qu'un opérateur intégré. Privilégiez donc toujours l'utilisation d'un opérateur intégré lorsque cela est possible.
Lors d'un test sur un jeu de données d'un million de lignes, l'application d'une UDF à chaque ligne a fait passer le temps d'exécution de 7 à 27 secondes.
Valeur de partition vide dans le schéma du DataFrame
Cela s'explique par le fait qu'un DataFrame traite les colonnes de partition et les colonnes classiques de la même manière. Par conséquent, schema.partitions sur un objet DataFrame ne fournit pas d'informations sur les colonnes de partition de la table sous-jacente. Vous pouvez filtrer les données en utilisant la colonne de partition comme une colonne classique.
df = o.get_table('your_table').to_df()
print(df[df.ds == 'your_partition_value'].execute())
Pour manipuler les métadonnées de partition, nous recommandons d'utiliser les méthodes fournies par l'objet table. Pour plus d'informations, consultez Tables.
Comment effectuer un produit cartésien avec un DataFrame PyODPS ?
Pour plus d'informations, consultez Comment gérer un produit cartésien dans un DataFrame PyODPS.
Comment implémenter la segmentation de mots chinois Jieba dans PyODPS ?
Pour plus d'informations, consultez Utiliser un nœud PyODPS pour effectuer une segmentation de mots chinois avec Jieba.
Comment télécharger des jeux de données complets à l'aide de PyODPS ?
Par défaut, PyODPS ne limite pas les données lues depuis une instance. Toutefois, pour les projets MaxCompute protégés, les téléchargements via Tunnel sont restreints. Si options.tunnel.limit_instance_tunnel n'est pas défini, une limite de taille de données est automatiquement activée et le nombre d'enregistrements téléchargeables est plafonné par la configuration MaxCompute (généralement 10 000 enregistrements). Pour récupérer toutes les données de manière itérative, désactivez la limit en utilisant les instructions suivantes pour activer globalement Instance Tunnel et désactiver la limit.
options.tunnel.use_instance_tunnel = True
options.tunnel.limit_instance_tunnel = False  # Disable the limit to read all data.

with instance.open_reader() as reader:
    # You can read the full dataset through the Instance Tunnel.
execute_sql contre DataFrame pour le calcul du taux de valeurs nulles
Un DataFrame offre de meilleures performances pour les agrégations. Nous recommandons d'utiliser un DataFrame pour effectuer des opérations d'agrégation.
Comment configurer les types de données dans PyODPS ?
Activez les nouveaux types de données dans PyODPS en utilisant l'une des méthodes suivantes :
Pour activer les nouveaux types de données via la méthode
execute_sql, exécutezo.execute_sql('set odps.sql.type.system.odps2=true;query_sql', hints={"odps.sql.submit.mode" : "script"}).-
Pour activer les nouveaux types de données pour les opérations DataFrame telles que
persist,executeouto_pandas, utilisez le paramètrehints. Les paramètres spécifiés de cette manière ne sont effectifs que pour une seule tâche.from odps.df import DataFrame users = DataFrame(o.get_table('odps2_test')) users.persist('copy_test',hints={'odps.sql.type.system.odps2':'true'})Pour activer ces paramètres globalement pour toutes les opérations DataFrame, définissez le paramètre d'option
options.sql.use_odps2_extension = True.
« ValueError » avec le type Decimal
Vous pouvez résoudre ce problème de l'une des manières suivantes :
Mettez à niveau le SDK vers la version V0.8.4 ou ultérieure.
-
Ajoutez les instructions suivantes à votre code :
from odps.types import Decimal
Decimal._max_precision=38
Comment diagnostiquer une exécution SQL lente dans PyODPS ?
PyODPS n'effectue pas d'opérations intensives avant de soumettre une tâche SQL. Dans la plupart des cas, la lenteur d'exécution SQL n'est pas liée à PyODPS. Suivez ces étapes pour identifier la cause :
-
Vérifiez la latence du réseau et du serveur
Contrôlez la latence du serveur proxy ou du lien réseau emprunté lors de la soumission de la tâche.
Recherchez d'éventuels problèmes côté serveur, tels que des délais de mise en file d'attente des tâches.
-
Évaluez l'efficacité de la lecture des données
Si l'exécution de votre SQL implique la lecture d'un grand volume de données, vérifiez si la vitesse de lecture est ralentie par un volume de données important ou un nombre excessif de shards de données. Effectuez les étapes suivantes :
Essayez de séparer la soumission de la tâche de la lecture des données. Pour ce faire, soumettez la tâche à l'aide de run_sql, attendez sa fin avec instance.wait_for_success, puis lisez les données via instance.open_reader afin de déterminer la latence induite par chaque instruction. Voici un exemple de cette séparation :
-
Avant séparation :
with o.execute_sql('select * from your_table').open_reader() as reader: for row in reader: print(row) -
Après séparation :
inst = o.run_sql('select * from your_table')
inst.wait_for_success()
with inst.open_reader() as reader:
    for row in reader:
        print(row)
-
-
Vérifiez l'état des tâches DataWorks (le cas échéant)
Pour les tâches soumises dans DataWorks, recherchez les tâches SQL qui ont été soumises avec succès mais qui n'ont pas réussi à générer de Logview, en particulier lorsque la version de PyODPS est inférieure à 0.11.6. Ces tâches sont généralement soumises à l'aide des méthodes execute_sql ou run_sql.
-
Analysez les facteurs liés à l'environnement local
Pour déterminer si le problème provient de votre environnement local, nous recommandons d'activer la journalisation de débogage. PyODPS imprime alors toutes les requêtes et réponses, ce qui permet de localiser précisément le retard.
Exemple :
import datetime
import logging
from odps import ODPS

logging.basicConfig(level=logging.DEBUG, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
o = ODPS(...)  #  Enter your credentials here. Ignore this if a MaxCompute entry is already provided in the environment.
# Print the local time to determine when the local operation was initiated.
print("Check time:", datetime.datetime.now())
# Submit the task.
inst = o.run_sql("select * from your_table")
La sortie standard devrait ressembler au résultat suivant :
Check time: 2025-01-24 15:34:21.531330
2025-01-24 15:34:21,532 - odps.rest - DEBUG - Start request.
2025-01-24 15:34:21,532 - odps.rest - DEBUG - POST: http://service.<region>.maxcompute.aliyun.com/api/projects/<project>/instances
2025-01-24 15:34:21,532 - odps.rest - DEBUG - data: b'<?xml version="1.0" encoding="utf-8"?>\n<Instance>\n  <Job>\n    <Priority>9</Priority>\n    <Tasks>\n      <SQL>\n        ....
2025-01-24 15:34:21,532 - odps.rest - DEBUG - headers: {'Content-Type': 'application/xml'}
2025-01-24 15:34:21,533 - odps.rest - DEBUG - request url + params /api/projects/<project>/instances?curr_project=<project>
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers before signing: {'Content-Type': 'application/xml', 'User-Agent': 'pyodps/0.12.2 CPython/3.7.12', 'Content-Length': '736'}
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers to sign: OrderedDict([('content-md5', ''), ('content-type', 'application/xml'), ('date', 'Fri, 24 Jan 2025 07:34:21 GMT')])
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - canonical string: POST

application/xml
Fri, 24 Jan 2025 07:34:21 GMT
/projects/maxframe_ci_cd/instances?curr_project=maxframe_ci_cd
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers after signing: {'Content-Type': 'application/xml', 'User-Agent': 'pyodps/0.12.2 CPython/3.7.12', 'Content-Length': '736', ....
2025-01-24 15:34:21,533 - urllib3.connectionpool - DEBUG - Resetting dropped connection: service.<region>.maxcompute.aliyun.com
2025-01-24 15:34:22,027 - urllib3.connectionpool - DEBUG - http://service.<region>.maxcompute.aliyun.com:80 "POST /api/projects/<project>/instances?curr_project=<project> HTTP/1.1" 201 0
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.status_code 201
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.headers:
{'Server': '<Server>', 'Date': 'Fri, 24 Jan 2025 07:34:22 GMT', 'Content-Type': 'text/plain;charset=utf-8', 'Content-Length': '0', 'Connection': 'close', 'Location': ....
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.content: b''
Cette sortie indique l'heure à laquelle le code lance la tâche (2025-01-24 15:34:21.531), l'heure d'envoi de la requête (2025-01-24 15:34:21.533) et l'heure à laquelle le serveur renvoie une réponse (2025-01-24 15:34:22.027). Cela permet de déterminer le coût temporel de chaque étape.
Comment obtenir le nombre de fichiers et la dernière heure de modification d'une table MaxCompute à l'aide de PyODPS ?
-
Description du problème
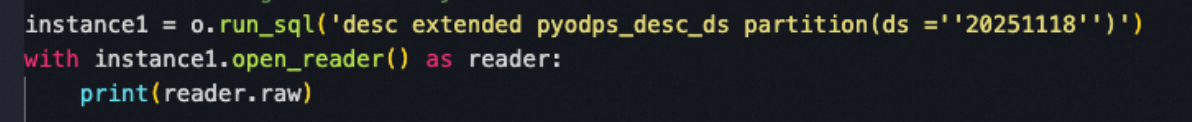
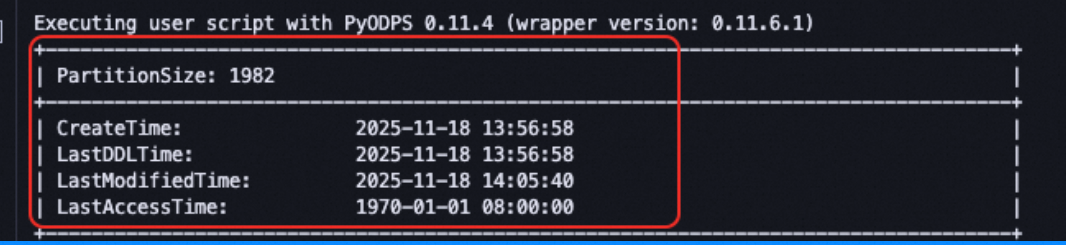
L'exécution de DESC EXTENDED table_name ou DESC EXTENDED table_name PARTITION (xxx='xxx') via le client MaxCompute (odpscmd) ou un nœud MaxCompute SQL dans DataWorks renvoie des métadonnées détaillées sur la table, telles que le nombre de fichiers (file_num), la taille physique et la dernière heure de modification.
Cependant, l'exécution de DESC EXTENDED via la méthode run_sql() ou execute_sql() de PyODPS ne renvoie pas les informations étendues complètes (comme file_num), rendant impossible l'extraction structurée de ces métriques.
-
Solution
Utilisez les interfaces natives du SDK PyODPS telles que table.reload_extend_info() ou partition.reload() pour obtenir ces statistiques. Cliquez sur ce lien pour consulter le code source.
L'exemple suivant montre comment obtenir le nombre de fichiers de chaque partition :
from odps.models import Partition

  # Replace with the actual table name
  table_name = 'your_real_table_name'

  # ========== 1. Get the table object ==========
  try:
      # Assume that o is an initialized ODPS object
      # In a DataWorks PyODPS node, uncomment the following line
      # o = odps
      table = o.get_table(table_name)
      print(f"Table object obtained: {table_name}")
  except Exception as e:
      print(f"Error: Failed to obtain table '{table_name}'. Cause: {str(e)}")
      raise

  # ========== 2. Check whether the table is partitioned ==========
  if not table.table_schema.partitions:
      print(f"Table '{table_name}' is not a partitioned table. Partition query
  is not supported.")
  else:
      print(f"Table '{table_name}' is a partitioned table. Iterating over all
  partitions...")
      print("=" * 60)

      # ========== 3. Iterate over partitions by using table.partitions
  ==========
      partition_count = 0
      try:
          for partition in table.partitions:
              try:
                  part_spec = partition.spec
                  if not part_spec:
                      part_spec = 'Unknown partition'

                  # partition.reload() loads detailed partition metadata
                  # This triggers one or more API calls to MaxCompute Metastore
                  partition.reload()

                  print(f"Partition Spec: {part_spec}")
                  print(f"  - Creation Time      : {partition.creation_time}")
                  print(f"  - Last Modified Time :
  {partition.last_data_modified_time}")
                  print(f"  - Physical Size      : {partition.physical_size}
  bytes")
                  print(f"  - File Count         : {partition.file_num}")
                  print(f"  - Is Archived        : {partition.is_archived}")
                  print("-" * 60)

                  partition_count += 1

              except Exception as e_inner:
                  print(f"Warning: Failed to load details for partition
  {partition.spec or ''}. Cause: {str(e_inner)}")
                  print("-" * 60)
                  continue

          print(f"Iteration complete: {partition_count} partitions processed.")

      except Exception as e_outer:
          print(f"Fatal error during partition iteration. Cause:
  {str(e_outer)}")