Les tables Append Delta utilisent le clustering par plage (Range Clustering) pour organiser les données. Par défaut, la clé de cluster est Row_ID et les buckets sont alloués dynamiquement à mesure que le volume de données augmente. Dès que vous spécifiez une clé de cluster, une tâche de clustering en arrière-plan effectue un reclustering incrémentiel : les données restent triées sans bloquer les écritures.
Quand utiliser les tables Append Delta
Les tables Append Delta sont particulièrement adaptées aux scénarios suivants :
Charges de travail d'ajout à haut débit : Les tables de la couche Operational Data Store (ODS) qui reçoivent des flux d'écritures continus bénéficient du découplage au moment de l'écriture : les données sont ingérées immédiatement, sans tri préalable.
Colonnes de filtre à cardinalité élevée : Les charges de travail filtrant sur des colonnes comportant de nombreuses valeurs distinctes tirent profit du clustering, sans subir la pénalité d'écriture des tables traditionnelles Range/Hash Cluster.
Données en croissance rapide : Les tables dont la taille passe de téraoctets à exaoctets nécessitent une stratégie de bucketing s'adaptant automatiquement, sans reconfiguration manuelle lors des variations de volume.
Tables sujettes au skew des données : Des distributions de données inégales rendent les nombres de buckets statiques peu fiables. Le bucketing dynamique élimine cette incertitude.
Accélération des requêtes dans la couche ODS : Lorsque les performances des requêtes et la fraîcheur des données sont toutes deux critiques, le reclustering incrémentiel offre une fraîcheur de l'ordre de la milliseconde, tandis que les tâches en arrière-plan gèrent le clustering.
Fonctionnement
Les tables Append Delta combinent deux mécanismes pour maintenir une organisation efficace des données :
Bucketing dynamique — ajuste automatiquement le nombre de buckets à mesure que le volume de données augmente, éliminant ainsi la nécessité de prédire ce nombre lors de la création de la table.
Reclustering incrémentiel — un service de données en arrière-plan reclustre de manière asynchrone les données nouvellement écrites, découplant ainsi les performances d'écriture de la surcharge liée au clustering.
Ensemble, ces mécanismes maintiennent un équilibre dynamique entre l'efficacité du stockage, la fraîcheur des données et les performances des requêtes grâce à trois tâches en arrière-plan : Merge, Compaction et Reclustering. Le bucketing dynamique prend également en charge une mise à l'échelle transparente, des téraoctets aux exaoctets, via les politiques Auto-Split/Merge.
Bucketing dynamique
Le problème des nombres de buckets statiques
Les tables traditionnelles Range/Hash Cluster vous obligent à spécifier un nombre de buckets lors de la création de la table. MaxCompute achemine ensuite les données vers les buckets en fonction de la clé de cluster. Une estimation incorrecte de ce nombre, qu'elle soit par excès ou par défaut, entraîne des problèmes :
Skew des données : Un nombre de buckets trop faible par rapport au volume de données provoque une croissance excessive de certains buckets, ce qui réduit l'efficacité de l'élimination des données (pruning) lors des requêtes.
Fragmentation des données : Un nombre de buckets trop élevé par rapport au volume de données laisse chaque bucket avec très peu de données, générant de nombreux petits fichiers fragmentés qui nuisent aux performances des requêtes.
Le choix du nombre approprié de buckets nécessite une connaissance détaillée du volume de données attendu et du format interne des tables de MaxCompute. Pour les migrations de données à grande échelle impliquant des milliers de tables, il n'est pas faisable d'estimer le nombre de buckets approprié pour chaque table. Même si l'estimation initiale est exacte, les volumes de données métier évoluent avec le temps, rendant une configuration précédemment correcte inadéquate.
Fonctionnement du bucketing dynamique
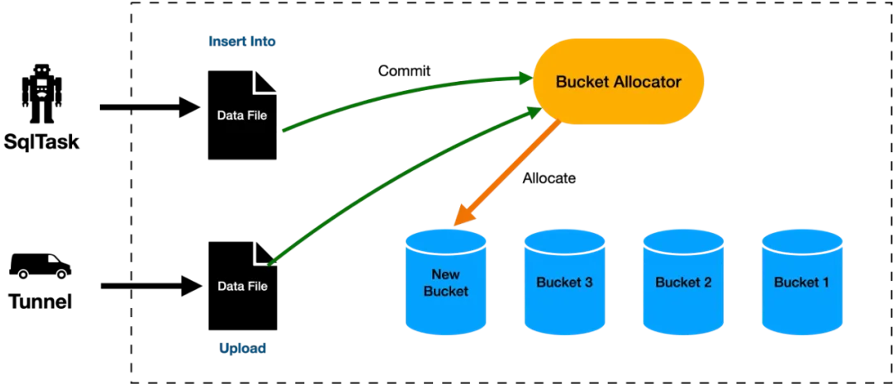
Les tables Append Delta allouent les buckets automatiquement. Chaque bucket est une unité de stockage logiquement contiguë qui contient environ 500 Mo de données. À mesure que vous écrivez des données en continu, de nouveaux buckets sont créés selon les besoins, sans aucune configuration requise. Le nombre de buckets reflète toujours le volume réel de données, éliminant ainsi le skew et la fragmentation causés par un sur-provisionnement ou un sous-provisionnement.
Le diagramme suivant illustre le flux de travail :
Reclustering incrémentiel
Le problème du clustering synchrone
Le clustering accélère les requêtes en triant et en co-localisant les données selon une clé de cluster spécifiée. Lorsqu'une requête utilise la clé de cluster, MaxCompute peut appliquer des techniques de pushdown et de pruning pour réduire la plage de balayage des données.
Le clustering par plage (Range Clustering) et le clustering par hachage (Hash Clustering) traditionnels y parviennent en répartissant les données dans des buckets et en les triant pendant le processus d'écriture afin d'obtenir un état globalement trié. Le diagramme suivant illustre le mécanisme de pruning du Range Clustering / Hash Clustering :

Ce tri au moment de l'écriture crée deux problèmes :
Problème 1 : Coût élevé de l'ajout de données
Le tri au moment de l'écriture restreint la manière dont vous pouvez charger les données. L'écriture initiale doit être effectuée en une seule opération à l'aide de INSERT INTO ou INSERT OVERWRITE. Pour ajouter davantage de données par la suite, vous devez lire toutes les données existantes de la table, les combiner avec les nouvelles données à l'aide de UNION, puis réécrire l'ensemble du jeu de données. Cela rend les opérations d'ajout coûteuses et limite le débit.
Les tables de la couche ODS reçoivent généralement des écritures continues provenant de pipelines de collecte externes, qui nécessitent une ingestion à faible latence et à haut débit. Le coût d'amplification d'écriture des tables clusterisées traditionnelles empêche l'application du clustering au niveau de la couche ODS.
Problème 2 : Latence de fraîcheur des données dans la couche entrepôt de données
Pour éviter l'amplification d'écriture, le clustering est généralement appliqué uniquement au niveau de la couche entrepôt de données (DW), où les données issues de la couche ODS sont nettoyées et chargées par lots stables. Cela introduit un décalage de fraîcheur : les données de la couche DW sont toujours en retard d'au moins un cycle de traitement par rapport à la couche ODS.
Certaines charges de travail exigent à la fois les performances de requête offertes par le clustering et la fraîcheur des données en temps réel. Le clustering synchrone au moment de l'écriture ne permet pas de répondre à cette exigence.
Fonctionnement du reclustering incrémentiel
Les tables Append Delta dissocient le clustering des écritures. Les données sont écrites directement sur le disque sans tri et allouées à des buckets, maximisant ainsi le débit d'écriture et minimisant la latence. Étant donné que les données nouvellement écrites ne sont pas encore clusterisées, les plages de données des nouveaux buckets chevauchent celles des buckets déjà clusterisés. Le moteur SQL gère cela de manière transparente : il élimine les buckets clusterisés et analyse les buckets incrémentiels lors de l'exécution des requêtes.
Le diagramme suivant illustre ce processus :

Un service de données en arrière-plan surveille en continu la profondeur de chevauchement des buckets (Bucket Overlap Depth). Lorsque le chevauchement atteint un seuil spécifique, il déclenche un reclustering incrémentiel sur les buckets nouvellement écrits. La majeure partie des données reste ordonnée en permanence, offrant ainsi des performances de requête globales stables.
Cette approche permet d'atteindre un équilibre optimal : les écritures sont effectuées avec une latence minimale, les requêtes s'exécutent sur des données majoritairement ordonnées et le décalage entre l'ingestion ODS et les performances de requête clusterisées est éliminé. Il en résulte une fraîcheur des données de l'ordre de la milliseconde dans la couche ODS, avec une accélération des requêtes grâce au clustering.