L'agrégateur est une fonctionnalité courante de MaxCompute Graph qui permet d'agréger et de traiter des informations globales provenant de tous les workers dans un job distribué. Utilisez-le pour vérifier si une condition globale est satisfaite (par exemple, la convergence dans l'apprentissage automatique) ou pour maintenir des statistiques s'étendant sur plusieurs workers.
Fonctionnement
La logique de l'agrégateur s'exécute à deux niveaux : de manière distribuée sur tous les workers pour l'agrégation partielle, et sur un seul worker désigné (le propriétaire de l'agrégateur) pour l'agrégation globale.
Chaque superstep suit la séquence suivante :
Au démarrage, chaque worker appelle
createStartupValuepour créer une valeurAggregatorValue.Au début de chaque itération, chaque worker appelle
createInitialValueafin d'initialiser la valeurAggregatorValuecorrespondante.Pendant l'itération, chaque sommet appelle
context.aggregate(), ce qui déclencheaggregate()pour construire un résultat partiel sur le worker.Chaque worker envoie son résultat partiel au worker propriétaire de l'agrégateur.
Le worker propriétaire de l'agrégateur appelle
mergeà plusieurs reprises pour combiner tous les résultats partiels en un résultat d'agrégation global.Le worker propriétaire de l'agrégateur appelle
terminatepour finaliser le résultat global et décider s'il faut mettre fin à l'itération.
Le résultat global est ensuite distribué à tous les workers au début du superstep suivant.
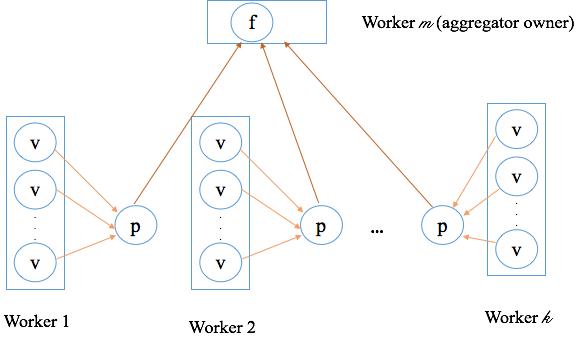
Opérations API
L'agrégateur propose cinq opérations API. Trois s'exécutent sur tous les workers et gèrent l'agrégation partielle ; deux s'exécutent uniquement sur le worker propriétaire de l'agrégateur et gèrent l'agrégation globale.
| API | S'exécute sur | Appelée par | Objectif |
|---|---|---|---|
createStartupValue(context) |
Tous les workers | Framework, une fois avant chaque superstep | Initialiser AggregatorValue |
createInitialValue(context) |
Tous les workers | Framework, une fois au début de chaque superstep | Initialiser AggregatorValue pour l'itération actuelle |
aggregate(value, item) |
Tous les workers | Appel explicite via ComputeContext#aggregate(item) |
Agrégation partielle |
merge(value, partial) |
Propriétaire de l'agrégateur uniquement | Framework | Fusionner les résultats partiels dans le résultat global |
terminate(context, value) |
Propriétaire de l'agrégateur uniquement | Framework, après merge() |
Finaliser le résultat global ; renvoyer true pour terminer l'itération |
createStartupValue(context)
Cette méthode est appelée une fois sur tous les workers avant le début de chaque superstep. Utilisez-la pour initialiser AggregatorValue. Dans le superstep 0, appelez WorkerContext.getLastAggregatedValue() ou ComputeContext.getLastAggregatedValue() pour obtenir l'objet initialisé.
createInitialValue(context)
Cette méthode est appelée une fois sur tous les workers au début de chaque superstep. Utilisez-la pour initialiser AggregatorValue pour l'itération en cours. En général, appelez WorkerContext.getLastAggregatedValue() pour récupérer le résultat de l'itération précédente, puis initialisez à partir de celui-ci.
aggregate(value, item)
Appelée sur tous les workers. Contrairement à createStartupValue et createInitialValue, cette méthode n'est pas appelée automatiquement : elle est déclenchée lorsque votre code de sommet appelle ComputeContext#aggregate(item).
value: le résultat d'agrégation actuel du worker pour ce superstep, initialisé parcreateInitialValueitem: la valeur transmise parComputeContext#aggregate(item)
Mettez à jour value à l'aide de item pour construire le résultat partiel. Une fois tous les appels aggregate terminés, le framework envoie value au worker propriétaire de l'agrégateur.
merge(value, partial)
Appelée sur le worker propriétaire de l'agrégateur pour combiner les résultats partiels de tous les workers.
value: le résultat d'agrégation global en cours d'exécutionpartial: un résultat partiel reçu d'un worker
Utilisez partial pour mettre à jour value. Par exemple, si les workers w0, w1 et w2 produisent les résultats partiels p0, p1 et p2, et qu'ils arrivent dans l'ordre p1, p0, p2 :
merge(p1, p0)— p1 est mis à jour pour inclure p0merge(p1, p2)— p1 est mis à jour pour inclure p2 ; p1 constitue désormais le résultat d'agrégation global
Si un seul worker existe, merge() n'est pas appelé.
terminate(context, value)
Appelée sur le worker propriétaire de l'agrégateur une fois tous les appels merge() terminés. value contient le résultat d'agrégation global.
Modifiez value si nécessaire, puis renvoyez :
true— termine l'itération pour l'ensemble du jobfalse— passe à l'itération suivante
Une fois que terminate() a renvoyé une valeur, le framework distribue l'objet d'agrégation global à tous les workers pour le superstep suivant. Renvoyer true lorsque la convergence est atteinte arrête immédiatement les jobs, ce qui représente le modèle typique dans les scénarios d'apprentissage automatique.
Exemple de clustering K-means
L'exemple suivant montre comment implémenter un agrégateur pour le clustering K-means. La logique principale est concentrée dans la classe Aggregator, qui coordonne l'agrégation partielle entre les workers et pilote la convergence.
Pour obtenir le code source complet, téléchargez Kmeans.gz . Le code ci-dessous est extrait à titre de référence.
GraphLoader
KmeansReader charge chaque ligne de la table d'entrée en tant que sommet. recordNum devient l'ID du sommet, et les données de la ligne sont stockées sous forme de DenseVector dans la valeur du sommet. (DenseVector provient de matrix-toolkits-java.)
public static class KmeansValue implements Writable {
    DenseVector sample;
    public KmeansValue() {
    }
    public KmeansValue(DenseVector v) {
        this.sample = v;
    }
    @Override
        public void write(DataOutput out) throws IOException {
        wirteForDenseVector(out, sample);
    }
    @Override
        public void readFields(DataInput in) throws IOException {
        sample = readFieldsForDenseVector(in);
    }
}
public static class KmeansReader extends
GraphLoader<LongWritable, KmeansValue, NullWritable, NullWritable> {
@Override
public void load(
LongWritable recordNum,
WritableRecord record,
MutationContext<LongWritable, KmeansValue, NullWritable, NullWritable> context)
throws IOException {
KmeansVertex v = new KmeansVertex();
v.setId(recordNum);
int n = record.size();
DenseVector dv = new DenseVector(n);
for (int i = 0; i < n; i++) {
dv.set(i, ((DoubleWritable)record.get(i)).get());
}
v.setValue(new KmeansValue(dv));
context.addVertexRequest(v);
}
}Vertex
Chaque sommet contribue à l'agrégation partielle avec son échantillon. Toute la logique de calcul repose sur un unique appel context.aggregate() :
public static class KmeansVertex extends
    Vertex<LongWritable, KmeansValue, NullWritable, NullWritable> {
    @Override
        public void compute(
        ComputeContext<LongWritable, KmeansValue, NullWritable, NullWritable> context,
        Iterable<NullWritable> messages) throws IOException {
        context.aggregate(getValue()); // submit this vertex's sample for partial aggregation
    }
}
Aggregator
KmeansAggrValue contient les données agrégées entre les workers et redistribuées à chaque superstep :
public static class KmeansAggrValue implements Writable {
    DenseMatrix centroids; // K x m matrix of current cluster centers
    DenseMatrix sums;      // running sums per cluster dimension, for recomputing centers
    DenseVector counts;    // number of samples assigned to each cluster center
    @Override
        public void write(DataOutput out) throws IOException {
        wirteForDenseDenseMatrix(out, centroids);
        wirteForDenseDenseMatrix(out, sums);
        wirteForDenseVector(out, counts);
    }
    @Override
        public void readFields(DataInput in) throws IOException {
        centroids = readFieldsForDenseMatrix(in);
        sums = readFieldsForDenseMatrix(in);
        counts = readFieldsForDenseVector(in);
    }
}
sums(i,j) stocke la somme de la dimension j pour tous les échantillons les plus proches du centre i. Utilisé conjointement avec counts, cela permet de recalculer la nouvelle position du centre à chaque superstep.
createStartupValue — lit les centres initiaux depuis le fichier cache centers et initialise sums et counts à zéro :
public static class KmeansAggregator extends Aggregator<KmeansAggrValue> {
    public KmeansAggrValue createStartupValue(WorkerContext context) throws IOException {
        KmeansAggrValue av = new KmeansAggrValue();
        byte[] centers = context.readCacheFile("centers"); // load initial cluster centers
        String lines[] = new String(centers).split("\n");
        int rows = lines.length;
        int cols = lines[0].split(",").length; // assumption rows >= 1
        av.centroids = new DenseMatrix(rows, cols);
        av.sums = new DenseMatrix(rows, cols);
        av.sums.zero();   // initialize to zero before first superstep
        av.counts = new DenseVector(rows);
        av.counts.zero(); // initialize to zero before first superstep
        for (int i = 0; i < lines.length; i++) {
            String[] ss = lines[i].split(",");
            for (int j = 0; j < ss.length; j++) {
                av.centroids.set(i, j, Double.valueOf(ss[j]));
            }
        }
        return av;
    }
}
createInitialValue — réinitialise sums et counts à zéro tout en conservant les centroids de l'itération précédente :
@Override
public KmeansAggrValue createInitialValue(WorkerContext context)
    throws IOException {
    KmeansAggrValue av = (KmeansAggrValue)context.getLastAggregatedValue(0);
    // reset accumulators; retain centroids from the previous iteration
    av.sums.zero();
    av.counts.zero();
    return av;
}
aggregate — trouve le centroïde le plus proche pour chaque échantillon et accumule sums et counts (agrégation partielle sur chaque worker) :
@Override
public void aggregate(KmeansAggrValue value, Object item)
    throws IOException {
    DenseVector sample = ((KmeansValue)item).sample;
    int min = findNearestCentroid(value.centroids, sample); // find closest cluster center
    for (int i = 0; i < sample.size(); i ++) {
        value.sums.add(min, i, sample.get(i)); // accumulate sample dimensions
    }
    value.counts.add(min, 1.0d); // increment sample count for this cluster
}
merge — combine les résultats partiels de tous les workers en additionnant sums et counts (agrégation globale sur le worker propriétaire de l'agrégateur) :
@Override
public void merge(KmeansAggrValue value, KmeansAggrValue partial)
    throws IOException {
    value.sums.add(partial.sums);     // accumulate sums from this worker
    value.counts.add(partial.counts); // accumulate counts from this worker
}
terminate — calcule les nouveaux centres de cluster, vérifie la convergence à l'aide de la distance euclidienne avec un seuil de 0,05, et décide s'il faut mettre fin à l'itération :
@Override
public boolean terminate(WorkerContext context, KmeansAggrValue value)
    throws IOException {
    // Calculate new centers from the aggregated sums and counts
    DenseMatrix newCentriods = calculateNewCentroids(value.sums, value.counts, value.centroids);
    // print old centroids and new centroids for debugging
    System.out.println("\nsuperstep: " + context.getSuperstep() +
                       "\nold centriod:\n" + value.centroids + " new centriod:\n" + newCentriods);
    boolean converged = isConverged(newCentriods, value.centroids, 0.05d); // Euclidean distance threshold
    System.out.println("superstep: " + context.getSuperstep() + "/"
                       + (context.getMaxIteration() - 1) + " converged: " + converged);
    if (converged || context.getSuperstep() == context.getMaxIteration() - 1) {
        // converged or reached max iterations — write final centers and stop
        for (int i = 0; i < newCentriods.numRows(); i++) {
            Writable[] centriod = new Writable[newCentriods.numColumns()];
            for (int j = 0; j < newCentriods.numColumns(); j++) {
                centriod[j] = new DoubleWritable(newCentriods.get(i, j));
            }
            context.write(centriod);
        }
        return true;  // end iteration
    }
    value.centroids.set(newCentriods); // update centers for next iteration
    return false; // continue iteration
}
Méthode main
La méthode main construit GraphJob, configure toutes les classes de composants et soumet le job. Le nombre maximal d'itérations par défaut est de 30, configurable via le troisième argument.
public static void main(String[] args) throws IOException {
    if (args.length < 2)
        printUsage();
    GraphJob job = new GraphJob();
    job.setGraphLoaderClass(KmeansReader.class);
    job.setRuntimePartitioning(false); // each worker loads and retains its own data partition
    job.setVertexClass(KmeansVertex.class);
    job.setAggregatorClass(KmeansAggregator.class); // register the Aggregator implementation
    job.addInput(TableInfo.builder().tableName(args[0]).build());
    job.addOutput(TableInfo.builder().tableName(args[1]).build());
    // default max iteration is 30
    job.setMaxIteration(30);
    if (args.length >= 3)
        job.setMaxIteration(Integer.parseInt(args[2]));
    long start = System.currentTimeMillis();
    job.run();
    System.out.println("Job Finished in "
                       + (System.currentTimeMillis() - start) / 1000.0 + " seconds");
}Lorsquejob.setRuntimePartitioningest défini surfalse, les données chargées par chaque worker ne sont pas partitionnées par le partitionneur. Chaque worker charge et conserve ses propres données.