Cette rubrique compare les performances de compression des données de Lindorm avec celles de HBase, MySQL et MongoDB open source sur quatre jeux de données réels : commandes, Internet des véhicules (IoV), journaux et comportements utilisateurs.
Environnement de test
Lindorm est un service de base de données hyperconvergée multimodèle qui utilise par défaut l'algorithme de compression zstd et prend en charge la compression basée sur un dictionnaire. Cette dernière améliore le taux de compression en optimisant l'échantillonnage du dictionnaire lors de l'encodage des données.
Le tableau suivant présente les versions des bases de données et les configurations de compression utilisées pour ce test.
| Database | Version | Default compression | Notes |
|---|---|---|---|
| Lindorm | Latest | zstd (optimized) | Dictionary-based compression available |
| Open source HBase | 2.3.4 | Snappy | zstd is supported with later Hadoop versions but prone to stability issues and core dumps; most deployments use Snappy |
| Open source MySQL | 8,0 | None (disabled) | zlib is available but significantly degrades query performance when enabled |
| Open source MongoDB | 5,0 | Snappy | zstd is available as an alternative |
Ce test ne respecte que partiellement les spécifications des benchmarks TPC. Les résultats ne sont ni équivalents ni comparables à ceux de tests respectant intégralement ces spécifications.
Chaque scénario teste et compare les configurations suivantes :
Lindorm avec zstd (par défaut)
Lindorm avec la compression basée sur un dictionnaire activée
HBase open source avec Snappy
MySQL open source avec la compression désactivée
MongoDB open source avec Snappy
MongoDB open source avec zstd
Quand utiliser la compression basée sur un dictionnaire
zstd ou compression basée sur un dictionnaire :
| Algorithm | Benefit | Best for |
|---|---|---|
| zstd (default) | Significant storage reduction with no additional configuration | All data types |
| Dictionary-based compression | Further reduction beyond zstd, at the cost of a dictionary training step during data ingestion | Datasets with high row-to-row repetition |
Données tirant le plus profit de la compression basée sur un dictionnaire : jeux de données présentant une structure répétitive d'une ligne à l'autre, tels que les entrées de journal, les champs de télémétrie IoV et les enregistrements d'événements comportementaux.
Pour consulter les résultats consolidés pour tous les scénarios, reportez-vous à la section Récapitulatif.
Commandes
Jeu de données
Ce scénario utilise le jeu de données de benchmark TPC-H, défini par le Transaction Processing Performance Council (TPC) pour évaluer les performances des requêtes analytiques.
Téléchargez l'outil TPC-H : TPC-H_Tools_v3.0.0.zip
Générez 10 Go de données de test :
# Unzip and build the data generator
unzip TPC-H_Tools_v3.0.0.zip
cd TPC-H_Tools_v3.0.0/dbgen
cp makefile.suite makefile

# Edit makefile: set the following fields
# CC = gcc
# DATABASE = ORACLE
# MACHINE = LINUX
# WORKLOAD = TPCH
make

# Generate 10 GB of test data
./dbgen -s 10
Cette opération génère huit fichiers .tbl. Ce test utilise le fichier ORDERS.tbl : 15 millions de lignes, 1,76 Go.
| Field | Type |
|---|---|
| O_ORDERKEY | INT |
| O_CUSTKEY | INT |
| O_ORDERSTATUS | CHAR(1) |
| O_TOTALPRICE | DECIMAL(15,2) |
| O_ORDERDATE | DATE |
| O_ORDERPRIORITY | CHAR(15) |
| O_CLERK | CHAR(15) |
| O_SHIPPRIORITY | INT |
| O_COMMENT | VARCHAR(79) |
Créer les tables de test
HBase
create 'ORDERS', {NAME => 'f', DATA_BLOCK_ENCODING => 'DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '32768}MySQL
CREATE TABLE ORDERS (
  O_ORDERKEY      INTEGER NOT NULL,
  O_CUSTKEY       INTEGER NOT NULL,
  O_ORDERSTATUS   CHAR(1) NOT NULL,
  O_TOTALPRICE    DECIMAL(15,2) NOT NULL,
  O_ORDERDATE     DATE NOT NULL,
  O_ORDERPRIORITY CHAR(15) NOT NULL,
  O_CLERK         CHAR(15) NOT NULL,
  O_SHIPPRIORITY  INTEGER NOT NULL,
  O_COMMENT       VARCHAR(79) NOT NULL
);
MongoDB
db.createCollection("ORDERS")Lindorm
-- lindorm-cli
CREATE TABLE ORDERS (
  O_ORDERKEY      INTEGER NOT NULL,
  O_CUSTKEY       INTEGER NOT NULL,
  O_ORDERSTATUS   CHAR(1) NOT NULL,
  O_TOTALPRICE    DECIMAL(15,2) NOT NULL,
  O_ORDERDATE     DATE NOT NULL,
  O_ORDERPRIORITY CHAR(15) NOT NULL,
  O_CLERK         CHAR(15) NOT NULL,
  O_SHIPPRIORITY  INTEGER NOT NULL,
  O_COMMENT       VARCHAR(79) NOT NULL,
  PRIMARY KEY(O_ORDERKEY)
);
Résultats de la compression
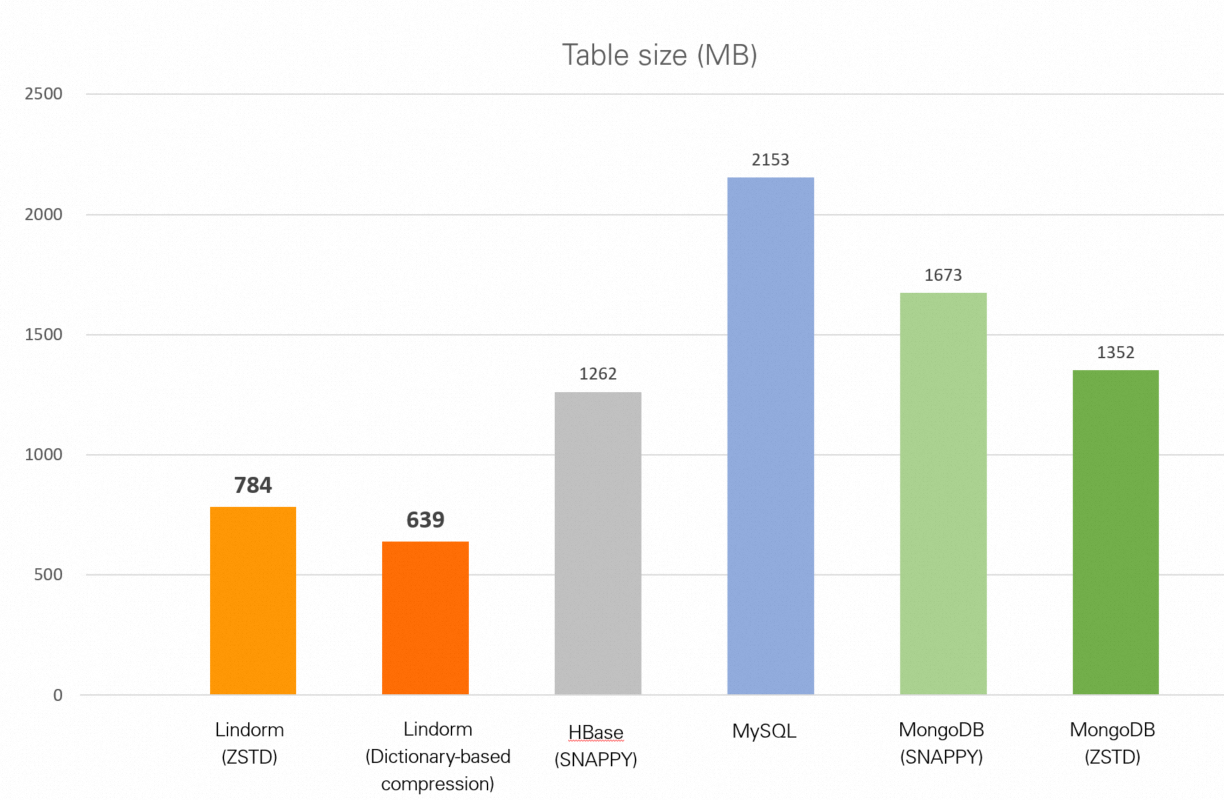
| Database | Table size |
|---|---|
| Lindorm (zstd) | 784 MB |
| Lindorm (dictionary-based compression) | 639 MB |
| HBase (Snappy) | 1,23 GB |
| MySQL (no compression) | 2,10 GB |
| MongoDB (Snappy) | 1,63 GB |
| MongoDB (zstd) | 1,32 GB |
IoV
Jeu de données
Ce scénario utilise le jeu de données NGSIM (Next Generation Simulation), collecté par la Federal Highway Administration américaine à partir des trajectoires de véhicules sur la route US 101. NGSIM est largement utilisé dans la recherche sur le comportement de conduite, l'analyse du flux de trafic, la prédiction des trajectoires de véhicules et la planification des décisions pour la conduite autonome.
Téléchargez le fichier NGSIM_Data.csv : 11,85 millions de lignes, 1,54 Go, 25 colonnes par ligne.
Créer les tables de test
HBase
create 'NGSIM', {NAME => 'f', DATA_BLOCK_ENCODING => 'DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '32768}MySQL
CREATE TABLE NGSIM (
  ID             INTEGER NOT NULL,
  Vehicle_ID     INTEGER NOT NULL,
  Frame_ID       INTEGER NOT NULL,
  Total_Frames   INTEGER NOT NULL,
  Global_Time    BIGINT NOT NULL,
  Local_X        DECIMAL(10,3) NOT NULL,
  Local_Y        DECIMAL(10,3) NOT NULL,
  Global_X       DECIMAL(15,3) NOT NULL,
  Global_Y       DECIMAL(15,3) NOT NULL,
  v_length       DECIMAL(10,3) NOT NULL,
  v_Width        DECIMAL(10,3) NOT NULL,
  v_Class        INTEGER NOT NULL,
  v_Vel          DECIMAL(10,3) NOT NULL,
  v_Acc          DECIMAL(10,3) NOT NULL,
  Lane_ID        INTEGER NOT NULL,
  O_Zone         CHAR(10),
  D_Zone         CHAR(10),
  Int_ID         CHAR(10),
  Section_ID     CHAR(10),
  Direction      CHAR(10),
  Movement       CHAR(10),
  Preceding      INTEGER NOT NULL,
  Following      INTEGER NOT NULL,
  Space_Headway  DECIMAL(10,3) NOT NULL,
  Time_Headway   DECIMAL(10,3) NOT NULL,
  Location       CHAR(10) NOT NULL,
  PRIMARY KEY(ID)
);
MongoDB
db.createCollection("NGSIM")Lindorm
-- lindorm-cli
CREATE TABLE NGSIM (
  ID             INTEGER NOT NULL,
  Vehicle_ID     INTEGER NOT NULL,
  Frame_ID       INTEGER NOT NULL,
  Total_Frames   INTEGER NOT NULL,
  Global_Time    BIGINT NOT NULL,
  Local_X        DECIMAL(10,3) NOT NULL,
  Local_Y        DECIMAL(10,3) NOT NULL,
  Global_X       DECIMAL(15,3) NOT NULL,
  Global_Y       DECIMAL(15,3) NOT NULL,
  v_length       DECIMAL(10,3) NOT NULL,
  v_Width        DECIMAL(10,3) NOT NULL,
  v_Class        INTEGER NOT NULL,
  v_Vel          DECIMAL(10,3) NOT NULL,
  v_Acc          DECIMAL(10,3) NOT NULL,
  Lane_ID        INTEGER NOT NULL,
  O_Zone         CHAR(10),
  D_Zone         CHAR(10),
  Int_ID         CHAR(10),
  Section_ID     CHAR(10),
  Direction      CHAR(10),
  Movement       CHAR(10),
  Preceding      INTEGER NOT NULL,
  Following      INTEGER NOT NULL,
  Space_Headway  DECIMAL(10,3) NOT NULL,
  Time_Headway   DECIMAL(10,3) NOT NULL,
  Location       CHAR(10) NOT NULL,
  PRIMARY KEY(ID)
);
Résultats de la compression
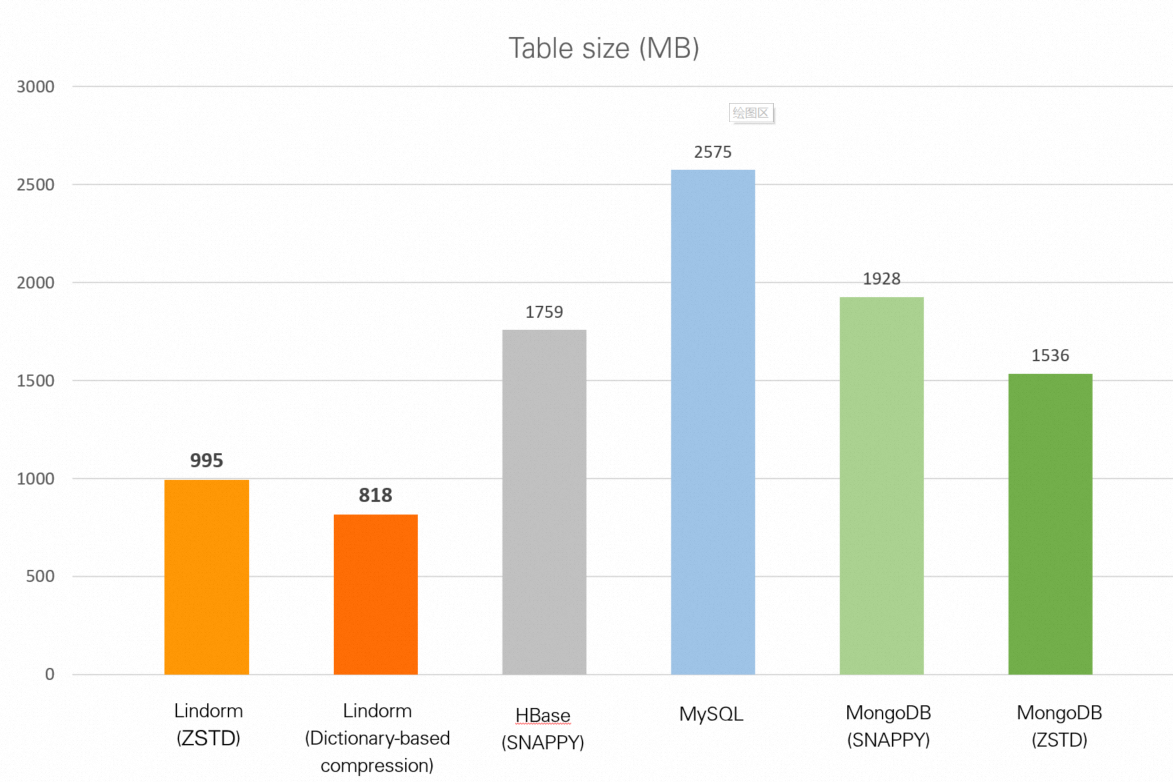
| Database | Table size |
|---|---|
| Lindorm (zstd) | 995 MB |
| Lindorm (dictionary-based compression) | 818 MB |
| HBase (Snappy) | 1,72 GB |
| MySQL (no compression) | 2,51 GB |
| MongoDB (Snappy) | 1,88 GB |
| MongoDB (zstd) | 1,50 GB |
Journaux
Jeu de données
Ce scénario utilise le jeu de données Online Shopping Store - Web Server Logs (Zaker, Farzin, 2019, Harvard Dataverse, V1).
Téléchargez le fichier access.log : 10,36 millions de lignes, 3,51 Go. Chaque ligne correspond à une entrée de journal unique. Exemple :
54.36.149.41 - - [22/Jan/2019:03:56:14 +0330] "GET /filter/27|13%20%D9%85%DA%AF%D8%A7%D9%BE%DB%8C%DA%A9%D8%B3%D9%84,27|%DA%A9%D9%85%D8%AA%D8%B1%20%D8%A7%D8%B2%205%20%D9%85%DA%AF%D8%A7%D9%BE%DB%8C%DA%A9%D8%B3%D9%84,p53 HTTP/1.1" 200 30577 "-" "Mozilla/5.0 (compatible; AhrefsBot/6.1; +http://ahrefs.com/robot/)" "-"Les données de journal présentent une structure répétitive d'une ligne à l'autre, ce qui explique pourquoi ce scénario affiche les gains de compression les plus élevés avec la compression basée sur un dictionnaire.
Créer les tables de test
HBase
create 'ACCESS_LOG', {NAME => 'f', DATA_BLOCK_ENCODING => 'DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '32768}MySQL
CREATE TABLE ACCESS_LOG (
  ID      INTEGER NOT NULL,
  CONTENT VARCHAR(10000),
  PRIMARY KEY(ID)
);
MongoDB
db.createCollection("ACCESS_LOG")Lindorm
-- lindorm-cli
CREATE TABLE ACCESS_LOG (
  ID      INTEGER NOT NULL,
  CONTENT VARCHAR(10000),
  PRIMARY KEY(ID)
);
Résultats de la compression
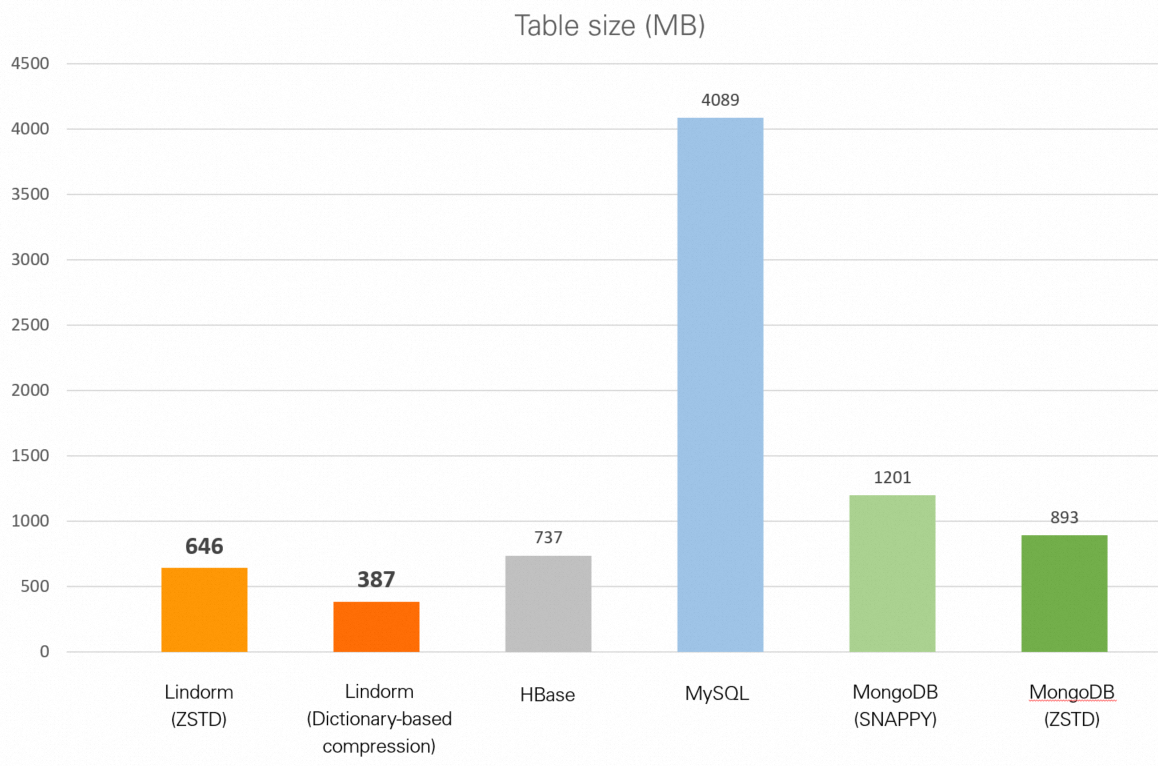
| Database | Table size |
|---|---|
| Lindorm (zstd) | 646 MB |
| Lindorm (dictionary-based compression) | 387 MB |
| HBase (Snappy) | 737 MB |
| MySQL (no compression) | 3,99 GB |
| MongoDB (Snappy) | 1,17 GB |
| MongoDB (zstd) | 893 MB |
Comportements utilisateurs
Jeu de données
Ce scénario utilise le jeu de données Shop Info and User Behavior data from IJCAI-15 provenant d'Alibaba Cloud Tianchi.
Téléchargez le fichier data_format1.zip et utilisez le fichier user_log_format1.csv : 54,92 millions de lignes, 1,91 Go.
| Column | Sample values |
|---|---|
| user_id | 328862 |
| item_id | 323294, 844400, 575153 |
| cat_id | 833, 1271 |
| seller_id | 2882 |
| brand_id | 2661 |
| time_stamp | 829 |
| action_type | 0 |
Créer les tables de test
HBase
create 'USER_LOG', {NAME => 'f', DATA_BLOCK_ENCODING => 'DIFF', COMPRESSION => 'SNAPPY', BLOCKSIZE => '32768}MySQL
CREATE TABLE USER_LOG (
  ID          INTEGER NOT NULL,
  USER_ID     INTEGER NOT NULL,
  ITEM_ID     INTEGER NOT NULL,
  CAT_ID      INTEGER NOT NULL,
  SELLER_ID   INTEGER NOT NULL,
  BRAND_ID    INTEGER,
  TIME_STAMP  CHAR(4) NOT NULL,
  ACTION_TYPE CHAR(1) NOT NULL,
  PRIMARY KEY(ID)
);
MongoDB
db.createCollection("USER_LOG")Lindorm
-- lindorm-cli
CREATE TABLE USER_LOG (
  ID          INTEGER NOT NULL,
  USER_ID     INTEGER NOT NULL,
  ITEM_ID     INTEGER NOT NULL,
  CAT_ID      INTEGER NOT NULL,
  SELLER_ID   INTEGER NOT NULL,
  BRAND_ID    INTEGER,
  TIME_STAMP  CHAR(4) NOT NULL,
  ACTION_TYPE CHAR(1) NOT NULL,
  PRIMARY KEY(ID)
);
Résultats de la compression
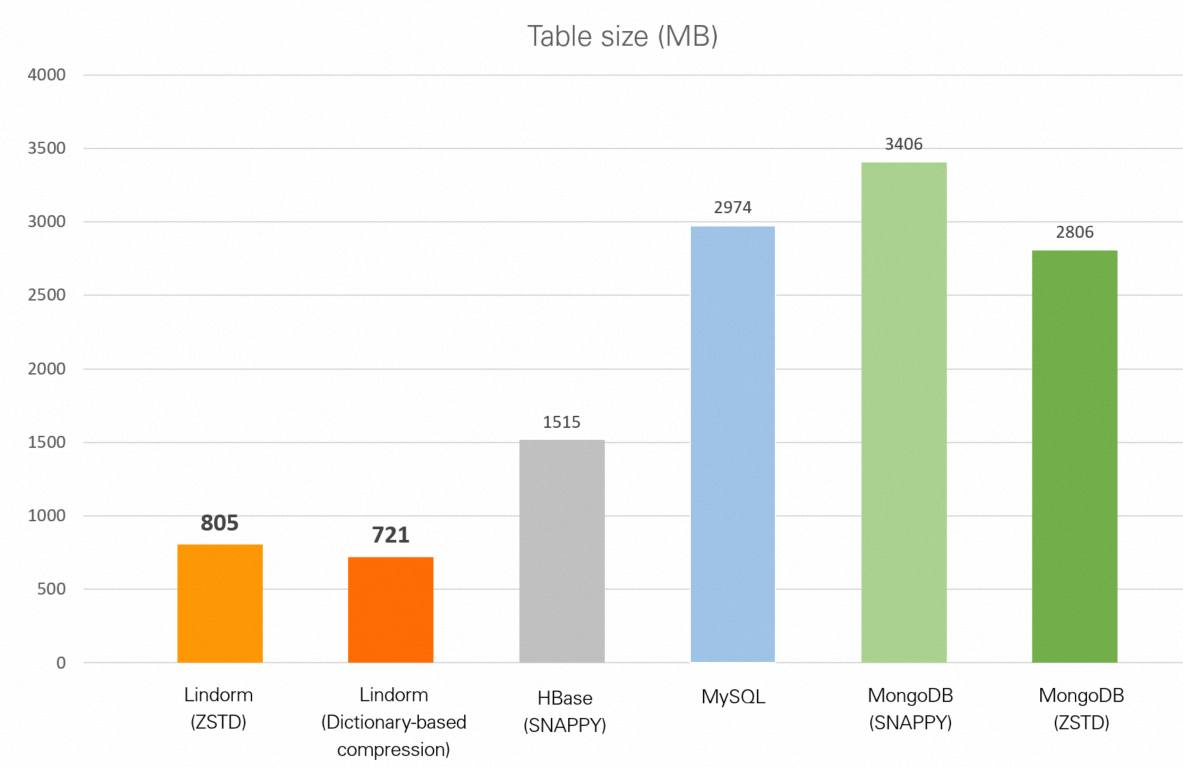
| Database | Table size |
|---|---|
| Lindorm (zstd) | 805 MB |
| Lindorm (dictionary-based compression) | 721 MB |
| HBase (Snappy) | 1,48 GB |
| MySQL (no compression) | 2,90 GB |
| MongoDB (Snappy) | 3,33 GB |
| MongoDB (zstd) | 2,74 GB |
Récapitulatif
Lindorm atteint un taux de compression supérieur à celui des bases de données open source, même sans activer la compression basée sur un dictionnaire. Avec cette fonctionnalité activée, Lindorm obtient le meilleur taux de compression dans les quatre scénarios. Par rapport aux configurations par défaut de chaque base de données open source, Lindorm avec compression basée sur un dictionnaire réduit la taille des données stockées de :
1 à 2 fois plus que HBase open source (Snappy)
2 à 4 fois plus que MongoDB open source (Snappy ou zstd)
3 à 10 fois plus que MySQL open source (non compressé)
Le tableau suivant consolide l'ensemble des résultats de test.
| Dataset | Original size | Lindorm (zstd) | Lindorm (dictionary) | HBase (Snappy) | MySQL | MongoDB (Snappy) | MongoDB (zstd) |
|---|---|---|---|---|---|---|---|
| Order data (TPC-H) | 1,76 GB | 784 MB | 639 MB | 1,23 GB | 2,10 GB | 1,63 GB | 1,32 GB |
| IoV data (NGSIM) | 1,54 GB | 995 MB | 818 MB | 1,72 GB | 2,51 GB | 1,88 GB | 1,50 GB |
| Log data (web server) | 3,51 GB | 646 MB | 387 MB | 737 MB | 3,99 GB | 1,17 GB | 893 MB |
| User behavior (IJCAI-15) | 1,91 GB | 805 MB | 721 MB | 1,48 GB | 2,90 GB | 3,33 GB | 2,74 GB |
Choix entre zstd et la compression basée sur un dictionnaire : zstd est activé par défaut et réduit les coûts de stockage pour tous les types de données sans configuration supplémentaire. La compression basée sur un dictionnaire offre une réduction supplémentaire, particulièrement marquée pour les données de journal (387 Mo contre 646 Mo) et plus modeste pour les données IoV riches en valeurs numériques, au prix d'une étape d'entraînement du dictionnaire lors de l'ingestion des données.