Par le passé, les opérations de compaction déclenchées par des chargements massifs de données consommaient les ressources dédiées de l'instance, entrant en concurrence avec les requêtes et réduisant la stabilité de cette dernière. À partir de Hologres V3.1.11, vous pouvez déléguer la compaction à des ressources serverless afin qu'elle s'exécute simultanément à l'importation, sans solliciter l'entrepôt virtuel de votre instance.
Fonctionnement
Lorsque cette fonctionnalité est activée, la compaction déclenchée par un chargement massif s'exécute sur des ressources serverless plutôt que sur les ressources dédiées de l'instance. Cette approche préserve les performances des autres opérations.
Activer la délégation de la compaction
Définissez hg_serverless_computing_run_compaction_before_commit_bulk_load sur on. Le paramètre prend effet au niveau où il est appliqué.
Commandes de configuration
|**Niveau**
|
**Commande**
| | --- | --- | |
Session
|
`SET hg_serverless_computing_run_compaction_before_commit_bulk_load = on;`
| |
Utilisateur
|
`ALTER USER "
| |
Base de données
|
`ALTER DATABASE
|
Référence des paramètres
|**Attribut**
|
**Valeur**
| | --- | --- | |
Type
|
Booléen
| |
Valeurs
|
`on` — la compaction s'exécute sur des ressources serverless ; `off` — la compaction utilise les ressources dédiées de l'instance
| |
Portée
|
Session, utilisateur ou base de données
|
Limitations
Durée d'importation : L'activation de cette option augmente légèrement le temps d'importation des données, mais améliore considérablement la stabilité de l'instance en cas de charge concurrente.
Portée : La compaction concurrente s'applique uniquement aux importations massives de données. Le nettoyage des données obsolètes lors de la compaction continue d'utiliser les ressources dédiées de l'instance.
Niveau de stockage : La compaction concurrente concerne uniquement les données importées dans le stockage chaud (niveau Standard). Les données importées dans le stockage froid (niveau Infrequent Access) ne sont pas affectées.
Exemple
Cet exemple utilise la fonctionnalité Importation de jeu de données public dans HoloWeb pour importer le jeu de données TPC-H de 100 Go. L'exécution de la même importation avec et sans compaction concurrente permet de comparer l'impact sur la consommation des ressources de l'instance.
-
Désactivez la compaction concurrente au niveau de la base de données et exécutez une tâche d'importation de données.
ALTER DATABASE <db_name> SET hg_serverless_computing_run_compaction_before_commit_bulk_load = off; -
Activez la compaction concurrente au niveau de la base de données et relancez la tâche d'importation de données.
ALTER DATABASE <db_name> SET hg_serverless_computing_run_compaction_before_commit_bulk_load = on; -
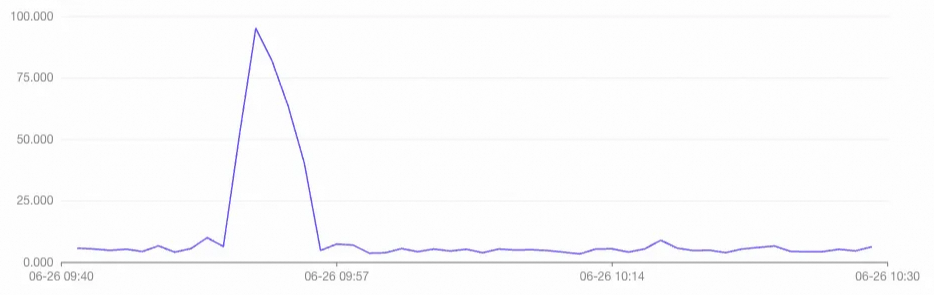
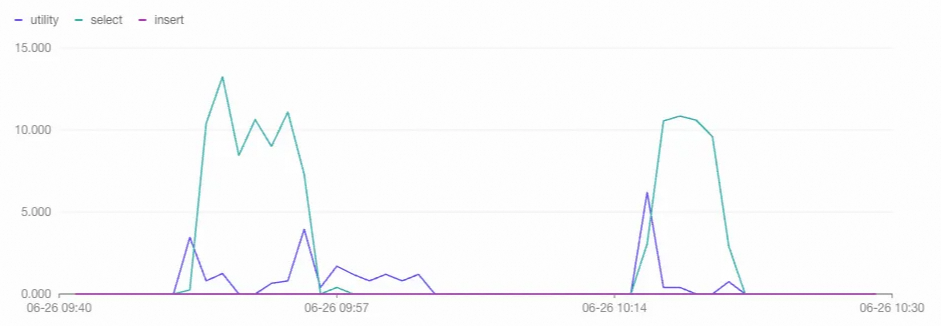
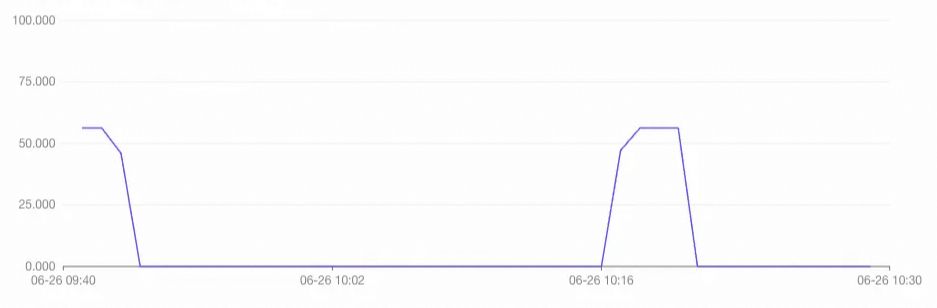
Une fois les deux importations terminées, consultez les métriques de surveillance de l'instance. Les graphiques ci-dessous confirment qu'avec la compaction concurrente activée, la tâche d'importation utilise bien les ressources serverless comme prévu, et que la tâche de compaction ne consomme aucune ressource dédiée de l'entrepôt virtuel.
-
Utilisation du CPU de l'entrepôt virtuel
-
QPS des tâches d'importation
-
Utilisation des ressources serverless
-