Cette rubrique explique comment utiliser la réplication au niveau des shards dans Hologres.
Fonctionnement
À partir de Hologres V1.1, améliorez la concurrence des requêtes et la disponibilité d'un groupe de tables en définissant son nombre de réplicas. Activez la réplication en spécifiant le nombre de réplicas lors de la création d'un groupe de tables ou modifiez ce nombre pour un groupe existant. Les réplicas ajoutés sont des copies en mémoire et n'engendrent aucun coût de stockage.
Détails concernant le nombre de réplicas :
Les données sont réparties sur plusieurs shards. Chaque shard gère un sous-ensemble des données. Ensemble, tous les shards constituent l'ensemble complet des données.
Par défaut, chaque shard ne possède qu'un seul réplica, c'est-à-dire
replica_count = 1. Ce réplica est le shard leader. Augmentez le nombre de réplicas pour créer plusieurs copies des mêmes données. Ces réplicas supplémentaires sont des shards followers.Le shard leader traite les requêtes d'écriture. Les requêtes de lecture sont équilibrées entre tous les réplicas, y compris les shards leaders et followers. Lors de l'interrogation d'un shard follower, vous pouvez observer une latence des données comprise entre 10 ms et 20 ms.
Une politique d'anti-affinité empêche le déploiement de plusieurs réplicas du même shard sur le même nœud worker. Par conséquent, la valeur de
replica_countne doit pas dépasser le nombre de nœuds workers. Dans Hologres V1.3.53 et versions ultérieures, une erreur survient si cette limite est dépassée. Pour connaître le nombre de nœuds workers correspondant à différentes spécifications d'instance, consultez la section Instance management.Pour garantir une charge de calcul équilibrée sur les nœuds workers, réduisez le nombre de shards lorsque vous augmentez le nombre de réplicas. Les performances optimales sont atteintes lorsque
shard_count * replica_count = nombre de shards recommandé pour l'instance.Hologres prend en charge la haute disponibilité (HA) pour les requêtes depuis la version V1.3.45.
-
Si la page de surveillance de votre instance affiche les éléments suivants :
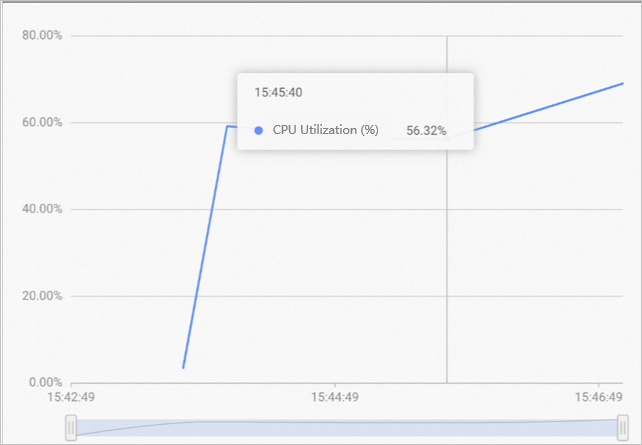
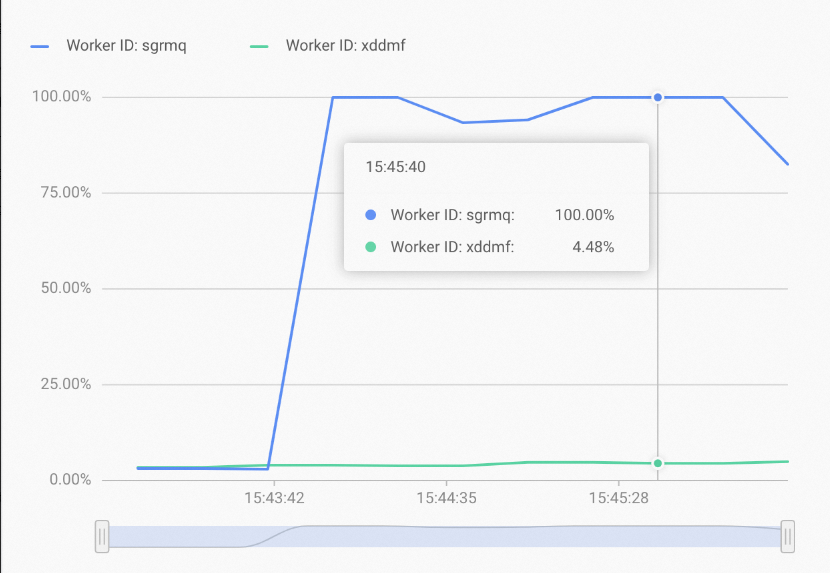
L'utilisation globale des ressources de l'instance n'est pas élevée, mais quelques nœuds workers affichent une utilisation élevée tandis que d'autres ont une faible utilisation. Cela peut être dû à une répartition inégale des requêtes, où la plupart des requêtes sont traitées par seulement quelques shards. Dans ce cas, augmentez le nombre de réplicas pour distribuer les réplicas sur davantage de workers. Cette stratégie permet d'améliorer efficacement l'utilisation des ressources et le nombre de requêtes par seconde (QPS).
RemarqueLa synchronisation des métadonnées entre les shards leaders et les shards followers consomme des ressources. Plus vous avez de réplicas, plus la consommation de ressources est importante. Par conséquent, nous ne recommandons pas d'utiliser cette méthode pour augmenter le QPS, sauf si vous avez confirmé que l'utilisation inégale des ressources est causée par une répartition inégale des requêtes.
De plus, il existe une latence des données de l'ordre de la milliseconde entre les shards leaders et les shards followers.
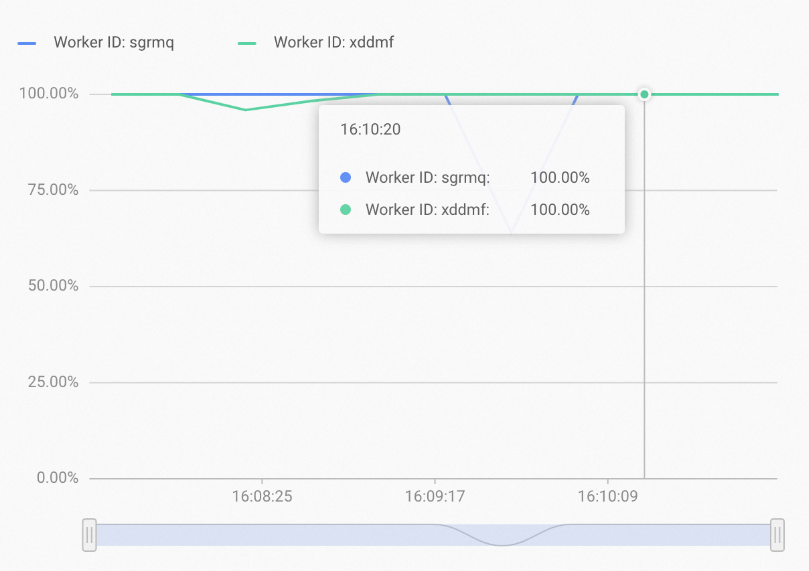
Après avoir augmenté le nombre de réplicas, les ressources de chaque worker sont utilisées de manière plus uniforme dans les mêmes conditions de requête, comme illustré dans la figure suivante.
Limites
-
La réplication au niveau des shards est prise en charge uniquement dans Hologres V1.1 et versions ultérieures.
RemarqueVérifiez la version actuelle de votre instance sur la page des détails de l'instance dans la console Hologres. Si votre instance est antérieure à la version V0.10, consultez la section Instance upgrades pour obtenir les instructions de mise à niveau ou rejoignez le groupe DingTalk Hologres pour obtenir de l'aide. Pour plus d'informations, consultez la section How to get online support?.
Le paramètre
replica_countdoit être inférieur ou égal au nombre de nœuds workers. Consultez le nombre de nœuds workers de votre instance sur la page des détails de l'instance dans la console Hologres.
Gérer la réplication des shards
-
Interroger les groupes de tables de la base de données actuelle
Utilisez l'instruction suivante pour afficher les groupes de tables de la base de données actuelle :
select * from hologres.hg_table_group_properties ; -
Interroger le nombre de réplicas d'un groupe de tables existant
-
Exemple
select property_value from hologres.hg_table_group_properties where tablegroup_name = 'table_group_name' and property_key = 'replica_count'; -
Paramètres
|
**Parameter**
|
**Description**
| | --- | --- | |
table_group_name
|
Le nom du groupe de tables cible.
| |
replica_count
|
Il s'agit d'un nom de paramètre fixe qui ne doit pas être modifié.
|
-
-
Activer la réplication
-
Exemple
Utilisez l'instruction suivante pour ajuster le nombre de réplicas d'un groupe de tables :
-- Adjust the replica count of a table group. call hg_set_table_group_property ('<table_group_name>', 'replica_count', '<replica_count>'); -
Paramètres
Parameter
Description
hg_set_table_group_property
Modifies the
replica_countof a table group.-
table_group_name: The name of the table group that you want to modify. -
replica_count: The desired number of replicas for the table group. The value must not exceed the number of worker nodes. A typical value is 2. -
The default is 1 (replication disabled). A value greater than 1 enables replication.
-
-
-
Désactiver la réplication
-
Exemple
-- Modify replica_count to disable replication. call hg_set_table_group_property ('table_group_name', 'replica_count', '1'); -
Paramètres
Parameter
Description
hg_set_table_group_property
Modifies the
replica_countof a table group.-
table_group_name: The name of the table group that you want to modify. -
replica_count: The desired number of replicas for the table group. -
The default is 1 (replication disabled). A value greater than 1 enables replication.
-
-
-
Vérifier l'état du chargement
Après avoir configuré plusieurs réplicas, exécutez l'instruction SQL suivante pour afficher l'état du chargement des shards sur chaque worker :
SELECT * FROM hologres.hg_worker_info;RemarqueLa colonne
worker_idpeut être vide avant qu'un worker ne termine le chargement des métadonnées des shards.Le résultat de la requête inclut les colonnes
worker_id,table_group_nameetshard_id. En plus deolap_replica_2, le résultat contient également des informations de distribution des shards pour d'autres groupes de tables tels queolap_replica_2_tg_inte.Pour le groupe de tables
olap_replica_2, qui comporte deux shards avec des valeursshard_idde 0 et 1, une copie des données de chaque shard existe sur les workers7tn8ket9c8sl.
Routage des requêtes pour la haute disponibilité et le débit
Comportement
-
Lorsque plusieurs réplicas de shards sont configurés, les réplicas d'un shard sont chargés sur plusieurs workers, comme illustré dans la figure suivante. Le système route ensuite les requêtes aléatoirement vers un réplica de shard sur l'un des workers pour traitement.
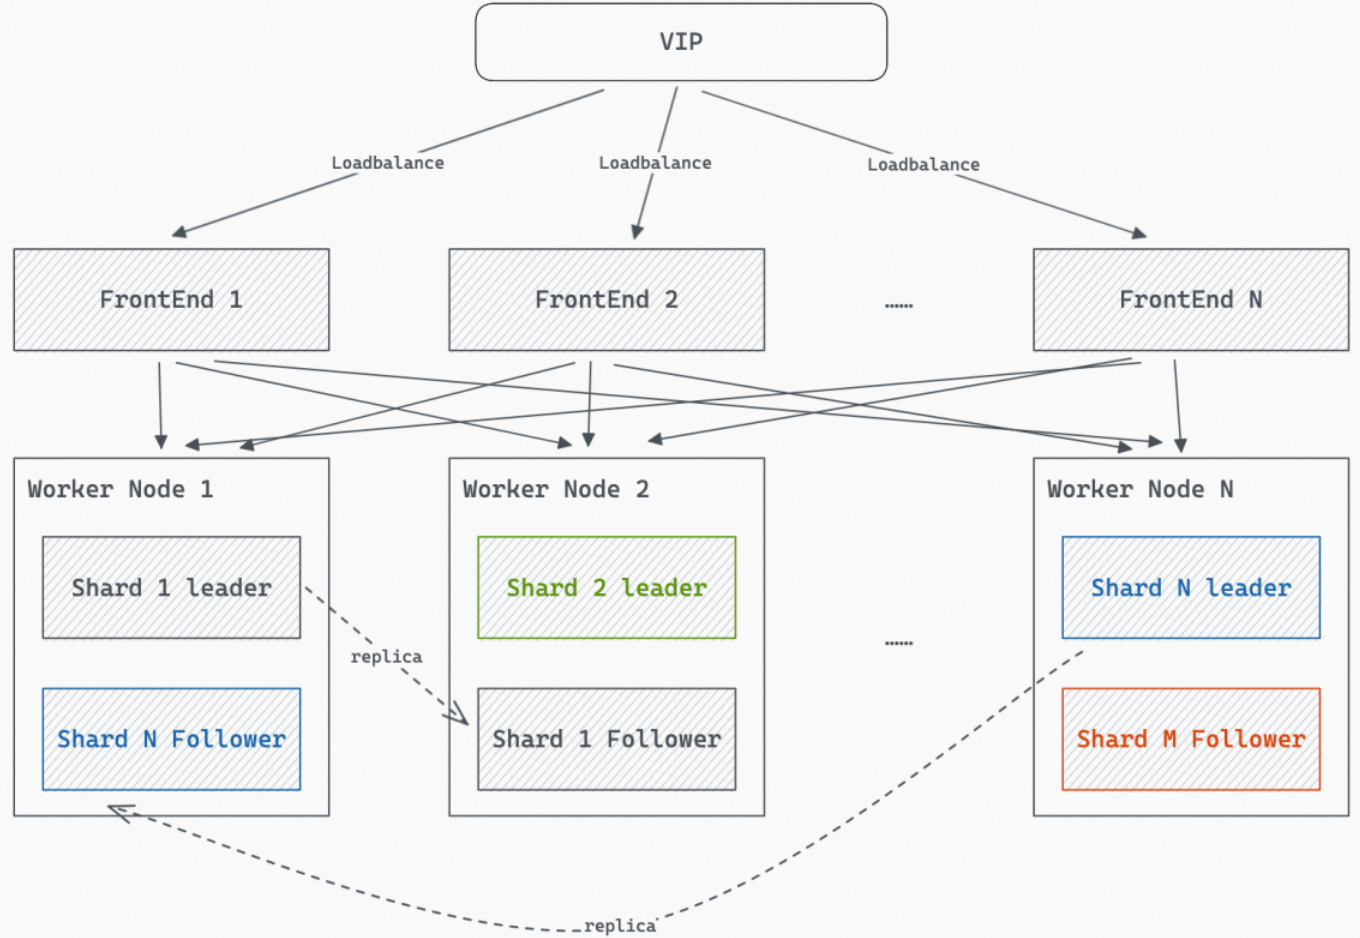
Pour les scénarios de requêtes ponctuelles (requêtes à plan fixe), un mécanisme de nouvelle tentative garantit le renvoi des résultats dans la mesure du possible. Si une requête ne renvoie pas de résultat dans un certain délai, elle est retentée sur un réplica situé sur un autre worker.
Paramètres
-
hg_experimental_query_replica_mode: Spécifie la stratégie de shard pour répondre aux requêtes.Use case
Default
Type
Valid values
Example
All queries
leader_follower
TEXT
-
leader_follower(default): Indicates that both leader shards and follower shards are used proportionally to respond to queries. -
leader_only: Indicates that only the leader shard is used to respond to queries. With this setting, you cannot scale out throughput or achieve high availability, even ifreplicas > 1. -
follower_only: Specifies that only follower shards are used to answer queries, and requiresreplicas > 3to ensure that there aretwo or more follower shardsfor increased throughput and high availability.
-- Session-level setting SET hg_experimental_query_replica_mode = leader_follower; -- Database-level setting ALTER DATABASE <database_name> SET hg_experimental_query_replica_mode = leader_follower; -
-
hg_experimental_query_replica_leader_weight: Spécifie le poids attribué au shard leader qui répond aux requêtes.Use case
Default
Type
Valid values
Example
All queries
100
INT
-
Maximum: 10000
-
Minimum: 1
-
Default: 100
-- Session-level setting
SET hg_experimental_query_replica_leader_weight = 100;

-- Database-level setting
ALTER DATABASE <database_name>
SET hg_experimental_query_replica_leader_weight = 100;
Lorsque le paramètre
replica_countd'un groupe de tables est supérieur à 1 et que la requête est une requête ponctuelle OLAP, les shards leaders et les shards followers répondent à la requête selon un ratio spécifique basé sur les paramètreshg_experimental_query_replica_modeethg_experimental_query_replica_leader_weight. Cela se produit dans les scénarios suivants :Scénario 1 : Si le groupe de tables d'une table a un paramètre
replica_countsupérieur à 1 et quehg_experimental_query_replica_mode=leader_follower, le système route les requêtes vers le shard leader et les shards followers. Le routage est basé sur un système de pondération. Le poids du shard leader est défini par le paramètrehg_experimental_query_replica_leader_weight, dont la valeur par défaut est 100. Par défaut, le poids de chaque shard follower est également de 100. Par exemple, sireplica_count=4, chaque shard dispose d'un shard leader et de trois shards followers. La probabilité qu'une requête soit routée vers l'un d'eux est de25%.Scénario 2 : Lorsque le groupe de tables d'une table a un paramètre
replica_count>1et quehg_experimental_query_replica_mode=leader_only, le système utilise uniquement le shard leader pour répondre aux requêtes, quelle que soit la valeur dereplica_count.Scénario 3 : Lorsque le groupe de tables correspondant à une table a un paramètre
replica_count>1et quehg_experimental_query_replica_mode='follower_only', le système utilise uniquement les shards followers pour répondre aux requêtes. Par défaut, le poids de chaque shard follower pour répondre à une requête est de 100. Par exemple, sireplica_count=4, il y a un shard leader et trois shards followers. Dans ce cas, seuls les trois shards followers sont utilisés pour répondre aux requêtes, et la probabilité d'atteindre chaque shard follower est d'un tiers.
-
-
hg_experimental_query_replica_fixed_plan_ha_mode: Spécifie le mode de haute disponibilité pour les scénarios de requêtes ponctuelles (requêtes à plan fixe).Use case
Default
Type
Valid values
Example
Point query (fixed-plan query)
any
TEXT
-
any(Default): Randomly distributes queries to shard replicas based on the shard scope defined byhg_experimental_query_replica_modeand the weight defined byhg_experimental_query_replica_leader_weight. -
leader_first: The default value. This setting takes effect only whenhg_experimental_query_replica_modeis set toleader_follower. It prioritizes sending queries to the leader shard and falls back to a follower shard only if the leader shard is unavailable, such as due to a timeout. -
off: The query is performed only once without any retries.
-- Session-level setting SET hg_experimental_query_replica_fixed_plan_ha_mode = any; -- Database-level setting ALTER DATABASE <database_name> SET hg_experimental_query_replica_fixed_plan_ha_mode = any; -
-
hg_experimental_query_replica_fixed_plan_first_query_timeout_ms: Spécifie le délai d'attente pour la requête initiale en mode haute disponibilité pour les requêtes ponctuelles (requêtes à plan fixe). En cas de dépassement du délai, la requête est envoyée à un autre shard disponible pour une nouvelle tentative. Par exemple,hg_experimental_query_replica_fixed_plan_first_query_timeout_ms=60indique que si une requête ne renvoie pas de résultat dans les 60 ms, le système retente la requête sur un autre worker.Use case
Default
Type
Valid values
Example
All queries
60
INT
-
Maximum: 10000
-
Minimum: 0
-
Default: 60
-- Session-level setting SET hg_experimental_query_replica_fixed_plan_first_query_timeout_ms = 60; -- Database-level setting ALTER DATABASE <database_name> SET hg_experimental_query_replica_fixed_plan_first_query_timeout_ms = 60; -
Cas d'utilisation
Cas d'utilisation 1 : Débit élevé avec plusieurs réplicas
-
Scénario : Vous observez via la surveillance que l'utilisation globale des ressources de votre instance n'est pas élevée, mais que quelques nœuds workers présentent une utilisation élevée des ressources tandis que d'autres sont sous-utilisés. Cela est probablement dû à une répartition inégale des requêtes, où la plupart des requêtes sont traitées par quelques shards. Dans ce cas, augmentez le nombre de réplicas de shards pour placer les réplicas sur davantage de workers, ce qui améliore efficacement l'utilisation des ressources et le QPS.
-
Procédure :
-
Augmentez le nombre de réplicas :
Par exemple, si vous disposez d'un groupe de tables nommé
tg_replicadans votre base de données, utilisez l'instruction SQL suivante pour définir son nombre de réplicas à 2.-- Set the replica count of the 'tg_replica' table group to 2. call hg_set_table_group_property ('tg_replica', 'replica_count', '2');Le système utilise la configuration par défaut suivante :
hg_experimental_query_replica_mode=leader_followerhg_experimental_query_replica_leader_weight=100
Après avoir augmenté le nombre de réplicas, le système distribue aléatoirement les requêtes aux nœuds workers hébergeant le shard leader et les shards followers. Cela résout le problème selon lequel le QPS ne peut pas être augmenté en raison de points chauds de requêtes.
-
Vérifiez si les workers ont chargé les shards :
Utilisez la commande suivante pour vérifier si les shards sont chargés sur les workers :
SELECT * FROM hologres.hg_worker_info WHERE table_group_name = 'tg_replica';Le résultat inclut les colonnes
worker_id,table_group_nameetshard_id.La configuration est réussie si la sortie affiche le même shard_id chargé sur plusieurs worker_ids.
-
Cas d'utilisation 2 : Haute disponibilité avec plusieurs réplicas
-
Scénario : Prévenir les échecs de requêtes causés par un basculement de shard unique.
-
Procédure :
-
Augmentez le nombre de réplicas :
Par exemple, si vous disposez d'un groupe de tables nommé
tg_replicadans votre base de données, utilisez l'instruction SQL suivante pour définir son nombre de réplicas à 2.-- Set the replica count of the 'tg_replica' table group to 2. call hg_set_table_group_property ('tg_replica', 'replica_count', '2');Le système utilise la configuration par défaut suivante :
hg_experimental_query_replica_mode=leader_followerhg_experimental_query_replica_fixed_plan_ha_mode=anyhg_experimental_query_replica_fixed_plan_first_query_timeout_ms=60
Après avoir augmenté le nombre de réplicas :
Pour les scénarios OLAP, le système distribue aléatoirement les requêtes aux nœuds workers des shards leaders et followers. Le processus Master vérifie périodiquement la disponibilité de chaque shard et supprime automatiquement les shards indisponibles de la liste des candidats aux requêtes. Une fois qu'un shard redevient disponible, il est ajouté à nouveau à la liste. Il faut 5 secondes pour détecter un shard indisponible et 10 secondes pour retirer le worker correspondant du frontend (FE). Par conséquent, des échecs de requêtes peuvent survenir pendant une durée maximale de 15 secondes durant ce processus de détection et de récupération. Les requêtes reprennent normalement par la suite.
Pour les scénarios de requêtes à plan fixe, le mécanisme de nouvelle tentative prévient les échecs de requêtes lors d'un basculement de worker, bien que le temps de réponse puisse augmenter.
-
Pour certains scénarios de requêtes à plan fixe sensibles à la cohérence lecture-après-écriture et ne pouvant pas tolérer la latence entre le shard leader et un shard follower, définissez le paramètre
hg_experimental_query_replica_fixed_plan_ha_modesurleader_first. Cela signifie que pour les requêtes à plan fixe, le shard leader est toujours utilisé en premier pour répondre à la requête. Si la requête adressée au shard leader expire, un shard follower est alors utilisé pour répondre à la requête.RemarqueDans ce cas, le scénario à plan fixe ne peut pas résoudre les goulots d'étranglement du QPS causés par les points chauds de requêtes.
-
Vérifiez si les workers ont chargé les shards :
Utilisez la commande suivante pour vérifier si les shards sont chargés sur les workers :
SELECT * FROM hologres.hg_worker_info WHERE table_group_name = 'tg_replica';Si le même shard est chargé par plusieurs workers, la configuration est réussie.
-
Dépannage
-
Problème : Après avoir configuré les paramètres comme décrit dans le cas d'utilisation 1, les requêtes ne sont pas distribuées aux shards followers. La charge des workers affichée dans la console Hologres reste aussi élevée qu'avant la configuration de plusieurs réplicas.
-
Dans les versions de Hologres antérieures à la V1.3, le paramètre GUC
hg_experimental_enable_read_replicacontrôle si les shards followers peuvent participer aux requêtes. Ce paramètre est désactivé par défaut. Utilisez l'instruction SQL suivante pour vérifier si ce paramètre est activé. Si la valeur renvoyée est « on », le paramètre est activé. Si la valeur renvoyée est « off », le paramètre est désactivé.SHOW hg_experimental_enable_read_replica; -
Pour résoudre ce problème, si
hg_experimental_enable_read_replicaest désactivé, utilisez l'instruction SQL suivante pour l'activer au niveau de la base de données.ALTER DATABASE <database_name> SET hg_experimental_enable_read_replica = on;Remplacez database_name par le nom de votre base de données.