Hologres Dynamic Table est une architecture de traitement des données déclarative qui traite et stocke automatiquement les résultats agrégés issus d'une ou plusieurs tables de base. Elle intègre des politiques de rafraîchissement configurables et natives, permettant un transfert automatique des données depuis les tables de base vers les Dynamic Tables. Cette approche répond aux besoins de développement unifié, de transfert automatisé des données et de traitement en temps opportun.
Quand utiliser Dynamic Table
Dynamic Table constitue une solution adaptée lorsque :
Vous souhaitez automatiser la transformation des données sans écrire de code de planification personnalisé.
Vous voulez éviter le suivi manuel des dépendances de données et la gestion des plannings de rafraîchissement.
Vous devez enchaîner plusieurs tables pour la transformation des données dans un pipeline, par exemple pour construire automatiquement les couches Data Warehouse Detail (DWD) → Data Warehouse Service (DWS) → Application Data Service (ADS).
Votre charge de travail n'exige pas une fraîcheur stricte des données en temps réel ; une actualisation à l'échelle de la minute ou de l'heure suffit.
Vous souhaitez consolider une architecture Lambda au sein d'un seul moteur doté d'une interface SQL unifiée.
Avantages
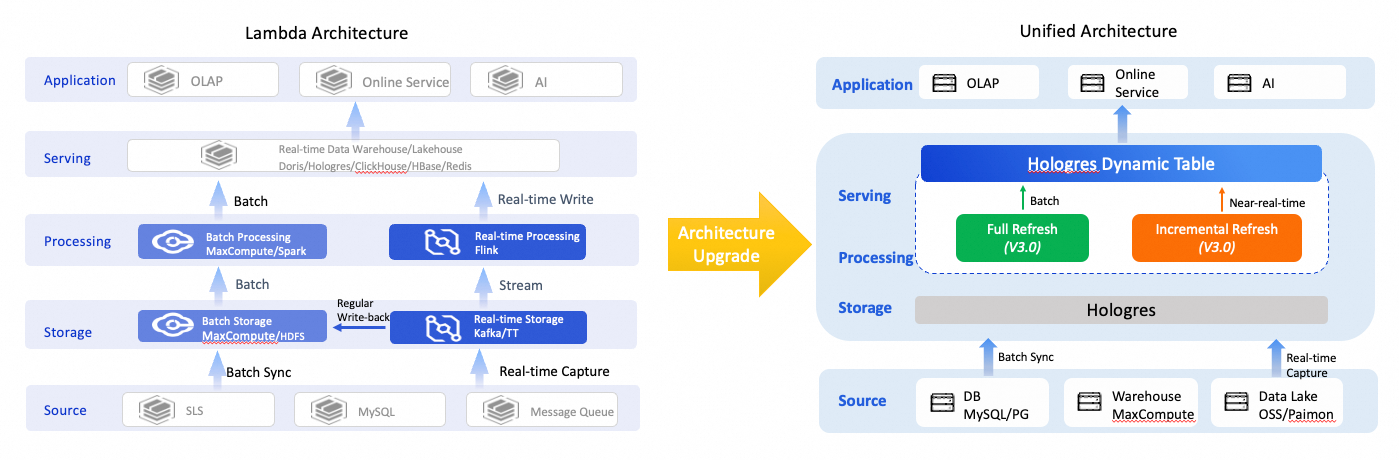
Architecture d'entrepôt de données simplifiée : Les modes de rafraîchissement complet et incrémentiel prennent en charge à la fois la transformation des données hors ligne et la transformation des données en quasi-temps réel. S'appuyant sur le stockage unifié de Hologres, Dynamic Table dessert directement plusieurs scénarios d'application — requêtes OLAP (Online Analytical Processing), services en ligne et charges de travail IA — via un seul moteur, un seul calcul et une seule instruction SQL. Cela remplace l'architecture Lambda et réduit les coûts de développement ainsi que ceux d'exploitation et de maintenance (O&M).
Automatic data warehouse layering : Une Dynamic Table déclenche automatiquement un rafraîchissement en fonction de la fraîcheur des données de la table de base, permettant un transfert automatique des données entre les couches Operation Data Store (ODS) → DWD → DWS → ADS.
Efficacité ETL améliorée : Le rafraîchissement incrémentiel ne traite que les nouvelles données de la table de base à chaque exécution, réduisant ainsi le volume de données calculé lors de chaque cycle ETL (Extract, Transform, Load). Les ressources n'ont pas besoin d'être constamment actives comme dans le cas du calcul en flux continu. Les rafraîchissements automatiques, déclenchés par la fraîcheur des données, permettent de réduire les coûts de calcul.
Coûts de développement et d'O&M réduits : Tous les modes de rafraîchissement utilisent une interface SQL unifiée. Les Dynamic Tables gèrent automatiquement les tâches de rafraîchissement et les dépendances hiérarchiques entre les couches, simplifiant ainsi les workflows complexes de développement et d'O&M.
Concepts clés
Table de base : Source de données d'une Dynamic Table. Il peut s'agir d'une table interne ou externe unique, ou d'une jointure de plusieurs tables. Les types de tables de base pris en charge varient selon le mode de rafraîchissement. Pour plus d'informations, consultez la rubrique Fonctionnalités prises en charge et limites de Dynamic Table.
Requête : Requête spécifiée lors de la création d'une Dynamic Table. Elle définit la manière dont les données de la table de base sont traitées, à l'instar d'un processus ETL. Les types de requêtes pris en charge varient selon le mode de rafraîchissement. Pour plus d'informations, consultez la rubrique Fonctionnalités prises en charge et limites de Dynamic Table.
Rafraîchissement : Lorsque les données d'une table de base changent, la Dynamic Table doit être rafraîchie pour refléter ces modifications. Les Dynamic Tables exécutent automatiquement des tâches de rafraîchissement en arrière-plan, selon l'heure de début et l'intervalle configurés. Pour en savoir plus sur la surveillance et la gestion des tâches de rafraîchissement, consultez la rubrique Gérer les tâches de rafraîchissement des Dynamic Tables.
Fonctionnement
Les données d'une table de base sont écrites dans une Dynamic Table via un processus de rafraîchissement, suivant le flux de traitement défini par la requête de la Dynamic Table. Les sections suivantes décrivent les principes techniques sous-jacents aux Dynamic Tables, couvrant les modes de rafraîchissement, les ressources de calcul, le stockage des données et les index de table.
Modes de rafraîchissement
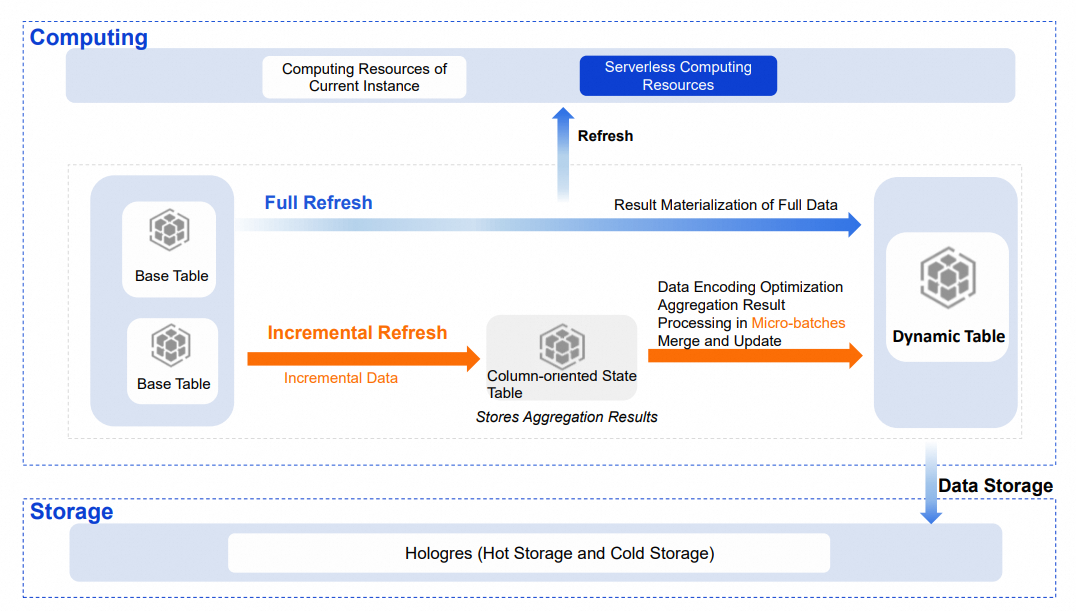
Dynamic Table prend en charge deux modes de rafraîchissement : complet et incrémentiel. Les principes techniques sous-jacents diffèrent selon le mode de rafraîchissement configuré.
Rafraîchissement complet
Un rafraîchissement complet retraite toutes les données à chaque exécution et écrase la Dynamic Table avec les résultats complets calculés à partir de la table de base, selon un principe similaire à une opération INSERT OVERWRITE. Ce processus peut générer un volume important de données Binlog et entraîner des frais de stockage supplémentaires significatifs. Pour plus d'informations sur les limites et sur la désactivation du Binlog, consultez la rubrique INSERT OVERWRITE.
Rafraîchissement incrémentiel
Le rafraîchissement incrémentiel lit uniquement les nouvelles données de la table de base à chaque exécution. Il calcule le résultat final en se basant sur l'état d'agrégation intermédiaire et les données incrémentielles, puis met à jour la Dynamic Table. Par rapport à un rafraîchissement complet, le rafraîchissement incrémentiel traite moins de données par exécution, ce qui améliore l'actualité des données tout en réduisant l'utilisation des ressources de calcul.
Principe technique
Lorsque vous créez une Dynamic Table avec rafraîchissement incrémentiel, le système lit les données incrémentielles de la table de base via la méthode Stream ou Binlog. Il crée ensuite en arrière-plan une table d'état orientée colonne, qui stocke l'état d'agrégation intermédiaire de la requête. Le moteur DPI optimise l'encodage et le stockage de cet état intermédiaire afin d'accélérer la lecture et la mise à jour. Les données incrémentielles sont agrégées par micro-lots en mémoire et fusionnées avec la table d'état. Les derniers résultats agrégés sont ensuite écrits dans la Dynamic Table via la méthode BulkLoad.
Choix entre Stream et Binlog
| Méthode | Principe | Performances de lecture | Notes |
|---|---|---|---|
| Stream (recommandé) | Détecte les modifications de données au niveau des fichiers pour calculer les données incrémentielles de la table de base. | Plus de 10 fois supérieures à celles de Binlog. | Plus simple à utiliser. N'enregistre pas séparément les modifications incrémentielles : aucun frais de stockage supplémentaire ni gestion du cycle de vie des journaux binaires requise. Ne prend pas en charge les tables orientées ligne comme tables de base. |
| Binlog | La journalisation binaire enregistre les modifications DML (Data Manipulation Language) apportées à la table de base et les stocke sous forme de journal binaire en arrière-plan. Le système lit le journal binaire pour détecter les modifications de données. | Inférieures. | Entraîne des frais de stockage supplémentaires. Nécessite la gestion du cycle de vie de stockage (TTL) du journal binaire ; sinon, l'utilisation du stockage augmente continuellement à mesure que les données changent. |
Remarques d'utilisation
Certaines limites s'appliquent aux tables de base prises en charge par le rafraîchissement incrémentiel. Pour plus d'informations, consultez la rubrique Fonctionnalités prises en charge et limites de Dynamic Table.
La table d'état intégrée pour le rafraîchissement incrémentiel occupe un certain espace de stockage. Le système définit un TTL pour nettoyer périodiquement les données. Utilisez la fonction fournie pour afficher la taille de stockage de la table d'état. Pour plus d'informations, consultez la rubrique Gérer les tables d'état.
Choisir un mode de rafraîchissement
Utilisez les critères suivants pour sélectionner un mode de rafraîchissement :
| Condition | Mode recommandé |
|---|---|
| La requête utilise des opérateurs pris en charge et les tables de base ne sont pas orientées ligne | Incrémentiel |
| Un pourcentage élevé de données change à chaque rafraîchissement, ou la requête inclut des opérateurs non pris en charge | Complet |
| Chargement initial ou garantie de la cohérence des données entre les couches | Complet (ponctuel) |
Ressources de calcul
Les tâches de rafraîchissement peuvent utiliser les ressources de l'instance actuelle ou des ressources Serverless :
Ressources Serverless (par défaut) : Dans Hologres V3.1 et versions ultérieures, les nouvelles Dynamic Tables utilisent par défaut des ressources Serverless. Pour les requêtes complexes ou les volumes de données importants, les ressources Serverless améliorent la stabilité du rafraîchissement et évitent la contention des ressources entre les tâches au sein de l'instance. Les ressources de calcul d'une tâche de rafraîchissement unique peuvent être ajustées indépendamment.
Ressources de l'instance actuelle : La tâche de rafraîchissement partage les ressources avec les autres tâches de l'instance, ce qui peut provoquer une contention des ressources pendant les heures de pointe.
Stockage des données
Le stockage des données d'une Dynamic Table est identique à celui d'une table standard, utilisant par défaut le mode de stockage chaud. Pour réduire les coûts de stockage, déplacez les données rarement interrogées vers le stockage froid.
Index de table
Interroger directement une Dynamic Table revient à interroger les résultats agrégés, ce qui améliore considérablement les performances des requêtes. À l'instar des tables standards, les Dynamic Tables prennent en charge des index de table tels que le stockage ligne ou colonne, la Distribution Key et la Clustering Key. Le moteur DPI déduit les index appropriés en fonction de la requête de la Dynamic Table. Définissez des index supplémentaires pour améliorer encore les performances des requêtes.
Comparaison avec les vues matérialisées
Dynamic Table vs vue matérialisée en temps réel Hologres
Hologres a introduit les vues matérialisées gérées par SQL dans la version V1.3. Dynamic Table étend considérablement ces capacités.
| Fonctionnalité | Hologres Dynamic Table | Vue matérialisée en temps réel Hologres |
|---|---|---|
| Type de table de base | Table interne ; Table externe (MaxCompute, Paimon, OSS) ; Dynamic Table ; Vue | Table interne unique |
| Opérations sur la table de base | Écriture, mise à jour, suppression | Écritures en ajout seul (append-only) |
| Principe de rafraîchissement | Rafraîchissement asynchrone (complet ou incrémentiel) | Synchrone |
| Actualité du rafraîchissement | Niveau minute ou heure | Temps réel |
| Types de requêtes | Agrégation sur table unique ; Jointure multi-tables ; JOIN avec table de dimension ; OLAP complexe (fonctions de fenêtrage, CTE, RB, etc.) Remarque
Les types de requêtes pris en charge varient selon le mode de rafraîchissement. Pour plus d'informations, consultez la rubrique Fonctionnalités prises en charge et limites de Dynamic Table. |
Prise en charge limitée des opérateurs (fonctions AGG, RB, etc.) |
| Mode de requête | Interroger directement la Dynamic Table | Interroger directement la vue matérialisée ; Réécriture de requête |
Dynamic Table vs vue matérialisée asynchrone
D'autres plateformes proposent des fonctionnalités similaires à Dynamic Table, telles que les vues matérialisées asynchrones dans les produits OLAP et Snowflake Dynamic Table.
| Fonctionnalité | Hologres Dynamic Table | Vue matérialisée asynchrone de produit OLAP | Snowflake Dynamic Table |
|---|---|---|---|
| Type de table de base | Table interne ; Table externe (MaxCompute, Paimon, OSS) ; Dynamic Table ; Vue Remarque
Les types de requêtes pris en charge varient selon le mode de rafraîchissement. Pour plus d'informations, consultez la rubrique Fonctionnalités prises en charge et limites de Dynamic Table. |
Table interne ; Table externe (Hive, Hudi, Iceberg, etc.) ; Vue matérialisée ; Vue | Table interne ; Dynamic Table ; Vue |
| Mode de rafraîchissement | Complet ; Incrémentiel | Complet ; Rafraîchissement par partition spécifiée ou plage d'horodatage | Complet ; Incrémentiel |
| Actualité du rafraîchissement | Niveau minute ou heure | Niveau heure | Niveau heure ou minute |
| Types de requêtes | Agrégation sur table unique ; Jointure multi-tables ; JOIN avec table de dimension ; OLAP complexe (fonctions de fenêtrage, CTE, RB, etc.) | Agrégation sur table unique ; Jointure multi-tables ; JOIN avec table de dimension ; OLAP complexe (fonctions de fenêtrage, CTE, etc.) | Agrégation sur table unique ; Jointure multi-tables ; JOIN avec table de dimension ; OLAP complexe (fonctions de fenêtrage, CTE, etc.) |
| Mode de requête | Interroger directement la Dynamic Table | Interroger directement la vue matérialisée ; Réécriture de requête | Interroger directement la Dynamic Table |
| Surveillance/O&M | Interfaces de visualisation DataWorks et HoloWeb ; Métriques de surveillance riches | Métriques de surveillance riches | Interface de visualisation |
Cas d'utilisation
Dynamic Table effectue automatiquement la transformation et le stockage des données, prenant en charge à la fois l'accélération des données et l'amélioration de l'actualité métier.
Modernisation de l'architecture Lambda
L'architecture Lambda utilise plusieurs composants de produit pour répondre à différentes exigences d'actualité, ce qui entraîne une architecture redondante, des définitions de données incohérentes, une maintenance difficile et une redondance de stockage. Dynamic Table prend en charge la transformation des données par lots et le traitement en quasi-temps réel. Combinée au stockage unifié de Hologres — qui prend en charge les requêtes OLAP et les requêtes ponctuelles clé-valeur (KV) —, elle couvre plusieurs scénarios d'application au sein d'un seul produit, simplifiant ainsi l'architecture et réduisant la complexité du développement ainsi que les coûts de stockage.
Traitement des données en quasi-temps réel
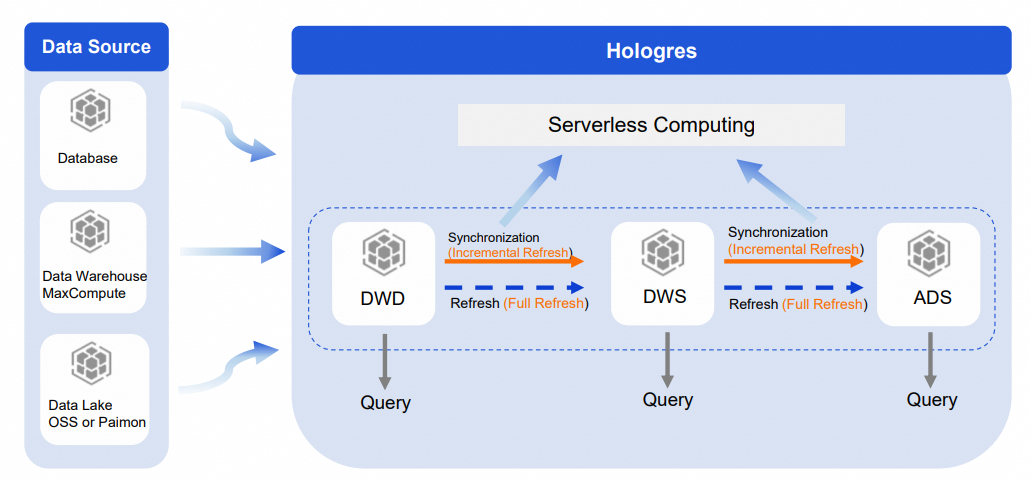
Pour les grandes tables de base nécessitant un traitement ETL complexe, la stratification de l'entrepôt de données est l'approche standard. Dynamic Table intègre un traitement automatique des données, ce qui facilite la mise en œuvre de la stratification dans Hologres.
Construisez les couches DWD → DWS → ADS dans Hologres à l'aide de Dynamic Tables :
Utilisez le rafraîchissement incrémentiel entre les couches. Cela garantit que moins de données sont traitées à chaque niveau, réduit les calculs répétés et améliore la vitesse de synchronisation. Soumettez les tâches de rafraîchissement au Serverless Computing pour améliorer encore l'actualité et la stabilité.
Effectuez un rafraîchissement complet ponctuel pour garantir la cohérence des données entre les couches. Soumettez également la tâche de rafraîchissement complet au Serverless Computing.
Chaque couche est interrogeable directement dans Hologres, offrant une stratification claire de l'entrepôt de données avec visibilité et réutilisabilité à tous les niveaux.
Accélération Lakehouse
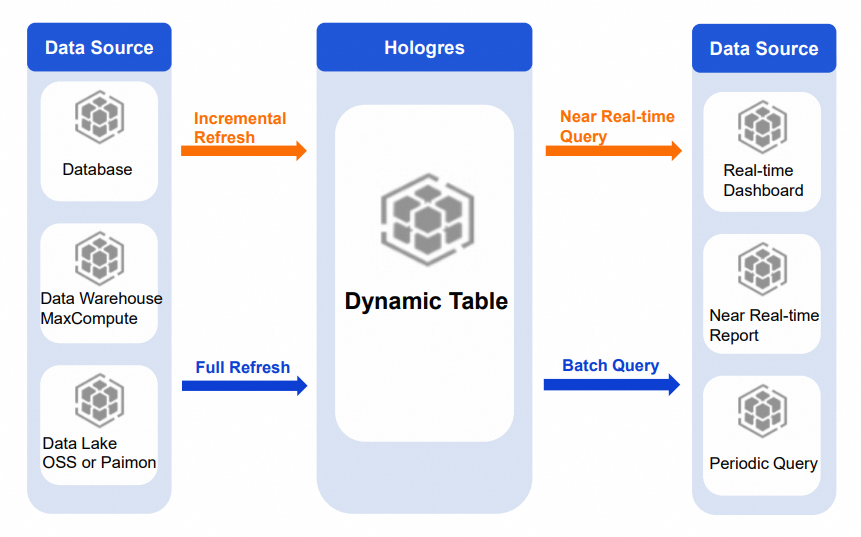
Les tables de base de Dynamic Table peuvent provenir de tables Hologres, d'entrepôts de données tels que MaxCompute, ou de lacs de données tels qu'OSS et Paimon. Les rafraîchissements complets ou incrémentiels sur ces données répondent à divers besoins de requête et d'exploration avec différentes exigences d'actualité.
Requêtes de rapports périodiques : Pour les scénarios d'observation périodique avec de petits volumes de données ou des requêtes simples, utilisez le rafraîchissement complet ou incrémentiel. Rafraîchissez périodiquement les résultats d'agrégation et d'analyse des données du lac de données vers une Dynamic Table. La couche application interroge directement la Dynamic Table pour récupérer les résultats précalculés, accélérant ainsi les requêtes de rapport.
Tableaux de bord et rapports en temps réel : Pour les scénarios exigeant une actualité plus élevée, utilisez le rafraîchissement incrémentiel. Rafraîchissez les résultats d'agrégation et d'analyse depuis Paimon ou les données en temps réel vers une Dynamic Table, permettant ainsi une analyse en quasi-temps réel.
Remplacement de la planification périodique hors ligne
Dans les scénarios de traitement hors ligne typiques, le volume de données est important et le cycle de calcul est long. Une approche courante exécute un traitement T+H (par exemple, toutes les 30 minutes) de DWD à DWS puis à ADS, plus un pipeline hors ligne T+1 distinct pour traiter les derniers jours de données afin d'assurer l'exactitude. Cela entraîne des calculs redondants, un gaspillage de ressources et une duplication des données. Les tâches planifiées peuvent également bloquer les travaux en aval si elles ne se terminent pas à temps.
Avec Dynamic Table, utilisez le rafraîchissement incrémentiel T+H pour chaque couche, de DWD à DWS puis à ADS. Plusieurs travaux fusionnent en un seul travail de calcul incrémentiel. Les Dynamic Tables gèrent automatiquement la planification, éliminant ainsi la nécessité de maintenir des travaux de planification externes. Seules les données incrémentielles sont calculées à chaque fois, ce qui élimine les calculs redondants, accélère les calculs, prévient les arriérés de tâches et réduit considérablement l'utilisation des ressources de calcul.
