Choisir les propriétés de table Hologres adaptées à vos modèles de requêtes réduit la quantité de données analysées, le nombre de fichiers accessibles et le nombre d'opérations d'E/S, ce qui se traduit par une latence plus faible et un débit de requêtes par seconde (QPS) plus élevé. Ce guide associe six scénarios de requête courants au format de stockage, à la clé primaire, à la clé de distribution, à la clé de clustering, au partitionnement et aux paramètres d'index bitmap qui conviennent le mieux à chacun d'eux.
Choisir un format de stockage
Hologres prend en charge trois formats de stockage : le stockage orienté ligne, le stockage orienté colonne et le stockage hybride ligne-colonne. Pour plus de détails sur chaque format, consultez la rubrique Configurer l'orientation des données.
Utilisez l'arbre de décision suivant pour sélectionner un format. Si votre charge de travail n'est pas encore bien définie, commencez par le stockage hybride ligne-colonne : il offre le meilleur compromis pour la plus large gamme de modèles de requêtes.
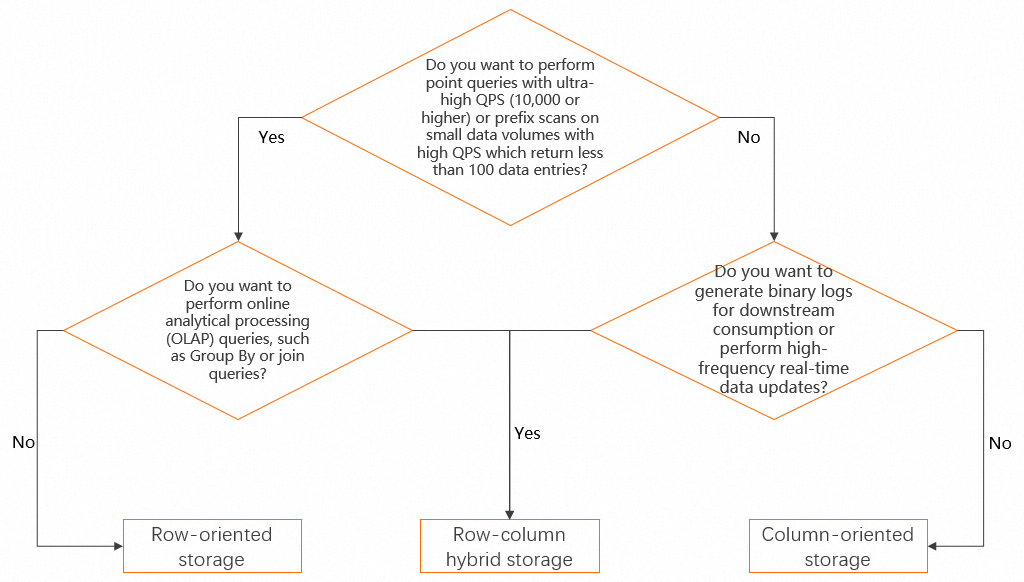
Référence rapide des propriétés
Chaque propriété de table cible une couche spécifique de l'exécution des requêtes. Comprendre le rôle de chacune vous aide à choisir la combinaison adaptée à votre scénario.
| Propriété | Fonction | Idéal pour |
|---|---|---|
| Clé primaire | Active le Fixed Plan pour la recherche directe de lignes | Requêtes ponctuelles avec un QPS ultra-élevé |
| Clé de distribution | Colocalise les lignes sur le même shard selon la valeur de la clé ; réduit le brassage inter-shards | Requêtes d'agrégation ; requêtes JOIN |
| Clé de clustering | Trie physiquement les lignes par clé dans chaque fichier ; réduit les E/S pour les analyses de plage ou d'égalité | Analyses de préfixe ; requêtes avec filtre sur une seule valeur |
event_time_column (clé de segment) |
Trie les données dans chaque fichier selon cette colonne ; réduit le nombre de fichiers analysés pour les prédicats de plage | Requêtes avec filtre temporel |
| Partitionnement | Élimine des partitions entières avant l'analyse | Grandes tables avec des modèles d'accès basés sur le temps |
| Index bitmap | Mappe chaque valeur distincte aux lignes correspondantes ; affine les analyses pour les filtres sur une seule valeur | Requêtes avec filtre sur une seule valeur |
Configurer les propriétés de table par scénario de requête
Une fois le format de stockage choisi, alignez les autres propriétés de la table sur vos modèles de requêtes. Chaque scénario ci-dessous décrit la configuration recommandée, explique le mécanisme sous-jacent et présente les résultats de performance mesurés.
Les exemples de cette section utilisent une instance Hologres de 64 unités de calcul (CU) et l'ensemble de données TPC-H de 100 Go. L'ensemble de données contient deux tables : la table Orders (oùo_orderkeyidentifie de manière unique une commande) et la table Lineitem (oùl_orderkeyetl_linenumberidentifient conjointement une ligne de commande). Ces tests sont basés sur la méthodologie de benchmarking TPC-H, mais ne satisfont pas à toutes les exigences TPC-H ; les résultats ne peuvent pas être comparés aux résultats de benchmark TPC-H publiés. Si votre table sert plusieurs modèles de requête avec différents champs de filtre ou de JOIN, configurez les propriétés en fonction de votre requête la plus fréquente ou la plus sensible en termes de performances.
Scénario 1 : Requêtes ponctuelles avec un QPS ultra-élevé
Modèle de requête
Vous souhaitez traiter des dizaines de milliers de requêtes ponctuelles par seconde sur la table Orders. Vous pouvez spécifier le champ o_orderkey pour localiser une ligne de données.
SELECT * FROM orders WHERE o_orderkey = ?;Configuration
Définissez le champ de filtre comme clé primaire. Hologres génère un Fixed Plan pour les recherches par clé primaire, contournant le chemin de planification de requête général et réduisant considérablement la surcharge d'exécution. Pour plus de détails, consultez la rubrique Accélérer l'exécution SQL avec Fixed Plan.
Fonctionnement
Le Fixed Plan ignore les étapes d'optimisation de requête inutiles pour les recherches sur une seule ligne, acheminant les demandes directement vers la ligne cible. Sans clé primaire, le moteur revient à une analyse complète du shard.
Résultats de performance (500 requêtes concurrentes, table orientée ligne ou hybride ligne-colonne)
| Configuration | QPS moyen | Latence moyenne |
|---|---|---|
| Clé primaire configurée | ~104 000 | ~4 ms |
| Aucune clé primaire | ~16 000 | ~30 ms |
Pour l'instruction DDL, consultez la section DDL du scénario 1.
Scénario 2 : Analyses de préfixe sur un petit ensemble de données avec un QPS élevé
Modèle de requête
Vous souhaitez traiter des requêtes présentant les caractéristiques suivantes : des dizaines de milliers de QPS, des requêtes basées sur un champ de la clé primaire et un jeu de résultats contenant plusieurs dizaines d'entrées.
SELECT * FROM lineitem WHERE l_orderkey = ?;Cette requête récupère toutes les lignes de commande pour une commande donnée : il s'agit d'une analyse de préfixe sur une clé primaire composite.
Configuration
Appliquez les trois éléments suivants :
Ordre de la clé primaire — Placez le champ de filtre en premier dans la clé primaire composite. Utilisez
(l_orderkey, l_linenumber), et non(l_linenumber, l_orderkey). Cela permet à Hologres d'évaluer le prédicat d'égalité sur la clé principale sans analyser les lignes non pertinentes.Clé de distribution — Définissez le champ de filtre comme clé de distribution (
l_orderkey). Les données de chaque commande sont stockées dans un seul shard, de sorte que la requête n'accède qu'à un seul shard au lieu de tous les shards.Clé de clustering (uniquement pour le stockage orienté colonne ou hybride ligne-colonne) — Définissez le champ de filtre comme clé de clustering (
l_orderkey). Dans chaque fichier, les lignes sont triées selon cette clé, ce qui réduit les E/S lors de l'analyse d'une plage contiguë.
Avec ces propriétés en place, activez le Fixed Plan pour les analyses de préfixe en définissant le paramètre Grand Unified Configuration (GUC) hg_experimental_enable_fixed_dispatcher_for_scan sur on. Pour plus de détails, consultez la rubrique Accélérer l'exécution SQL avec Fixed Plan.
Fonctionnement
La combinaison d'un ordre correct de la clé primaire, d'une clé de distribution colocalisée et d'une clé de clustering signifie que toutes les lignes correspondantes se trouvent dans un seul shard, sont physiquement adjacentes dans le stockage et sont adressées directement par le Fixed Plan.
Résultats de performance (table orientée ligne ou hybride ligne-colonne)
| Configuration | Requêtes concurrentes | QPS moyen | Latence moyenne |
|---|---|---|---|
| Les trois propriétés configurées | 500 | ~37 000 | ~13 ms |
| Propriétés non configurées | 1 | ~60 | ~16 ms |
Pour l'instruction DDL, consultez la section DDL du scénario 2.
Scénario 3 : Requêtes avec des conditions de filtre temporelles
Modèle de requête
-- Original query
SELECT
    l_returnflag,
    l_linestatus,
    sum(l_quantity) AS sum_qty,
    sum(l_extendedprice) AS sum_base_price,
    sum(l_extendedprice * (1 - l_discount)) AS sum_disc_price,
    sum(l_extendedprice * (1 - l_discount) * (1 + l_tax)) AS sum_charge,
    avg(l_quantity) AS avg_qty,
    avg(l_extendedprice) AS avg_price,
    avg(l_discount) AS avg_disc,
    count(*) AS count_order
FROM
    lineitem
WHERE
    l_shipdate <= date '1998-12-01' - interval '120' day
GROUP BY
    l_returnflag,
    l_linestatus
ORDER BY
    l_returnflag,
    l_linestatus;

-- Modified query used in the performance test (narrowed time range to highlight the effect)
SELECT ... FROM lineitem
WHERE
    l_year='1992'               -- filters to a single partition
    AND l_shipdate <= date '1992-12-01'
...;
Configuration
Partitionnement par temps — Ajoutez une colonne
l_yearet utilisez-la comme clé de partition pour diviser la table par année. Déterminez s'il faut partitionner votre table ou seulement configurer la propriétéevent_time_columnen fonction de votre volume de données et de vos besoins métier. Vérifiez les limites et les notes d'utilisation dans la rubrique CREATE PARTITION TABLE avant le partitionnement.event_time_column— Définissezl_shipdatecommeevent_time_column(clé de segment). Cela garantit que les entrées de données dans les fichiers du shard sont triées dans l'ordre basé sur la propriétéevent_time_column, ce qui réduit le nombre de fichiers à analyser. Pour plus de détails, consultez la rubrique Colonne d'heure de l'événement (clé de segment).
Fonctionnement
Le partitionnement élimine des partitions entières avant que la requête ne lise aucun fichier. La propriété event_time_column élimine ensuite des fichiers individuels au sein de la partition restante en triant les données dans chaque fichier selon la colonne configurée.
Résultats de performance (table orientée colonne)
| Configuration | Fichiers analysés |
|---|---|
Partition + event_time_column configurés comme suggéré |
80 fichiers dans 1 partition |
Pas de partition ; event_time_column défini sur un autre champ |
320 fichiers |
ExécutezEXPLAIN ANALYZEpour inspecter les comptes d'analyse réels. Le paramètrePartitions selectedindique le nombre de partitions accessibles ; le paramètredopindique le nombre de fichiers analysés.
Pour l'instruction DDL, consultez la section DDL du scénario 3.
Scénario 4 : Requêtes avec des conditions de filtre sur une seule valeur non temporelle
Modèle de requête
SELECT
    ...
FROM
    lineitem
WHERE
    l_shipmode IN ('FOB', 'AIR');
Configuration
Clé de clustering — Définissez
l_shipmodecomme clé de clustering. Les lignes ayant la même valeurl_shipmodesont stockées consécutivement dans chaque fichier, de sorte que le moteur lit un bloc plus petit et contigu au lieu de lignes dispersées dans tout le fichier.Index bitmap — Configurez
l_shipmodecomme colonne bitmap. L'index bitmap mappe chaque valeur distincte aux lignes qui la contiennent, permettant au moteur d'accéder directement aux lignes correspondantes sans lire les données non pertinentes.
Fonctionnement
La clé de clustering réduit les E/S en regroupant physiquement les lignes correspondantes. L'index bitmap affine ensuite l'analyse en filtrant au niveau du bloc avant que les données de ligne ne soient lues.
Résultats de performance (table orientée colonne)
| Configuration | Lignes lues | Durée de la requête |
|---|---|---|
| Clé de clustering + index bitmap configurés | 170 millions | 0,71 s |
| Aucun des deux configuré | 600 millions (table complète) | 2,41 s |
Vérifiez le nombre de lignes lues via le paramètreread_rowsdans les journaux de requêtes lentes. Consultez la rubrique Obtenir et analyser les journaux de requêtes lentes . Pour confirmer que l'index bitmap est appliqué, recherchez le mot-cléBitmap Filterdans le plan d'exécution.
Pour l'instruction DDL, consultez la section DDL du scénario 4.
Scénario 5 : Requêtes d'agrégation sur un seul champ
Modèle de requête
SELECT
    l_suppkey,
    sum(l_extendedprice * (1 - l_discount))
FROM
    lineitem
GROUP BY
    l_suppkey;
Configuration
Définissez le champ GROUP BY (l_suppkey) comme clé de distribution. Lorsque les données sont déjà distribuées selon la clé d'agrégation, chaque shard calcule son agrégat local indépendamment : aucune donnée n'a besoin d'être déplacée entre les shards.
Fonctionnement
Sans clé de distribution correspondante, le moteur brasse toutes les lignes vers un ensemble de shards réducteurs avant l'agrégation. Avec une clé de distribution correspondante, cela empêche le brassage d'une grande quantité de données entre les shards.
Résultats de performance (table orientée colonne)
| Configuration | Données brassées | Durée d'exécution |
|---|---|---|
l_suppkey comme clé de distribution |
~0,21 Go | 2,30 s |
| Autre champ comme clé de distribution | ~8,16 Go | 3,68 s |
Vérifiez le volume de données brassées via le paramètre shuffle_bytes dans les journaux de requêtes lentes. Consultez la rubrique Obtenir et analyser les journaux de requêtes lentes .
Pour l'instruction DDL, consultez la section DDL du scénario 5.
Scénario 6 : Requêtes JOIN sur plusieurs tables
Modèle de requête
SELECT
    o_orderpriority,
    count(*) AS order_count
FROM
    orders
WHERE
    o_orderdate >= date '1996-07-01'
    AND o_orderdate < date '1996-07-01' + interval '3' month
    AND EXISTS (
        SELECT
            *
        FROM
            lineitem
        WHERE
            l_orderkey = o_orderkey    -- join condition
            AND l_commitdate < l_receiptdate)
GROUP BY
    o_orderpriority
ORDER BY
    o_orderpriority;
Configuration
Définissez les champs JOIN comme clés de distribution sur les deux tables :
Lineitem :
l_orderkeycomme clé de distributionOrders :
o_orderkeycomme clé de distribution
Lorsque les deux tables sont distribuées sur la même clé, les lignes correspondantes de chaque table sont déjà colocalisées sur le même shard. Le JOIN s'exécute localement sans brasser aucune des tables sur le réseau.
Fonctionnement
Lorsque les tables sont distribuées sur des clés différentes, une grande quantité de données doit être brassée entre les shards pour exécuter le JOIN. L'alignement des clés de distribution avec les champs JOIN empêche ce brassage de données à grande échelle et transforme une opération limitée par le réseau en une opération locale.
Résultats de performance (les deux tables sont orientées colonne)
| Configuration | Données brassées | Durée d'exécution |
|---|---|---|
| Champs JOIN comme clés de distribution sur les deux tables | ~0,45 Go | 2,19 s |
| Clés de distribution non alignées avec les champs JOIN | ~6,31 Go | 5,55 s |
Vérifiez le volume de données brassées via le paramètre shuffle_bytes dans les journaux de requêtes lentes. Consultez la rubrique Obtenir et analyser les journaux de requêtes lentes .
Pour les instructions DDL, consultez la section DDL du scénario 6.
(Facultatif) Assigner des tables à des groupes de tables
Si votre instance Hologres dispose de plus de 256 cœurs et sert une variété de charges de travail, configurez plusieurs groupes de tables et assignez chaque table au groupe approprié lors de la création. Cela isole l'utilisation des ressources entre les charges de travail. Pour plus de détails, consultez la rubrique Bonnes pratiques pour la configuration des groupes de tables.
Annexe : Instructions DDL
DDL du scénario 1
-- Create the Orders table with a primary key.
-- To create the table without a primary key, remove PRIMARY KEY from the O_ORDERKEY column.
DROP TABLE IF EXISTS orders;
BEGIN;
CREATE TABLE orders(
    O_ORDERKEY       BIGINT         NOT NULL PRIMARY KEY
    ,O_CUSTKEY       INT            NOT NULL
    ,O_ORDERSTATUS   TEXT           NOT NULL
    ,O_TOTALPRICE    DECIMAL(15,2)  NOT NULL
    ,O_ORDERDATE     TIMESTAMPTZ    NOT NULL
    ,O_ORDERPRIORITY TEXT           NOT NULL
    ,O_CLERK         TEXT           NOT NULL
    ,O_SHIPPRIORITY  INT            NOT NULL
    ,O_COMMENT       TEXT           NOT NULL
);
CALL SET_TABLE_PROPERTY('orders', 'orientation', 'row');
CALL SET_TABLE_PROPERTY('orders', 'clustering_key', 'o_orderkey');
CALL SET_TABLE_PROPERTY('orders', 'distribution_key', 'o_orderkey');
COMMIT;
DDL du scénario 2
-- Create the Lineitem table with properties configured for prefix scan optimization.
DROP TABLE IF EXISTS lineitem;
BEGIN;
CREATE TABLE lineitem
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER)
);
CALL set_table_property('lineitem', 'orientation', 'row');
-- CALL set_table_property('lineitem', 'clustering_key', 'L_ORDERKEY,L_SHIPDATE');
CALL set_table_property('lineitem', 'distribution_key', 'L_ORDERKEY');
COMMIT;
DDL du scénario 3
-- Create a partitioned Lineitem table partitioned by year.
-- The non-partitioned version uses the same DDL as Scenario 2.
DROP TABLE IF EXISTS lineitem;
BEGIN;
CREATE TABLE lineitem
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    L_YEAR          TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER,L_YEAR)
)
PARTITION BY LIST (L_YEAR);
CALL set_table_property('lineitem', 'clustering_key', 'L_ORDERKEY,L_SHIPDATE');
CALL set_table_property('lineitem', 'segment_key', 'L_SHIPDATE');
CALL set_table_property('lineitem', 'distribution_key', 'L_ORDERKEY');
COMMIT;
DDL du scénario 4
-- Create the Lineitem table without clustering key or bitmap index (baseline).
-- For the optimized version, add the clustering key and bitmap_columns properties as shown in the comments.
DROP TABLE IF EXISTS lineitem;
BEGIN;
CREATE TABLE lineitem
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER)
);
CALL set_table_property('lineitem', 'segment_key', 'L_SHIPDATE');
CALL set_table_property('lineitem', 'distribution_key', 'L_ORDERKEY');
CALL set_table_property('lineitem', 'bitmap_columns', 'l_orderkey,l_partkey,l_suppkey,l_linenumber,l_returnflag,l_linestatus,l_shipinstruct,l_comment');
COMMIT;
DDL du scénario 5
-- Create the Lineitem table with the GROUP BY field configured as the distribution key.
DROP TABLE IF EXISTS lineitem;
BEGIN;
CREATE TABLE lineitem
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER,L_SUPPKEY)
);
CALL set_table_property('lineitem', 'segment_key', 'L_COMMITDATE');
CALL set_table_property('lineitem', 'clustering_key', 'L_ORDERKEY,L_SHIPDATE');
CALL set_table_property('lineitem', 'distribution_key', 'L_SUPPKEY');
COMMIT;
DDL du scénario 6
DROP TABLE IF EXISTS LINEITEM;

BEGIN;
CREATE TABLE LINEITEM
(
    L_ORDERKEY      BIGINT      NOT NULL,
    L_PARTKEY       INT         NOT NULL,
    L_SUPPKEY       INT         NOT NULL,
    L_LINENUMBER    INT         NOT NULL,
    L_QUANTITY      DECIMAL(15,2) NOT NULL,
    L_EXTENDEDPRICE DECIMAL(15,2) NOT NULL,
    L_DISCOUNT      DECIMAL(15,2) NOT NULL,
    L_TAX           DECIMAL(15,2) NOT NULL,
    L_RETURNFLAG    TEXT        NOT NULL,
    L_LINESTATUS    TEXT        NOT NULL,
    L_SHIPDATE      TIMESTAMPTZ NOT NULL,
    L_COMMITDATE    TIMESTAMPTZ NOT NULL,
    L_RECEIPTDATE   TIMESTAMPTZ NOT NULL,
    L_SHIPINSTRUCT  TEXT        NOT NULL,
    L_SHIPMODE      TEXT        NOT NULL,
    L_COMMENT       TEXT        NOT NULL,
    PRIMARY KEY (L_ORDERKEY,L_LINENUMBER)
);
CALL set_table_property('LINEITEM', 'clustering_key', 'L_SHIPDATE,L_ORDERKEY');
CALL set_table_property('LINEITEM', 'segment_key', 'L_SHIPDATE');
CALL set_table_property('LINEITEM', 'distribution_key', 'L_ORDERKEY');
CALL set_table_property('LINEITEM', 'bitmap_columns', 'L_ORDERKEY,L_PARTKEY,L_SUPPKEY,L_LINENUMBER,L_RETURNFLAG,L_LINESTATUS,L_SHIPINSTRUCT,L_SHIPMODE,L_COMMENT');
CALL set_table_property('LINEITEM', 'dictionary_encoding_columns', 'L_RETURNFLAG,L_LINESTATUS,L_SHIPINSTRUCT,L_SHIPMODE,L_COMMENT');
COMMIT;

DROP TABLE IF EXISTS ORDERS;

BEGIN;
CREATE TABLE ORDERS
(
    O_ORDERKEY      BIGINT      NOT NULL PRIMARY KEY,
    O_CUSTKEY       INT         NOT NULL,
    O_ORDERSTATUS   TEXT        NOT NULL,
    O_TOTALPRICE    DECIMAL(15,2) NOT NULL,
    O_ORDERDATE     timestamptz NOT NULL,
    O_ORDERPRIORITY TEXT        NOT NULL,
    O_CLERK         TEXT        NOT NULL,
    O_SHIPPRIORITY  INT         NOT NULL,
    O_COMMENT       TEXT        NOT NULL
);
CALL set_table_property('ORDERS', 'segment_key', 'O_ORDERDATE');
CALL set_table_property('ORDERS', 'distribution_key', 'O_ORDERKEY');
CALL set_table_property('ORDERS', 'bitmap_columns', 'O_ORDERKEY,O_CUSTKEY,O_ORDERSTATUS,O_ORDERPRIORITY,O_CLERK,O_SHIPPRIORITY,O_COMMENT');
CALL set_table_property('ORDERS', 'dictionary_encoding_columns', 'O_ORDERSTATUS,O_ORDERPRIORITY,O_CLERK,O_COMMENT');
COMMIT;
Références
Pour les instructions Data Definition Language (DDL) relatives aux tables internes Hologres, consultez :