Pour améliorer les performances des requêtes sur les données JSONB, Hologres V1.3 et versions ultérieures prennent en charge une optimisation du stockage orienté colonne pour le type JSONB. Cette fonctionnalité permet de réduire la taille de stockage et d'accélérer les requêtes. Cette rubrique explique comment utiliser le format JSONB en colonnes dans Hologres.
Principes du JSONB en colonnes
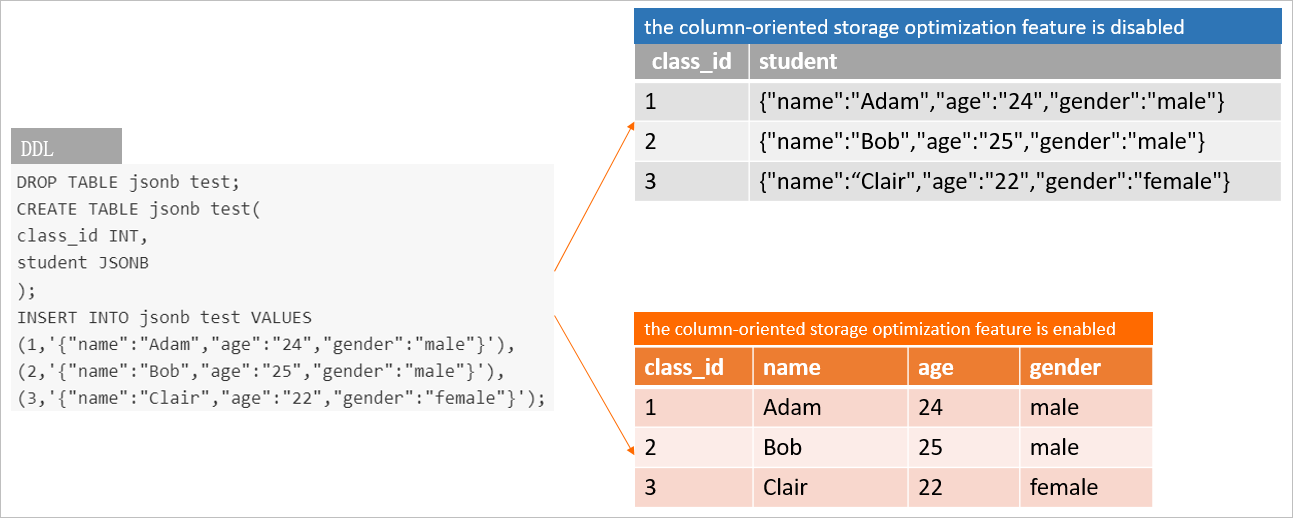
Comme l'illustre la figure suivante, lorsque vous activez l'optimisation du stockage orienté colonne pour le type JSONB, le système convertit automatiquement la colonne JSONB au format de stockage orienté colonne fortement typé au niveau sous-jacent. Lorsque vous interrogez une valeur spécifique dans les données JSONB, le système peut accéder directement à la colonne correspondante, ce qui améliore les performances des requêtes. Par ailleurs, comme les valeurs des données JSONB sont stockées dans un format orienté colonne, elles bénéficient de la même efficacité de stockage et de compression que les données structurées classiques. Cela réduit les coûts de stockage et améliore le rapport qualité-prix.
L'optimisation du stockage orienté colonne pour le type JSONB ne s'applique pas au type de données JSON.
Limitations
Pour des performances optimales, nous vous recommandons de mettre à niveau votre instance Hologres vers la version V1.3.37 ou ultérieure avant d'utiliser la fonctionnalité JSONB en colonnes. Pour demander une mise à niveau, consultez la rubrique Erreurs courantes lors de l'échec de la préparation de la mise à niveau ou rejoignez le groupe DingTalk Hologres. Pour plus d'informations, consultez la rubrique Comment obtenir davantage d'assistance en ligne ?.
L'optimisation orientée colonne pour le type JSONB s'applique uniquement aux tables orientées colonnes. De plus, l'optimisation n'est déclenchée qu'une fois que la table contient au moins 1 000 lignes.
-
Actuellement, seuls les opérateurs suivants prennent en charge l'optimisation du stockage orienté colonne. L'utilisation d'opérateurs non pris en charge dans les requêtes risque de dégrader les performances des requêtes.
Opérateur
Type de l'opérande droit
Description
Opération et résultat
->
text
Récupère un champ d'objet JSON par clé.
-
Exemple :
select '{"a": {"b":"foo"}}'::json->'a' -
Résultat :
{"b":"foo"}
->>
text
Récupère un champ d'objet JSON au format TEXT.
-
Exemple :
select '{"a":1,"b":2}'::json->>'b' -
Résultat :
2
-
Utilisation du JSONB en colonnes
Activation du JSONB en colonnes
Utilisez l'instruction suivante pour activer l'optimisation du stockage orienté colonne pour une colonne JSONB spécifique dans une table.
-- Enable column-oriented storage optimization for a specific column in a specific table.
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_columnar_type = ON);
table_name correspond au nom de la table. column_name correspond au nom de la colonne.
Après avoir activé l'optimisation du stockage orienté colonne pour le type JSONB, le système convertit les données historiques vers le stockage orienté colonne lors de la compaction. La conversion est terminée une fois la compaction achevée.
La compaction consomme des ressources système, telles que la mémoire. Nous vous recommandons d'effectuer cette opération pendant les heures creuses. Vous pouvez exécuter la commande
vacuum table_name;pour forcer une compaction. Le processus de compaction est terminé une fois l'exécution de la commande vacuum achevée.Une fois la compaction terminée, les nouvelles données écrites sont stockées dans un format orienté colonne.
Activation de l'inférence de type DECIMAL
Avant d'activer l'inférence de type DECIMAL, assurez-vous que l'optimisation du stockage orienté colonne pour le type JSONB est déjà activée.
Hologres V2.0.11 et versions ultérieures prennent en charge l'optimisation du stockage orienté colonne pour les données DECIMAL. Prenons l'exemple des données JSON suivantes :
{
  "name":"Mike",
  "statistical_period":"2023-01-01 00:00:00+08",
  "balance":123.45
}
Une fois l'inférence de type DECIMAL activée, la valeur de balance prend également en charge l'optimisation orientée colonne. Utilisez l'instruction suivante pour activer cette fonctionnalité :
-- Enable column-oriented optimization for DECIMAL values in a specific column in a specific table.
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_decimal = ON);
table_name correspond au nom de la table. column_name correspond au nom de la colonne.
Vérification de l'état du JSONB en colonnes
Utilisez les instructions suivantes pour vérifier l'état du JSONB en colonnes d'une table.
-
La commande suivante est prise en charge dans Hologres V1.3.37 et versions ultérieures.
RemarqueDans Hologres V2.0.17 et versions antérieures, cette commande affiche uniquement les tables du schéma
public. À partir de la version V2.0.18, elle peut afficher l'état des tables d'autres schémas.-- In V2.0.17 and earlier, you can query only tables in the public schema. In V2.0.18 and later, you can query tables in other schemas. SELECT * FROM hologres.hg_column_options WHERE schema_name='<schema_name>' AND table_name = '<table_name>';schema_name correspond au nom du schéma et table_name correspond au nom de la table.
-
Pour Hologres V1.3.10 à V1.3.36, utilisez la commande suivante.
SELECT DISTINCT
    a.attnum as num,
    a.attname as name,
    format_type(a.atttypid, a.atttypmod) as type,
    a.attnotnull as notnull,
    com.description as comment,
    coalesce(i.indisprimary,false) as primary_key,
    def.adsrc as default,
    a.attoptions
FROM pg_attribute a
JOIN pg_class pgc ON pgc.oid = a.attrelid
LEFT JOIN pg_index i ON
    (pgc.oid = i.indrelid AND i.indkey[0] = a.attnum)
LEFT JOIN pg_description com on
    (pgc.oid = com.objoid AND a.attnum = com.objsubid)
LEFT JOIN pg_attrdef def ON
    (a.attrelid = def.adrelid AND a.attnum = def.adnum)
WHERE a.attnum > 0 AND pgc.oid = a.attrelid
AND pg_table_is_visible(pgc.oid)
AND NOT a.attisdropped
AND pgc.relname = '<table_name>'
ORDER BY a.attnum;
table_name correspond au nom de la table.
-
Exemple de résultat :
Dans le résultat, si la propriété attoptions ou option d'une colonne est définie sur
enable_columnar_type = ON, cela indique que la configuration a réussi.num | name | type | notnull | comment | primary_key | default | attoptions ------+------+--------------------------+---------+---------+-------------+---------+------------------------------ 1 | ds | timestamp with time zone | f | | f | | 2 | tags | jsonb | f | | f | | {enable_columnar_type=on} (2 rows)
Désactivation du JSONB en colonnes
Utilisez la commande suivante pour désactiver l'optimisation du stockage orienté colonne pour une colonne JSONB spécifique dans une table.
-- Disable column-oriented storage optimization for a specific column in a specific table.
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_columnar_type = OFF);
table_name correspond au nom de la table. column_name correspond au nom de la colonne.
Après avoir désactivé l'optimisation du stockage orienté colonne pour le type JSONB, le système reconvertit les données historiques vers le format de stockage JSONB standard lors de la compaction. La conversion est terminée une fois la compaction achevée.
La compaction consomme des ressources système, telles que la mémoire. Nous vous recommandons d'effectuer cette opération pendant les heures creuses. Vous pouvez exécuter la commande
vacuum table_name;pour forcer une compaction. Le processus de compaction est terminé une fois l'exécution de la commande vacuum achevée.Une fois la compaction terminée, les nouvelles données écrites sont stockées au format JSONB standard.
Désactivation de l'inférence de type DECIMAL
Pour désactiver l'inférence de type DECIMAL pour une colonne spécifique, utilisez la commande suivante.
-- Disable column-oriented optimization for DECIMAL values in a specific column in a specific table.
ALTER TABLE <table_name> ALTER COLUMN <column_name> SET (enable_decimal = OFF);
table_name correspond au nom de la table. column_name correspond au nom de la colonne.
La désactivation de l'inférence de type DECIMAL déclenche immédiatement une compaction afin de reconvertir les données DECIMAL précédemment optimisées vers leur format d'origine.
Configuration d'un index bitmap
Dans Hologres, la propriété bitmap_columns spécifie un index bitmap, qui constitue une structure d'index indépendante séparée du stockage des données. Elle utilise une structure de vecteur bitmap pour accélérer les comparaisons d'égalité, permettant ainsi un filtrage rapide par égalité des données au sein des blocs de fichiers. À partir de la version V2.0, Hologres prend en charge la configuration d'un index bitmap pour les colonnes JSONB dont le stockage orienté colonne est activé. Une fois le format JSONB en colonnes activé, le système analyse les données en sept types de données : int, int[], bigint, bigint[], text, text[] et jsonb. Lorsqu'un index bitmap est activé, le système construit un index bitmap pour les données inférées comme étant de type int, int[], bigint, bigint[], text et text[].
La syntaxe est la suivante :
call set_table_property('<table_name>', 'bitmap_columns', '[<columnName>{:[on|off]}[,...]]');Paramètres :
|
Paramètre |
Description |
|
table_name |
Nom de la table. |
|
columnName |
Nom de la colonne. |
|
on |
Active l'index bitmap pour le champ spécifié. Important
Vous pouvez configurer un index bitmap uniquement pour les colonnes JSONB dont le stockage orienté colonne est activé. |
|
off |
Désactive l'index bitmap pour le champ spécifié. |
Exemple
-
Créez une table.
DROP TABLE IF EXISTS user_tags; -- Create a data table BEGIN; CREATE TABLE IF NOT EXISTS user_tags ( ds timestamptz, tags jsonb ); COMMIT; -
Activez l'optimisation du stockage orienté colonne pour la colonne
tags.ALTER TABLE user_tags ALTER COLUMN tags SET (enable_columnar_type = ON); -
Vérifiez l'état du stockage JSONB en colonnes.
select * from hologres.hg_column_options where table_name = 'user_tags';Dans le résultat suivant, la propriété options de la ligne tags est définie sur {enable_columnar_type=on}, ce qui indique que la configuration a réussi.
schema_name | table_name | column_id | column_name | column_type | notnull | comment | default | options -------------+------------+-----------+-------------+--------------------------+---------+---------+---------+--------------------------- public | user_tags | 1 | ds | timestamp with time zone | f | | | public | user_tags | 2 | tags | jsonb | f | | | {enable_columnar_type=on} (2 rows) -
Importez des données.
INSERT INTO user_tags (ds, tags) SELECT '2022-01-01 00:00:00+08' , ('{"id":' || i || ',"first_name" :"Sig", "gender" :"Male"}')::jsonb FROM generate_series(1, 10001) i; -
(Facultatif) Forcez une vidange des données.
Une fois les données écrites, le système effectue l'optimisation JSONB en colonnes lors d'une vidange des données. Pour voir l'effet immédiatement, exécutez la commande suivante pour forcer une vidange des données.
VACUUM user_tags; -
Exécutez un exemple de requête.
Exécutez l'instruction SQL suivante pour interroger la valeur
first_nameoùidest égal à10.SELECT (tags -> 'first_name')::text AS first_name FROM user_tags WHERE (tags -> 'id')::int = 10; -
Vérifiez le plan d'exécution pour confirmer que la requête utilise l'optimisation en colonnes.
-- Show detailed statistics.
SET hg_experimental_show_execution_statistics_in_explain = ON;
-- View the execution plan.
EXPLAIN ANALYZE
SELECT
    (tags -> 'first_name')::text AS first_name
FROM
    user_tags
WHERE (tags -> 'id')::int = 10;
Si
columnar_access_usedapparaît dans le résultat, l'optimisation JSONB en colonnes a été utilisée. -
Pour la requête de l'étape 6, vous pouvez également configurer un index bitmap sur la colonne
tagsafin d'améliorer l'efficacité des requêtes d'égalité pour une clé spécifique en utilisant la commande suivante :call set_table_property('user_tags', 'bitmap_columns', 'tags'); -
Vérifiez le plan d'exécution pour confirmer que l'index bitmap est efficace.
-- View the execution plan.
EXPLAIN ANALYZE
SELECT
    (tags -> 'first_name')::text AS first_name
FROM
    user_tags
WHERE (tags -> 'id')::int = 10;
Le résultat est le suivant :
QUERY PLAN
Gather  (cost=0.00..6.42 rows=3334 width=8)
[2:1 id=100002 dop=1 time=7/7/7ms rows=1(1/1/1) mem=584/584/584B open=0/0/0ms get_next=7/7/7ms]
 -> Local Gather  (cost=0.00..6.30 rows=3334 width=8)
     [id=6 dop=2 time=6/4/3ms rows=1(1/0/0) mem=584/584/584B open=0/0/0ms get_next=6/4/3ms pull_dop=0/0/0]
     -> Decode  (cost=0.00..6.30 rows=3334 width=8)
         [id=4 dop=2 time=7/5/3ms rows=1(1/0/0) mem=0/0/0B open=7/5/3ms get_next=0/0/0ms]
         -> Project  (cost=0.00..6.20 rows=3334 width=8)
             [id=3 dop=2 time=7/5/3ms rows=1(1/0/0) mem=2/2/2KB open=7/5/3ms get_next=0/0/0ms]
             -> Seq Scan on user_tags  (cost=0.00..5.18 rows=3334 width=8)
                 Filter: (int4((tags -> 'id'::text)) = 10)
                 [id=2 dop=2 time=7/5/3ms rows=1(1/0/0) mem=260/160/60KB open=7/5/3ms get_next=0/0/0ms scan_rows=10001(8192/5000/1809) bitmap_used=1]
ADVICE:
[node id : 2]  Table user_tags misses bitmap index: ColRef_0012.
Si
bitmap_usedapparaît dans le résultat, l'index bitmap a été utilisé.
Cas où il convient d'éviter le JSONB en colonnes
L'utilisation du format JSONB en colonnes permet de réduire le stockage et d'améliorer considérablement l'efficacité des requêtes. Toutefois, cette approche ne convient pas à tous les scénarios. Nous vous déconseillons de l'utiliser dans les situations suivantes, car elle pourrait s'avérer contre-productive.
Retour de la colonne JSONB entière
Le format JSONB en colonnes de Hologres offre une bonne optimisation pour la plupart des cas d'utilisation. Cependant, pour les scénarios où le résultat de la requête doit inclure la colonne JSONB entière, les performances peuvent être inférieures à celles obtenues avec le stockage des données au format JSONB d'origine. Prenons l'exemple des instructions SQL suivantes :
-- DDL for creating the table
CREATE TABLE TBL(key int, json_data jsonb);
SELECT json_data FROM TBL WHERE key = 123;
SELECT * FROM TBL limit 10;
Cette dégradation des performances s'explique par le fait que la couche sous-jacente a déjà converti les données JSONB en stockage orienté colonne. Par conséquent, lorsque vous devez interroger les données JSON complètes, le système doit réassembler les données en colonnes pour les reconvertir au format JSONB d'origine :

Cette étape génère une surcharge importante en termes d'E/S et de conversion. Si le volume de données est important et que le nombre de colonnes est élevé, ce processus peut devenir un goulot d'étranglement au niveau des performances. Par conséquent, nous vous recommandons de ne pas activer l'optimisation orientée colonne dans ce scénario.
Données JSONB extrêmement clairsemées
Lorsque Hologres rencontre un champ clairsemé lors de la conversion des données JSONB vers un format orienté colonne, il fusionne ces champs dans une colonne spéciale nommée holo.remaining afin d'éviter une explosion du nombre de colonnes. Par conséquent, si les données JSONB sont entièrement composées de champs clairsemés — par exemple, dans un cas extrême où chaque champ n'apparaît qu'une seule fois — la conversion en colonnes ne sera pas efficace. Étant donné que tous les champs sont clairsemés, ils sont tous fusionnés dans la colonne holo.remaining , empêchant toute conversion réelle en colonnes. Dans ce cas, aucune amélioration des performances des requêtes ne sera constatée.
Données JSONB avec des structures imbriquées complexes
Dans les données JSONB suivantes, le nœud racine est un tableau contenant des données JSONB non homogènes. Actuellement, lorsque Hologres convertit les données JSONB vers un format orienté colonne, il rétrograde ces structures imbriquées complexes en une seule colonne. Par conséquent, l'activation de l'optimisation JSONB en colonnes pour ce type de données JSONB n'apportera pas d'avantages significatifs en matière de performances des requêtes.
'[
  {"key1": "value1"},
  {"key2": 123},
  {"key3": 123.01}
]'
Bonnes pratiques
Diagnostic des requêtes lentes
Si vous constatez que les performances des requêtes se dégradent après avoir activé le format JSONB en colonnes, vérifiez d'abord si la requête renvoie la colonne JSONB entière. Si l'instruction SQL est trop complexe, vous pouvez utiliser la commande EXPLAIN ANALYZE pour effectuer un diagnostic. Voici un exemple de commande :
CREATE TABLE TBL(key int, json_data json); -- DDL for creating the table
ALTER TABLE TBL ALTER COLUMN json_data SET (enable_columnar_type = on);
Explain Analyze SELECT json_data FROM TBL WHERE key = 123;
Le résultat de EXPLAIN ANALYZE contient des informations d'indication. Si l'indication contient le message suivant, cela signifie que la requête a renvoyé la colonne JSONB entière, ce qui a entraîné une dégradation des performances :
Column 'json_data' has enabled columnar jsonb, but the query scanned the entire Jsonb valueSyntaxe SQL plus efficace
-
Il existe plusieurs façons de convertir les données de champ JSONB au format TEXT, mais l'opérateur
->>offre de meilleures performances. Par exemple, pour récupérer l'attribut name de la colonne json_data :-- Better performance SELECT json_data->>'name' FROM tbl; -- Average performance SELECT (json_data->'name')::text FROM tbl; -
Si un champ JSON stocke un tableau TEXT et que vous devez vérifier si le tableau contient une valeur spécifique, nous vous recommandons d'utiliser la syntaxe suivante :
SELECT key FROM tbl WHERE jsonb_to_textarray(json_data->'phones') && ARRAY['123456'];
FAQ
Pourquoi l'utilisation du stockage a-t-elle augmenté après l'activation de l'optimisation orientée colonne ?
Après avoir activé l'optimisation JSONB en colonnes, les noms de champ des données JSONB d'origine ne sont plus stockés. Seules les valeurs spécifiques de chaque champ sont conservées. Après la conversion vers un format orienté colonne, toutes les données de chaque colonne sont du même type, ce qui permet au stockage orienté colonne d'atteindre un taux de compression des données élevé. En théorie, cela devrait réduire considérablement l'espace de stockage des données.
Toutefois, si les champs des données JSONB sont clairsemés et que le nombre de colonnes augmente de manière significative, chaque nouvelle colonne entraînera des frais de stockage supplémentaires pour les métadonnées, telles que les statistiques et les index. De plus, si la plupart des colonnes sont inférées comme étant de type TEXT, la compression sera moins efficace. Par conséquent, l'efficacité réelle de la compression du stockage dépend des caractéristiques spécifiques de vos données, telles que leur caractère clairsemé, et une compression idéale n'est pas garantie pour tous les jeux de données.