Utilisez les commandes EXPLAIN et EXPLAIN ANALYZE pour inspecter la manière dont Hologres exécute une requête SQL. Lorsqu'une requête présente des performances médiocres ou renvoie des résultats inattendus, ces commandes affichent le plan d'exécution afin que vous puissiez identifier les goulots d'étranglement et optimiser votre code SQL ou la conception de vos tables.
Les plans d'exécution sont plus clairs et plus lisibles à partir de la version V1.3.4x de Hologres. Cette documentation se base sur la version V1.3.4x. Mettez à niveau votre instance vers la version V1.3.4x ou ultérieure pour suivre les exemples.
Fonctionnement
Chaque instruction SQL passe par deux étapes :
L'optimiseur de requêtes (QO) analyse la requête et génère un plan d'exécution.
Le moteur de requêtes (QE) prend ce plan, l'exécute et renvoie les résultats.
Le plan d'exécution décrit les opérateurs utilisés par le QE, l'ordre dans lequel les données circulent entre eux et le coût estimé de chaque étape. Un plan bien choisi consomme moins de ressources et renvoie les résultats plus rapidement, ce qui explique pourquoi la compréhension des plans d'exécution est essentielle à l'optimisation SQL.
Hologres est compatible avec PostgreSQL et utilise la même syntaxe EXPLAIN / EXPLAIN ANALYZE :
| Commande | Ce qu'elle affiche |
|---|---|
EXPLAIN |
Le plan estimé par le QO. La requête n'est pas exécutée. |
EXPLAIN ANALYZE |
Le plan d'exécution réel. La requête est exécutée et les timings réels, le nombre de lignes et l'utilisation de la mémoire sont affichés. |
Utilisez EXPLAIN pour obtenir une estimation rapide. Privilégiez EXPLAIN ANALYZE pour un diagnostic précis.
EXPLAIN
Syntaxe
EXPLAIN <sql>;Exemple
L'exemple suivant utilise une requête TPC-H à titre illustratif uniquement et ne représente pas les résultats officiels du benchmark TPC-H.
EXPLAIN SELECT
        l_returnflag,
        l_linestatus,
        sum(l_quantity) AS sum_qty,
        sum(l_extendedprice) AS sum_base_price,
        sum(l_extendedprice * (1 - l_discount)) AS sum_disc_price,
        sum(l_extendedprice * (1 - l_discount) * (1 + l_tax)) AS sum_charge,
        avg(l_quantity) AS avg_qty,
        avg(l_extendedprice) AS avg_price,
        avg(l_discount) AS avg_disc,
        count(*) AS count_order
FROM
        lineitem
WHERE
        l_shipdate <= date '1998-12-01' - interval '120' day
GROUP BY
        l_returnflag,
        l_linestatus
ORDER BY
        l_returnflag,
        l_linestatus;
Sortie :
QUERY PLAN
Sort  (cost=0.00..7795.30 rows=3 width=80)
  Sort Key: l_returnflag, l_linestatus
  ->  Gather  (cost=0.00..7795.27 rows=3 width=80)
        ->  Project  (cost=0.00..7795.27 rows=3 width=80)
              ->  Project  (cost=0.00..7794.27 rows=3 width=104)
                    ->  Final HashAggregate  (cost=0.00..7793.27 rows=3 width=76)
                          Group Key: l_returnflag, l_linestatus
                          ->  Redistribution  (cost=0.00..7792.95 rows=1881 width=76)
                                Hash Key: l_returnflag, l_linestatus
                                ->  Partial HashAggregate  (cost=0.00..7792.89 rows=1881 width=76)
                                      Group Key: l_returnflag, l_linestatus
                                      ->  Local Gather  (cost=0.00..7791.81 rows=44412 width=76)
                                            ->  Decode  (cost=0.00..7791.80 rows=44412 width=76)
                                                  ->  Partial HashAggregate  (cost=0.00..7791.70 rows=44412 width=76)
                                                        Group Key: l_returnflag, l_linestatus
                                                        ->  Project  (cost=0.00..3550.73 rows=584421302 width=33)
                                                              ->  Project  (cost=0.00..2585.43 rows=584421302 width=33)
                                                                    ->  Index Scan using Clustering_index on lineitem  (cost=0.00..261.36 rows=584421302 width=25)
                                                                          Segment Filter: (l_shipdate <= '1998-08-03 00:00:00+08'::timestamp with time zone)
                                                                          Cluster Filter: (l_shipdate <= '1998-08-03 00:00:00+08'::timestamp with time zone)
Lecture de la sortie
Lisez le plan de bas en haut. Chaque élément -> représente un nœud. Les données circulent vers le haut, depuis les nœuds feuilles (les sources de données réelles) jusqu'au nœud racine (la sortie finale).
Chaque nœud affiche trois estimations de l'optimiseur :
| Champ | description |
|---|---|
cost |
Durée d'exécution estimée de l'opérateur, affichée sous la forme startup_cost..total_cost. Le coût de démarrage correspond au coût avant la production de la première ligne de sortie. Le coût total correspond au coût si l'opateur s'exécute jusqu'à son terme. Le coût d'un nœud parent inclut tous ses enfants. Par exemple, Final HashAggregate (cost=0.00..7793.27) a un coût de démarrage de 0.00 et un coût total de 7793.27. |
rows |
Nombre estimé de lignes de sortie, basé sur les statistiques de la table. Pour les opérations de scan, l'estimation par défaut est de 1000. Si vous voyez rows=1000, les statistiques sont probablement obsolètes ; exécutez ANALYZE <tablename> pour les actualiser. |
width |
Largeur moyenne estimée des lignes en octets. Des valeurs plus élevées indiquent des lignes de sortie plus larges. |
EXPLAIN ANALYZE
Syntaxe
EXPLAIN ANALYZE <sql>;Exemple
EXPLAIN ANALYZE SELECT
        l_returnflag,
        l_linestatus,
        sum(l_quantity) AS sum_qty,
        sum(l_extendedprice) AS sum_base_price,
        sum(l_extendedprice * (1 - l_discount)) AS sum_disc_price,
        sum(l_extendedprice * (1 - l_discount) * (1 + l_tax)) AS sum_charge,
        avg(l_quantity) AS avg_qty,
        avg(l_extendedprice) AS avg_price,
        avg(l_discount) AS avg_disc,
        count(*) AS count_order
FROM
        lineitem
WHERE
        l_shipdate <= date '1998-12-01' - interval '120' day
GROUP BY
        l_returnflag,
        l_linestatus
ORDER BY
        l_returnflag,
        l_linestatus;
Résultat :
QUERY PLAN
Sort  (cost=0.00..7795.30 rows=3 width=80)
  Sort Key: l_returnflag, l_linestatus
[id=21 dop=1 time=2427/2427/2427ms rows=4(4/4/4) mem=3/3/3KB open=2427/2427/2427ms get_next=0/0/0ms]
  ->  Gather  (cost=0.00..7795.27 rows=3 width=80)
      [20:1 id=100003 dop=1 time=2426/2426/2426ms rows=4(4/4/4) mem=1/1/1KB open=0/0/0ms get_next=2426/2426/2426ms]
        ->  Project  (cost=0.00..7795.27 rows=3 width=80)
            [id=19 dop=20 time=2427/2426/2425ms rows=4(1/0/0) mem=87/87/87KB open=2427/2425/2425ms get_next=1/0/0ms]
              ->  Project  (cost=0.00..7794.27 rows=0 width=104)
                    ->  Final HashAggregate  (cost=0.00..7793.27 rows=3 width=76)
                          Group Key: l_returnflag, l_linestatus
                        [id=16 dop=20 time=2427/2425/2424ms rows=4(1/0/0) mem=574/570/569KB open=2427/2425/2424ms get_next=1/0/0ms]
                          ->  Redistribution  (cost=0.00..7792.95 rows=1881 width=76)
                                Hash Key: l_returnflag, l_linestatus
                              [20:20 id=100002 dop=20 time=2427/2424/2423ms rows=80(20/4/0) mem=3528/1172/584B open=1/0/0ms get_next=2426/2424/2423ms]
                                ->  Partial HashAggregate  (cost=0.00..7792.89 rows=1881 width=76)
                                      Group Key: l_returnflag, l_linestatus
                                    [id=12 dop=20 time=2428/2357/2256ms rows=80(4/4/4) mem=574/574/574KB open=2428/2357/2256ms get_next=1/0/0ms]
                                      ->  Local Gather  (cost=0.00..7791.81 rows=44412 width=76)
                                          [id=11 dop=20 time=2427/2356/2255ms rows=936(52/46/44) mem=7/6/6KB open=0/0/0ms get_next=2427/2356/2255ms pull_dop=9/9/9]
                                            ->  Decode  (cost=0.00..7791.80 rows=44412 width=76)
                                                [id=8 dop=234 time=2435/1484/5ms rows=936(4/4/4) mem=0/0/0B open=2435/1484/5ms get_next=4/0/0ms]
                                                  ->  Partial HashAggregate  (cost=0.00..7791.70 rows=44412 width=76)
                                                        Group Key: l_returnflag, l_linestatus
                                                      [id=5 dop=234 time=2435/1484/3ms rows=936(4/4/4) mem=313/312/168KB open=2435/1484/3ms get_next=0/0/0ms]
                                                        ->  Project  (cost=0.00..3550.73 rows=584421302 width=33)
                                                            [id=4 dop=234 time=2145/1281/2ms rows=585075720(4222846/2500323/3500) mem=142/141/69KB open=10/1/0ms get_next=2145/1280/2ms]
                                                              ->  Project  (cost=0.00..2585.43 rows=584421302 width=33)
                                                                  [id=3 dop=234 time=582/322/2ms rows=585075720(4222846/2500323/3500) mem=142/142/69KB open=10/1/0ms get_next=582/320/2ms]
                                                                    ->  Index Scan using Clustering_index on lineitem  (cost=0.00..261.36 rows=584421302 width=25)
                                                                          Segment Filter: (l_shipdate <= '1998-08-03 00:00:00+08'::timestamp with time zone)
                                                                          Cluster Filter: (l_shipdate <= '1998-08-03 00:00:00+08'::timestamp with time zone)
                                                                        [id=2 dop=234 time=259/125/1ms rows=585075720(4222846/2500323/3500) mem=1418/886/81KB open=10/1/0ms get_next=253/124/0ms]

ADVICE:
[node id : 1000xxx] distribution key miss match! table lineitem defined distribution keys : l_orderkey; request distribution columns : l_returnflag, l_linestatus;
shuffle data skew in different shards! max rows is 20, min rows is 0

Query id:[300200511xxxx]
======================cost======================
Total cost:[2505] ms
Optimizer cost:[47] ms
Init gangs cost:[4] ms
Build gang desc table cost:[2] ms
Start query cost:[18] ms
- Wait schema cost:[0] ms
- Lock query cost:[0] ms
- Create dataset reader cost:[0] ms
- Create split reader cost:[0] ms
Get the first block cost:[2434] ms
Get result cost:[2434] ms
====================resource====================
Memory: 921(244/230/217) MB,  straggler worker id: 72969760xxx
CPU time: 149772(38159/37443/36736) ms, straggler worker id: 72969760xxx
Physical read bytes: 3345(839/836/834) MB, straggler worker id: 72969760xxx
Read bytes: 41787(10451/10446/10444) MB, straggler worker id: 72969760xxx
DAG instance count: 41(11/10/10), straggler worker id: 72969760xxx
Fragment instance count: 275(70/68/67), straggler worker id: 72969760xxx
Lecture de la sortie
La sortie se compose de quatre sections : QUERY PLAN, ADVICE, Cost et Resource.
QUERY PLAN
Lisez le plan de bas en haut, comme pour EXPLAIN. Chaque nœud affiche deux lignes :
Estimations de l'optimiseur
(cost=... rows=... width=...): Même signification que dansEXPLAIN.Mesures réelles du temps d'exécution
[id=... dop=... time=... rows=... mem=... open=... get_next=...]: Valeurs réelles collectées pendant l'exécution.
Les champs de mesure du temps d'exécution sont les suivants :
| Champ | Format | Description |
|---|---|---|
dag dop (par exemple, 20:20) |
input:output |
Ratio entre la concurrence en entrée et en sortie. Gather 21:1 combine 21 entrées en 1. Redistribution 20:20 redistribue les données sur 20 workers. Broadcast 1:21 diffuse 1 entrée vers 21 sorties. |
id |
Entier | Identifiant unique du nœud opérateur. |
dop |
Entier | Degré de parallélisme (dop) — le parallélisme réel lors de l'exécution. Correspond au nombre de shards de l'instance. Pour Local Gather, il s'agit du nombre de fichiers analysés. |
time |
max/avg/min ms |
Temps d'exécution réel décomposé en deux phases : open (initialisation de l'opérateur, y compris l'extraction de toutes les données en aval pour les opérateurs tels que Hash) et get_next (récupération de chaque lot d'enregistrements). |
rows |
total(max/avg/min) |
Nombre de lignes produites par l'opérateur. Un écart important entre le maximum et le minimum indique une distorsion des données (skew). |
mem |
max/avg/min |
Mémoire consommée lors de l'exécution de l'opérateur. Cette valeur n'est pas cumulative ; la valeur de chaque opérateur est indépendante. |
La valeurtimed'un opérateur inclut le temps cumulé de ses opérateurs enfants. Pour isoler le coût d'un seul opérateur, soustrayez le temps de son enfant. Les valeursrowsetmemsont spécifiques à chaque opérateur et ne sont pas cumulatives.
ADVICE
La section ADVICE liste les suggestions d'optimisation automatique dérivées de l'exécution actuelle :
Clés de distribution, clés de clustering ou index bitmap manquants ou incorrects (par exemple,
Table xxx misses bitmap index)Statistiques de table obsolètes (
Table xxx Miss Stats! please run 'analyze xxx')Distorsion des données (
shuffle data skew in different shards! max rows is 20, min rows is 0)
Ces suggestions sont basées uniquement sur la requête actuelle. Examinez-les par rapport à votre charge de travail spécifique avant d'appliquer des modifications.
Détail des coûts
La section des coûts indique où le temps de requête est dépensé :
| Phase | Description |
|---|---|
| Total cost | Temps total de bout en bout de la requête (ms). |
| Optimizer cost | Temps passé par l'optimiseur de requêtes (QO) à générer le plan d'exécution. |
| Build gang desc table cost | Temps nécessaire pour convertir le plan du QO en structures de données utilisées par le moteur d'exécution. |
| Init gangs cost | Temps de prétraitement du plan et d'envoi des demandes au moteur d'exécution. |
| Start query cost | Initialisation après Init gangs — couvre l'alignement du schéma, le verrouillage et la configuration. Décomposé plus loin : |
| — Wait schema cost | Temps nécessaire pour que le moteur de stockage (SE) et le frontend (FE) alignent les versions du schéma. Des valeurs élevées indiquent souvent des opérations fréquentes de langage de définition de données (DDL) sur les tables parentes partitionnées, ce qui peut ralentir les écritures et les lectures de données. |
| — Lock query cost | Temps passé à acquérir les verrous de requête. Des valeurs élevées indiquent une contention des verrous. |
| — Create dataset reader cost | Temps de création des lecteurs de données d'index. Des valeurs élevées peuvent indiquer des échecs de cache. |
| — Create split reader cost | Temps d'ouverture des fichiers. Des valeurs élevées suggèrent des échecs de cache de métadonnées et une surcharge d'E/S importante. |
| Get the first block cost | Temps écoulé entre la fin de la phase Start query et le retour du premier lot d'enregistrements. Pour les opérateurs comme Hash Agg qui ont besoin de toutes les données en aval avant de produire une sortie, cela correspond étroitement au coût total de Get result. |
| Get result cost | Temps écoulé entre la fin de la phase Start query et le retour de tous les résultats. |
Consommation des ressources
Les métriques de ressource utilisent le format total(max/avg/min), où chaque valeur couvre le worker ayant la consommation la plus élevée, la moyenne par worker et le worker ayant la consommation la plus faible.
| Métrique | Description |
|---|---|
| Memory | Mémoire totale consommée, plus le max/moyenne/min par worker. |
| CPU time | Temps CPU total sur tous les cœurs (ms, approximatif). Reflète la complexité globale de la requête. |
| Physical read bytes | Données lues depuis le disque. Se produit lorsque les résultats ne sont pas mis en cache. |
| Read bytes | Total des données lues, y compris les lectures physiques et les hits de cache. |
| Affected rows | Lignes affectées. Affiché uniquement pour les instructions DML. |
| DAG instance count | Nombre d'instances de graphes acycliques dirigés (DAG). Des valeurs plus élevées indiquent un parallélisme et une complexité accrus. |
| Fragment instance count | Nombre d'instances de fragments. Des valeurs plus élevées indiquent davantage de segments de plan d'exécution et de fichiers. |
| straggler_worker_id | ID du nœud worker présentant la consommation maximale de ressources pour chaque métrique. |
Référence des opérateurs
Le tableau ci-dessous répertorie tous les opérateurs ainsi que leur rôle. Pour plus de détails et des conseils d'optimisation, consultez les sections suivantes.
| Opérateur | Catégorie | Fonction |
|---|---|---|
| Seq Scan | Scan | Analyse complète du table sans utilisation d'index. |
| Seq Scan on Partitioned Table | Scan | Analyse une table partitionnée ; indique le nombre de partitions sélectionnées. |
| Index Scan (Clustering_index) | Scan | Analyse en mode column-store utilisant un index (segment, clustering ou bitmap). |
| Index Seek (pk_index) | Scan | Analyse en mode row-store utilisant un index de clé primaire. |
| Foreign Table Type | Scan | Indique la source d'une table externe : MaxCompute, OSS ou Hologres. |
| Filter | Filter | Applique une condition WHERE qui n'a atteint aucun index. |
| Segment Filter | Filter | La condition correspond à un index de segment (colonne Event Time). |
| Cluster Filter | Filter | La condition correspond à un index de clustering. |
| Bitmap Filter | Filter | La condition correspond à un index bitmap. |
| Join Filter | Filter | Filtrage supplémentaire appliqué après une jointure. |
| Hash Join (variants) | Join | Joint deux tables à l'aide d'une table de hachage construite à partir de la plus petite table. |
| Nested Loop | Join | Parcourt la table interne pour chaque ligne de la table externe. Coûteux pour les grands ensembles de données. |
| Merge Join | Join | Joint deux entrées prétriées sur les clés de jointure. |
| Cross Join | Join | Jointure non équi optimisée (V3.0+) qui charge la petite table en mémoire. |
| Materialize | Join | Met en buffer la table interne pour une boucle imbriquée (Nested Loop). |
| Broadcast | Distribution | Copie une petite table sur tous les shards pour une jointure. |
| Redistribution | Distribution | Répartit les données entre les shards à l'aide d'une distribution par hachage ou aléatoire. |
| Local Gather | Merge | Fusionne les données de plusieurs fichiers au sein d'un même shard. |
| Gather | Merge | Fusionne les données de plusieurs shards pour produire le résultat final. |
| Partial HashAggregate | Aggregate | Effectue l'agrégation au niveau des fichiers et des shards. |
| Final HashAggregate | Aggregate | Combine les agrégats partiels entre les shards. |
| GroupAggregate | Aggregate | Agrège des données prétriées sans hachage. |
| Sort | Other | Trie les lignes selon une ou plusieurs clés. |
| Limit | Other | Limite le nombre de lignes de sortie. |
| Append | Other | Fusionne les résultats de sous-requêtes UNION ALL. |
| Decode | Other | Décode ou encode les données de type texte pour accélérer le calcul. |
| ExecuteExternalSQL | Other | Indique qu'une fonction ou un opérateur est revenu à PQE au lieu de HQE. |
| Exchange | Other | Transfère les données au sein d'un shard. Aucune action nécessaire. |
| Forward | Other | Transfère les données entre HQE et PQE ou SQE. |
| Project | Other | Mappe les colonnes entre une sous-requête et sa requête externe. Aucune action nécessaire. |
Opérateurs de scan
Seq scan
Un Seq Scan lit l'intégralité de la table sans utiliser aucun index.
EXPLAIN SELECT * FROM public.holo_lineitem_100g;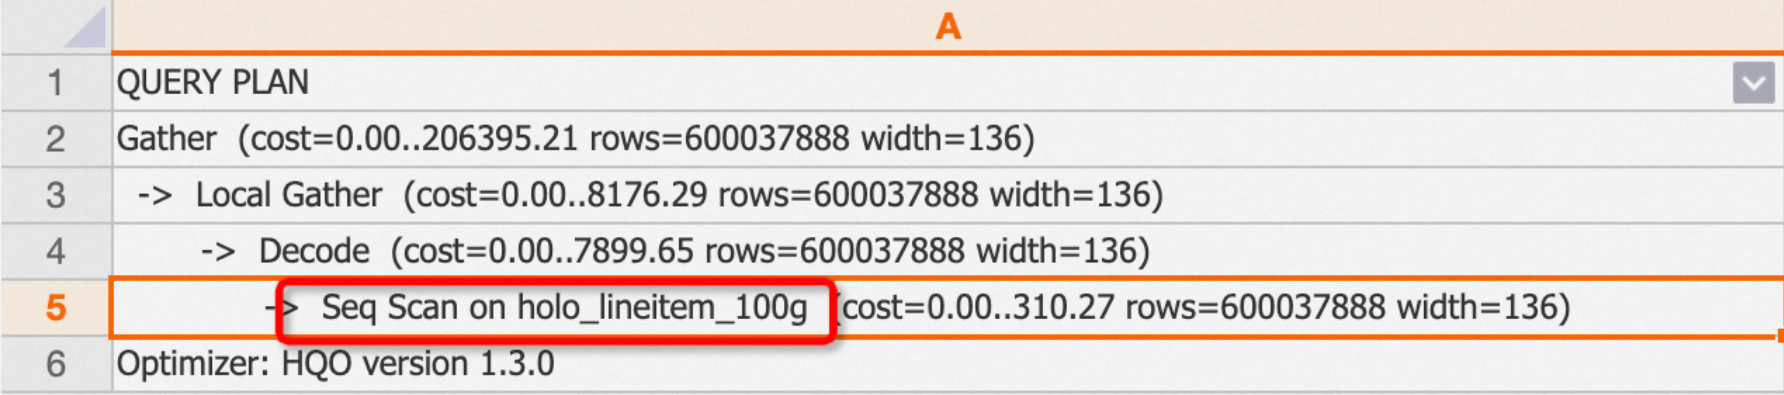
Les tables partitionnées affichent l'opérateur Seq Scan on Partitioned Table et indiquent « Partitions selected: x out of y » :
EXPLAIN SELECT * FROM public.hologres_parent;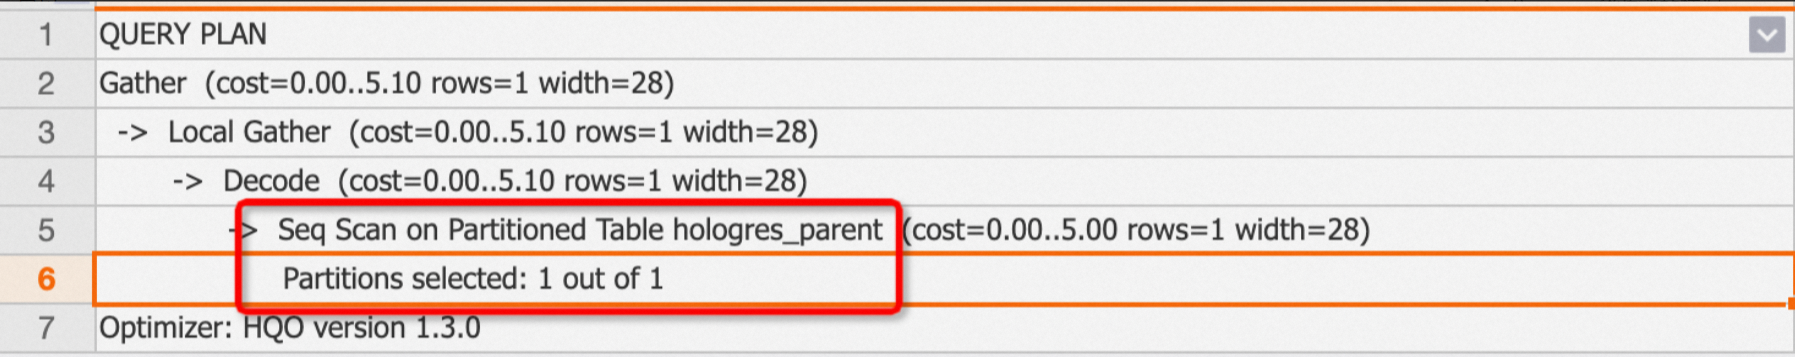
Les tables externes incluent une étiquette Foreign Table Type qui identifie la source (MaxCompute, OSS ou Hologres) :
EXPLAIN SELECT * FROM public.odps_lineitem_100;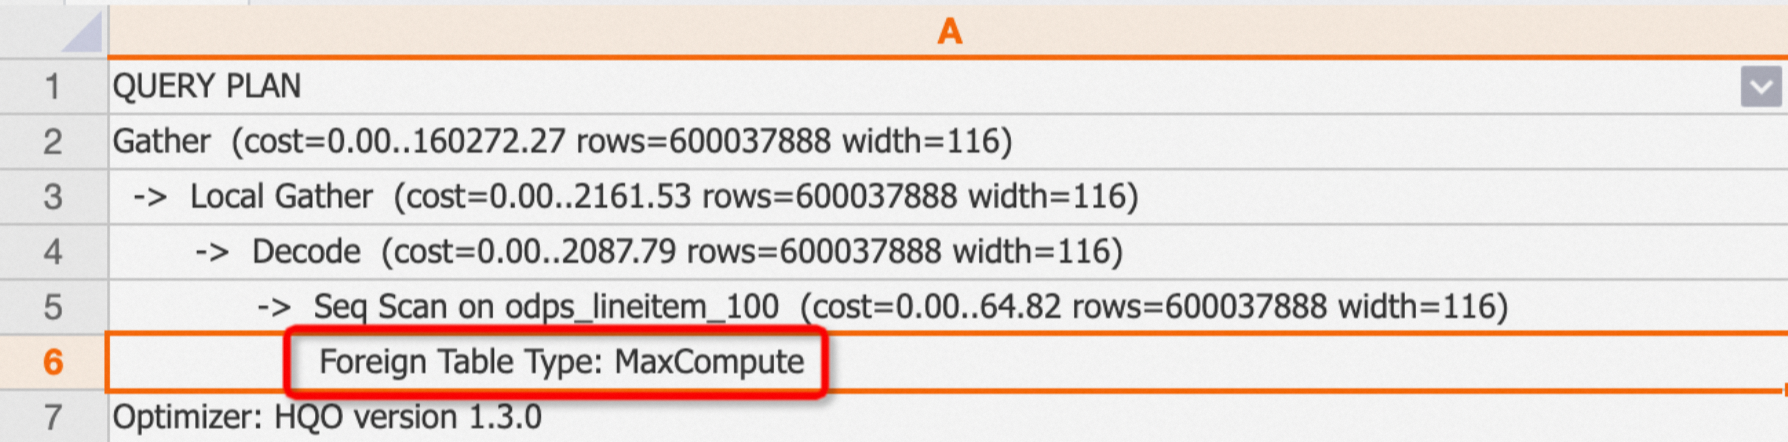
Index Scan et Index Seek
Hologres utilise différents opérateurs d'index selon le format de stockage de la table :
-
Index Scan (Clustering_index) : Utilisé pour les tables en mode column-store. Apparaît lorsqu'une requête atteint un index. Le plan affiche des sous-opérateurs qui identifient l'index utilisé : Segment Filter (index de segment), Cluster Filter (index de clustering) ou Bitmap Filter (index bitmap). Pour plus d'informations, consultez Principes du stockage en colonnes. Exemple 1 : La requête atteint l'index de clustering.
BEGIN;
CREATE TABLE column_test (
 "id" bigint not null ,
 "name" text not null ,
 "age" bigint not null
);
CALL set_table_property('column_test', 'orientation', 'column');
CALL set_table_property('column_test', 'distribution_key', 'id');
CALL set_table_property('column_test', 'clustering_key', 'id');
COMMIT;

INSERT INTO column_test VALUES(1,'tom',10),(2,'tony',11),(3,'tony',12);

EXPLAIN SELECT * FROM column_test WHERE id>2;
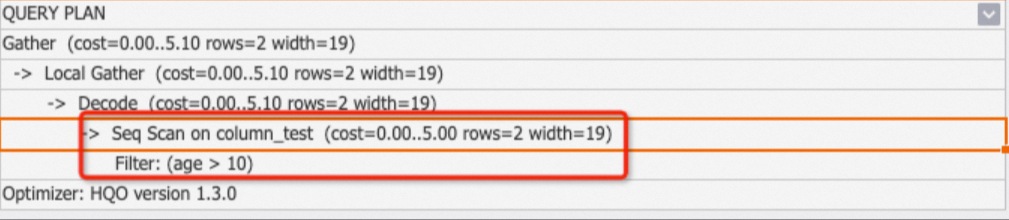
Exemple 2 : Requête sur une colonne non indexée — aucun Clustering_index dans le plan.
EXPLAIN SELECT * FROM column_test WHERE age>10;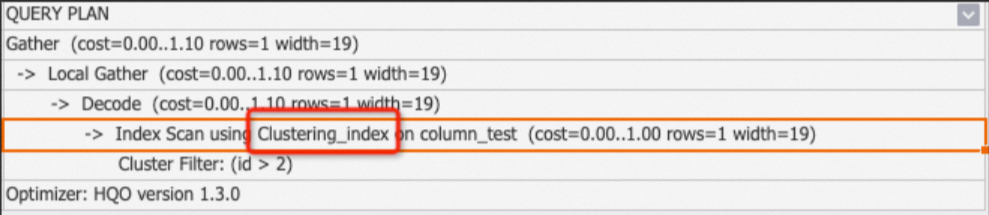
-
Index Seek (pk_index) : Utilisé pour les tables en mode row-store avec des index de clé primaire. Apparaît lorsqu'une requête de clé primaire n'utilise pas Fixed Plan. Pour plus d'informations, consultez Principes du stockage en lignes.
BEGIN;
CREATE TABLE row_test_1 (
    id bigint not null,
    name text not null,
    class text ,
PRIMARY KEY (id)
);
CALL set_table_property('row_test_1', 'orientation', 'row');
CALL set_table_property('row_test_1', 'clustering_key', 'name');
COMMIT;
INSERT INTO row_test_1 VALUES ('1','qqq','3'),('2','aaa','4'),('3','zzz','5');

BEGIN;
CREATE TABLE row_test_2 (
    id bigint not null,
    name text not null,
    class text ,
PRIMARY KEY (id)
);
CALL set_table_property('row_test_2', 'orientation', 'row');
CALL set_table_property('row_test_2', 'clustering_key', 'name');
COMMIT;
INSERT INTO row_test_2 VALUES ('1','qqq','3'),('2','aaa','4'),('3','zzz','5');

--primary key index
EXPLAIN SELECT * FROM (SELECT id FROM row_test_1 WHERE id = 1) t1 JOIN row_test_2 t2 ON t1.id = t2.id;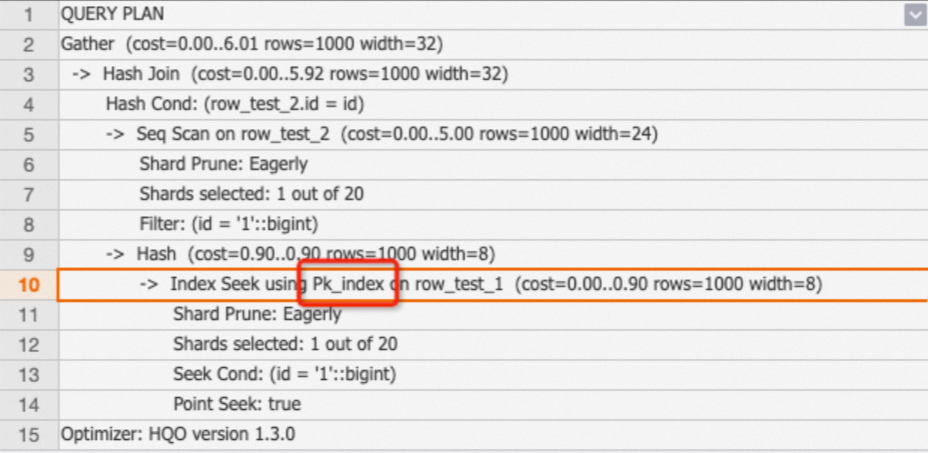
Opérateurs de filtrage
Les opérateurs de filtrage apparaissent en tant que nœuds enfants des opérateurs d'analyse et indiquent si une condition correspond à un index.
Filter
Un opérateur Filter simple signifie que la condition ne correspond à aucun index. Vérifiez la configuration des index de la table et ajoutez les index appropriés pour améliorer les performances.
Si le plan affiche One-Time Filter: false , l'ensemble de résultats est vide.
BEGIN;
CREATE TABLE clustering_index_test (
 "id" bigint not null ,
 "name" text not null ,
 "age" bigint not null
);
CALL set_table_property('clustering_index_test', 'orientation', 'column');
CALL set_table_property('clustering_index_test', 'distribution_key', 'id');
CALL set_table_property('clustering_index_test', 'clustering_key', 'age');
COMMIT;

INSERT INTO clustering_index_test VALUES (1,'tom',10),(2,'tony',11),(3,'tony',12);

EXPLAIN SELECT * FROM clustering_index_test WHERE id>2;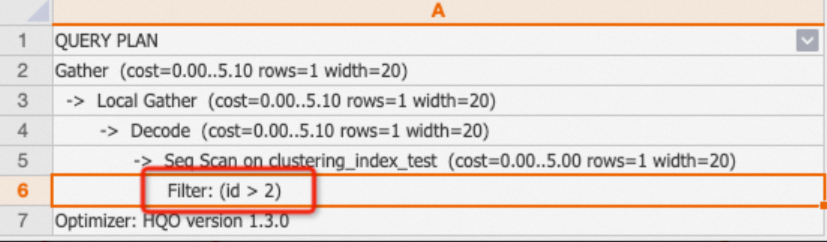
Segment Filter
La requête correspond à un index de segment (colonne Event Time). Cet opérateur apparaît conjointement avec Index Scan. Consultez la section Colonne Event Time (clé de segment).
Cluster Filter
La requête correspond à un index de regroupement. Consultez la section Clustering key.
Bitmap Filter
La requête correspond à un index bitmap. Consultez la section Index bitmap.
Join Filter
Applique un filtrage supplémentaire après une opération de jointure.
Decode
L'opérateur Decode décode ou encode les types de données textuels et similaires afin d'accélérer le calcul.
Local Gather et Gather
Dans Hologres, les données sont stockées sous forme de fichiers au sein des shards. L'opérateur Local Gather fusionne les données provenant de plusieurs fichiers au sein d'un même shard. L'opérateur Gather fusionne les données issues de plusieurs shards pour produire le résultat final.
EXPLAIN SELECT * FROM public.lineitem;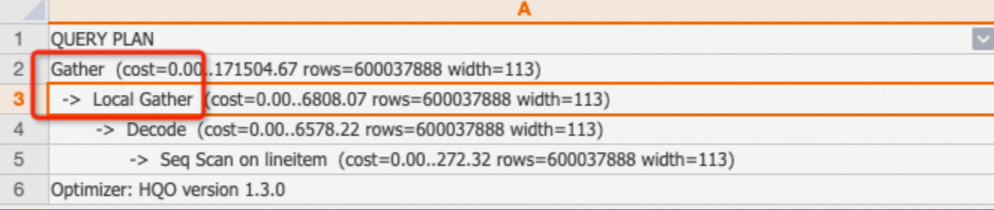
Redistribution
L'opérateur Redistribution redistribue les données entre les shards à l'aide d'une distribution par hachage ou aléatoire. Il apparaît généralement dans les situations suivantes :
Requêtes impliquant
JOIN,COUNT DISTINCTouGROUP BYdont les clés de distribution sont absentes ou incompatibles ; les données doivent être redistribuées entre les shards au lieu d'être jointes localement. Dans le cas de jointures multitable, la présence de l'opérateur Redistribution indique que la jointure locale n'a pas été utilisée, ce qui dégrade les performances.Clés de
JOINou deGROUP BYutilisant des expressions (telles que des conversions de type) qui modifient le type du champ d'origine, empêchant ainsi les jointures locales.
Exemple 1 : Des clés de distribution incompatibles entraînent une redistribution.
BEGIN;
CREATE TABLE tbl1(
a int not null,
b text not null
);
CALL set_table_property('tbl1', 'distribution_key', 'a');
CREATE TABLE tbl2(
c int not null,
d text not null
);
CALL set_table_property('tbl2', 'distribution_key', 'd');
COMMIT;

EXPLAIN SELECT * FROM tbl1  JOIN tbl2 ON tbl1.a=tbl2.c;
La condition de jointure est tbl1.a=tbl2.c, mais les clés de distribution sont a et d ; cette incompatibilité impose une redistribution des données.
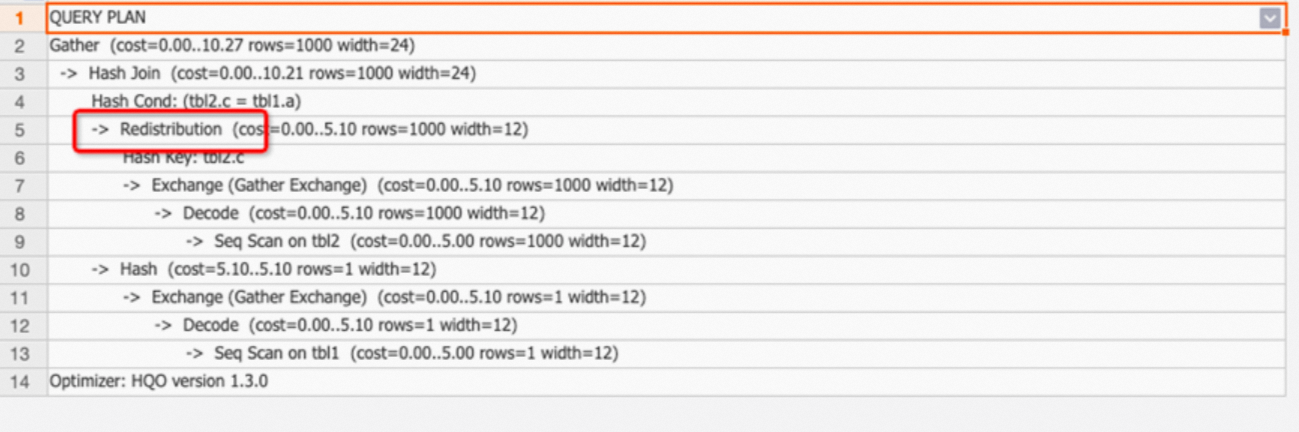
Si l'opérateur Redistribution apparaît, vérifiez que les clés de distribution sont correctement définies. Consultez la section Distribution key.
Exemple 2 : Une clé de jointure associée à une expression modifiant le type empêche les jointures locales.
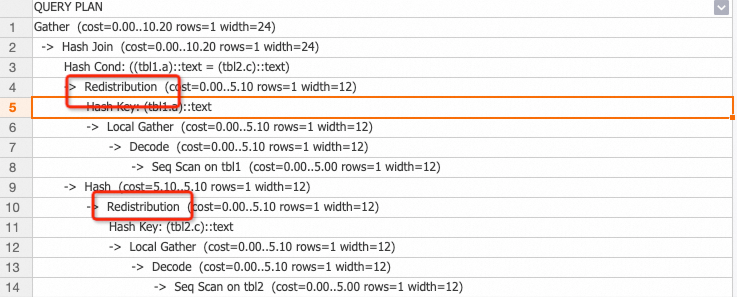
Évitez d'utiliser des expressions sur les clés de jointure pour prévenir ce problème.
Opérateurs de jointure
Hash Join
Une opération Hash Join construit une table de hachage en mémoire à partir de la table la plus petite, puis l'interroge ligne par ligne avec les données de la table la plus grande.
| Type | Description |
|---|---|
| Hash Left Join | Renvoie toutes les lignes de la table de gauche, avec des valeurs nulles pour les colonnes non appariées de la table de droite. |
| Hash Right Join | Renvoie toutes les lignes de la table de droite, avec des valeurs nulles pour les colonnes non appariées de la table de gauche. |
| Hash Inner Join | Renvoie uniquement les lignes qui satisfont la condition de jointure. |
| Hash Full Join | Renvoie toutes les lignes des deux tables, avec des valeurs nulles du côté non correspondant. |
| Hash Anti Join | Renvoie les lignes de la table principale qui n'ont aucune correspondance — utilisé pour NOT EXISTS. |
| Hash Semi Join | Renvoie une seule ligne par correspondance depuis la table principale — utilisé pour EXISTS. Aucune duplication. |
Lors de l'analyse d'une opération Hash Join, vérifiez également :
hash cond: la condition de jointure, par exemplehash cond (tmp.a=tmp1.b).hash key: la clé utilisée pour le calcul de hachage entre les shards, généralement la cléGROUP BY.
La table la plus petite doit servir de table de hachage. Pour le vérifier, repérez la table étiquetée hash dans le plan : en lecture ascendante (de bas en haut), elle apparaît comme la branche inférieure. L'utilisation de la table la plus grande comme table de hachage consomme une quantité excessive de mémoire.
Optimisation : mettez à jour les statistiques
Des statistiques obsolètes conduisent l'optimiseur de requêtes (QO) à mal estimer la taille des tables. Par exemple, les statistiques indiquent rows=1000 pour une table qui contient réellement 1 million de lignes, ce qui entraîne la sélection incorrecte de la table servant de table de hachage.
BEGIN ;
CREATE TABLE public.hash_join_test_1 (
    a integer not null,
    b text not null
);
CALL set_table_property('public.hash_join_test_1', 'distribution_key', 'a');
CREATE TABLE public.hash_join_test_2 (
    c integer not null,
    d text not null
);
CALL set_table_property('public.hash_join_test_2', 'distribution_key', 'c');
COMMIT ;

INSERT INTO hash_join_test_1 SELECT i, i+1 FROM generate_series(1, 10000) AS s(i);
INSERT INTO hash_join_test_2 SELECT i, i::text FROM generate_series(10, 1000000) AS s(i);

EXPLAIN SELECT * FROM hash_join_test_1 tbl1  JOIN hash_join_test_2 tbl2 ON tbl1.a=tbl2.c;
Le plan utilise incorrectement la table plus grande hash_join_test_2 comme table de hachage :
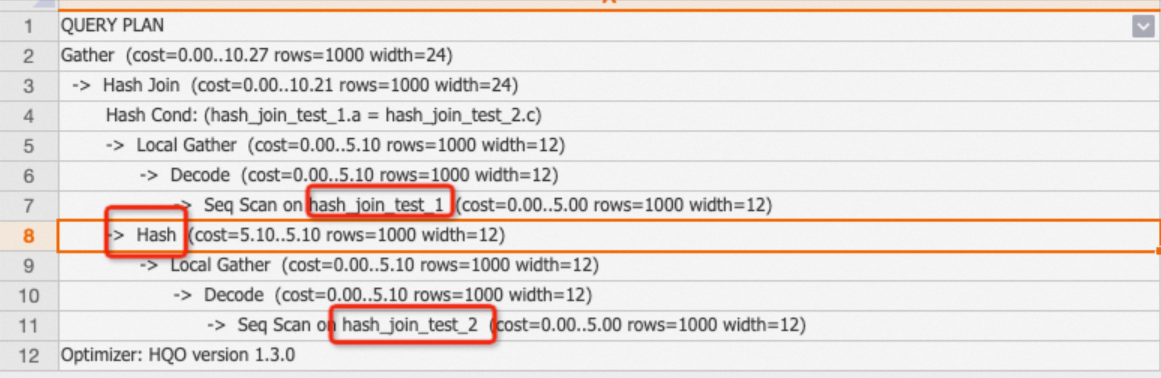
Après actualisation des statistiques, le plan sélectionne correctement la table la plus petite :
ANALYZE hash_join_test_1;
ANALYZE hash_join_test_2;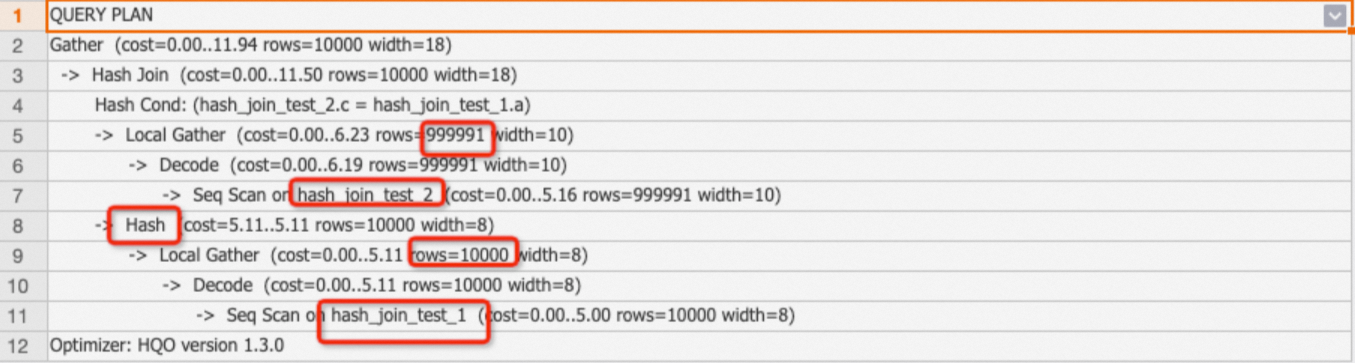
Optimisation : ajustez l'ordre des jointures pour les requêtes complexes
L'actualisation des statistiques résout la plupart des problèmes liés à l'ordre des jointures. Pour les jointures complexes impliquant cinq tables ou plus, le QO peut consacrer un temps significatif à la recherche du plan optimal. Utilisez le paramètre de configuration globale unifiée (GUC) optimizer_join_order pour contrôler ce comportement :
SET optimizer_join_order = '<value>';| Valeur | Description |
|---|---|
exhaustive (par défaut) |
Évalue toutes les permutations de l'ordre des jointures. Produit des plans optimaux, mais augmente la charge de l'optimiseur lorsqu'il y a beaucoup de tables. |
query |
Utilise l'ordre des jointures tel qu'écrit dans le code SQL. Réduit la charge du QO pour les jointures impliquant de petites tables (moins de 100 millions de lignes). Ne définissez pas cette option au niveau de la base de données, car elle affecte toutes les jointures. |
greedy |
Utilise un algorithme glouton pour trouver un bon ordre de jointure avec une charge modérée pour le QO. |
Nested Loop Join et Materialize
Un opérateur Nested Loop lit la table externe ligne par ligne et recherche chaque correspondance dans la table interne — il s'agit essentiellement d'un produit cartésien. La table interne affiche généralement un opérateur Materialize dans le plan.
BEGIN;
CREATE TABLE public.nestedloop_test_1 (
    a integer not null,
    b integer not null
);
CALL set_table_property('public.nestedloop_test_1', 'distribution_key', 'a');
CREATE TABLE public.nestedloop_test_2 (
    c integer not null,
    d text not null
);
CALL set_table_property('public.nestedloop_test_2', 'distribution_key', 'c');
COMMIT;

INSERT INTO nestedloop_test_1 SELECT i, i+1 FROM generate_series(1, 10000) AS s(i);
INSERT INTO nestedloop_test_2 SELECT i, i::text FROM generate_series(10, 1000000) AS s(i);

EXPLAIN SELECT * FROM nestedloop_test_1 tbl1,nestedloop_test_2 tbl2 WHERE tbl1.a>tbl2.c;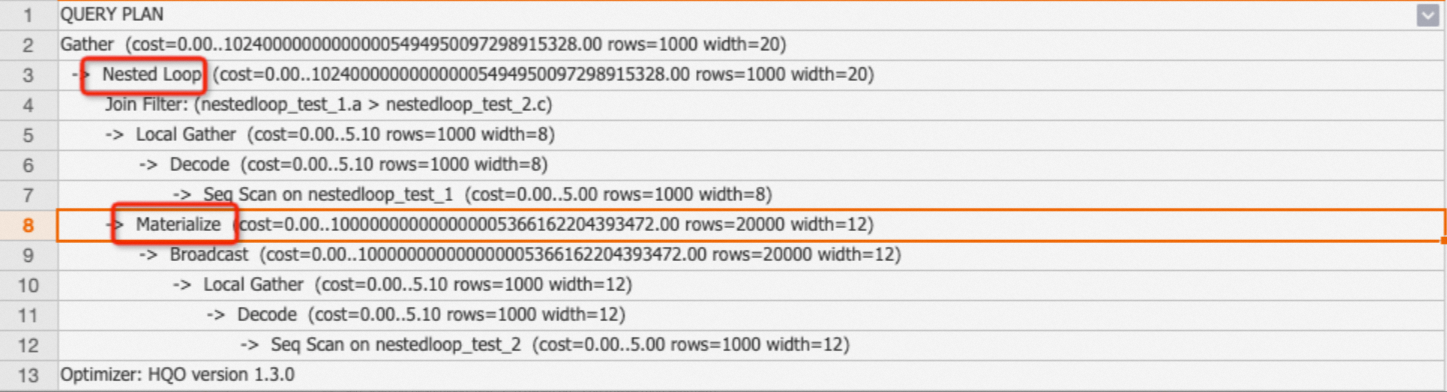
Pour réduire le coût d'une opération Nested Loop :
Maintenez un petit ensemble de résultats externes afin de limiter le nombre d'analyses de la table interne.
Évitez autant que possible les jointures non équivalentes, car elles génèrent généralement des plans de type Nested Loop.
Cross Join
À partir de la version 3.0, l'opérateur Cross Join optimise les scénarios de jointure non équivalente impliquant une petite table. Contrairement à Nested Loop, qui réinitialise l'état interne pour chaque ligne externe, Cross Join charge la totalité de la petite table en mémoire et y fait passer la grande table en flux continu. Cette méthode est nettement plus rapide, mais consomme davantage de mémoire.
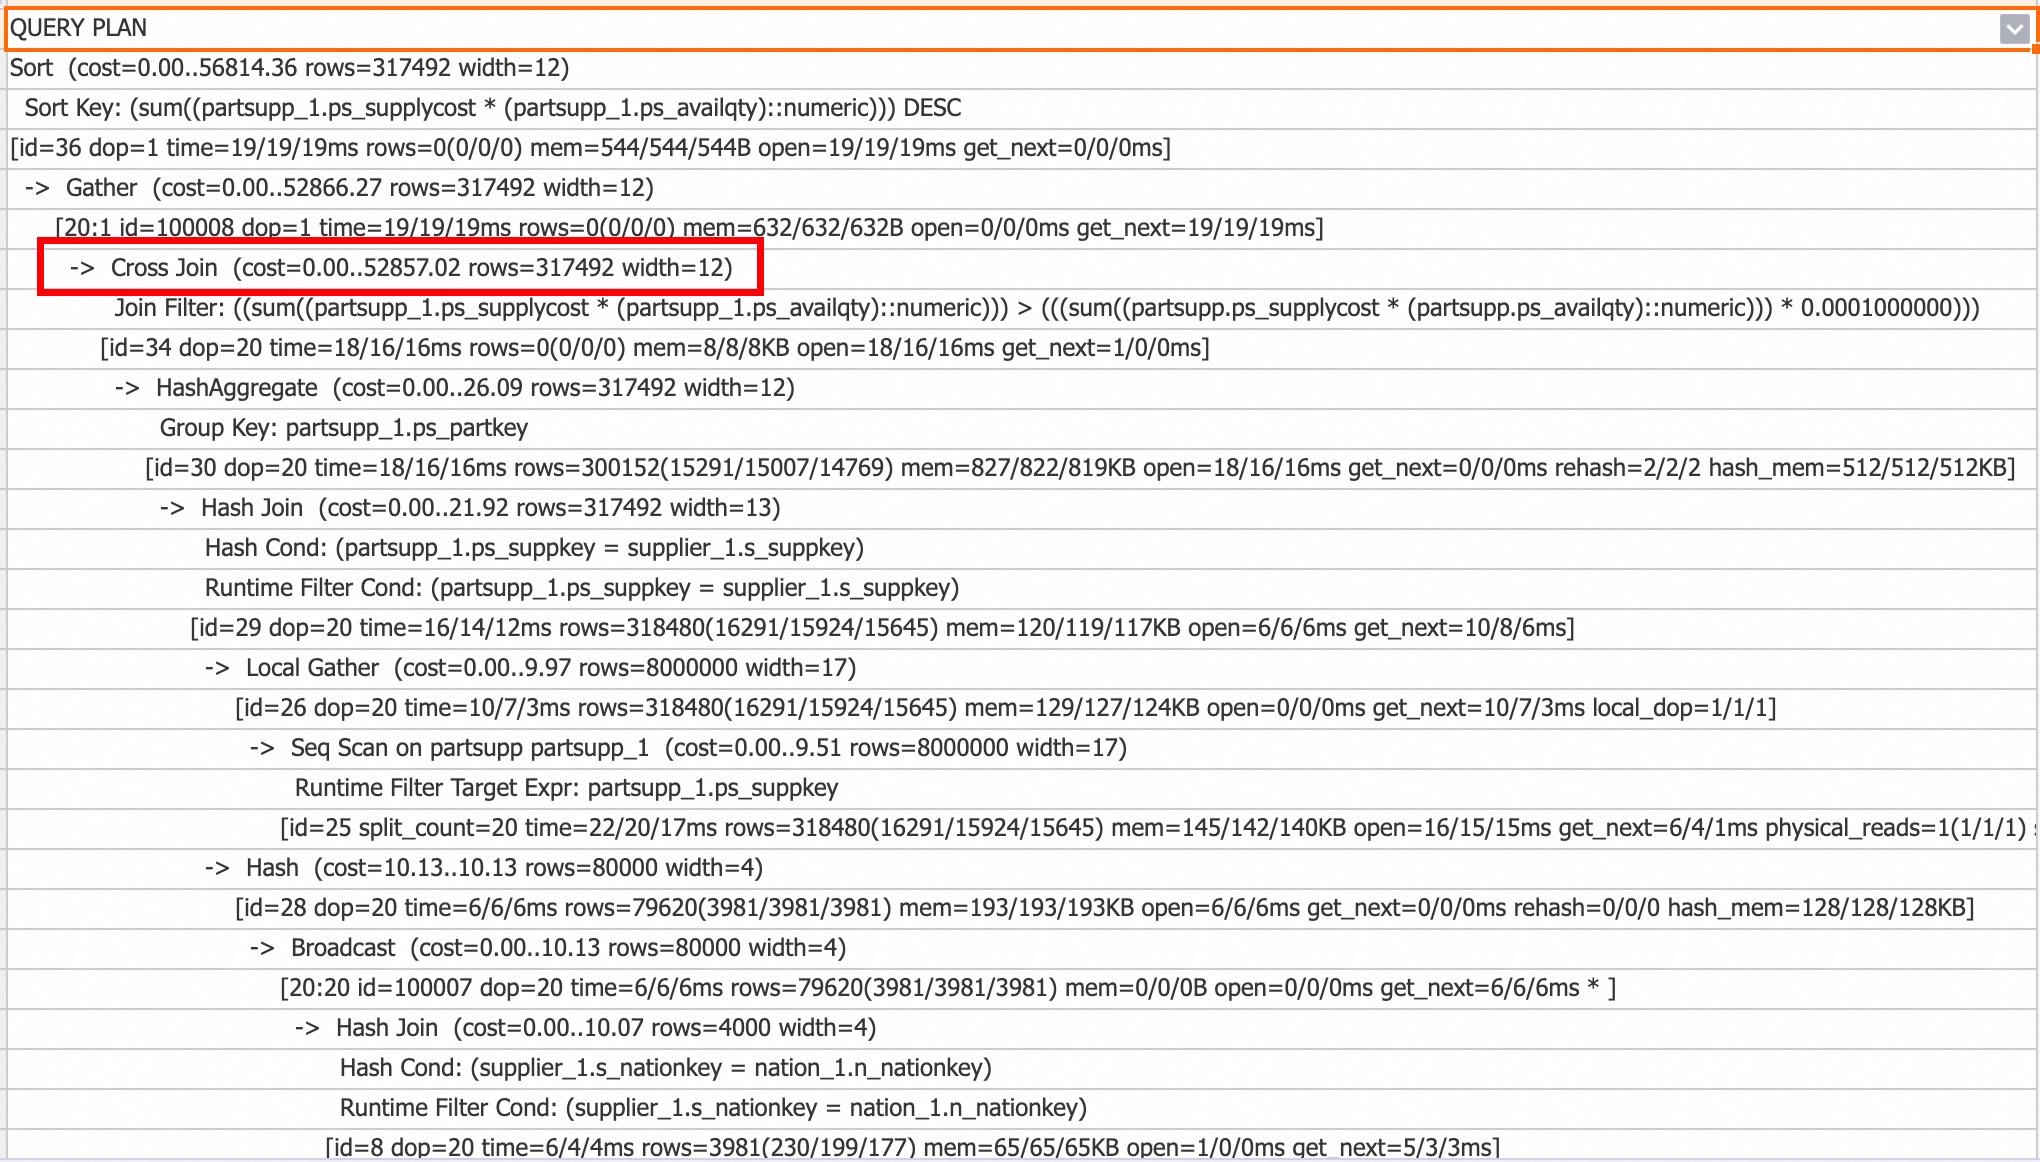
Pour désactiver Cross Join :
-- Disable for the current session
SET hg_experimental_enable_cross_join_rewrite = off;

-- Disable at the database level (takes effect for new connections)
ALTER database <database name> hg_experimental_enable_cross_join_rewrite = off;
Merge Join
Une opération Merge Join nécessite que ses entrées soient pré-triées selon les clés de jointure. Hologres peut sélectionner Merge Join pour les requêtes dont les données d'entrée sont déjà ordonnées.
Broadcast
L'opérateur Broadcast copie une table vers tous les shards. Il est utilisé dans les scénarios de jointure par diffusion (Broadcast Join), où une petite table est jointe à une grande table. L'optimiseur de requête (QO) compare le coût de la diffusion à celui de la redistribution et sélectionne l'option la moins coûteuse.
La diffusion s'avère rentable lorsque la table est de petite taille et que l'instance comporte peu de shards (par exemple, 5 shards).
BEGIN;
CREATE TABLE broadcast_test_1 (
    f1 int,
    f2 int);
CALL set_table_property('broadcast_test_1','distribution_key','f2');
CREATE TABLE broadcast_test_2 (
    f1 int,
    f2 int);
COMMIT;

INSERT INTO broadcast_test_1 SELECT i AS f1, i AS f2 FROM generate_series(1, 30)i;
INSERT INTO broadcast_test_2 SELECT i AS f1, i AS f2 FROM generate_series(1, 30000)i;

ANALYZE broadcast_test_1;
ANALYZE broadcast_test_2;

EXPLAIN SELECT * FROM broadcast_test_1 t1, broadcast_test_2 t2 WHERE t1.f1=t2.f1;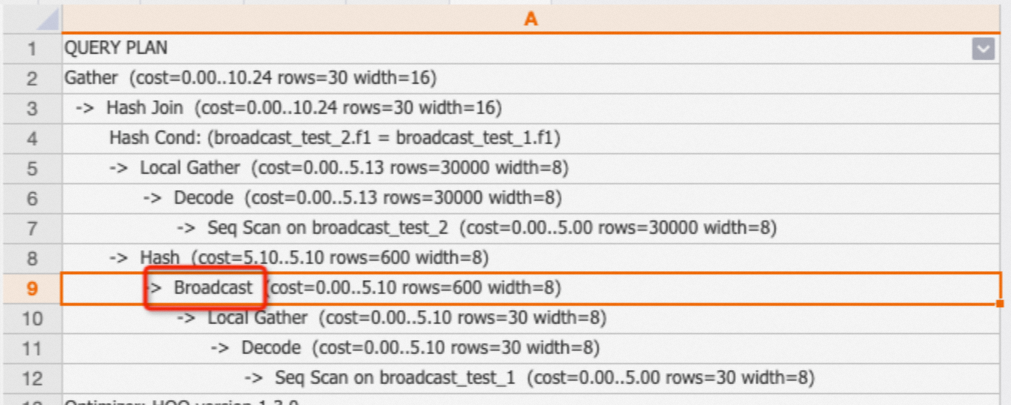
Si l'opération Broadcast apparaît pour une table qui n'est pas petite, cela est probablement dû à des statistiques obsolètes (par exemple, les statistiques indiquent 1 000 lignes, alors que la table en contient réellement 1 million). Exécutez ANALYZE <tablename> pour les actualiser.
Shard prune et Shards selected
-
Shard prune : indique comment le QO sélectionne les shards pertinents. Le QO choisit automatiquement la méthode appropriée.
lazily: les shards sont d'abord identifiés par leur ID, puis sélectionnés lors du calcul.eagerly: seuls les shards correspondants sont immédiatement sélectionnés ; les shards non pertinents sont ignorés.
Shards selected : nombre de shards utilisés. Par exemple, 1 out of 20 signifie qu'un shard a été sélectionné sur un total de 20.
ExecuteExternalSQL
Hologres repose sur trois composants de moteur de requête : Hologres Query Engine (HQE), PostgreSQL Query Engine (PQE) et Shard Query Engine (SQE). HQE est le moteur propriétaire. Lorsque HQE ne prend pas en charge une fonction ou un opérateur, PQE s'en charge, ce qui entraîne un coût en termes de performances. L'opérateur ExecuteExternalSQL présent dans un plan signale une exécution via PQE.
Exemple 1 : la conversion ::timestamp est gérée par PQE.
CREATE TABLE pqe_test(a text);
INSERT INTO pqe_test VALUES ('2023-01-28 16:25:19.082698+08');
EXPLAIN SELECT a::timestamp FROM pqe_test;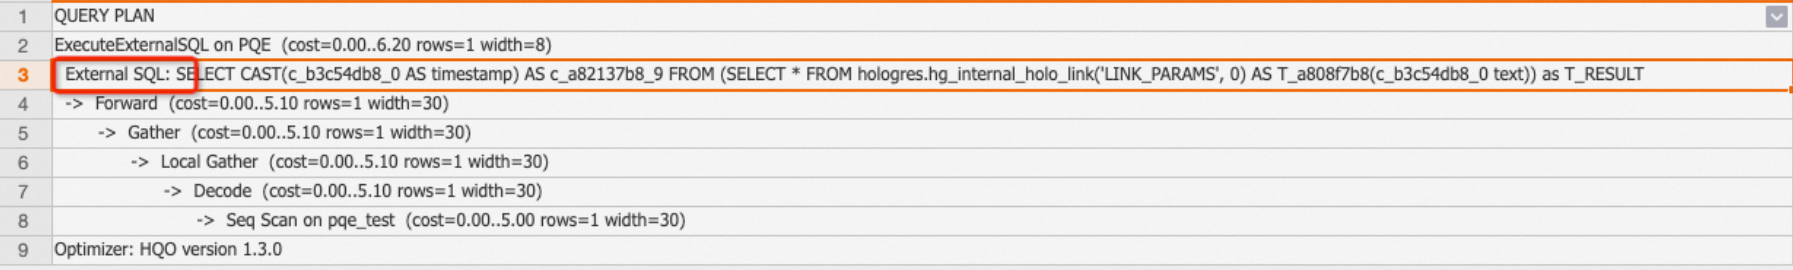
Exemple 2 : remplacer ::timestamp par to_timestamp permet d'utiliser HQE à la place ; aucun ExecuteExternalSQL n'apparaît alors dans le plan.
EXPLAIN SELECT to_timestamp(a,'YYYY-MM-DD HH24:MI:SS') FROM pqe_test;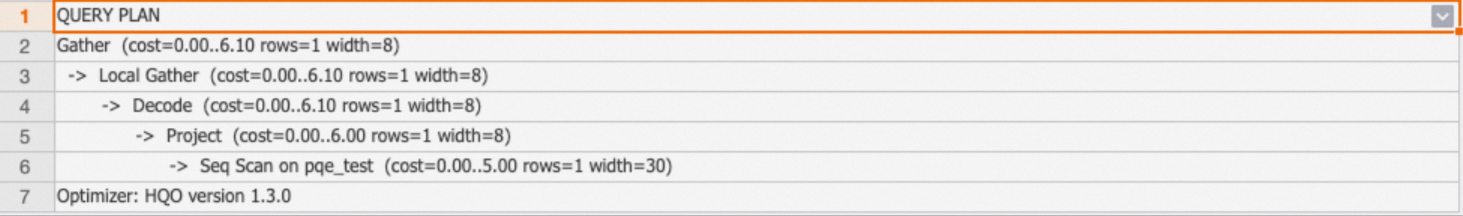
Identifiez les fonctions qui déclenchent PQE dans les plans d'exécution, puis réécrivez-les pour utiliser des équivalents compatibles avec HQE. Consultez la rubrique Optimiser les performances des requêtes pour des exemples courants de réécriture.
À chaque nouvelle version, Hologres transfère davantage d'opérations PQE vers HQE. Certaines fonctions peuvent ainsi utiliser automatiquement HQE après une mise à niveau. Consultez les Notes de version des fonctions .
Opérateurs d'agrégation
Hologres utilise HashAggregate pour la plupart des agrégations. HashAggregate distribue les données entre les shards pour une agrégation parallèle, puis fusionne les résultats avec Gather.
Pour les grands ensembles de données, Hologres utilise un HashAggregate en plusieurs étapes :
Partial HashAggregate : agrège les données au sein des fichiers et des shards.
Final HashAggregate : combine les résultats partiels issus des différents shards.
L'opérateur GroupAggregate est utilisé lorsque les données sont déjà triées selon les clés GROUP BY.
EXPLAIN SELECT
        sum(l_extendedprice * l_discount) AS revenue
FROM
        lineitem
WHERE
        l_shipdate >= date '1996-01-01'
        AND l_shipdate < date '1996-01-01' + interval '1' year
        AND l_discount BETWEEN 0.02 - 0.01 AND 0.02 + 0.01
        AND l_quantity < 24;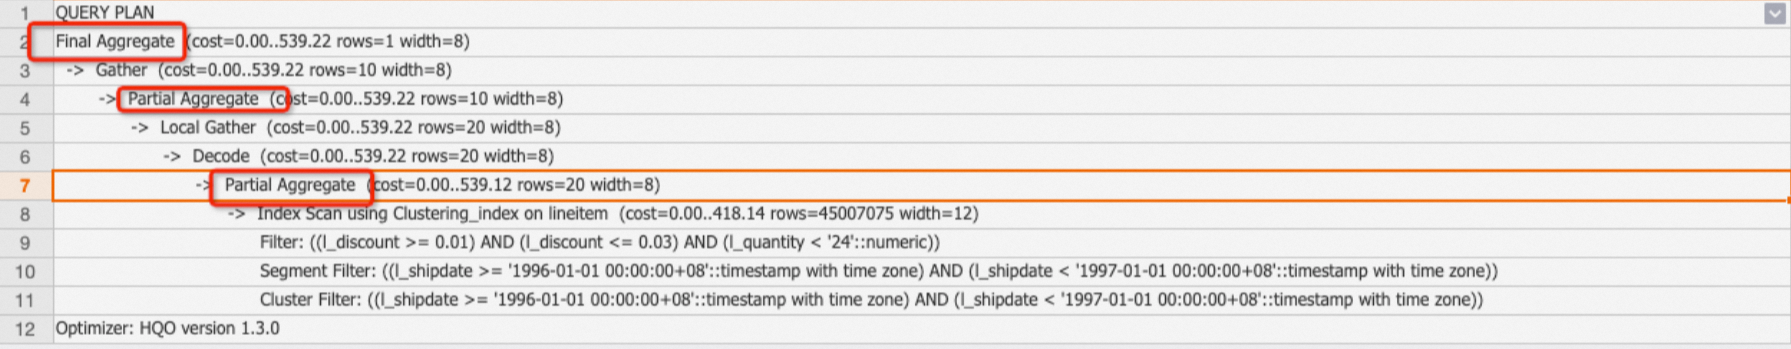
Le QO choisit automatiquement entre une agrégation en une seule étape ou en plusieurs étapes selon le volume de données. Si EXPLAIN ANALYZE indique un temps élevé pour un opérateur Aggregate, mais que le QO n'a choisi qu'une agrégation au niveau des shards, forcez l'agrégation en plusieurs étapes :
SET optimizer_force_multistage_agg = on;Sort
L'opérateur Sort trie les lignes par ordre croissant (ASC) ou décroissant (DESC), généralement à partir des clauses ORDER BY.
EXPLAIN SELECT l_shipdate FROM public.lineitem ORDER BY l_shipdate;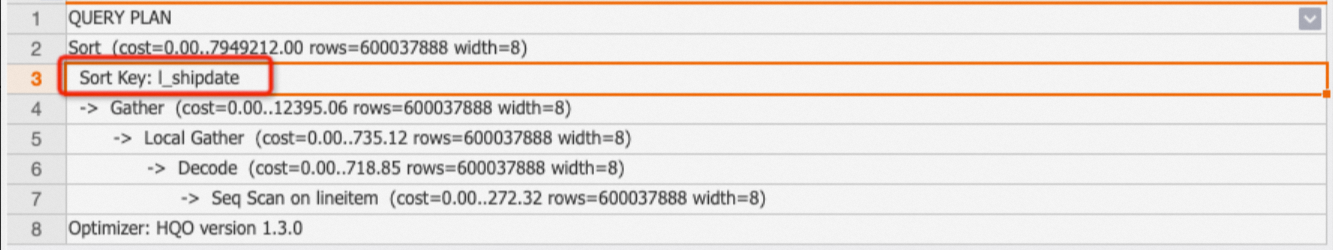
Les opérations de tri de grande ampleur consomment des ressources significatives. Évitez autant que possible de trier de grands ensembles de données.
Limit
L'opérateur Limit plafonne le nombre de lignes en sortie. Il contrôle uniquement le résultat final, et non le nombre de lignes analysées. Vérifiez si Limit est poussé vers le nœud Seq Scan pour comprendre le volume réel d'analyse.
EXPLAIN SELECT * FROM public.lineitem limit 1;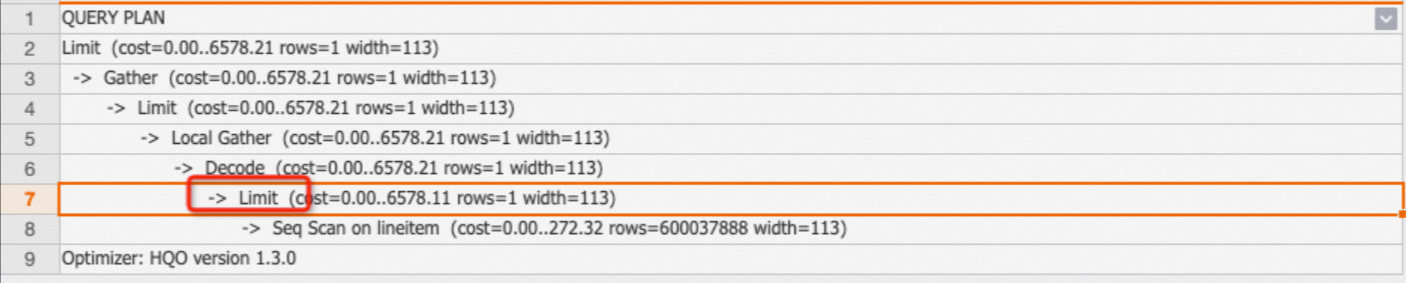
Remarques concernant Limit :
Tous les opérateurs Limit ne sont pas poussés vers le bas. Ajoutez des conditions de filtrage pour réduire le nombre de lignes analysées.
Évitez les valeurs LIMIT très élevées (des centaines de milliers ou plus) : elles augmentent le temps d'analyse, même lorsqu'elles sont poussées vers le bas.
Append
L'opérateur Append fusionne les résultats des sous-requêtes UNION ALL.
Exchange
L'opérateur Exchange transfère les données au sein d'un shard. Aucune action n'est requise.
Forward
L'opérateur Forward transfère les données entre HQE et PQE ou SQE. Il apparaît dans les plans qui utilisent des combinaisons HQE+PQE ou HQE+SQE.
Project
L'opérateur Project représente le mappage de colonnes entre une sous-requête et sa requête externe. Aucune action n'est requise.
Problèmes de performances courants
Cette section sert de référence rapide lorsque vous identifiez un symptôme spécifique dans le plan d'exécution.
| Symptôme | Cause probable | Action recommandée |
|---|---|---|
rows=1000 sur une opération de scan |
Statistiques obsolètes | Exécutez la commande ANALYZE <tablename> |
| Redistribution lors d'une jointure | Inadéquation des clés de distribution ou expression modifiant le type sur la clé de jointure | Alignez les clés de distribution avec les clés de jointure ; évitez les expressions sur les clés de jointure. Consultez la section Distribution key. |
| La table volumineuse sert de table de hachage dans une jointure par hachage (Hash Join) | Statistiques obsolètes | Exécutez la commande ANALYZE sur les deux tables |
| Temps d'agrégation élevé avec uniquement une agrégation au niveau des shards | Volume de données trop important pour une agrégation en une seule étape | Définissez le paramètre optimizer_force_multistage_agg = on |
| Présence de l'opération ExecuteExternalSQL | Fonction ou opérateur non pris en charge par HQE, avec basculement vers PQE | Réécrivez l'expression en utilisant une fonction compatible avec HQE. Consultez la rubrique Optimize query performance. |
| Jointure par boucles imbriquées (Nested Loop) sur des tables volumineuses | Condition de jointure non équivalente | Réécrivez la requête sous forme de jointure équivalente si possible ; maintenez l'ensemble de résultats externe à une taille réduite |
Temps open élevé sur les opérateurs de hachage |
Construction lente de la table de hachage — table interne volumineuse ou nœuds enfants lents | Vérifiez les statistiques et les temps des opérateurs enfants ; envisagez de modifier l'ordre des jointures |
Écart important entre les valeurs max et min des paramètres rows ou mem |
Déséquilibre des données entre les shards | Consultez la section ADVICE ; ajustez les clés de distribution |
| Coût élevé lié à l'attente du schéma (Wait schema) | Opérations DDL fréquentes sur les tables parentes partitionnées | Réduisez la fréquence des opérations DDL |
| Coût élevé lié au verrouillage des requêtes (Lock query) | Contentions de verrous | Analysez les requêtes concurrentes |
Étapes suivantes
Pour visualiser les plans d'exécution dans HoloWeb, consultez la rubrique View execution plans.