Les tâches par lots dans Realtime Compute for Apache Flink reposent sur des mécanismes d'exécution différents de ceux des tâches en continu : l'allocation des ressources, la transmission des données et la récupération après incident ne fonctionnent pas de la même manière. Ce guide détaille ces distinctions et vous explique comment configurer les ressources ainsi que le parallélisme pour optimiser les performances de vos tâches par lots.
Realtime Compute for Apache Flink prend en charge le traitement par lots lors du développement de brouillons, de l'exploitation et de la maintenance des tâches, des workflows, de la gestion des files d'attente et du profilage des données. Pour une présentation complète de bout en bout, consultez Démarrage rapide avec le traitement par lots .
Différences entre les tâches par lots et les tâches en continu
Comprendre ces différences vous permet de configurer correctement les tâches par lots et d'éviter les erreurs courantes.
Mode d'exécution
Les tâches en continu traitent des flux de données continus et illimités avec une faible latence. Les données circulent entre les opérateurs en mode pipeline, ce qui signifie que toutes les sous-tâches de tous les opérateurs sont déployées et s'exécutent simultanément.
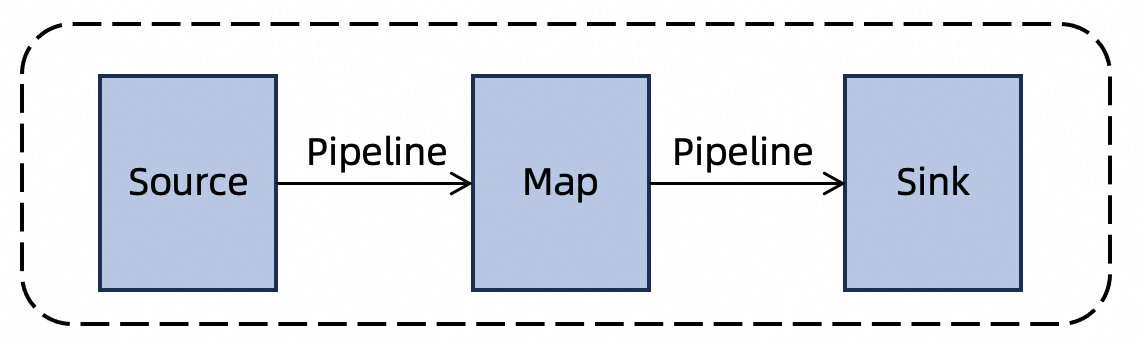
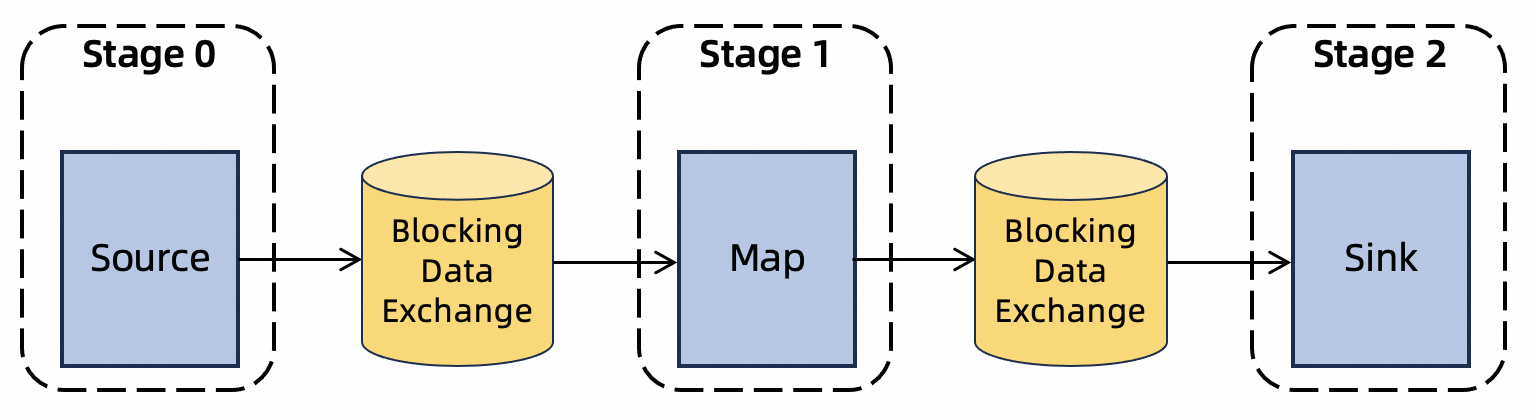
Les tâches par lots traitent des ensembles de données délimités avec un débit élevé. Une tâche s'exécute en plusieurs phases :
Les phases indépendantes s'exécutent en parallèle afin de maximiser l'utilisation des ressources.
Les phases dépendantes attendent : les sous-tâches en aval ne démarrent qu'une fois les sous-tâches en amont terminées.
Transmission des données
Les tâches en continu conservent les données intermédiaires en mémoire et les transmettent directement entre les opérateurs. Comme les données ne sont pas persistées, toute lenteur en aval exerce une contre-pression sur les opérateurs en amont.
Les tâches par lots écrivent les résultats intermédiaires dans un stockage externe avant leur consommation par les opérateurs en aval. Par défaut, les résultats sont stockés sur le disque local de chaque TaskManager. Si le service de shuffle distant est activé, les résultats y sont envoyés à la place.
Besoins en ressources
Les tâches en continu nécessitent l'allocation de toutes les ressources avant le démarrage, car chaque sous-tâche s'exécute en même temps.
Les tâches par lots n'allouent pas les ressources au préalable. Realtime Compute for Apache Flink planifie les sous-tâches par lots dès que leurs données d'entrée sont prêtes, ce qui permet d'exécuter une tâche par lot avec aussi peu qu'un seul slot.
Récupération après incident
Les tâches en continu reprennent à partir du dernier checkpoint ou savepoint. Étant donné que les données intermédiaires ne sont pas persistées, toutes les sous-tâches redémarrent.
Les tâches par lots stockent les résultats intermédiaires sur le disque ; seules la sous-tâche ayant échoué et ses sous-tâches en aval doivent donc redémarrer, sans nécessité de retour arrière complet. Les tâches par lots ne disposent pas de mécanisme de checkpoint ; les sous-tâches redémarrées commencent donc depuis le début de leur phase.
Configurer les ressources
CPU et mémoire
Définissez le CPU et la mémoire pour le JobManager et les TaskManagers dans la section Resources de l'onglet Configuration.
| Composant | Recommandé | Minimum |
|---|---|---|
| JobManager | 1 cœur de CPU, 4 GiB de mémoire | 0,5 cœur de CPU, 2 GiB de mémoire |
| TaskManager (par slot) | 1 cœur de CPU, 4 GiB de mémoire | 0,5 cœur de CPU, 2 GiB de mémoire |
Pour un TaskManager disposant de n slots, allouez n cœurs de CPU et 4n GiB de mémoire.
L'espace disque est proportionnel aux cœurs de CPU : chaque cœur fournit 20 GiB, avec un minimum de 20 GiB et un maximum de 200 GiB par TaskManager.
Par défaut, chaque TaskManager d'une tâche par lot dispose d'un seul slot. Pour réduire la surcharge de planification des TaskManagers, définissez le nombre de slots par TaskManager à 2 ou 4. Gardez à l'esprit qu'un plus grand nombre de slots sur un seul TaskManager implique que davantage de sous-tâches partagent son disque local ; si l'espace disque vient à manquer, la tâche échoue et redémarre. Consultez la section No space left on device pour connaître les solutions.
Pour les tâches présentant une topologie à grande échelle ou un routage réseau complexe, augmentez les ressources au-delà des valeurs par défaut en fonction de votre charge de travail.
Si vous rencontrez des problèmes liés aux ressources, consultez la page Dépannage de la mémoire Flink.
Nombre maximal de slots
Configurez une limite maximale de slots pour plafonner les ressources qu'une tâche par lot peut consommer, afin d'éviter qu'elle n'affame les autres tâches. Pour plus de détails sur la configuration, consultez la section Comment limiter le nombre de TaskManagers ?
Configurer le parallélisme
Définissez le parallélisme dans la section Resources de l'onglet Configuration.
Parallélisme global
Le parallélisme global définit la limite supérieure du nombre de sous-tâches qu'un opérateur peut exécuter en parallèle. Saisissez une valeur dans le champ Parallelism.
Inférence automatique du parallélisme
Dans Realtime Compute for Apache Flink avec Ververica Runtime (VVR) 8.0 ou version ultérieure, l'inférence automatique du parallélisme est activée par défaut pour les tâches par lots. Cette fonctionnalité analyse le volume total de données consommé par chaque opérateur et le volume moyen de données configuré par sous-tâche, puis déduit automatiquement un parallélisme approprié.
Le parallélisme global que vous avez défini sert de upper limit pour le parallélisme inféré.
Configurez les paramètres suivants dans la section Parameters de l'onglet Configuration :
| Paramètre | Description | Par défaut |
|---|---|---|
execution.batch.adaptive.auto-parallelism.enabled |
Active l'inférence automatique du parallélisme. | true |
execution.batch.adaptive.auto-parallelism.min-parallelism |
Parallélisme minimal inféré. | 1 |
execution.batch.adaptive.auto-parallelism.max-parallelism |
Parallélisme maximal inféré. Si non défini, le parallélisme global est utilisé. | 128 |
execution.batch.adaptive.auto-parallelism.avg-data-volume-per-task |
Volume moyen de données que chaque sous-tâche est censée traiter. Le parallélisme inféré est mis à l'échelle en fonction du volume total de données de l'opérateur divisé par cette valeur. | 16MiB |
execution.batch.adaptive.auto-parallelism.default-source-parallelism |
Parallélisme pour les opérateurs source. Étant donné que le volume de données source ne peut pas être mesuré avant la lecture, définissez-le explicitement. Si non défini, le parallélisme global est utilisé. | 1 |
FAQ
Comment limiter le nombre de TaskManagers ?
Les TaskManagers (TM) sont créés et libérés dynamiquement dans les tâches par lots. Avec un parallélisme de 16 et un slot par TaskManager, la tâche démarre 16 TM. À mesure que les sous-tâches se terminent et que leurs TM sont libérés, de nouveaux TM sont créés pour les opérateurs suivants ; le nombre total peut donc dépasser brièvement 16 (par exemple, 17, 18 ou 19). Il s'agit d'un comportement normal de planification élastique.
Pour appliquer une limite stricte, configurez le nombre maximal de slots pour la tâche. Cela permet de limiter le nombre de TM pouvant s'exécuter simultanément.
Quelle est la différence entre le parallélisme et les slots ?
Le parallélisme définit le nombre maximal d'instances de sous-tâches qu'un opérateur peut exécuter simultanément.
Un slot est l'unité d'allocation des ressources. Le nombre total de slots disponibles détermine combien de sous-tâches peuvent s'exécuter simultanément sur l'ensemble de la tâche.
Les tâches en continu utilisent le partage de slots par défaut et demandent des slots équivalents au parallélisme global au démarrage, de sorte que toutes les sous-tâches commencent immédiatement.
Les tâches par lots n'allouent pas les slots au préalable. La concurrence réelle est limitée par les slots disponibles, même si le parallélisme global est défini à une valeur plus élevée.
Par exemple : une tâche en continu avec un parallélisme de 4 nécessite 4 slots dès le départ. Une tâche par lot avec un parallélisme de 4 exécute au maximum 4 sous-tâches si 4 slots sont disponibles ; les sous-tâches restantes attendent que des slots se libèrent.
Que faire si une tâche par lot est bloquée ?
Surveillez l'utilisation de la mémoire, l'utilisation du CPU et l'activité des threads de vos TaskManagers. Consultez la page Surveiller les performances des tâches.
| Symptôme | Où regarder | Action |
|---|---|---|
| Utilisation élevée de la mémoire ou pauses GC fréquentes | Métriques de mémoire | Augmentez la mémoire du TaskManager |
| Un thread consommant beaucoup de CPU | Métriques CPU et threads | Identifiez le thread problématique à partir des traces de pile des threads |
| La tâche ne progresse pas | Traces de pile des threads | Analysez les goulots d'étranglement d'exécution par opérateur |
No space left on device
Lorsqu'une tâche par lot échoue avec l'erreur No space left on device, cela signifie que les TaskManagers ont épuisé leur espace disque local en stockant les fichiers de résultats intermédiaires. L'espace disque est proportionnel aux cœurs de CPU : chaque cœur fournit 20 GiB, jusqu'à 200 GiB par TaskManager.
Résolvez le problème en appliquant l'une des approches suivantes :
Réduisez le nombre de slots par TaskManager. Moins de slots signifient moins de sous-tâches simultanées sur un seul nœud, ce qui réduit la quantité de données intermédiaires écrites sur le disque local.
Augmentez le nombre de cœurs de CPU par TaskManager. Davantage de cœurs augmentent proportionnellement l'espace disque disponible.
Étapes suivantes
Démarrage rapide avec le traitement par lots — présentation de bout en bout des principales fonctionnalités de traitement par lots
Configurer des paramètres personnalisés pour l'exécution des tâches — référence complète des paramètres des tâches