Le connecteur MongoDB intègre ApsaraDB for MongoDB et les instances MongoDB autogérées dans Realtime Compute for Apache Flink en tant que tables source, de dimension et de destination (sink). Il utilise l'API Change Stream pour capturer en temps réel les événements d'insertion, de mise à jour, de remplacement et de suppression.
Fonctionnalités
|
Catégorie |
Description |
|
Types de table |
Source SQL, recherche (dimension) et destination (sink) Source Flink CDC Source DataStream |
|
Mode d'exécution |
Streaming |
|
Types d'API |
API DataStream, SQL, Flink CDC |
|
Sémantique d'écriture du sink |
Insertion, mise à jour et suppression (avec clé primaire déclarée) |
Métriques de surveillance
Tables sources :
numBytesIn, numBytesInPerSecond, numRecordsIn, numRecordsInPerSecond, numRecordsInErrors, currentFetchEventTimeLag, currentEmitEventTimeLag, watermarkLag, sourceIdleTime
Les tables de dimension et de destination n'exposent aucune métrique de surveillance.
Pour les définitions des métriques, consultez la rubrique Métriques.
Fonctionnement
Le connecteur MongoDB lit les données en deux phases :
Instantané complet : lecture parallèle de tous les documents existants dans les collections ciblées.
Lecture incrémentielle : basculement automatique vers la consommation de l'oplog via l'API Change Stream une fois l'instantané terminé.
Ce processus offre une sémantique exactement une fois (exactly-once), garantissant l'absence de doublons ou de pertes d'enregistrements lors de la récupération après incident.
Concepts clés
Modes de démarrage
Choisissez un mode de démarrage en fonction du moment où votre pipeline doit commencer à consommer les données :
|
Mode |
Comportement |
Cas d'utilisation |
|
|
Lit un instantané au premier démarrage, puis passe à la lecture incrémentielle |
Vous avez besoin d'une copie complète des données existantes |
|
|
Démarre à partir de la position actuelle de l'oplog ; aucune donnée historique |
Seules les modifications futures vous intéressent |
|
|
Lit les événements de l'oplog à partir d'un horodatage spécifié ; ignore l'instantané |
Vous avez besoin des modifications à partir d'un point temporel connu (nécessite MongoDB 4.0+) |
Prise en charge complète du journal des modifications (changelog)
Par défaut, MongoDB ne stocke pas l'état des documents avant modification (versions antérieures à MongoDB 6.0). Sans cette information, le connecteur ne peut produire que des événements UPSERT : les enregistrements UPDATE_BEFORE sont absents.
Pour contourner cette limitation, le planificateur SQL de Flink insère un opérateur ChangelogNormalize qui met en cache l'état des documents dans le backend d'état de Flink. Bien que fonctionnelle, cette approche consomme un volume important de stockage d'état.
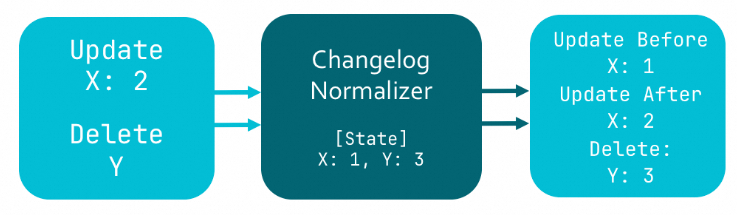
MongoDB 6.0 et versions ultérieures prennent en charge l'enregistrement des images avant (preimage) et après (postimage) modification. Lorsqu'elle est activée, cette fonctionnalité permet à MongoDB d'enregistrer l'état complet du document avant et après chaque changement. Définir scan.full-changelog sur true indique au connecteur d'utiliser ces enregistrements pour produire des flux de journal des modifications complets, éliminant ainsi l'opérateur ChangelogNormalize et sa surcharge d'état associée.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Une instance ApsaraDB for MongoDB (replica set ou cluster shardé) ou un cluster MongoDB autogéré version 3.6 ou ultérieure, avec le mode replica set activé. Consultez la documentation Replication.
Si l'authentification est activée, un utilisateur MongoDB disposant des autorisations suivantes :
splitVector,listDatabases,listCollections,collStats,find,changeStream, ainsi qu'un accès en lecture aux collectionsconfig.collectionsetconfig.chunks.Les adresses IP du cluster Flink ajoutées à la liste d'autorisation IP de MongoDB.
La base de données et la collection cibles créées avant l'exécution de la tâche.
Limitations
Source SQL
La lecture parallèle des instantanés nécessite MongoDB 4.0 ou une version ultérieure. Activez-la en définissant
scan.incremental.snapshot.enabledsurtrue.Les bases de données
admin,localetconfig, ainsi que toutes les collections système, ne peuvent pas être surveillées. Il s'agit d'une restriction liée aux Change Streams de MongoDB. Consultez la section Change Streams de la documentation MongoDB.Lors de la création d'une table source SQL, déclarez la colonne
_id STRINGet définissez-la comme clé primaire.
Destination (sink) SQL
VVR 8.0.4 et versions antérieures : insertion uniquement.
VVR 8.0.5 et versions ultérieures avec une clé primaire déclarée : insertion, mise à jour et suppression.
VVR 8.0.5 et versions ultérieures sans clé primaire : insertion uniquement.
La livraison exactement une fois (exactly-once) n'est pas prise en charge. L'option
sink.delivery-guaranteeaccepte les valeursnoneouat-least-once.
Recherche SQL (dimension)
Prise en charge disponible à partir de VVR 8.0.5.
À partir de VVR 8.0.9 : les jointures de recherche prennent en charge la lecture du champ intégré
_idde type ObjectId.
SQL
Syntaxe
CREATE TABLE tableName(
  _id STRING,
  [columnName dataType,]*
  PRIMARY KEY(_id) NOT ENFORCED
) WITH (
  'connector' = 'mongodb',
  'hosts' = 'localhost:27017',
  'username' = 'mongouser',
  'password' = '${secret_values.password}',
  'database' = 'testdb',
  'collection' = 'testcoll'
)
Déclarez la colonne _id STRING et spécifiez-la comme clé primaire lors de la création d'une table source CDC.
Options du connecteur
Général
|
Option |
Type |
Obligatoire |
Valeur par défaut |
Description |
|
|
String |
Oui |
— |
Identifiant du connecteur. Pour les tables source : |
|
|
String |
Non |
— |
URI de connexion MongoDB. Spécifiez soit |
|
|
String |
Non |
— |
Nom d'hôte du serveur MongoDB. Séparez plusieurs hôtes par des virgules ( |
|
|
String |
Non |
|
Protocole de connexion. Valeurs valides : |
|
|
String |
Non |
— |
Nom d'utilisateur MongoDB. Requis lorsque l'authentification est activée. |
|
|
String |
Non |
— |
Mot de passe MongoDB. Requis lorsque l'authentification est activée. Utilisez des variables au lieu de coder en dur les identifiants. |
|
|
String |
Non |
— |
Nom de la base de données MongoDB. Prend en charge les expressions régulières pour les tables source. Si ce paramètre n'est pas défini, toutes les bases de données sont surveillées. La surveillance des bases de données |
|
|
String |
Non |
— |
Nom de la collection MongoDB. Prend en charge les expressions régulières pour les tables source. Remarques :
|
|
|
String |
Non |
— |
Options de connexion supplémentaires sous forme de paires Par défaut, le connecteur ne définit pas de délai d'expiration de connexion socket, ce qui peut provoquer de longues interruptions en cas d'instabilité réseau. Définissez |
Source
|
Option |
Type |
Obligatoire |
Valeur par défaut |
Description |
|
|
String |
Non |
|
Mode de démarrage. Valeurs valides : |
|
|
Long |
Conditionnel |
— |
Horodatage de démarrage en millisecondes depuis l'époque UNIX. Requis lorsque |
|
|
Integer |
Non |
|
Taille maximale de la file d'attente pendant la phase de snapshot initial. Ne prend effet que lorsque |
|
|
Integer |
Non |
|
Taille du lot du curseur. |
|
|
Integer |
Non |
|
Nombre maximal de documents de modification extraits par lot lors de la lecture en flux continu. Des valeurs plus élevées allouent un tampon interne plus grand. |
|
|
Integer |
Non |
|
Intervalle entre les requêtes d'extraction de données, en millisecondes. |
|
|
Integer |
Non |
|
Intervalle de heartbeat en millisecondes. Le connecteur envoie des heartbeats pour suivre la dernière position de l'oplog. La définition de cette valeur sur |
|
|
Boolean |
Non |
|
Active la lecture parallèle des snapshots. Fonctionnalité expérimentale. Requiert MongoDB 4.0 ou version ultérieure. |
|
|
Integer |
Non |
|
Taille des chunks pour la lecture parallèle des snapshots, en Mo. Fonctionnalité expérimentale. Ne prend effet que lorsque la lecture parallèle des snapshots est activée. |
|
|
Boolean |
Non |
|
Génère un flux de journal des modifications complet à l'aide des enregistrements preimage et postimage de MongoDB. Fonctionnalité expérimentale. Requiert MongoDB 6.0 ou version ultérieure avec les fonctionnalités preimage et postimage activées. |
|
|
Boolean |
Non |
|
Analyse les champs séparés par |
|
|
Boolean |
Non |
|
Analyse tous les types BSON primitifs comme STRING. Pris en charge dans VVR 8.0.5 et versions ultérieures. |
|
|
Boolean |
Non |
|
Ignore tous les événements DELETE (-D), y compris ceux générés lors de l'archivage des données MongoDB. Pris en charge dans VVR 11.1 et versions ultérieures. |
|
|
Boolean |
Non |
|
Valeurs valides :
Le backfill s'applique uniquement lors de la requête de snapshot d'un seul chunk et ne couvre pas l'intégralité de la phase de lecture complète. Lorsque le backfill est ignoré, la requête de snapshot de chaque chunk lit les dernières données à cet instant ; les mises à jour qui se produisent sur un chunk après sa lecture ne sont pas fusionnées pendant la phase de lecture complète et sont lues depuis l'OpLog après l'entrée en phase incrémentielle. Par exemple, une mise à jour de chunk5 qui se produit pendant le snapshot de chunk5 est reflétée directement dans le snapshot de chunk5 ; si chunk5 est mis à jour après que le lecteur est passé à chunk80, la mise à jour est appliquée ultérieurement depuis l'OpLog pendant la phase incrémentielle. Important
Lorsqu'il est activé, les modifications qui se produisent pendant ou après l'analyse d'un chunk sont toujours transmises depuis l'OpLog en phase incrémentielle et peuvent être dupliquées. Seule la sémantique at-least-once est garantie. Activez cette option uniquement si la destination en aval supporte les écritures idempotentes par clé primaire. Remarque
Pris en charge uniquement dans VVR 11.1 et versions ultérieures. |
|
|
String |
Non |
— |
Opérations de pipeline d'agrégation MongoDB appliquées lors de la lecture des snapshots pour filtrer les données. Spécifiez sous forme de tableau JSON, par exemple : |
|
|
Integer |
Non |
— |
Nombre de threads pour la réplication des snapshots. Ne prend effet que lorsque |
|
|
Integer |
Non |
|
Taille de la file d'attente pour le snapshot initial. Ne prend effet que lorsque |
|
|
Integer |
Non |
|
Nombre de lecteurs simultanés pour le Change Stream. Ne prend effet que lorsque |
|
|
Integer |
Non |
|
Taille de la file d'attente des messages pour les abonnements concurrents au change stream. Ne prend effet que lorsque |
Recherche (dimension)
|
Option |
Type |
Obligatoire |
Valeur par défaut |
Description |
|
|
String |
Non |
|
Politique de cache. Valeurs valides : |
|
|
Integer |
Non |
|
Nombre maximal de tentatives en cas d'échec de la recherche. |
|
|
Duration |
Non |
|
Intervalle entre les tentatives en cas d'échec de la recherche. |
|
|
Duration |
Non |
— |
Durée de vie maximale d'une entrée en cache après le dernier accès. Unités prises en charge : |
|
|
Duration |
Non |
— |
Durée de vie maximale d'une entrée en cache après son écriture. Requiert |
|
|
Long |
Non |
— |
Nombre maximal de lignes dans le cache. Les entrées les plus anciennes sont supprimées lorsque la limite est atteinte. Requiert |
|
|
Boolean |
Non |
|
Met en cache une entrée null lorsqu'une clé de recherche ne correspond à aucun enregistrement. Requiert |
|
String |
Non |
|
Stratégie de conversion utilisée lorsque les valeurs de chaîne Flink sont comparées à la table de dimension MongoDB. Valeurs valides :
Remarque Ce paramètre est pris en charge uniquement dans VVR 11.9 et versions ultérieures. |
Destination
|
Option |
Type |
Obligatoire |
Valeur par défaut |
Description |
|
|
Integer |
Non |
|
Nombre maximal d'enregistrements écrits par lot. |
|
|
Duration |
Non |
|
Intervalle de vidage. |
|
|
String |
Non |
|
Sémantique de livraison en écriture. Valeurs valides : |
|
|
Integer |
Non |
|
Nombre maximal de tentatives en cas d'échec d'écriture. |
|
|
Duration |
Non |
|
Intervalle entre les tentatives en cas d'échec d'écriture. |
|
|
Integer |
Non |
— |
Parallélisme personnalisé pour la destination. |
|
|
String |
Non |
|
Stratégie de gestion des événements -D et -U. Valeurs valides : |
Mappages des types de données
Source
|
Type BSON |
Flink SQL |
|
Int32 |
INT |
|
Int64 |
BIGINT |
|
Double |
DOUBLE |
|
Decimal128 |
DECIMAL(p, s) |
|
Boolean |
BOOLEAN |
|
Date Timestamp |
DATE |
|
Date Timestamp |
TIME |
|
DateTime |
TIMESTAMP(3), TIMESTAMP_LTZ(3) |
|
Timestamp |
TIMESTAMP(0), TIMESTAMP_LTZ(0) |
|
String, ObjectId, UUID, Symbol, MD5, JavaScript, Regex |
STRING |
|
Binary |
BYTES |
|
Object |
ROW |
|
Array |
ARRAY |
|
DBPointer |
ROW\<$ref STRING, $id STRING\> |
|
GeoJSON Point |
ROW\<type STRING, coordinates ARRAY\<DOUBLE\>\> |
|
GeoJSON Line |
ROW\<type STRING, coordinates ARRAY\<ARRAY\<DOUBLE\>\>\> |
Lookup (dimension) et sink
|
Type BSON |
Type Flink SQL |
|
Int32 |
INT |
|
Int64 |
BIGINT |
|
Double |
DOUBLE |
|
Decimal128 |
DECIMAL |
|
Boolean |
BOOLEAN |
|
DateTime |
TIMESTAMP_LTZ(3) |
|
Timestamp |
TIMESTAMP_LTZ(0) |
|
String, ObjectId |
STRING |
|
Binary |
BYTES |
|
Object |
ROW |
|
Array |
ARRAY |
Colonnes de métadonnées
La source SQL prend en charge les colonnes de métadonnées suivantes :
|
Colonne de métadonnées |
Type |
Description |
|
|
STRING NOT NULL |
Base de données contenant le document. |
|
|
STRING NOT NULL |
Collection contenant le document. |
|
|
TIMESTAMP_LTZ(3) NOT NULL |
Horodatage de la modification du document. Renvoie |
|
|
STRING NOT NULL |
Type d'événement de changement : |
Exemples
Source
L'exemple suivant lit les données d'une table source MongoDB avec lecture parallèle du snapshot et journalisation complète activée, puis écrit les champs sélectionnés dans un sink print.
-- CDC source table: reads product data from MongoDB
-- _id must be declared and set as the primary key
CREATE TEMPORARY TABLE mongo_source (
  `_id` STRING,
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price ROW<amount DECIMAL, currency STRING>,
  suppliers ARRAY<ROW<name STRING, address STRING>>,
  db_name STRING METADATA FROM 'database_name' VIRTUAL,
  collection_name STRING METADATA VIRTUAL,
  op_ts TIMESTAMP_LTZ(3) METADATA VIRTUAL,
  PRIMARY KEY(_id) NOT ENFORCED
) WITH (
  'connector' = 'mongodb',
  'hosts' = 'dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,',
  'username' = 'root',
  'password' = '${secret_values.password}',
  'database' = 'flinktest',
  'collection' = 'flinkcollection',
  'scan.incremental.snapshot.enabled' = 'true', -- Enable parallel snapshot reading (requires MongoDB 4.0+)
  'scan.full-changelog' = 'true'                -- Enable full changelog (requires MongoDB 6.0+ with preimage/postimage)
);

CREATE TEMPORARY TABLE productssink (
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price_amount DECIMAL,
  suppliers_name STRING,
  db_name STRING,
  collection_name STRING,
  op_ts TIMESTAMP_LTZ(3)
) WITH (
  'connector' = 'print',
  'logger' = 'true'
);

INSERT INTO productssink
SELECT
  name,
  weight,
  tags,
  price.amount,
  suppliers[1].name,
  db_name,
  collection_name,
  op_ts
FROM mongo_source;
Lookup (dimension)
L'exemple suivant joint un flux de générateur de données à une table de dimension MongoDB à l'aide d'une jointure temporelle.
CREATE TEMPORARY TABLE datagen_source (
  id STRING,
  a INT,
  b BIGINT,
  `proctime` AS PROCTIME()
) WITH (
  'connector' = 'datagen'
);

CREATE TEMPORARY TABLE mongo_dim (
  `_id` STRING,
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price ROW<amount DECIMAL, currency STRING>,
  suppliers ARRAY<ROW<name STRING, address STRING>>,
  PRIMARY KEY(_id) NOT ENFORCED
) WITH (
  'connector' = 'mongodb',
  'hosts' = 'dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,',
  'username' = 'root',
  'password' = '${secret_values.password}',
  'database' = 'flinktest',
  'collection' = 'flinkcollection',
  'lookup.cache' = 'PARTIAL',                           -- Cache lookup results for better performance
  'lookup.partial-cache.expire-after-access' = '10min', -- Evict cached entries after 10 minutes of inactivity
  'lookup.partial-cache.expire-after-write' = '10min',  -- Evict cached entries 10 minutes after write
  'lookup.partial-cache.max-rows' = '100'               -- Maximum 100 rows in the cache
);

CREATE TEMPORARY TABLE print_sink (
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price_amount DECIMAL,
  suppliers_name STRING
) WITH (
  'connector' = 'print',
  'logger' = 'true'
);

INSERT INTO print_sink
SELECT
  T.id,
  T.a,
  T.b,
  H.name
FROM datagen_source AS T
JOIN mongo_dim FOR SYSTEM_TIME AS OF T.`proctime` AS H ON T.id = H._id;
Sink
L'exemple suivant écrit les données d'un générateur de données dans une table sink MongoDB. Une clé primaire est déclarée pour prendre en charge les opérations d'insertion, de mise à jour et de suppression.
CREATE TEMPORARY TABLE datagen_source (
  `_id` STRING,
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price ROW<amount DECIMAL, currency STRING>,
  suppliers ARRAY<ROW<name STRING, address STRING>>
) WITH (
  'connector' = 'datagen'
);

CREATE TEMPORARY TABLE mongo_sink (
  `_id` STRING,
  name STRING,
  weight DECIMAL,
  tags ARRAY<STRING>,
  price ROW<amount DECIMAL, currency STRING>,
  suppliers ARRAY<ROW<name STRING, address STRING>>,
  PRIMARY KEY(_id) NOT ENFORCED -- Declare primary key to enable update and delete
) WITH (
  'connector' = 'mongodb',
  'hosts' = 'dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,dds-bp169b982fc25****.mongodb.rds.aliyuncs.com:3717,',
  'username' = 'root',
  'password' = '${secret_values.password}',
  'database' = 'flinktest',
  'collection' = 'flinkcollection'
);

INSERT INTO mongo_sink SELECT * FROM datagen_source;
Flink CDC (public preview)
Flink CDC vous permet de synchroniser les données MongoDB vers un magasin aval à l'aide d'un pipeline basé sur un script YAML, sans écrire de DDL SQL. Cette fonctionnalité nécessite VVR 11.1 ou version ultérieure.
Syntaxe
source:
   type: mongodb
   name: MongoDB Source
   hosts: localhost:33076
   username: ${mongo.username}
   password: ${mongo.password}
   database: foo_db
   collection: foo_col_.*

sink:
  type: ...
Options de configuration
|
Option |
Required |
Type |
Default |
Description |
|
|
Yes |
STRING |
— |
Le connecteur. Définissez la valeur sur |
|
|
No |
STRING |
|
Protocole de connexion. Valeurs valides : |
|
|
Yes |
STRING |
— |
Nom d'hôte du ou des serveurs MongoDB. Séparez les différents hôtes par des virgules. |
|
|
No |
STRING |
— |
Nom d'utilisateur MongoDB. |
|
|
No |
STRING |
— |
Mot de passe MongoDB. |
|
|
Yes |
STRING |
— |
Nom de la base de données MongoDB à capturer. Les expressions régulières sont prises en charge. |
|
|
Yes |
STRING |
— |
Nom de la collection MongoDB à capturer. Les expressions régulières sont prises en charge. Utilisez l'espace de noms complet |
|
|
No |
STRING |
— |
Options de connexion supplémentaires sous forme de paires |
|
|
No |
STRING |
|
Stratégie d'inférence de schéma. |
|
|
No |
INT |
|
Nombre maximal d'enregistrements à échantillonner par collection lors de l'inférence initiale du schéma. |
|
|
No |
STRING |
|
Mode de démarrage. Valeurs valides : |
|
|
No |
LONG |
— |
Horodatage de démarrage en millisecondes. Requis lorsque |
|
|
No |
INT |
|
Taille maximale des blocs de métadonnées. |
|
|
No |
BOOLEAN |
|
Ferme les lecteurs source inactifs après le passage à la lecture incrémentielle. |
|
|
No |
BOOLEAN |
|
Valeurs valides :
Le remplissage arrière s'applique uniquement lors de la requête d'instantané d'un seul bloc et ne couvre pas l'intégralité de la phase de lecture complète. Lorsque le remplissage arrière est ignoré, la requête d'instantané de chaque bloc lit les dernières données disponibles à cet instant ; les mises à jour intervenant sur un bloc après sa lecture ne sont pas fusionnées durant la phase de lecture complète et sont lues depuis l'OpLog après l'entrée en phase incrémentielle. Par exemple, une mise à jour du bloc chunk5 qui survient pendant la création de l'instantané de chunk5 est directement reflétée dans l'instantané de ce bloc ; si chunk5 est mis à jour après que le lecteur est passé au bloc chunk80, la mise à jour sera appliquée ultérieurement depuis l'OpLog durant la phase incrémentielle. Important
Lorsque cette option est activée, les modifications survenant pendant ou après l'analyse d'un bloc sont toujours transmises depuis l'OpLog en phase incrémentielle et peuvent entraîner des doublons. Seule la sémantique « au moins une fois » (at-least-once) est garantie. N'activez cette option que si le récepteur en aval prend en charge les écritures idempotentes par clé primaire. |
|
|
No |
BOOLEAN |
|
Lit d'abord les blocs non bornés. Réduit le risque de dépassement de mémoire pour les collections fréquemment mises à jour. |
|
|
No |
INT |
|
Taille du lot du curseur. |
|
|
No |
INT |
|
Nombre maximal d'entrées par requête d'extraction du Change Stream. |
|
|
No |
INT |
|
Temps d'attente minimal entre les requêtes d'extraction du Change Stream, en millisecondes. |
|
|
No |
INT |
|
Intervalle des signaux de maintien de connexion (heartbeat) en millisecondes. Configurez ce paramètre pour les collections rarement mises à jour. La valeur |
|
|
No |
INT |
|
Taille des blocs lors de la création d'instantanés, en Mo. |
|
|
No |
INT |
|
Nombre d'échantillons utilisés pour estimer la taille de la collection lors de la création d'instantanés. |
|
|
No |
BOOLEAN |
|
Génère des événements de journal des modifications complets à l'aide des enregistrements preimage et postimage. Nécessite MongoDB 6.0 ou version ultérieure avec les options preimage et postimage activées. |
|
|
No |
BOOLEAN |
|
Désactive le délai d'expiration du curseur. Par défaut, MongoDB ferme les curseurs inactifs après 10 minutes. |
|
|
No |
BOOLEAN |
|
Ignore les événements de suppression provenant de MongoDB. |
|
|
No |
BOOLEAN |
|
Aplatit les documents BSON imbriqués. Par exemple, |
|
|
No |
BOOLEAN |
|
Infère tous les types primitifs comme STRING. Réduit le nombre d'événements de modification de schéma lorsque les types en amont sont incohérents. |
|
|
No |
STRING |
— |
Liste séparée par des virgules des champs de métadonnées à transmettre en aval. Valeurs prises en charge : |
Mappages de types de données
|
MongoDB BSON |
Flink CDC |
Notes |
|
STRING |
VARCHAR |
— |
|
INT32 |
INT |
— |
|
INT64 |
BIGINT |
— |
|
DECIMAL128 |
DECIMAL |
— |
|
DOUBLE |
DOUBLE |
— |
|
BOOLEAN |
BOOLEAN |
— |
|
TIMESTAMP |
TIMESTAMP |
— |
|
DATETIME |
LOCALZONEDTIMESTAMP |
— |
|
BINARY |
VARBINARY |
— |
|
DOCUMENT |
MAP |
Les types de clé et de valeur sont inférés. |
|
ARRAY |
ARRAY |
Les types d'éléments sont inférés. |
|
OBJECTID |
VARCHAR |
Représenté sous forme de chaîne hexadécimale. |
|
SYMBOL, REGULAREXPRESSION, JAVASCRIPT, JAVASCRIPTWITHSCOPE |
VARCHAR |
Représenté sous forme de chaîne. |
Colonnes de métadonnées
Flink CDC prend en charge la colonne de métadonnées suivante pour le connecteur MongoDB :
|
Metadata column |
Type |
Description |
|
|
BIGINT NOT NULL |
Heure de modification du document (horodatage OpLog). Renvoie |
Utilisez les colonnes de métadonnées génériques du module Transform pour accéder à database_name, collection_name et row_kind.
API DataStream
Pour utiliser l'API DataStream, configurez le connecteur DataStream pour votre tâche. Consultez Utilisation du connecteur DataStream.
Ajout de la dépendance Maven
Le référentiel central Maven héberge les connecteurs VVR MongoDB.
<dependency>
    <groupId>com.alibaba.ververica</groupId>
    <artifactId>flink-connector-mongodb</artifactId>
    <version>${vvr.version}</version>
</dependency>
Création d'une source MongoDB
Utilisez MongoDBSource.builder() pour construire une source :
Pour activer la lecture par instantané incrémentiel, utilisez le générateur issu de
com.ververica.cdc.connectors.mongodb.source.Sinon, utilisez le générateur issu de
com.ververica.cdc.connectors.mongodb.
MongoDBSource.builder()
  .hosts("mongo.example.com:27017")
  .username("mongouser")
  .password("mongopasswd")
  .databaseList("testdb")          // Supports regular expressions; use .* to match all databases
  .collectionList("testcoll")      // Supports regular expressions; use .* to match all collections
  .startupOptions(StartupOptions.initial()) // StartupOptions.latest-offset(), StartupOptions.timestamp()
  .deserializer(new JsonDebeziumDeserializationSchema())
  .build();
Paramètres MongoDBSource
|
Paramètre |
Description |
|
|
Nom d'hôte du serveur MongoDB. |
|
|
Nom d'utilisateur MongoDB. Omettez ce paramètre si l'authentification n'est pas activée. |
|
|
Mot de passe MongoDB. Omettez ce paramètre si l'authentification n'est pas activée. |
|
|
Nom de la base de données à surveiller. Les expressions régulières sont prises en charge. Utilisez |
|
|
Nom de la collection à surveiller. Les expressions régulières sont prises en charge. Utilisez |
|
|
Mode de démarrage. Valeurs valides : |
|
|
Désérialiseur permettant de convertir les objets |
Références
Flink CDC (aperçu public) — Synchronisez les modifications de schéma et de données MongoDB vers les tables en aval (VVR 11.1 et versions ultérieures).
Métriques — Surveillez les performances de la table source.