Le moteur de stockage OpenStore (Log Analytics) est un moteur de stockage serverless pour les journaux, développé par l'équipe Alibaba Cloud Elasticsearch. Il prend en charge la facturation au paiement à l'utilisation, basée sur le volume réel de données stockées, ce qui vous dispense de réserver à l'avance la capacité de stockage du cluster. OpenStore va au-delà de l'architecture traditionnelle de séparation des données chaudes et froides, réduisant ainsi la complexité de l'ingestion des données dans le cluster et abaissant le coût de stockage des volumes massifs de données dans le cloud.
Le moteur de stockage OpenStore (Log Analytics) est actuellement disponible dans la région Chine (Hong Kong). La prise en charge d'autres régions sera bientôt assurée.
Contexte
Dans les scénarios d'observabilité des journaux, les exigences métier ou réglementaires imposent souvent une conservation ou un archivage des données à long terme à des fins d'audit. Avec Elasticsearch open source, vous devez séparer les données chaudes et froides au sein du cluster. Vous devez également stocker les données âgées de 30 jours ou plus sur d'autres supports de stockage, tels que Object Storage Service (OSS), via des snapshots de cluster. Cette approche permet d'archiver les données de journalisation à long terme, mais vous ne pouvez pas interroger directement les données stockées. Avant de pouvoir les interroger, vous devez appeler les opérations API pertinentes pour restaurer le snapshot dans le cluster et attendre que les index du snapshot terminent leur initialisation. Par conséquent, les requêtes sont complexes et les coûts de stockage à long terme sont élevés.
OpenStore est une fonctionnalité majeure d'Alibaba Cloud Elasticsearch 7.10 Kernel-enhanced Edition. Combiné au service managé Indexing Service, OpenStore offre des opérations d'écriture hautement concurrentielles à faible coût et une conservation des données à long terme pour les scénarios de journalisation. Vous pouvez créer un cluster 7,10 Kernel-enhanced Edition à la demande et activer le moteur de stockage OpenStore (Log Analytics).
Dans la section Node Visualization de la page Basic Information de votre cluster, vous pouvez vérifier si OpenStore est activé, l'activer et consulter les informations de stockage OpenStore. Pour plus d'informations, consultez la rubrique View cluster status and node information.
Si votre cluster dispose d'OpenStore et du service Indexing Service activés, le service de stockage sous-jacent garantit une haute disponibilité des données pour le cluster. Par conséquent, vous ne pouvez pas configurer la fonctionnalité Auto Snapshot.
Avantages
Stockage massif — OpenStore utilise une facturation de stockage serverless. Vous n'avez pas besoin de planifier ni d'acheter la capacité de stockage à l'avance. L'utilisation réelle du stockage des données est facturée à l'heure et l'utilisation des ressources de stockage atteint 100 %.
Faible coût — Les données peuvent être modifiées en temps réel et prennent en charge les mises à jour lors de l'écriture. Vous n'avez pas besoin de configurer des cycles de vie d'index complexes et la hiérarchisation des données s'effectue automatiquement, ce qui réduit la courbe d'apprentissage. Le prix unitaire du stockage des données est inférieur de 60 % à celui des disques SATA locaux et de 70 % à celui des disques ultra.
Haute disponibilité (HA) — Grâce à l'architecture de découplage du stockage et du calcul, plusieurs réplicas partagent une seule copie des données sans coût de stockage supplémentaire. Le service de stockage sous-jacent garantit une haute disponibilité des données pour le cluster et offre une durabilité des données allant jusqu'à 99,9999999999 % (douze neufs).
Performances de requête améliorées — Pour les tâches courantes de requête et d'analyse dans les scénarios de journalisation typiques, les performances sont améliorées de 100 % par rapport aux disques SATA locaux et sont comparables à celles des disques ultra ou des ESSD PL0.
Limites
Les limites suivantes s'appliquent lors de l'achat et de l'utilisation du stockage OpenStore.
Catégorie | Description |
Région | OpenStore est disponible uniquement dans les régions suivantes. Les régions réellement disponibles s'affichent dans la console :
|
Version du cluster | 9.4.0, 8.17.0, 7.10. |
Spécifications du cluster | Seules les spécifications de stockage OpenStore 8 cœurs 64 Go et 16 cœurs 64 Go sont prises en charge. |
Capacité de stockage du cluster | La capacité maximale de stockage des données par nœud est de 30 To. Remarque Si vous avez besoin d'une capacité de stockage par nœud plus importante, submit a ticket pour faire une demande. Un maximum de 50 To est pris en charge. |
Nombre de réplicas de shard | Lorsque vous activez le moteur de stockage OpenStore (Log Analytics), le nombre de réplicas de shard doit être supérieur ou égal à 1. Avertissement Plusieurs réplicas partagent une seule copie des données sans coût de stockage supplémentaire et garantissent la fiabilité de l'accélération d'écriture du stockage local. Si vous ne configurez pas plusieurs réplicas, certaines données écrites en temps réel peuvent être perdues et ne pourront pas être récupérées. |
Modèle d'index |
Remarque Pour supprimer manuellement un index OpenStore, vous devez supprimer l'index ainsi que son alias correspondant. Sinon, la suppression échoue. |
Configuration du cycle de vie de l'index | Vous ne pouvez pas personnaliser l'étape freeze dans un cycle de vie d'index. |
Limites de requête |
|
Limite de shards du cluster | (Recommandé) Moins de 80 000 shards par cluster. |
Limite de shards par nœud | (Recommandé) Moins de 3 000 shards par nœud. |
Taille par shard | (Recommandé) Moins de 40 Go par shard. |
Débit d'écriture du disque de données | 300 Mo/s lorsque l'utilisation réelle du disque de données est inférieure à 85 % ; 100 Mo/s lorsque l'utilisation réelle du disque de données est supérieure ou égale à 85 %. |
Scénarios
Le moteur de stockage OpenStore (Log Analytics) est développé par Alibaba Cloud Elasticsearch. Il convient aux scénarios tels que la recherche dans les journaux et l'analyse des métriques, qui nécessitent l'écriture et le stockage à long terme de volumes massifs de données. Ces scénarios présentent également un faible nombre de requêtes par seconde (QPS) et une tolérance relativement élevée à la latence des requêtes.
OpenStore est également adapté aux scénarios métier qui nécessitent des mises à jour de données en temps réel et n'imposent pas de séparation stricte entre les données chaudes et froides.
Architecture de stockage hybride
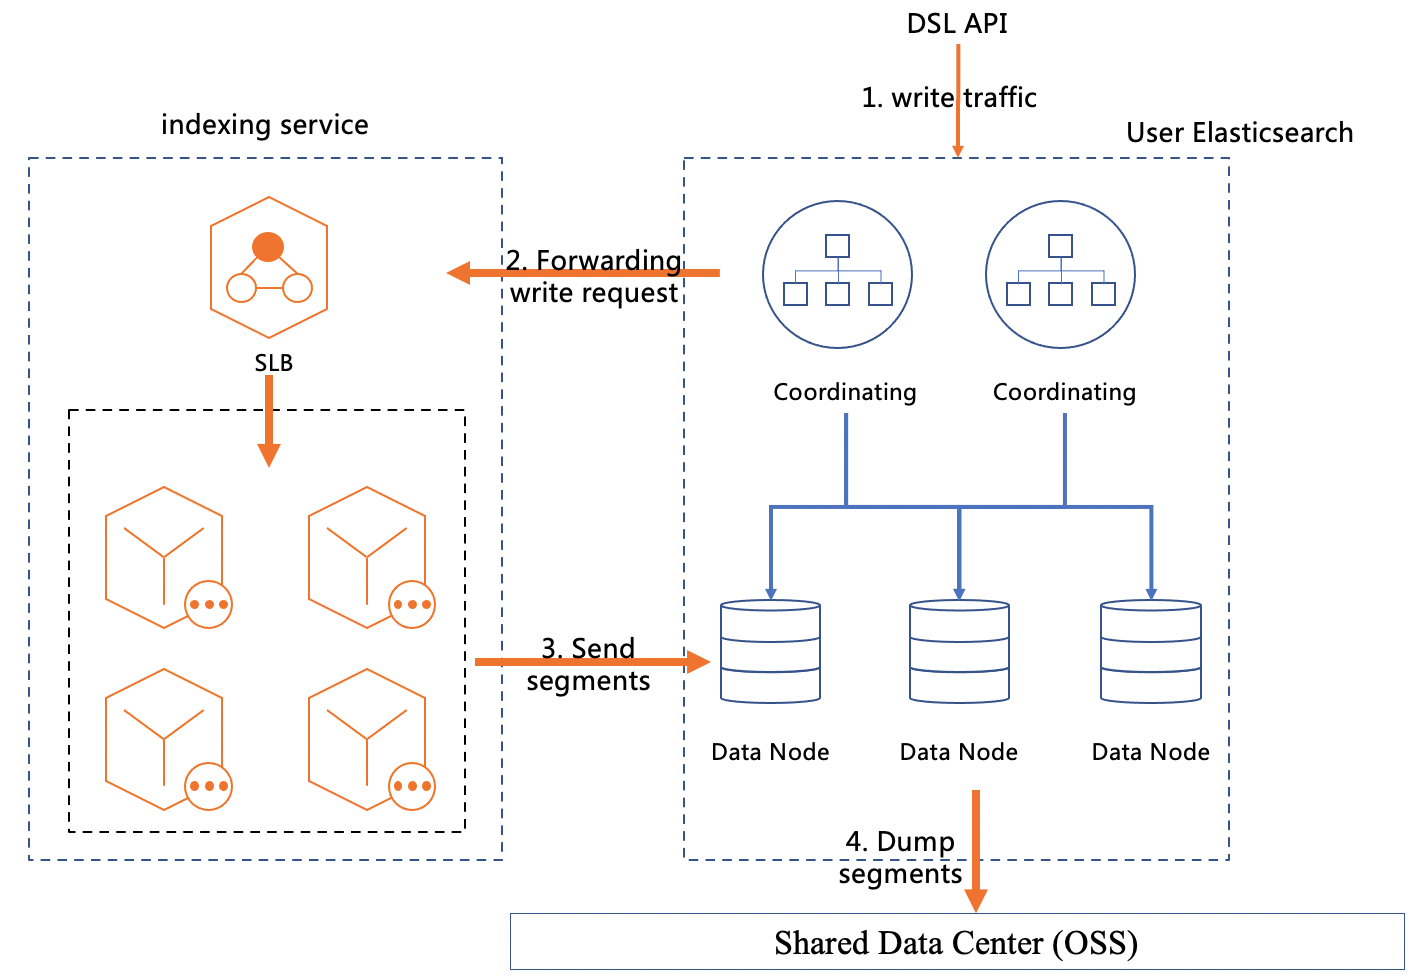
Le moteur de stockage OpenStore (Log Analytics) utilise une architecture de stockage hybride avec découplage du stockage et du calcul. Ses principes de conception architecturale et ses avantages principaux, tels que le découplage du stockage et du calcul, la cohérence des données, la facilité d'utilisation et la haute disponibilité, sont identiques à ceux du moteur de stockage OpenStore. Pour plus d'informations, consultez la rubrique relative au moteur de stockage OpenStore dans le même répertoire.
Test de performance
-
Environnement de test
Jeu de données : un jeu de données issu d'un scénario de journalisation.
-
Spécifications du cluster : tous les clusters utilisent la même configuration pour un scénario de journalisation, où :
Nombre de nœuds : 10
Nombre de shards : 108
-
Conditions de requête :
Type de requête : tri
Nombre de documents : 3 800 000 000
-
Résultats des tests
Type de stockage
Temps de requête
Disque SATA local
Plus de 30 secondes
Disque ultra
12 229 secondes
Stockage OpenStore
15 841 secondes
-
Conclusion du test :
Avec la même configuration de cluster, l'interrogation des données de journal stockées dans OpenStore prend significativement moins de temps que l'interrogation des données stockées sur des disques SATA locaux. Le temps de requête est à peu près équivalent à celui des données stockées sur des disques ultra. Le prix unitaire du stockage OpenStore est environ 60 % inférieur à celui du stockage sur disque ultra. OpenStore utilise également la méthode de facturation au paiement à l'utilisation, ce qui vous dispense d'acheter la capacité de stockage à l'avance. Par conséquent, le stockage OpenStore permet de réduire vos coûts.