Presto (également connu sous le nom de PrestoDB) est un moteur de requêtes SQL distribué conçu pour l'analyse interactive à grande échelle. Alibaba Cloud ne propose pas de produit Presto autonome et vous ne pouvez pas acheter Presto séparément. Presto est fourni en tant que composant de la plateforme big data open source E-MapReduce (EMR) ; vous déployez et utilisez le service Presto au sein d'un cluster EMR. Cette rubrique présente les fonctionnalités clés, l'architecture, le modèle de données et les avantages de Presto sur EMR.
Notes importantes
Les versions 3.45.0 et 5.11.0 ou ultérieures d'E-MapReduce (EMR) prennent en charge Presto, dont le numéro de version est généralement 0.2XX. Dans les versions antérieures d'EMR, le composant Presto portant le numéro de version 3XX utilisait le noyau PrestoSQL ou Trino. Pour plus d'informations, consultez Trino.
Fonctionnalités clés
Écrit en Java, Presto est conçu pour offrir des performances élevées et une mise à l'échelle horizontale. Il offre :
Une prise en charge complète de la norme ANSI SQL.
La connectivité à un large éventail de sources de données, notamment Hive, Hudi, Iceberg, Delta Lake, MySQL et PostgreSQL.
-
La prise en charge de types de données avancés :
Tableaux et maps
Données JSON
Données SIG (Système d'Information Géographique)
Données de couleur
-
L'extensibilité via plusieurs mécanismes :
Connecteurs de données enfichables
Types de données personnalisés
Fonctions SQL personnalisées
Le traitement par pipeline : il renvoie les résultats de requête aux clients de manière incrémentielle au fur et à mesure du traitement des données, ce qui réduit le temps d'attente jusqu'au premier résultat.
-
Une observabilité intégrée :
Une interface utilisateur web permettant de visualiser l'exécution des requêtes en temps réel.
La prise en charge du protocole JMX pour la collecte de métriques.
Architecture
La figure suivante illustre l'architecture du système Presto.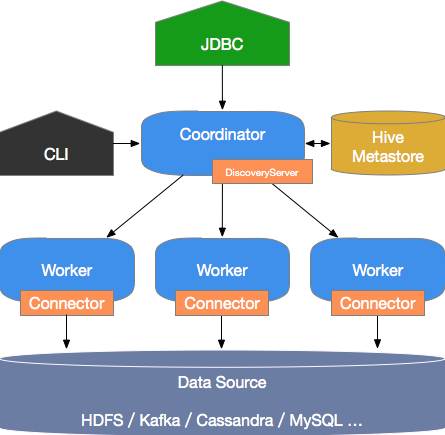
Presto repose sur une architecture coordinateur/travailleur. Un nœud coordinateur gère la planification des requêtes et l'état du cluster, tandis que plusieurs nœuds travailleurs assurent l'exécution distribuée des requêtes.
Le coordinateur est responsable des tâches suivantes :
Accepter et analyser les requêtes, générer des plans d'exécution et distribuer les fragments de plan aux nœuds travailleurs.
Surveiller l'état de santé des nœuds travailleurs. Chaque travailleur maintient une connexion heartbeat avec le coordinateur pour signaler son statut.
Gérer les métadonnées du metastore.
Les nœuds travailleurs exécutent les tâches de requête distribuées. Ils utilisent des connecteurs pour lire et traiter les données provenant de systèmes de stockage externes, puis renvoient les résultats au coordinateur.
Presto ne prend pas actuellement en charge une architecture haute disponibilité (HA). Dans un cluster EMR, le coordinateur s'exécute sur le nœud master-1-1. Les travailleurs s'exécutent sur tous les nœuds Core et Task.
Cas d'utilisation
Presto est optimisé pour les charges de travail analytiques sur de grands ensembles de données. Il convient particulièrement aux scénarios suivants :
Extraction, transformation et chargement (ETL)
Requêtes ad hoc
Analyse à grande échelle de données structurées ou semi-structurées
Agrégation de données multidimensionnelles et génération de rapports
Presto est un moteur d'entrepôt de données. Sa prise en charge des transactions étant limitée, il ne convient pas aux charges de travail de traitement transactionnel en ligne (OLTP).
Avantages de Presto sur EMR
Par rapport à une installation open source de Presto auto-gérée, Presto sur EMR offre :
Une configuration rapide : provisionnez un cluster Presto comptant des centaines de nœuds en quelques minutes.
Une mise à l'échelle élastique nécessitant une configuration minimale.
Une intégration native avec la pile logicielle EMR, y compris Data Lake Formation (DLF), Object Storage Service (OSS) et OSS-HDFS.
Des opérations entièrement gérées : EMR se charge du provisionnement du cluster et des opérations et de la maintenance (O&M), vous permettant ainsi de vous concentrer sur vos requêtes.
Concepts
Modèle de données
Presto organise les données selon une hiérarchie à trois niveaux : catalog, schema et table.
Catalog : contient un ou plusieurs schemas et correspond à une source de données externe accessible via un connecteur. Une seule requête peut s'étendre sur plusieurs catalogs.
Schema : équivalent à une instance de base de données ; contient une ou plusieurs tables.
Table : une table relationnelle standard au sein d'un schema.
Connecteur
Les connecteurs constituent la couche d'intégration entre Presto et les sources de données externes. Presto est livré avec des connecteurs intégrés pour les systèmes courants et expose une SPI standard que vous pouvez implémenter pour connecter des sources de données personnalisées.
Généralement, chaque catalog est lié à un type de connecteur spécifique, défini dans le fichier de propriétés du catalog.
Informations complémentaires
Pour consulter la documentation open source de Presto correspondant à votre version, remplacez XXX dans l'URL https://prestodb.io/docs/XXX/ par le numéro de version de votre composant Presto, puis ouvrez l'URL dans un navigateur.
Par exemple, si votre version de Presto est la 0 279, consultez la documentation Presto 0.279.