Impala permet d'exécuter des requêtes SQL haute performance et à faible latence sur les données stockées dans Apache Hadoop. Il prend en charge les requêtes en temps réel via les fonctions SELECT, JOIN et d'agrégation sur les données présentes dans HDFS ou HBase.
Informations générales
Impala utilise les mêmes métadonnées, syntaxe SQL (Hive SQL) et pilotes ODBC qu'Apache Hive, offrant ainsi une plateforme familière et unifiée pour les requêtes par lots et en temps réel.
Remarque
Si vous utilisez le composant Impala, supprimez les partitions de table Hive à l'aide des commandes Impala ou Hive. Ne supprimez pas directement les répertoires de partition depuis le système de fichiers, sous peine de rendre la table indisponible.
Avantages
Contrairement à MapReduce, Impala utilise un moteur de requête distribué pour accéder directement aux données, à l'instar d'un système de gestion de base de données relationnelle (SGBDR). Selon le type de requête et la configuration, Impala peut s'avérer plusieurs ordres de grandeur plus rapide que Hive.
Impala présente les avantages suivants par rapport aux autres solutions SQL-on-Hadoop :
Le traitement local sur les nœuds de données évite les goulots d'étranglement réseau.
Il élimine la surcharge liée aux conversions de format de données coûteuses.
Il utilise un metastore unique, ouvert et unifié.
Toutes les données sont immédiatement interrogables, sans attendre la fin d'un processus ETL (extraction, transformation et chargement).
Il exploite l'intégralité du matériel pour les requêtes Impala et les tâches MapReduce.
La mise à l'échelle s'effectue au sein d'un seul pool de machines.
Pour plus d'informations sur Impala, consultez Apache Impala.
Architecture
La figure suivante illustre l'architecture d'Impala dans E-MapReduce.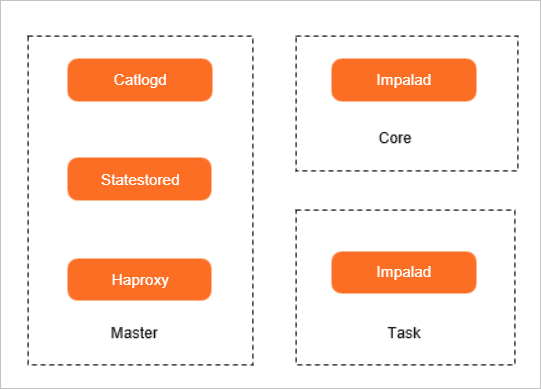
Impala se compose des composants suivants :
-
Impalad
Déployé sur les nœuds core et task. Prend en charge la mise à l'échelle horizontale (scale-out) et la réduction (scale-in).
Le démon Impala (Impalad) est le composant principal d'Impala. Il s'exécute sur chaque nœud, lit et écrit des fichiers de données, et accepte les requêtes provenant de la commande
impala-shell, de Hue, de Java Database Connectivity (JDBC) ou d'ODBC. Impalad parallélise les requêtes, répartit la charge de travail sur le cluster et renvoie les résultats locaux au nœud coordinateur. -
Statestored
Déployé sur la machine master-1-1 du nœud master.
Le service Statestore s'exécute en tant que processus Statestored. Il surveille l'état de santé de tous les processus Impalad du cluster et diffuse leur statut. Si un processus Impalad devient indisponible en raison d'une défaillance du nœud, d'un problème réseau ou logiciel, le Statestore notifie tous les autres processus Impalad afin qu'aucune nouvelle requête ne soit envoyée vers le nœud indisponible.
-
Catalogd
Déployé sur la machine master-1-1 du nœud master.
Catalogd synchronise les modifications de métadonnées de tout processus Impalad vers tous les autres processus Impalad du cluster. Étant donné que toutes les requêtes transitent par Statestore, exécutez Statestore et Catalogd sur le même nœud.