Apache Flume est un système distribué, fiable et hautement disponible. Vous pouvez utiliser Apache Flume pour collecter, agréger et déplacer de grandes quantités de données de journalisation, puis les stocker de manière centralisée. Diverses sources de données sont prises en charge.
Scénarios
Dans la plupart des cas, Flume sert à collecter des données de journalisation. Vous pouvez également personnaliser les sources Flume pour recueillir des événements provenant de diverses sources de données externes.
Flume stocke les données sur une plateforme de calcul en temps réel, une plateforme de calcul hors ligne ou un système de stockage, en vue d'une analyse et d'un nettoyage ultérieurs des données. Une plateforme de calcul en temps réel peut être Flink, Spark Streaming ou Storm. Une plateforme de calcul hors ligne peut être MapReduce, Hive ou Presto. Un système de stockage peut être Hadoop Distributed File System (HDFS), Object Storage Service (OSS), Kafka ou Elasticsearch. 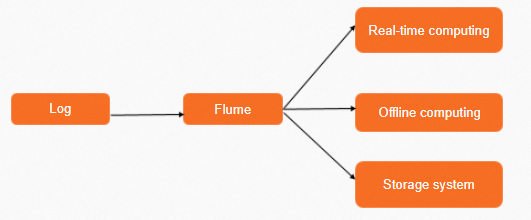
Architecture
Un agent Flume est une instance de Flume. Il s'agit essentiellement d'un processus Java VM (JVM) qui contrôle la transmission des événements des producteurs aux consommateurs. Un agent Flume contient une ou plusieurs sources, canaux et puits. Une source peut se connecter à plusieurs canaux. Un canal peut se connecter à plusieurs puits. 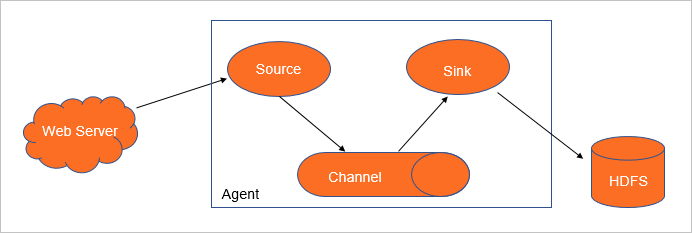
Termes
Terme | Description |
event | L'unité de base des données circulant dans un agent Flume. Un événement est composé d'un tableau d'octets de données et d'un ensemble facultatif d'attributs de chaîne ajoutés sous forme d'en-têtes. Exemple : |
source | Collecteur de données. Il collecte des événements depuis une source de données externe et envoie simultanément plusieurs événements vers un ou plusieurs canaux. Sources courantes :
|
channel | Un canal se situe entre une source et un puits pour mettre en cache les événements. Canaux courants :
|
sink | Récupère les événements depuis un canal et les valide en tant que transactions vers un stockage externe. Une fois qu'un événement est validé dans un stockage externe, il est supprimé du canal. Puits courants :
|