Créez un cluster EMR basé sur Kubernetes pour exécuter des moteurs de big data tels que Spark, Flink et Presto sur ACK.
Prérequis
Les stratégies AliyunOSSFullAccess et AliyunDLFFullAccess vous ont été attribuées. Pour plus d'informations, consultez la rubrique Accorder des autorisations pour accéder à OSS et DLF.
Vous avez créé un cluster Kubernetes. Pour plus d'informations, consultez les rubriques Créer un cluster ACK dédié (obsolète) ou Créer un cluster ACK managé.
Vous avez créé un pool de nœuds. Pour plus d'informations, consultez la rubrique Créer et gérer un pool de nœuds.
Le service Object Storage Service (OSS) est activé. Pour plus d'informations, consultez la rubrique Activer OSS.
Procédure
Connectez-vous à la console EMR on ACK.
Sur la page EMR on ACK, cliquez sur Create Cluster.
-
Sur la page EMR on ACK, configurez les paramètres du cluster.
Paramètre
Description
Region
Région de déploiement du cluster. Ce paramètre est immuable après la création.
Cluster Type
Les types de clusters suivants sont disponibles :
-
Shuffle Service : composant d'extension EMR fournissant un service de shuffle distant. Il permet d'exécuter des tâches Spark sur des nœuds dépourvus de disques locaux et prend en charge l'allocation dynamique des ressources, ce qui le rend idéal pour les clusters Spark dans un environnement ACK. Pour plus d'informations, consultez Celeborn.
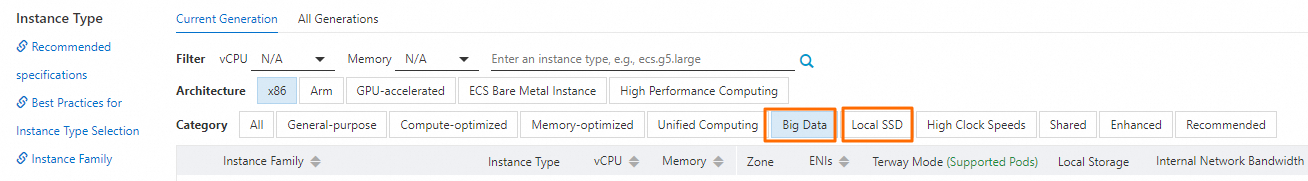
ImportantLors de la création d'un cluster Shuffle Service, la spécification d'instance du pool de nœuds dédié ou des nœuds du cluster ACK associé doit être de type Big Data ou SSD local. Sinon, le déploiement RSS échoue.
 Remarque
Cette tâche optimise la gestion du stockage et évite le gaspillage en supprimant les PVC invalides ou redondants.
-
Presto : moteur SQL distribué en mémoire conçu pour les requêtes interactives.
Il prend en charge plusieurs sources de données et convient à l'analyse à l'échelle du pétaoctet ainsi qu'aux requêtes inter-sources.
-
Spark : moteur de traitement de big data distribué polyvalent, utilisé pour l'ETL, le traitement par lots hors ligne et la modélisation des données.
ImportantPour associer un cluster Spark à un cluster Shuffle Service, leurs versions majeures de produit doivent correspondre. Par exemple, un cluster Spark de version EMR-5.x-ack ne peut être associé qu'à un cluster Shuffle Service de version EMR-5.x-ack.
-
Flink : moteur de traitement distribué pour les calculs avec état sur des flux de données bornés et non bornés. Basé sur EMR on ACK et sur l'opérateur communautaire Flink Kubernetes Operator 1.0.1, Flink on ACK utilise par défaut le noyau entreprise fourni par l'équipe officielle Flink, offrant ainsi une expérience Flink on Kubernetes prête à l'emploi.
Product Version
La dernière version logicielle est sélectionnée par défaut.
Component Version
Liste des composants et des versions inclus dans le type de cluster sélectionné.
ACK cluster
Sélectionnez un cluster ACK existant ou créez-en un nouveau dans la console Container Service for Kubernetes (ACK).
Cliquez sur Configure Dedicated Nodes pour configurer les nœuds dédiés à EMR. Cette opération applique des taints et des libellés spécifiques à EMR à un pool de nœuds ou à des nœuds individuels, afin de les réserver exclusivement à EMR.
RemarqueNous vous recommandons de configurer les nœuds dédiés via un pool de nœuds. Si aucun pool de nœuds n'est disponible, créez-en un. Pour plus d'informations, consultez la rubrique Créer un pool de nœuds.
OSS bucket
Sélectionnez un bucket existant ou créez-en un nouveau dans la console Object Storage Service (OSS).
Cluster Name
Le nom doit comporter entre 1 et 64 caractères et ne peut contenir que des caractères chinois, des lettres, des chiffres, des traits d'union (-) et des underscores (_).
-
-
Cliquez sur create.
Le cluster est prêt lorsque son statut passe à Running.