cGPU est une technologie de partage de GPU basée sur le noyau, développée par Alibaba Cloud, qui permet à plusieurs conteneurs isolés de partager un seul GPU physique. En virtualisant les ressources GPU en vGPU au niveau du pilote du noyau, cGPU garantit l'isolation de la mémoire GPU et de la puissance de calcul pour chaque conteneur, sans compromettre les performances. Cette approche améliore l'utilisation du matériel et réduit les coûts d'infrastructure GPU.
Fonctionnement
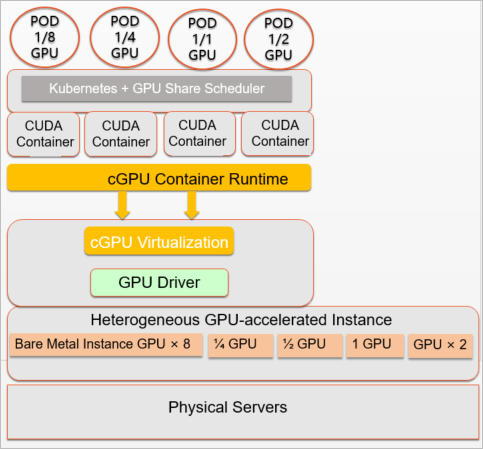
Le pilote du noyau d'Alibaba Cloud crée des périphériques vGPU pour chaque conteneur s'exécutant sur le GPU partagé. Le pilote assure l'isolation au niveau de la mémoire GPU et de la couche de calcul, empêchant ainsi les conteneurs d'interférer avec les charges de travail des autres. Il devient alors possible d'exécuter simultanément plusieurs tâches d'entraînement ou d'inférence sur un seul GPU.
Fonctionnalités
Isolation et contrôle des ressources
Isolation de la mémoire GPU : Allouez la mémoire GPU avec une granularité au niveau du Mo, appliquée par conteneur.
Isolation de la puissance de calcul : Définissez l'utilisation du GPU par conteneur et configurez un ratio de puissance de calcul minimal aussi bas que 2 %.
Préemption : Les tâches prioritaires peuvent préempter celles de priorité inférieure afin de garantir les objectifs de niveau de service.
Compatibilité
Fonctionne avec Docker, containerd et Kubernetes sans modifier vos applications d'IA.
Aucune recompilation du code ni remplacement des bibliothèques Compute Unified Device Architecture (CUDA) n'est nécessaire.
Types d'instance pris en charge
cGPU prend en charge les instances Bare Metal Elastic Compute Service (ECS) accélérées par GPU, les instances virtualisées et les instances accélérées par vGPU.
Opérations
Mise à niveau à chaud : Mettez à niveau le pilote du noyau sans interrompre les charges de travail en cours d'exécution.
Allocation multi-GPU : Assignez plusieurs vGPU à un seul conteneur.
**Surveillance et gestion : Des capacités élevées d'exploitation et de maintenance permettent de suivre et de gérer l'utilisation des ressources GPU.
Cas d'utilisation
Colocalisation des charges de travail en ligne et hors ligne : Exécutez des services en ligne sensibles à la latence et des travaux batch hors ligne sur le même GPU pour maximiser l'utilisation.
Entraînement et inférence IA : Isolez plusieurs tâches d'entraînement ou d'inférence basées sur CUDA sur un seul GPU avec des limites de ressources garanties.
Rendu : Partagez les ressources GPU entre les tâches de rendu dans des environnements multi-locataires.