Elastic GPU Service met à votre disposition des instances accélérées par GPU offrant une densité de calcul élevée, un réseau à faible latence et une facturation flexible. Le service inclut également DeepGPU, une boîte à outils gratuite qui accélère les charges de travail d'entraînement et d'inférence sans nécessiter de modification du code.
Elastic GPU Service
Déploiement mondial dans 17 régions. Déployez des instances accélérées par GPU à grande échelle dans 17 régions à travers le monde. Le provisionnement automatique et l'Auto Scaling gèrent les pics de demande soudains sans intervention manuelle.
Jusqu'à 1 000 TFLOPS en précision mixte. Associées à une plateforme CPU haute performance, les instances accélérées par GPU offrent jusqu'à 1 000 billions d'opérations en virgule flottante par seconde (TFLOPS) en calcul de précision mixte. Cette puissance suffit à l'entraînement de grands modèles de langage (LLM) à grande échelle et à l'inférence à haut débit.
Réseau à deux niveaux pour tous les types de charge de travail. Chaque instance accélérée par GPU se connecte à un VPC avec une bande passante interne allant jusqu'à 32 Gbit/s et un débit de 4,5 millions de paquets par seconde (Mpps) pour les charges de travail générales. Pour les tâches d'entraînement distribué, associez les instances au Super Computing Cluster (SCC) afin d'ajouter jusqu'à 50 Gbit/s de bande passante Remote Direct Memory Access (RDMA) entre les nœuds, évitant ainsi que la synchronisation des gradients ne devienne un goulot d'étranglement.
Une facturation adaptée à votre usage. Choisissez parmi l'abonnement, le paiement à l'utilisation, les instances préemptibles, les instances réservées et les unités de capacité de stockage (SCU) pour adapter la solution à votre modèle de coûts. Combinez les méthodes de facturation pour couvrir à la fois les charges de travail stables et les pics d'activité.
DeepGPU
DeepGPU est une boîte à outils gratuite qui accélère les charges de travail GPU sur Elastic GPU Service. Elle comprend Deepytorch, AIACC-ACSpeed (ACSpeed), AIACC-AGSpeed (AGSpeed), FastGPU et cGPU.
FastGPU
FastGPU est un outil de déploiement de cluster qui automatise la configuration de l'infrastructure. Vous pouvez ainsi exécuter des tâches d'entraînement et d'inférence IA sans avoir à provisionner manuellement les ressources de calcul, de stockage ou de réseau.
Clusters prêts en 5 minutes. FastGPU déploie un cluster entièrement configuré en 5 minutes. Toutes les ressources sont provisionnées au niveau de l'infrastructure et sont directement accessibles pour le débogage.
Cycle de vie des ressources lié au cycle de vie des tâches. FastGPU libère automatiquement les instances accélérées par GPU lorsqu'une tâche d'entraînement ou d'inférence se termine. Les instances préemptibles sont prises en charge pour réduire les coûts.
Observabilité complète. FastGPU fournit la visualisation, la gestion des journaux et le suivi des tâches, garantissant ainsi l'auditabilité de chaque exécution.
cGPU
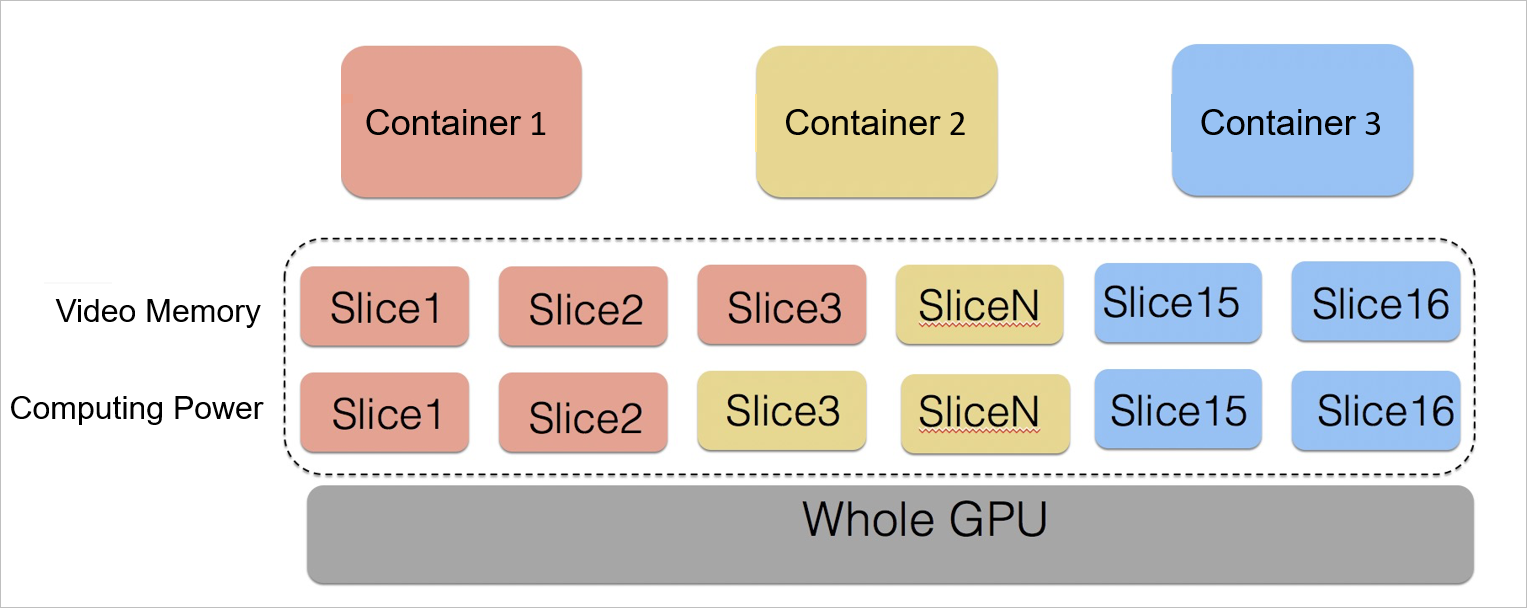
cGPU permet à plusieurs conteneurs de partager un seul GPU physique avec une isolation stricte des ressources, améliorant ainsi l'utilisation du GPU, réduisant les coûts et renforçant la sécurité.
Partagez un GPU entre plusieurs conteneurs sans exposer les données métier. La plupart des charges de travail IA ne nécessitent pas un GPU entier. cGPU alloue les ressources GPU entre les conteneurs tout en isolant les données de chaque conteneur, de sorte que vous ne payez que pour la mémoire GPU et la puissance de calcul réellement utilisées par chaque charge de travail.
Allocation flexible selon la mémoire GPU ou la puissance de calcul. Allouez des ressources en fonction des ratios de mémoire GPU ou de puissance de calcul pour répondre aux exigences de chaque conteneur.
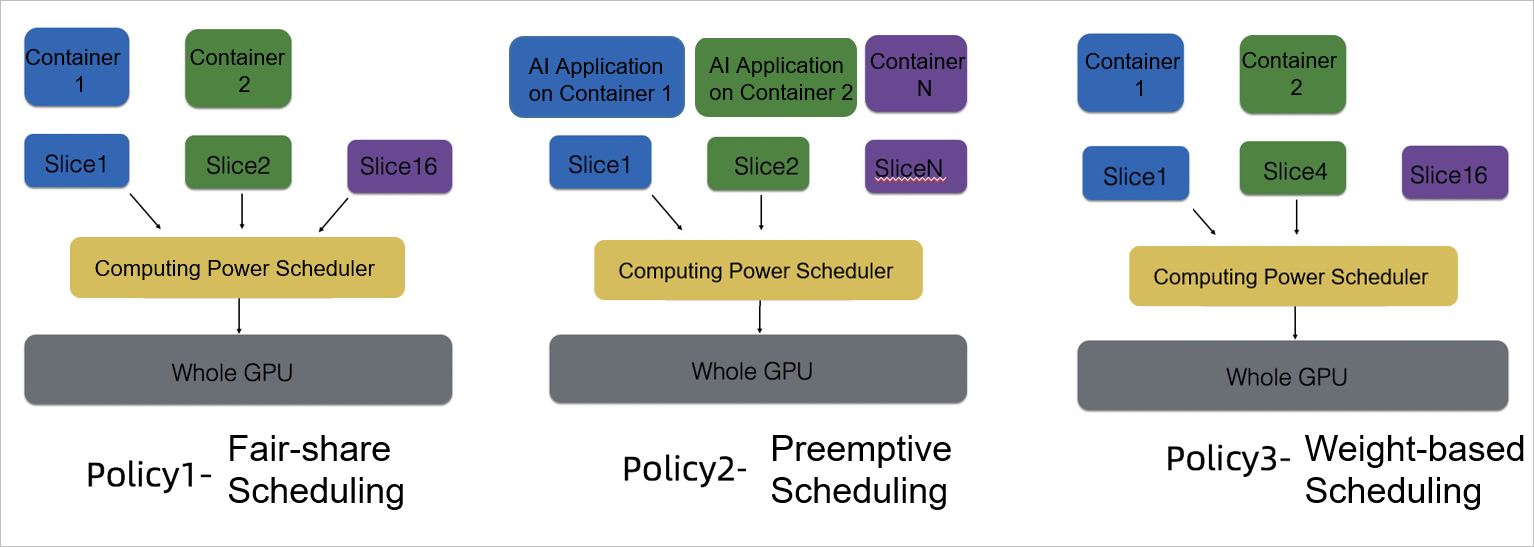
Three switchable scheduling policies for peak and off-peak hours. Basculez en temps réel entre trois politiques d'allocation de puissance de calcul pour adapter l'intensité de la charge de travail, sans aucun redémarrage nécessaire.