Utilisez Data Transmission Service (DTS) pour mettre en place un pipeline de données continu entre ApsaraDB RDS for PostgreSQL et AnalyticDB for PostgreSQL. DTS gère à la fois le chargement initial complet et la capture continue des données incrémentielles (CDC) via la réplication logique, afin que votre base de données analytique reste synchronisée avec les modifications apportées aux données source.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Une instance AnalyticDB for PostgreSQL dont l'espace de stockage disponible est supérieur à la taille totale des données de l'instance RDS for PostgreSQL source. Consultez la rubrique Créer une instance.
Une base de données créée dans l'instance AnalyticDB for PostgreSQL de destination pour recevoir les données synchronisées. Reportez-vous à la section CREATE DATABASE de la rubrique Syntaxe SQL.
Un compte privilégié sur l'instance RDS for PostgreSQL source, propriétaire de la base de données. Consultez les rubriques Créer un compte et Créer une base de données.
Un compte de base de données sur l'instance AnalyticDB for PostgreSQL de destination disposant des autorisations de lecture et d'écriture. Un compte initial ou un compte doté de l'autorisation RDS_SUPERUSER convient également. Consultez les rubriques Créer un compte de base de données et Gérer les utilisateurs et les autorisations.
Facturation
| Type de synchronisation | Frais |
|---|---|
| Synchronisation du schéma et synchronisation complète des données | Gratuit |
| Synchronisation incrémentielle des données | Facturé. Consultez la rubrique Présentation de la facturation. |
Opérations SQL prises en charge pour la synchronisation incrémentielle
| Type d'opération | Instructions SQL |
|---|---|
| DML | INSERT, UPDATE, DELETE |
| DDL | CREATE TABLE, DROP TABLE, TRUNCATE TABLE (base de données PostgreSQL auto-gérée source version 11+), CREATE INDEX ON TABLE et opérations ALTER TABLE, notamment RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK et ALTER COLUMN DROP DEFAULT |
Exigences relatives à la synchronisation DDL :
La synchronisation DDL n'est disponible que pour les tâches créées après le 1er octobre 2020.
Pour les tâches créées avant le 12 mai 2023, configurez des déclencheurs et des fonctions dans la base de données source avant de configurer la tâche. Consultez la rubrique Utiliser des déclencheurs et des fonctions pour implémenter la migration DDL incrémentielle pour les bases de données PostgreSQL.
La synchronisation DDL nécessite un compte de base de données privilégié sur l'instance source et une version mineure du moteur 20210228 ou ultérieure. Consultez la rubrique Mettre à jour la version mineure du moteur.
Vous ne pouvez pas synchroniser les données de type BIT lors de la synchronisation incrémentielle des données.
Les opérations DDL suivantes ne sont pas synchronisées :
Les instructions DDL incluant des modificateurs supplémentaires tels que CASCADE ou RESTRICT
Les instructions DDL provenant de sessions exécutant
SET session_replication_role = replicaLes instructions DDL invoquées via des fonctions
Les instructions DDL validées dans la même transaction que les instructions DML
Les instructions DDL portant sur des objets non inclus dans le périmètre de synchronisation
Limites
Exigences relatives aux tables et aux schémas
-
Les tables doivent posséder une contrainte PRIMARY KEY ou UNIQUE avec tous les champs uniques. Sans cela, la base de données de destination peut contenir des enregistrements en double.
RemarqueSi vous créez une table de destination en dehors de DTS (sans sélectionner Schema Synchronization pour Synchronization Types), assurez-vous que la table de destination possède les mêmes contraintes PRIMARY KEY ou NOT NULL UNIQUE que la table source.
Seules les tables peuvent être sélectionnées comme objets de synchronisation, et non les vues, les fonctions ou d'autres types d'objets.
Une tâche ne peut synchroniser les données que d'une seule base de données. Pour synchroniser plusieurs bases de données, créez une tâche distincte pour chacune d'elles.
Les tables ayant des relations d'héritage entre différents schémas ne peuvent pas être synchronisées.
La table de destination ne peut pas être une table optimisée pour l'ajout (AO).
DTS ne synchronise pas les types de données suivants : VARBIT, GEOMETRY, UUID, TSQUERY, TSVECTOR et TXID_SNAPSHOT.
Mappage des colonnes et différences de schéma
Si vous utilisez le mappage de colonnes pour une synchronisation partielle des tables, ou si les schémas des tables source et de destination diffèrent, les données des colonnes présentes dans la source mais absentes dans la destination seront perdues.
Si vous renommez des tables ou des colonnes dans la base de données de destination à l'aide de la fonctionnalité de mappage des noms d'objets, la synchronisation de plus de 5 000 tables dans une seule tâche provoque une erreur de requête. Pour les tables dépassant ce nombre, configurez plusieurs tâches ou synchronisez des bases de données entières.
Exigences relatives aux journaux WAL
La base de données source doit respecter les exigences suivantes en matière de journalisation préalable à l'écriture (WAL) :
Définissez
wal_levelsurlogical.Pour une synchronisation uniquement incrémentielle : conservez les journaux WAL pendant plus de 24 heures.
Pour une synchronisation complète puis incrémentielle : conservez les journaux WAL pendant au moins 7 jours. Une fois la synchronisation complète terminée, vous pouvez définir la période de rétention sur plus de 24 heures.
Le non-respect de ces exigences peut empêcher DTS d'obtenir les journaux WAL, entraînant l'échec de la tâche ou, dans des cas exceptionnels, une incohérence ou une perte de données.
Contraintes d'exécution
N'exécutez pas d'instructions DDL pendant la synchronisation du schéma ou la synchronisation complète des données, sous peine d'échec de la tâche.
-
Si vous ajoutez une table à un schéma synchronisé ou renommez une table à l'aide de RENAME, exécutez
ALTER TABLE schema.table REPLICA IDENTITY FULL;avant d'écrire des données dans la table. Cela permet d'éviter toute incohérence des données. Effectuez cette opération pendant les heures creuses pour éviter les interblocages.RemarqueRemplacez
schemaettablepar le nom réel du schéma et le nom de la table. Ne supprimez pas les tables temporaires créées par DTS dans la base de données source :
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionetpublic.aliyun_dts_instance. DTS supprime automatiquement ces tables lors de la libération de l'instance.Les transactions de longue durée dans la base de données source peuvent provoquer une accumulation des journaux WAL et épuiser l'espace disque.
Si la base de données source fait l'objet d'une mise à niveau majeure de version pendant l'exécution de la tâche, celle-ci échoue et ne peut pas être récupérée. Reconfigurez la tâche.
Une modification unique de données incrémentielles ne doit pas dépasser 256 Mo. Si tel est le cas, la tâche échoue et ne peut pas être récupérée. Reconfigurez la tâche.
Slots de réplication
DTS crée un slot de réplication préfixé par dts_sync_ dans la base de données source. Ce slot conserve les journaux incrémentiels des 15 dernières minutes.
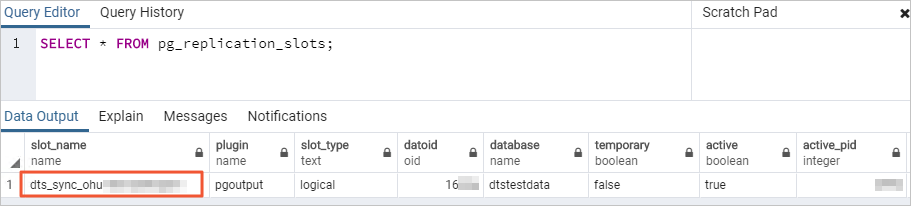
Le slot de réplication est automatiquement supprimé lorsque l'instance DTS est libérée. Si vous modifiez le mot de passe de la base de données source ou retirez les adresses IP de DTS de la liste d'autorisation, le slot ne peut pas être supprimé automatiquement ; supprimez-le manuellement pour éviter toute accumulation.
Si la tâche est libérée ou échoue, DTS supprime automatiquement le slot de réplication. Après un basculement primaire/secondaire sur la base de données PostgreSQL source, connectez-vous à la base de données secondaire pour supprimer manuellement le slot de réplication.
DTS ajoute également une table de heartbeat nommée dts_postgres_heartbeat à la base de données source pour suivre la latence de synchronisation.
Contraintes spécifiques à la source
ApsaraDB RDS for PostgreSQL :
Ne modifiez pas le point de terminaison ni la zone de l'instance RDS for PostgreSQL source pendant l'exécution de la tâche, sous peine d'échec de celle-ci.
Pour effectuer un basculement primaire/secondaire sur l'instance source, activez d'abord la fonctionnalité Logical Replication Slot Failover. Consultez la rubrique Logical Replication Slot Failover.
PostgreSQL auto-géré :
Définissez
max_wal_sendersetmax_replication_slotssur des valeurs supérieures à la somme des slots de réplication existants et du nombre d'instances DTS à créer.Un basculement primaire/secondaire sur une base de données PostgreSQL auto-gérée entraîne l'échec de la tâche.
Google Cloud SQL for PostgreSQL :
-
Définissez le paramètre Database Account sur un compte disposant de l'autorisation
cloudsqlsuperuser. Lors de la sélection des objets à synchroniser, choisissez uniquement les objets que le compte est autorisé à gérer, ou accordez l'autorisation OWNER sur ces objets au compte.RemarqueUn compte disposant de l'autorisation
cloudsqlsuperuserne peut pas gérer les données appartenant à d'autres comptes dotés de la même autorisation.
Cohérence des données
Évaluez l'impact sur les performances des bases de données source et de destination avant de démarrer la tâche. Exécutez la tâche pendant les heures creuses.
Lors de la synchronisation complète des données, les opérations INSERT simultanées créent une fragmentation des tables dans la base de données de destination ; ainsi, l'espace de table de destination peut être plus grand que celui de la source une fois la synchronisation complète terminée.
Une incohérence des données survient si des données provenant de sources autres que DTS sont écrites dans la base de données de destination pendant la synchronisation. Si vous utilisez Data Management (DMS) pour effectuer des opérations DDL en ligne pendant que d'autres sources écrivent dans la destination, une perte de données peut se produire.
Si vous n'utilisez que DTS pour écrire des données dans la destination, utilisez DMS pour effectuer des opérations DDL en ligne sur les tables sources pendant la synchronisation. Consultez la rubrique Modifier les schémas sans verrouiller les tables.
Récupération des tâches
En cas d'échec d'une tâche DTS, le support technique DTS tente une récupération dans un délai de 8 heures. Pendant la récupération, la tâche peut être redémarrée et les paramètres de la tâche (et non ceux de la base de données) peuvent être modifiés. Pour plus de détails sur les paramètres susceptibles de changer, consultez la section Modifier les paramètres de l'instance de la rubrique Modifier les paramètres d'une instance DTS.
Configurer une tâche de synchronisation des données
Étape 1 : Accéder aux tâches de synchronisation des données
Connectez-vous à la console Data Management (DMS).
Dans la barre de navigation supérieure, cliquez sur Data + AI.
-
Dans le volet de navigation de gauche, choisissez DTS (DTS) > Data Synchronization.
RemarqueLa navigation peut varier selon le mode et la disposition de la console DMS. Consultez les rubriques Mode simple et Personnaliser la disposition et le style de la console DMS.
Vous pouvez également accéder directement à la page Tâches de synchronisation des données de la nouvelle console DTS.
Étape 2 : Créer une tâche
-
À droite de Data Synchronization Tasks, sélectionnez la région où résidera l'instance de synchronisation.
RemarqueDans la nouvelle console DTS, sélectionnez la région dans la barre de navigation supérieure.
Cliquez sur Create Task.
-
(Facultatif) Cliquez sur New Configuration Page dans le coin supérieur droit.
RemarqueIgnorez cette étape si Back to Previous Version s'affiche à la place.
Utilisez la nouvelle page de configuration, car certains paramètres diffèrent selon les versions.
Étape 3 : Configurer les bases de données source et de destination
Configurez les paramètres suivants :
Task name
| Paramètre | Description |
|---|---|
| Task Name | Nom de la tâche DTS. DTS génère un nom par défaut ; spécifiez un nom descriptif pour identifier facilement la tâche. Le nom n'a pas besoin d'être unique. |
Source database
| Paramètre | Description |
|---|---|
| Select a DMS database instance. | Sélectionnez une base de données enregistrée existante pour remplir automatiquement les paramètres, ou laissez vide et configurez manuellement. Pour enregistrer une base de données, consultez les rubriques Enregistrer une instance de base de données Alibaba Cloud ou Enregistrer une base de données hébergée sur un service cloud tiers ou une base de données auto-gérée. Pour l'enregistrement dans la console DTS, consultez la rubrique Gérer les connexions aux bases de données. |
| Database Type | Sélectionnez PostgreSQL. |
| Access Method | Sélectionnez Alibaba Cloud Instance. |
| Instance Region | Région de l'instance RDS for PostgreSQL source. |
| Replicate Data Across Alibaba Cloud Accounts | Sélectionnez No pour utiliser une base de données du compte actuel. |
| Instance ID | ID de l'instance RDS for PostgreSQL source. |
| Database Name | Nom de la base de données source contenant les données à synchroniser. |
| Database Account | Compte privilégié de l'instance source. |
| Database Password | Mot de passe du compte de base de données. |
| Encryption | Sélectionnez Non-encrypted pour une connexion standard, ou SSL-encrypted pour une connexion chiffrée. Pour SSL, téléchargez le CA Certificate, et éventuellement le Client Certificate et la Private Key of Client Certificate, puis définissez Private Key Password of Client Certificate. Consultez la rubrique Chiffrement SSL. |
Destination database
| Paramètre | Description |
|---|---|
| Select a DMS database instance. | Sélectionnez une base de données enregistrée existante pour remplir automatiquement les paramètres, ou configurez manuellement. |
| Database Type | Sélectionnez AnalyticDB for PostgreSQL. |
| Access Method | Sélectionnez Alibaba Cloud Instance. |
| Instance Region | Région de l'instance AnalyticDB for PostgreSQL de destination. |
| Instance ID | ID de l'instance AnalyticDB for PostgreSQL de destination. |
| Database Name | Nom de la base de données de destination. |
| Database Account | Compte de l'instance de destination, disposant des autorisations de lecture et d'écriture. |
| Database Password | Mot de passe du compte de base de données. |
Étape 4 : Tester la connectivité
Cliquez sur Test Connectivity and Proceed.
DTS ajoute automatiquement ses blocs CIDR de serveur aux listes d'autorisation des instances de base de données Alibaba Cloud et aux règles de groupe de sécurité des bases de données hébergées sur ECS. Pour les bases de données auto-gérées dans des centres de données ou sur des plateformes cloud tierces, ajoutez manuellement les blocs CIDR du serveur DTS à la liste d'autorisation de la base de données. Consultez la rubrique Blocs CIDR des serveurs DTS.
L'ajout de blocs CIDR DTS aux listes d'autorisation ou aux groupes de sécurité comporte des risques de sécurité. Avant de poursuivre, prenez des mesures préventives telles que l'application de mots de passe robustes, la limitation des ports exposés, l'authentification des appels API, l'audit régulier des règles de liste d'autorisation et l'utilisation d'Express Connect, VPN Gateway ou Smart Access Gateway pour connecter la base de données à DTS.
Étape 5 : Configurer les objets de synchronisation
Choisir les types de synchronisation
Sélectionnez les types de synchronisation adaptés à votre cas d'utilisation :
| Type de synchronisation | Quand sélectionner |
|---|---|
| Schema Synchronization | Sélectionnez cette option pour que DTS crée automatiquement les tables de destination. Requis lorsque vous sélectionnez également Full Data Synchronization. |
| Full Data Synchronization | Sélectionnez cette option pour copier toutes les données existantes de la source vers la destination avant le début de la synchronisation incrémentielle. Requis pour la configuration initiale. |
| Incremental Data Synchronization | Sélectionné par défaut. Maintient la destination synchronisée avec les modifications continues de la source via la réplication logique. Requis pour une synchronisation continue. |
Pour la plupart des configurations, sélectionnez les trois options : la synchronisation du schéma crée les tables, la synchronisation complète des données copie les données historiques et la synchronisation incrémentielle des données maintient la destination à jour.
Configurer les objets et la gestion des conflits
| Paramètre | Description |
|---|---|
| DDL and DML Operations to Be Synchronized | Opérations SQL à synchroniser. Pour configurer par table, faites un clic droit sur un objet dans Selected Objects et sélectionnez les opérations. Consultez la rubrique Opérations SQL prenant en charge la synchronisation incrémentielle. |
| Processing Mode of Conflicting Tables | Precheck and Report Errors : échoue la vérification préalable si les tables de destination partagent des noms avec les tables source. Utilisez le mappage des noms d'objets pour résoudre les conflits. Ignore Errors and Proceed : ignore la vérification des conflits de noms. Lors de la synchronisation complète, les enregistrements de destination existants avec des clés primaires ou uniques correspondantes sont conservés ; lors de la synchronisation incrémentielle, ils sont écrasés. Si les schémas diffèrent, l'initialisation peut échouer partiellement. |
| Capitalization of Object Names in Destination Instance | Façon dont DTS gère la casse des noms de bases de données, de tables et de colonnes dans la destination. La valeur par défaut est DTS default policy. Consultez la rubrique Spécifier la casse des noms d'objets dans l'instance de destination. |
| Source Objects | Sélectionnez des objets dans cette section et cliquez sur  pour les ajouter à Selected Objects. Granularité sélectionnable : colonnes, tables ou schémas. |
| Selected Objects | Faites un clic droit sur une table pour la renommer, définir des filtres de données ou configurer des opérations SQL par table. Pour renommer plusieurs objets à la fois, cliquez sur Batch Edit. Consultez les rubriques Mapper les noms d'objets et Définir les conditions de filtrage. |
Le renommage d'un objet à l'aide du mappage des noms d'objets peut entraîner l'échec de la synchronisation des objets dépendants.
Configurer les paramètres avancés
Cliquez sur Next: Advanced Settings et configurez les paramètres suivants :
| Paramètre | Description |
|---|---|
| Dedicated Cluster for Task Scheduling | DTS utilise un cluster partagé par défaut. Achetez un cluster dédié pour une stabilité accrue. Consultez la rubrique Qu'est-ce qu'un cluster dédié DTS ?. |
| Retry Time for Failed Connections | Durée pendant laquelle DTS réessaie les connexions échouées après le démarrage de la tâche. Plage : 10–1440 minutes. Par défaut : 720 minutes. Définissez une valeur supérieure à 30 minutes. Si DTS se reconnecte dans ce délai, la tâche reprend ; sinon, elle échoue. La valeur la plus courte parmi les tâches partageant la même source ou la même destination s'applique. |
| Retry Time for Other Issues | Durée pendant laquelle DTS réessaie les opérations DDL ou DML échouées. Plage : 1–1440 minutes. Par défaut : 10 minutes. Définissez une valeur supérieure à 10 minutes et inférieure à Retry Time for Failed Connections. |
| Enable Throttling for Full Data Synchronization | Limite la charge de lecture/écriture sur les bases de données source et de destination pendant la synchronisation complète. Configurez Queries per second (QPS) to the source database, RPS of Full Data Migration et Data migration speed for full migration (MB/s). Disponible uniquement lorsque Full Data Synchronization est sélectionné. |
| Enable Throttling for Incremental Data Synchronization | Limite la charge pendant la synchronisation incrémentielle. Configurez RPS of Incremental Data Synchronization et Data synchronization speed for incremental synchronization (MB/s). |
| Environment Tag | Tag facultatif pour identifier l'instance DTS par environnement. |
| Configure ETL | Définissez sur Yes pour activer le traitement extract, transform, and load (ETL) et saisir les instructions de transformation des données. Définissez sur No pour ignorer. Consultez les rubriques Qu'est-ce que l'ETL ? et Configurer l'ETL dans une tâche de migration ou de synchronisation des données. |
| Monitoring and Alerting | Définissez sur Yes pour recevoir des alertes en cas d'échec de la tâche ou si la latence de synchronisation dépasse un seuil. Configurez le seuil d'alerte et les paramètres de notification. Consultez la rubrique Configurer la surveillance et les alertes. |
Configurer la vérification des données
Cliquez sur Next Step: Data Verification pour configurer la vérification des données. Consultez la rubrique Configurer une tâche de vérification des données.
(Facultatif) Configurer les champs de base de données et de table
Cliquez sur Next: Configure Database and Table Fields pour définir la structure de la table dans l'instance AnalyticDB for PostgreSQL de destination :
| Paramètre | Description |
|---|---|
| Type | Type de table dans l'instance de destination. |
| Primary Key Column | Colonne ou colonnes de clé primaire. Plusieurs colonnes forment une clé primaire composite. |
| Distribution Key | Clé de distribution pour la table. Doit être l'une des colonnes de clé primaire. Consultez les rubriques Gérer les tables et Définir la distribution des tables. |
Cette étape n'est disponible que lorsque Schema Synchronization est sélectionné. Définissez Definition Status sur All pour afficher et modifier toutes les tables.
Étape 6 : Enregistrer les paramètres et exécuter une vérification préalable
Cliquez sur Next: Save Task Settings and Precheck.
Pour prévisualiser les paramètres d'API de cette configuration de tâche, survolez le bouton et cliquez sur Preview OpenAPI parameters.
DTS exécute une vérification préalable avant de démarrer la tâche. La tâche ne démarre qu'après réussite de la vérification.
Si la vérification préalable échoue, cliquez sur View Details à côté de chaque élément ayant échoué, résolvez les problèmes, puis cliquez sur Precheck Again.
Si une alerte est déclenchée : si elle ne peut pas être ignorée, résolvez le problème et relancez la vérification préalable. Si elle peut être ignorée, cliquez sur Confirm Alert Details, puis Ignore, puis OK, puis Precheck Again. Ignorer les alertes peut entraîner une incohérence des données.
Étape 7 : Acheter et démarrer l'instance
Attendez que le Success Rate atteigne 100 %, puis cliquez sur Next: Purchase Instance.
Sur la page d'achat, configurez les éléments suivants :
| Paramètre | Description |
|---|---|
| Billing Method | Subscription : payez à l'avance pour une durée fixe, plus rentable pour une utilisation à long terme. Pay-as-you-go : facturation horaire, adaptée à une utilisation à court terme. Libérez l'instance lorsqu'elle n'est plus nécessaire pour arrêter la facturation. |
| Resource Group Settings | Groupe de ressources pour l'instance. Par défaut : default resource group. Consultez la rubrique Qu'est-ce que Resource Management ? |
| Instance Class | Niveau de vitesse de synchronisation. Consultez la rubrique Classes d'instance des instances de synchronisation des données. |
| Subscription Duration | Disponible uniquement pour la méthode de facturation par abonnement. Options : 1 à 9 mois, 1 an, 2 ans, 3 ans ou 5 ans. |
Lisez et acceptez les Data Transmission Service (Pay-as-you-go) Service Terms, puis cliquez sur Buy and Start. Dans la boîte de dialogue de confirmation, cliquez sur OK.
La tâche apparaît dans la liste des tâches. Vous pouvez y surveiller sa progression.
Étapes suivantes
Logical Replication Slot Failover — activez cette fonctionnalité sur l'instance RDS source si vous envisagez d'effectuer des basculements primaire/secondaire.
Mapper les noms d'objets — renommez les objets dans la destination sans modifier les objets source.
Modifier les paramètres d'une instance DTS — ajustez les paramètres de la tâche après son démarrage.
Configurer une tâche de vérification des données — vérifiez la cohérence des données entre la source et la destination.