Utilisez le service Data Transmission Service (DTS) pour diffuser en temps réel les modifications incrémentielles d'une instance ApsaraDB RDS for MySQL vers un projet DataHub. Une fois la synchronisation active, exploitez Alibaba Cloud Realtime Compute for Apache Flink ou StreamCompute pour analyser les données.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Un projet DataHub dans l'une des régions suivantes : Chine (Hangzhou), Chine (Shanghai), Chine (Pékin) ou Chine (Shenzhen). Pour en créer un, consultez la rubrique Création d'un projet.
Des tables à synchroniser disposant de contraintes PRIMARY KEY ou UNIQUE.
Facturation
|
Type de synchronisation |
Frais |
|
Synchronisation du schéma et synchronisation complète des données |
Gratuit |
|
Synchronisation incrémentielle des données |
Payant. Pour plus d'informations, consultez la rubrique Présentation de la facturation. |
Limites
Aucune donnée historique (CDC uniquement) : La synchronisation initiale complète des données n'est pas prise en charge. DTS ne synchronise que les modifications intervenues après le démarrage de la tâche.
Tables uniquement : Seules les tables peuvent être sélectionnées comme objets à synchroniser.
Évitez les opérations DDL pendant la synchronisation : L'exécution d'opérations DDL sur les tables synchronisées alors que la tâche est en cours peut entraîner l'échec de la synchronisation.
Opérations SQL pouvant être synchronisées
|
Type d'opération |
Instruction SQL |
|
DML |
INSERT, UPDATE et DELETE |
|
DDL |
ADD COLUMN |
Configuration de la synchronisation des données
Étape 1 : Acheter une instance de synchronisation de données
Achetez une instance de synchronisation de données. Pour plus d'informations, consultez la rubrique Achat d'une instance DTS.
Sur la page d'achat, définissez Source Instance sur MySQL , Destination Instance sur DataHub , et Synchronization Topology sur One-way Synchronization .
Étape 2 : Configurer la tâche
-
Connectez-vous à la console DTS.
Si vous êtes redirigé vers la console Data Management (DMS), cliquez sur l'icône
 située dans
 pour revenir à la version précédente de la console DTS.
Dans le volet de navigation de gauche, cliquez sur Data Synchronization.
En haut de la page Synchronization Tasks, sélectionnez la région où réside l'instance de destination.
Localisez l'instance de synchronisation de données et cliquez sur Configure Task dans la colonne Actions.
-
Configurez les instances source et de destination.
Section
Parameter
Description
N/A
Nom de la tâche de synchronisation
Le nom généré automatiquement par DTS pour la tâche. Spécifiez un nom descriptif pour faciliter l'identification de la tâche. Le nom n'a pas besoin d'être unique.
Détails de l'instance source
Type d'instance
Sélectionnez RDS Instance.
ImportantPour une base de données MySQL gérée par vos soins, préparez d'abord l'environnement requis. Consultez la rubrique Présentation de la préparation.
Région de l'instance
La région source sélectionnée sur la page d'achat. Lecture seule.
ID de l'instance
L'ID de l'instance ApsaraDB RDS source.
Compte de base de données
Le compte de la base de données source.
ImportantPour MySQL 5.5 ou MySQL 5.6, ce paramètre n'est pas requis.
Mot de passe de la base de données
Le mot de passe du compte.
ImportantPour MySQL 5.5 ou MySQL 5.6, ce paramètre n'est pas requis.
Chiffrement
Sélectionnez Non-encrypted ou SSL-encrypted. Si vous sélectionnez SSL-encrypted, activez le chiffrement SSL sur l'instance RDS avant de configurer cette tâche. Consultez la rubrique Configuration du chiffrement SSL.
ImportantCe paramètre est disponible uniquement en Chine continentale et en Chine (Hong Kong).
Détails de l'instance de destination
Type d'instance
DataHub. Lecture seule.
Région de l'instance
La région de destination sélectionnée sur la page d'achat. Lecture seule.
Projet
Le nom du projet DataHub de destination.
-
Cliquez sur Set Whitelist and Next en bas à droite. DTS ajoute automatiquement ses blocs CIDR serveur à la liste d'autorisation d'adresses IP des instances de base de données Alibaba Cloud (telles qu'ApsaraDB RDS for MySQL) ou aux règles du groupe de sécurité des instances Elastic Compute Service (ECS) hébergeant la base de données. Si la base de données gérée par vos soins est hébergée sur plusieurs instances ECS, ajoutez manuellement les blocs CIDR des serveurs DTS aux règles du groupe de sécurité de chaque instance ECS. Pour les bases de données gérées par vos soins dans un centre de données ou hébergées par un fournisseur cloud tiers, ajoutez manuellement les blocs CIDR des serveurs DTS. Consultez la rubrique Ajout des blocs CIDR des serveurs DTS.
AvertissementL'ajout des blocs CIDR DTS à une liste d'autorisation ou à un groupe de sécurité peut introduire des risques de sécurité. Prenez des mesures préventives telles que le renforcement de la sécurité des mots de passe, la limitation des ports exposés, l'audit des appels API et la révision régulière des règles de la liste d'autorisation. Pour une sécurité accrue, connectez la base de données à DTS via Express Connect, VPN Gateway ou Smart Access Gateway.
-
Configurez la stratégie de synchronisation et les objets.
Paramètre
Description
Synchronisation initiale
Sélectionnez Initial Schema Synchronization. DTS synchronise les schémas des objets sélectionnés vers le projet DataHub de destination.
Objets à synchroniser
Dans la section Available, sélectionnez les tables et cliquez sur
 pour les déplacer vers la section Selected. Pour renommer les objets synchronisés dans la destination, utilisez la fonctionnalité de mappage des noms d'objets. Consultez la rubrique Renommage d'un objet à synchroniser.
Activer les nouvelles règles de nommage pour les colonnes supplémentaires
Sélectionnez Yes ou No. Avant de configurer ce paramètre, vérifiez si les noms des colonnes supplémentaires entrent en conflit avec les colonnes existantes dans le topic de destination. Dans le cas contraire, la tâche de synchronisation des données peut échouer ou des données peuvent être perdues. Consultez la rubrique Règles de nommage pour les colonnes supplémentaires.
Renommer les bases de données et les tables
Utilisez la fonctionnalité de mappage des noms d'objets pour renommer les objets synchronisés dans la destination. Consultez la rubrique Mappage des noms d'objets.
Répliquer les tables temporaires lors des opérations DDL effectuées par DMS
Contrôle si DTS synchronise les tables temporaires générées par les opérations DDL en ligne dans DMS. Yes: DTS synchronise les tables temporaires. Les opérations DDL en ligne volumineuses peuvent augmenter la latence de synchronisation. No: DTS ignore les tables temporaires et ne synchronise que l'instruction DDL d'origine depuis la source. Les tables de destination peuvent être verrouillées.
Délai de nouvelle tentative en cas d'échec de connexion
Valeur par défaut : 720 minutes (12 heures). Si DTS se reconnecte dans ce délai, la synchronisation reprend. Sinon, la tâche échoue. Des frais DTS s'appliquent pendant les périodes de nouvelle tentative. Définissez cette valeur en fonction de vos besoins métier et libérez l'instance si les instances source et de destination sont libérées.
(Facultatif) Dans la section Selected, survolez le nom d'une table et cliquez sur Edit pour configurer une clé de partitionnement pour le partitionnement de la table.
-
Cliquez sur Precheck en bas à droite.
DTS exécute une vérification préalable avant de démarrer la tâche. La tâche ne démarre qu'après la réussite de la vérification préalable. Si un élément de vérification échoue, cliquez sur l'icône
 située à côté de l'élément ayant échoué pour afficher les détails. Corrigez le problème et relancez la vérification préalable, ou ignorez l'élément ayant échoué et relancez-la si aucune correction n'est nécessaire.
Une fois le message Precheck Passed affiché, fermez la boîte de dialogue Precheck. La tâche démarre automatiquement.
Attendez la fin de la synchronisation initiale. L'état de la tâche passe à Synchronizing. Vérifiez l'état de la tâche sur la page Synchronization Tasks.
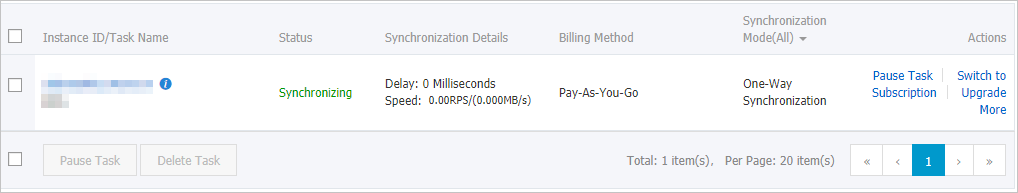
Schéma du topic DataHub
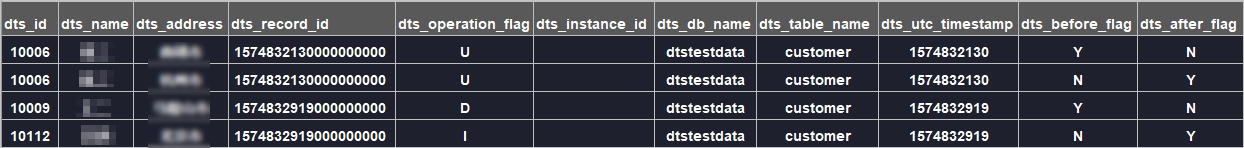
Lorsque DTS synchronise des données incrémentielles vers un topic DataHub, il ajoute des colonnes de métadonnées au topic.
Dans cet exemple,id,nameetaddresssont des champs de données. Lorsque les règles de nommage précédentes sont utilisées, DTS ajoute le préfixedts_à tous les champs, y compris les champs d'origine de la source. Lorsque les nouvelles règles de nommage sont utilisées, DTS n'ajoute pas de préfixe aux champs d'origine de la source.
|
Nom de colonne précédent |
Nouveau nom de colonne |
Type |
Description |
|
|
|
String |
ID unique de l'entrée de journal incrémentielle. Incrémentation automatique pour chaque nouvelle entrée. Dans les scénarios de reprise après sinistre, un retour arrière peut provoquer une duplication des ID. Pour les opérations UPDATE, les deux entrées de journal (avant et après la mise à jour) partagent le même |
|
|
|
String |
Le type d'opération. Valeurs possibles : |
|
|
|
String |
L'ID du serveur de la base de données. |
|
|
|
String |
Le nom de la base de données. |
|
|
|
String |
Le nom de la table. |
|
|
|
String |
L'horodatage de l'opération en UTC. Il s'agit également de l'horodatage du fichier journal. |
|
|
|
String |
Indique si les valeurs de la ligne correspondent aux valeurs avant la mise à jour. Valeurs possibles : |
|
|
|
String |
Indique si les valeurs de la ligne correspondent aux valeurs après la mise à jour. Valeurs possibles : |
Valeurs des indicateurs before et after
Les colonnes dts_before_flag et dts_after_flag indiquent si une ligne du topic représente l'état avant ou après une modification des données.
|
Opération |
Entrées de journal générées |
dts_before_flag |
dts_after_flag |
Contenu de la ligne |
|
INSERT |
1 |
|
|
Les valeurs nouvellement insérées. |
|
DELETE |
1 |
|
|
Les valeurs supprimées. |
|
UPDATE (première entrée) |
2 (même |
|
|
Valeurs avant la mise à jour. |
|
UPDATE (deuxième entrée) |
2 (même |
|
|
Valeurs après la mise à jour. |
Opération INSERT
L'entrée de journal contient les valeurs nouvellement insérées. dts_before_flag est N et dts_after_flag est Y.
Opération UPDATE
DTS génère deux entrées de journal avec les mêmes valeurs dts_record_id, dts_operation_flag et dts_utc_timestamp. La première entrée capture les valeurs avant la mise à jour (dts_before_flag=Y, dts_after_flag=N). La deuxième entrée capture les valeurs après la mise à jour (dts_before_flag=N, dts_after_flag=Y).

Opération DELETE
L'entrée de journal contient les valeurs supprimées. dts_before_flag est Y et dts_after_flag est N.

Étapes suivantes
Une fois la tâche de synchronisation en cours d'exécution, utilisez Alibaba Cloud Realtime Compute for Apache Flink pour analyser les données du projet DataHub. Pour plus d'informations, consultez la rubrique Présentation d'Alibaba Cloud Realtime Compute for Apache Flink