Utilisez Data Transmission Service (DTS) pour synchroniser en temps réel les données incrémentielles d'un cluster PolarDB for MySQL vers DataHub. Vous pouvez ensuite exploiter des produits Big Data, tels que Realtime Compute for Apache Flink, pour analyser les données en temps réel.
Prérequis
Créez un cluster source PolarDB for MySQL. Pour plus d'informations, consultez les rubriques Achat personnalisé et Acheter un cluster par abonnement.
Activez DataHub et créez un projet pour recevoir les données synchronisées. Pour plus d'informations, voir Prise en main de la synchronisation DataHub et Créer et supprimer des projets.
Activez la journalisation binaire (binary logging) pour le cluster PolarDB for MySQL. Pour plus d'informations, voir Activer la journalisation binaire.
Précautions
DTS ne synchronise pas les clés étrangères de la base de données source vers la base de données de destination. Par conséquent, les opérations en cascade et les suppressions effectuées sur la base de données source ne sont pas répliquées vers la destination.
Type | Description |
Limites de la base de données source |
|
Autres limites |
|
Autres remarques | DTS exécute périodiquement la commande CREATE DATABASE IF NOT EXISTS |
Facturation
|
Type de synchronisation |
Tarification |
|
Synchronisation des schémas et synchronisation complète des données |
Gratuit. |
|
Synchronisation des données incrémentielles |
Payant. Pour plus d'informations, consultez la rubrique Aperçu de la facturation. |
Topologies de synchronisation prises en charge
Synchronisation unidirectionnelle un-à-un.
Synchronisation unidirectionnelle un-à-plusieurs.
Synchronisation unidirectionnelle plusieurs-à-un.
Synchronisation unidirectionnelle en cascade.
Pour plus d'informations sur ces topologies de synchronisation, consultez la rubrique Topologies de synchronisation.
Opérations SQL prises en charge
Type d'opération | Instruction SQL |
DML | INSERT, UPDATE, DELETE |
DDL | ADD COLUMN Important Si vous modifiez manuellement la structure de la table dans la base de données cible, redémarrez la tâche : mettez-la en pause puis démarrez-la. |
Autorisations du compte de base de données
Le compte de base de données du cluster source PolarDB for MySQL nécessite au minimum l'autorisation de lecture sur les objets à synchroniser.
Procédure
-
Accédez à la page de liste des tâches de synchronisation de la région de destination. Vous pouvez utiliser l'une des deux méthodes suivantes :
Depuis la console DTS
Connectez-vous à la console Data Transmission Service (DTS)console Data Transmission Service (DTS).
Dans le volet de navigation de gauche, cliquez sur Data Synchronization.
Dans le coin supérieur gauche de la page, sélectionnez la région où se trouve l'instance de synchronisation.
Depuis la console DMS
RemarqueLes opérations réelles peuvent varier en fonction du mode et de la disposition de la console DMS. Pour plus d'informations, consultez Mode simple et Personnaliser la disposition et le style de l'interface DMS.
Connectez-vous à Data Management (DMS)Data Management (DMS).
Dans la barre de menu supérieure, choisissez Data + AI > Data Transmission (DTS) > Data Synchronization.
À droite de Data Synchronization Tasks, sélectionnez la région où se trouve l'instance de synchronisation.
Cliquez sur Create Task pour ouvrir la page de configuration de la tâche.
-
Configurez les bases de données source et de destination.
Catégorie
Paramètre
Description
N/A
Data Synchronization
DTS génère automatiquement un nom de tâche. Nous vous recommandons de spécifier un nom descriptif pour une identification facile. Le nom n'a pas besoin d'être unique.
Data + AI
Data Transmission (DTS)
Sélectionnez une instance existante selon vos besoins.
-
Si vous utilisez une instance existante, les informations de la base de données sont renseignées automatiquement. Vous n'avez pas besoin de les saisir à nouveau.
-
Si vous n'utilisez pas d'instance existante, saisissez les informations de base de données suivantes.
Data Synchronization
Sélectionnez Data Synchronization Tasks.
Create Task
Sélectionnez Task Name.
Source Database
Sélectionnez la région où se trouve le cluster PolarDB for MySQL source.
Select DMS Database Instance
Dans ce scénario, les données sont synchronisées au sein du même compte Alibaba Cloud. Sélectionnez Database Type.
PolarDB for MySQL
Sélectionnez l'ID du cluster PolarDB for MySQL source.
Connection Type
Saisissez le compte de base de données pour le cluster PolarDB for MySQL source. Pour plus d'informations sur les autorisations requises, consultez Autorisations requises pour un compte de base de données.
Alibaba Cloud Instance
Saisissez le mot de passe correspondant au compte de base de données.
Instance Region
Sélectionnez une option en fonction de vos besoins. Pour plus d'informations, consultez Configurer le chiffrement SSL.
Cross-account
No
Sélectionnez une instance existante selon vos besoins.
-
Si vous utilisez une instance existante, les informations de la base de données sont renseignées automatiquement. Vous n'avez pas besoin de les saisir à nouveau.
-
Si vous n'utilisez pas d'instance existante, saisissez les informations de base de données suivantes.
PolarDB Cluster ID
Sélectionnez Database Account.
Database Password
Sélectionnez Encryption.
Destination Database
Sélectionnez la région où se trouve l'instance DataHub de destination.
Select DMS Database Instance
Sélectionnez le projet DataHub de destination.
-
-
Une fois la configuration terminée, cliquez sur Test Connectivity and Proceed en bas de la page.
RemarqueAssurez-vous que les blocs CIDR d'adresses IP des serveurs DTS sont ajoutés aux paramètres de sécurité des bases de données source et de destination pour autoriser l'accès depuis les serveurs DTS. Cette opération peut être effectuée automatiquement ou manuellement. Pour plus d'informations, consultez Ajouter les blocs CIDR d'adresses IP des serveurs DTS à une liste d'autorisation.
-
Configurez les objets de la tâche.
-
Sur la page Configure Objects, configurez les objets à synchroniser.
Paramètre
Description
Database Type
DataHub est sélectionné. Par défaut, vous devez également sélectionner Connection Type et Alibaba Cloud Instance. Une fois la pré-vérification terminée, DTS effectue une synchronisation complète des données des objets sélectionnés depuis l'instance source vers le cluster de destination. Cela sert de données de référence pour la synchronisation incrémentielle des données ultérieure.
Instance Region
Lorsque DTS synchronise les données vers DataHub, il ajoute des colonnes supplémentaires au topic de destination. Si un nom de colonne supplémentaire entre en conflit avec un nom de colonne existant dans le topic de destination, la tâche de synchronisation des données échoue. Pour éviter cet échec, définissez l'option Project sur Test Connectivity and Proceed ou Configure Objects en fonction de vos besoins métier.
AvertissementAvant de sélectionner une règle de colonne supplémentaire, vous devez évaluer si les noms des colonnes supplémentaires entreront en conflit avec les noms des colonnes existantes dans le topic de destination. Sinon, la tâche peut échouer ou des données peuvent être perdues. Pour plus d'informations sur les règles et les définitions des colonnes supplémentaires, consultez Noms et définitions des colonnes supplémentaires.
Synchronization Types
-
Incremental Data Synchronization : vérifie si une table portant le même nom existe dans la base de données de destination. Si aucune table portant le même nom n'existe, la pré-vérification réussit. Si une table portant le même nom existe, la pré-vérification échoue et la tâche de synchronisation des données ne démarre pas.
RemarqueSi vous ne pouvez pas supprimer ou renommer la table portant le même nom dans la base de données de destination, vous pouvez la mapper vers un nom de table différent. Pour plus d'informations, consultez Mapper les noms de tables et de colonnes.
-
Schema Synchronization : ignore la vérification des noms de tables en double dans la base de données de destination.
AvertissementLa sélection de Full Data Synchronization peut entraîner une incohérence des données et mettre votre activité à risque. Par exemple :
-
Si les schémas de table sont identiques et qu'un enregistrement dans la base de données de destination a la même valeur de clé primaire ou de clé unique qu'un enregistrement dans la base de données source :
-
Lors de la synchronisation complète, DTS conserve l'enregistrement dans le cluster de destination. L'enregistrement correspondant de la base de données source n'est pas synchronisé.
-
Lors de la synchronisation incrémentielle, l'enregistrement de la base de données source écrase l'enregistrement dans la base de données de destination.
-
-
Si les schémas de table sont différents, la synchronisation initiale des données peut échouer. Cela peut entraîner la synchronisation uniquement des données de certaines colonnes ou un échec complet de la synchronisation. Procédez avec prudence.
-
Naming Rules of Additional Columns
Vous pouvez configurer la politique de sensibilité à la casse pour les noms d'objets de base de données, de tables et de colonnes qui sont synchronisés vers l'instance de destination. Par défaut, la Enable new additional column rule est sélectionnée. Vous pouvez également choisir d'utiliser les politiques par défaut des bases de données source et de destination. Pour plus d'informations, consultez Politique de sensibilité à la casse pour les noms d'objets de destination.
Yes
Dans la zone No, cliquez sur les objets à synchroniser, puis cliquez sur l'icône
 pour les déplacer vers la zone Processing Mode of Conflicting Tables.Remarque
Vous pouvez sélectionner des objets à synchroniser au niveau de la base de données et de la table.
Precheck and Report Errors
-
Pour renommer un seul objet de synchronisation dans l'instance de destination, faites un clic droit sur l'objet dans la zone Ignore Errors and Proceed. Pour plus d'informations sur le renommage des objets, consultez Mapper une seule base de données, table ou colonne.
-
Pour modifier les noms de plusieurs objets de synchronisation dans l'instance de destination par lot, cliquez sur Ignore Errors and Proceed dans le coin supérieur droit de la zone Case Sensitivity Policy for Destination Object Names. Pour plus d'informations, consultez Mapper des bases de données, tables et colonnes par lot.
RemarquePour sélectionner les opérations SQL à synchroniser au niveau de la base de données ou de la table, faites un clic droit sur un objet dans la zone DTS default policy et sélectionnez les opérations SQL requises dans la boîte de dialogue qui s'affiche. Pour obtenir la liste des opérations prises en charge, consultez Opérations SQL prises en charge.
Pour filtrer les données à l'aide d'une clause WHERE, faites un clic droit sur une table dans la zone Source Objects et définissez les conditions de filtre dans la boîte de dialogue qui s'affiche. Pour plus d'informations, consultez Définir les conditions de filtre.
Si vous sélectionnez des objets au niveau de la table, vous pouvez faire un clic droit sur une table dans la zone Source Objects, décocher la case Selected Objects, puis définir une Shard Key, qui est une clé utilisée pour le partitionnement.
-
-
Cliquez sur Next: Advanced Settings pour configurer les paramètres avancés.
Paramètre
Description
Selected Objects
Par défaut, DTS planifie les tâches sur un cluster partagé et vous n'avez pas besoin de sélectionner un cluster. Pour des performances plus stables, vous pouvez acheter un cluster dédié pour exécuter les tâches de synchronisation DTS. Pour plus d'informations, consultez Qu'est-ce qu'un cluster dédié DTS ?.
Selected Objects
Après le démarrage d'une tâche de synchronisation, si la connexion à la base de données source ou de destination échoue, DTS signale une erreur et commence immédiatement à retenter la connexion. La durée de nouvelle tentative par défaut est de 720 minutes. Vous pouvez également spécifier une durée de nouvelle tentative personnalisée comprise entre 10 et 1 440 minutes. Nous vous recommandons de définir la durée à 30 minutes ou plus. Si DTS se reconnecte avec succès à la base de données dans le délai spécifié, la tâche de synchronisation reprend automatiquement. Sinon, la tâche échoue.
Remarque-
Si vous disposez de plusieurs instances DTS (par exemple, l'instance A et l'instance B) qui partagent la même source ou la même destination, et que vous définissez le temps de nouvelle tentative réseau à 30 minutes pour l'instance A et à 60 minutes pour l'instance B, la durée la plus courte de 30 minutes est utilisée pour les deux.
-
Étant donné que DTS facture le temps d'exécution de la tâche pendant la période de nouvelle tentative de connexion, nous vous recommandons de personnaliser la durée de nouvelle tentative en fonction de vos besoins métier ou de libérer l'instance DTS dès que possible après la libération des instances de base de données source et de destination.
Batch Edit
Après le démarrage de la tâche de synchronisation, si d'autres problèmes non liés à la connectivité surviennent avec la base de données source ou de destination (tels que des exceptions d'exécution DDL ou DML), DTS signale une erreur et commence immédiatement des opérations de nouvelle tentative continues. La durée de nouvelle tentative par défaut est de 10 minutes. Vous pouvez également personnaliser la durée de nouvelle tentative dans la plage de 1 à 1 440 minutes. Nous vous recommandons de la définir à 10 minutes ou plus. Si les opérations pertinentes réussissent dans la durée de nouvelle tentative définie, la tâche de synchronisation reprend automatiquement. Sinon, la tâche échoue.
ImportantLa valeur de Selected Objects doit être inférieure à celle de Selected Objects.
Selected Objects
Pendant l'étape de synchronisation complète, DTS consomme des ressources de lecture et d'écriture des bases de données source et de destination, ce qui peut augmenter la charge de la base de données. Pour réduire la charge sur les bases de données source et de destination, vous pouvez définir une limite de débit pour la tâche de synchronisation complète en configurant les paramètres Selected Objects, Sync All Columns et Next: Advanced Settings.
Remarque-
Cet élément de configuration est disponible uniquement lorsque Dedicated Cluster for Task Scheduling est défini sur Retry Time for Failed Connections.
-
Vous pouvez également ajuster le taux de synchronisation complète après le démarrage de l'instance de synchronisation.
Retry Time for Other Issues
Vous pouvez également définir une limite de débit pour la tâche de synchronisation incrémentielle. Pour soulager la pression sur la base de données de destination, définissez les paramètres Retry Time for Other Issues et Retry Time for Failed Connections.
Enable Throttling for Full Data Synchronization
Vous pouvez sélectionner un tag d'environnement pour identifier l'instance. Ce paramètre est facultatif.
Queries per second (QPS) to the source database
Choisissez si vous souhaitez écrire les informations SQL de heartbeat dans la base de données source lorsque l'instance DTS est en cours d'exécution.
-
RPS of Full Data Migration : Les informations SQL de heartbeat ne sont pas écrites dans la base de données source. Cela peut entraîner un retard signalé par l'instance DTS.
-
Data migration speed for full migration (MB/s) : Écrit les informations SQL de heartbeat dans la base de données source. Cela peut interférer avec des fonctionnalités telles que la sauvegarde physique et le clonage de la base de données source.
Synchronization Types
Choisissez si vous souhaitez activer la fonctionnalité extract, transform, and load (ETL). Pour plus d'informations, consultez Qu'est-ce que l'ETL ? Valeurs valides :
-
Full Data Synchronization : Active la fonctionnalité ETL. Saisissez les instructions de traitement des données dans l'éditeur de code. Pour plus d'informations, consultez Configurer l'ETL dans une tâche de migration ou de synchronisation de données.
-
Enable Throttling for Incremental Data Synchronization : Désactive la fonctionnalité ETL.
RPS of Incremental Data Synchronization
Spécifiez si vous souhaitez configurer des alertes. Si la synchronisation échoue ou si la latence dépasse le seuil spécifié, une notification est envoyée à un contact d'alerte.
-
Data synchronization speed for incremental synchronization (MB/s) : Aucune alerte n'est configurée.
-
Environment Tag : Configurez les alertes en définissant un seuil d'alerte et en spécifiant un notification d'alerte. Pour plus d'informations, consultez Configurer la surveillance et les alertes lors de la configuration de la tâche.
-
-
-
Enregistrez la tâche et exécutez une pré-vérification.
Pour afficher les paramètres API pour configurer cette instance, survolez le bouton Next: Save Task Settings and Precheck et cliquez sur Preview OpenAPI parameters dans la bulle.
Si vous avez terminé la consultation des paramètres API, cliquez sur Next: Save Task Settings and Precheck en bas de la page.
RemarqueAvant le démarrage de la tâche de synchronisation, DTS exécute une pré-vérification. La tâche ne peut démarrer qu'après la réussite de tous les éléments de pré-vérification.
Si la pré-vérification échoue, cliquez sur View Details pour l'élément ayant échoué. Corrigez le problème comme indiqué, puis relancez la pré-vérification.
-
Si la pré-vérification renvoie un avertissement :
Si un élément de vérification échoue et ne peut pas être ignoré, cliquez sur View Details à côté de l'élément. Suivez les instructions pour corriger le problème, puis relancez la pré-vérification.
Pour les éléments de vérification qui peuvent être ignorés, vous pouvez cliquer sur Confirm Alert Details, Ignore, OK et Precheck Again dans l'ordre pour ignorer l'avertissement et relancer la pré-vérification. Si vous choisissez de masquer l'élément d'avertissement, cela peut entraîner des problèmes tels que l'incohérence des données et présenter des risques pour votre activité.
-
Achetez l'instance.
Lorsque le Taux de réussite est de 100 %, cliquez sur Next: Purchase Instance.
-
Sur la page Purchase, sélectionnez la méthode de facturation et la spécification de lien pour l'instance de synchronisation de données. Le tableau suivant décrit ces paramètres en détail.
Catégorie
Paramètre
Description
Whether to delete SQL operations on heartbeat tables of forward and reverse tasks
Méthode de facturation
-
Abonnement : Vous payez lors de la création de l'instance. Cela convient aux besoins à long terme et est plus rentable que le paiement à l'utilisation. Plus la durée de l'abonnement est longue, plus la remise est importante.
-
Paiement à l'utilisation : Vous êtes facturé à l'heure. Cela convient aux besoins à court terme. Vous pouvez libérer l'instance immédiatement après utilisation pour économiser des coûts.
Configuration du groupe de ressources
Le groupe de ressources auquel appartient l'instance. La valeur par défaut est le groupe de ressources par défaut. Pour plus d'informations, consultez Qu'est-ce que la gestion des ressources ?.
Spécification de lien
DTS propose des spécifications de synchronisation avec différents niveaux de performance. La spécification de lien de synchronisation affecte le taux de synchronisation. Vous pouvez choisir une spécification en fonction de votre scénario métier. Pour plus d'informations, consultez Spécifications de lien de synchronisation de données.
Durée de l'abonnement
En mode abonnement, sélectionnez la durée et la quantité pour l'instance d'abonnement. Vous pouvez choisir un abonnement mensuel de 1 à 9 mois, ou un abonnement annuel de 1, 2, 3 ou 5 ans.
RemarqueCette option est disponible uniquement lorsque la méthode de facturation est Yes.
-
Une fois la configuration terminée, lisez et sélectionnez Conditions de service Data Transmission Service (paiement à l'utilisation).
-
Cliquez sur Buy and Start. Dans la boîte de dialogue OK, cliquez sur OK.
Vous pouvez consulter la progression de la tâche sur la page Data Synchronization.
Schéma de topic DataHub
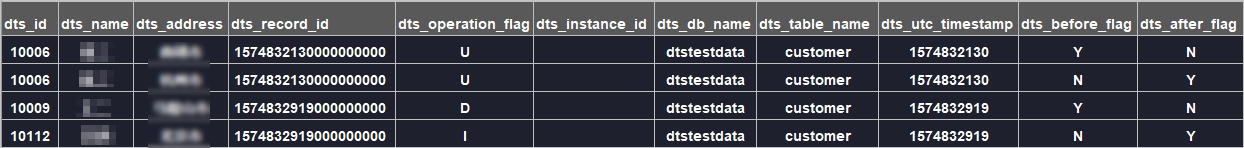
Lorsque DTS synchronise les données incrémentielles vers un topic DataHub, il ajoute des colonnes de métadonnées au topic.
Dans cet exemple,id,nameetaddresssont des champs de données. Lorsque les règles de nommage précédentes sont utilisées, DTS ajoute le préfixedts_à tous les champs, y compris les champs d'origine de la source. Lorsque les nouvelles règles de nommage sont utilisées, DTS n'ajoute pas de préfixe aux champs d'origine de la source.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Valeurs des indicateurs avant et après
Les colonnes dts_before_flag et dts_after_flag indiquent si une ligne dans le topic représente l'état avant ou après une modification des données.
|
Opération |
Entrées de journal générées |
dts_before_flag |
dts_after_flag |
Contenu de la ligne |
|
INSERT |
1 |
|
|
Les valeurs nouvellement insérées. |
|
DELETE |
1 |
|
|
Les valeurs supprimées. |
|
UPDATE (première entrée) |
2 (même |
|
|
Valeurs avant la mise à jour. |
|
UPDATE (deuxième entrée) |
2 (même |
|
|
Valeurs après la mise à jour. |
Opération INSERT
L'entrée de journal contient les valeurs nouvellement insérées. dts_before_flag est défini sur N et dts_after_flag sur Y.
Opération UPDATE
DTS génère deux entrées de journal partageant les mêmes valeurs pour dts_record_id, dts_operation_flag et dts_utc_timestamp. La première entrée capture les valeurs avant la mise à jour (dts_before_flag=Y, dts_after_flag=N). La seconde capture les valeurs après la mise à jour (dts_before_flag=N, dts_after_flag=Y).

Opération DELETE
L'entrée de journal contient les valeurs supprimées. dts_before_flag est défini sur Y et dts_after_flag sur N.

Étapes suivantes
Une fois la tâche de synchronisation en cours d'exécution, utilisez Alibaba Cloud Realtime Compute for Apache Flink pour analyser les données du projet DataHub. Pour plus d'informations, consultez la rubrique Présentation d'Alibaba Cloud Realtime Compute for Apache Flink.