Utilisez Data Transmission Service (DTS) pour maintenir deux clusters PolarDB for PostgreSQL (Compatible avec Oracle) synchronisés dans les deux sens.
La synchronisation bidirectionnelle s'exécute sous la forme d'une paire de tâches : une tâche directe (du cluster A vers le cluster B) et une tâche inverse (du cluster B vers le cluster A). DTS empêche les boucles de données en créant un schéma dts dans chaque cluster de destination afin de suivre l'origine de chaque écriture.
La synchronisation bidirectionnelle ne garantit pas l'absence totale de conflits. Lorsque le même enregistrement est mis à jour simultanément sur les deux clusters, DTS applique la politique de résolution des conflits que vous avez configurée. Pour minimiser les conflits, restreignez les écritures sur les enregistrements partageant la même clé primaire ou unique à un seul cluster à la fois.
Facturation
| Type de synchronisation | Tarification |
|---|---|
| Synchronisation du schéma et synchronisation complète des données | Gratuit |
| Synchronisation incrémentielle des données | Facturé. Consultez Aperçu de la facturation. |
Prérequis
Avant de commencer, assurez-vous que :
Les deux clusters PolarDB for PostgreSQL (Compatible avec Oracle) sont créés. Consultez Créer un cluster PolarDB for PostgreSQL (Compatible avec Oracle).
Le paramètre
wal_levelest défini surlogicalsur les deux clusters. Cela ajoute les informations requises pour la réplication logique au journal des transactions anticipées (WAL). Consultez Définir les paramètres du cluster.Le cluster de destination dispose de plus d'espace de stockage que celui actuellement utilisé par le cluster source.
Limitations
Limites de la base de données source
Bande passante : Le serveur hébergeant le cluster source doit disposer d'une bande passante sortante suffisante. Une bande passante insuffisante dégrade la vitesse de synchronisation.
Tables sans clé primaire ou unique : Activez la fonctionnalité d'écriture Exactly-Once lors de la configuration de la tâche. Sinon, des enregistrements en double peuvent apparaître dans la destination. Consultez Synchroniser des tables sans clé primaire ou contrainte UNIQUE.
Sélections d'objets volumineuses avec mappage de noms : Si vous devez mapper des noms de table ou de colonne et que la tâche inclut plus de 1 000 tables, divisez les tables en plusieurs tâches ou synchronisez plutôt la base de données entière. La soumission d'une seule tâche qui mappe plus de 1 000 tables peut entraîner une erreur de requête.
-
Rétention des journaux WAL : Si les journaux WAL sont purgés avant que DTS ne les lise, la tâche échoue. Dans les cas extrêmes, une perte de données ou une incohérence peut survenir. Les problèmes causés par une rétention WAL insuffisante ne sont pas couverts par le SLA (Accord de niveau de service).
Synchronisation incrémentielle uniquement : conservez les journaux WAL pendant plus de 24 heures.
Synchronisation complète + incrémentielle : conservez les journaux WAL pendant au moins 7 jours. Une fois la synchronisation complète terminée, vous pouvez réduire la période de rétention à plus de 24 heures.
Transactions de longue durée : Les journaux WAL générés avant la validation d'une transaction de longue durée s'accumulent pendant la synchronisation incrémentielle. Cela peut épuiser l'espace disque sur le cluster source.
Opérations DDL pendant la synchronisation : N'effectuez pas d'opérations DDL modifiant la structure de la base de données ou des tables pendant la synchronisation du schéma ou la synchronisation complète des données. La tâche échouera.
Écritures pendant la synchronisation complète uniquement : N'écrivez pas de nouvelles données dans le cluster source si seule la synchronisation complète des données est sélectionnée. Pour maintenir la cohérence en temps réel, sélectionnez également la synchronisation du schéma et la synchronisation incrémentielle des données.
-
Basculement des slots de réplication logique : Pour éviter que la réplication logique ne soit interrompue lors d'un basculement primaire/secondaire, le cluster source doit prendre en charge et avoir activé le Basculement des slots de réplication logique.
Si le cluster ne prend pas en charge le basculement des slots de réplication logique (par exemple, si Database Engine est Oracle syntax compatible 2,0 ), un basculement de haute disponibilité (HA) peut provoquer l'échec de l'instance de synchronisation et la rendre irrécupérable.
Limite de taille d'une modification unique : Si une modification unique des données incrémentielles dépasse 256 Mo, l'instance de synchronisation peut échouer et ne pas être récupérée. Vous devez reconfigurer l'instance de synchronisation.
Limites de la synchronisation bidirectionnelle
Schéma de prévention des boucles : DTS crée un schéma nommé
dtsdans chaque cluster de destination pour prévenir les boucles de données. Ne modifiez pas ce schéma pendant l'exécution de la tâche.Champs de type SERIAL : Si une table possède un champ de type SERIAL, le cluster source crée automatiquement une séquence pour ce champ. Si vous sélectionnez Schema Synchronization sous Synchronization Types, sélectionnez également Sequence ou synchronisez le schéma entier. Sinon, l'instance de synchronisation peut échouer.
Portée des données de la tâche : Dans une paire de synchronisation bidirectionnelle, une seule tâche peut synchroniser à la fois les données complètes et incrémentielles. L'autre tâche prend en charge uniquement la synchronisation incrémentielle.
Direction du flux de données : Les données provenant de la source d'une tâche sont synchronisées uniquement vers la destination de cette tâche. Elles ne sont pas traitées comme des données sources pour l'autre tâche.
Base de données unique par tâche : Chaque tâche de synchronisation synchronise une seule base de données. Configurez des tâches distinctes pour les bases de données supplémentaires.
Objets non pris en charge : DTS ne prend pas en charge les tables d'extension TimescaleDB, les tables avec héritage inter-schémas ou les tables avec des index uniques basés sur des expressions.
Schémas créés par des plugins : Les schémas créés par l'installation de plugins ne peuvent pas être synchronisés.
-
`REPLICA IDENTITY FULL` requirement: Exécutez
ALTER TABLE schema.table REPLICA IDENTITY FULL;sur les tables du cluster source avant d'y écrire des données dans les scénarios suivants :Lorsque l'instance de synchronisation s'exécute pour la première fois.
Lorsque vous sélectionnez Schema comme granularité pour la sélection d'objets, et qu'une nouvelle table est créée ou qu'une table existante est reconstruite à l'aide de la commande
RENAME.Lorsque vous utilisez la fonctionnalité de modification des objets de synchronisation.
Remplacez
schemaettablepar le nom du schéma et le nom de la table réels. Exécutez cette commande pendant les heures creuses. Ne verrouillez pas les tables pendant son exécution — le verrouillage peut provoquer des interblocages. Si vous ignorez les éléments de précontrôle associés, DTS exécute cette commande automatiquement lors de l'initialisation de l'instance. Tables temporaires : DTS crée les tables temporaires suivantes dans le cluster source pour capturer les instructions DDL, la structure des tables et les informations de heartbeat. Ne les supprimez pas pendant la synchronisation — la tâche échouera. DTS les supprime automatiquement lorsque l'instance est libérée :
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionetpublic.aliyun_dts_instance.Table de heartbeat : DTS ajoute une table de heartbeat nommée
dts_postgres_heartbeatau cluster source pour maintenir la précision des mesures de latence incrémentielle.-
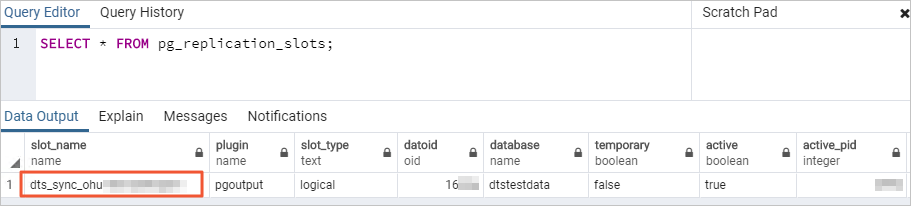
Slot de réplication : DTS crée un slot de réplication avec le préfixe
dts_sync_dans le cluster source. Ce slot permet à DTS d'accéder aux journaux incrémentiels des 15 dernières minutes. Lorsque la tâche de synchronisation échoue ou que l'instance est libérée, DTS tente de supprimer le slot automatiquement.Si vous modifiez le mot de passe du compte de la base de données source ou supprimez l'adresse IP de DTS de la liste d'autorisation du cluster source pendant la synchronisation, le slot ne peut pas être supprimé automatiquement. Supprimez-le manuellement pour empêcher l'accumulation de WAL de remplir le disque et de rendre le cluster source indisponible. En cas de basculement, connectez-vous au cluster secondaire pour supprimer manuellement le slot.
Calendrier de synchronisation : Synchronisez les données pendant les heures creuses lorsque la charge CPU sur les deux clusters est inférieure à 30 %. La synchronisation complète des données exécute des opérations INSERT concurrentes, ce qui augmente la charge sur les deux clusters et provoque une fragmentation des tables dans la destination. L'espace de la table de destination peut être plus grand que celui de la source une fois la synchronisation complète terminée.
Vérifications des contraintes pendant la synchronisation : Pendant la synchronisation du schéma, DTS synchronise les clés étrangères de la source vers la destination. Pendant la synchronisation complète et incrémentielle, DTS désactive temporairement les vérifications de contraintes et les opérations en cascade de clés étrangères au niveau de la session. Si des opérations de mise à jour ou de suppression en cascade se produisent dans la source pendant l'exécution de la tâche, une incohérence des données peut survenir.
Précision FLOAT et DOUBLE : DTS lit les valeurs FLOAT et DOUBLE en utilisant
ROUND(COLUMN, PRECISION). Si la précision n'est pas explicitement définie, DTS utilise par défaut 38 pour FLOAT et 308 pour DOUBLE. Confirmez que ces valeurs par défaut répondent à vos exigences.Récupération de tâche et protection en écriture : DTS tente de récupérer automatiquement les tâches ayant échoué pendant jusqu'à 7 jours. Avant de basculer votre charge de travail vers le cluster de destination, terminez ou libérez la tâche, ou utilisez
REVOKEpour révoquer les autorisations d'écriture du compte de base de données DTS sur la destination. Cela empêche les données sources d'écraser les données de destination si la tâche est récupérée.Clés étrangères, déclencheurs et déclencheurs d'événements : DTS définit
session_replication_rolesurreplicaau niveau de la session si le compte de destination est un compte privilégié ou dispose des autorisations superuser. Si le compte ne dispose pas de ces autorisations, définissez manuellementsession_replication_rolesurreplicasur la destination. Pendant cette période, les opérations de mise à jour ou de suppression en cascade dans la source peuvent provoquer une incohérence des données. Une fois la tâche libérée, remettezsession_replication_rolesurorigin.Récupération par le support DTS : Si une tâche échoue, le personnel du support DTS tente de la restaurer dans un délai de 8 heures et peut redémarrer la tâche ou ajuster les paramètres de la tâche (et non les paramètres de la base de données). Les paramètres susceptibles d'être ajustés sont répertoriés dans Modifier les paramètres de l'instance.
Tables partitionnées : Incluez à la fois la table parente et toutes les partitions enfants en tant qu'objets de synchronisation. La table parente d'une table partitionnée ne stocke aucune donnée directement — toutes les données se trouvent dans les partitions enfants. L'absence de la table parente ou d'une partition enfant peut provoquer une incohérence des données.
Détection des conflits prise en charge
DTS détecte les types de conflits suivants lors de la synchronisation bidirectionnelle. En raison des différences horaires et de la latence, la prévention des conflits n'est pas garantie. Pour maintenir la cohérence, mettez à jour les enregistrements ayant la même clé primaire ou unique sur un seul cluster à la fois.
| Type de conflit | Condition de déclenchement | Comportement de DTS |
|---|---|---|
| Conflit d'insertion | Des enregistrements avec la même clé primaire sont insérés simultanément dans les deux clusters | Applique la politique de résolution des conflits configurée |
| Mise à jour : enregistrement manquant | L'enregistrement à mettre à jour n'existe pas dans la destination | Convertit l'UPDATE en INSERT, puis applique la politique de résolution des conflits si un conflit de clé survient |
| Mise à jour : conflit de clé | La valeur mise à jour provoque un conflit de clé primaire ou unique dans la destination | Applique la politique de résolution des conflits configurée |
| Suppression : enregistrement manquant | L'enregistrement à supprimer n'existe pas dans la destination | Ignore le DELETE quelle que soit la politique de résolution des conflits |
Politiques de résolution des conflits :
| Politique | Comportement |
|---|---|
| TaskFailed | La tâche s'arrête et passe à l'état d'échec. Une intervention manuelle est requise pour reprendre. |
| Ignore | DTS ignore l'instruction conflictuelle. L'enregistrement existant dans la destination est conservé. |
| Overwrite | DTS écrase l'enregistrement de destination conflictuel avec les données sources. |
Si la tâche est suspendue ou redémarrée et qu'il y a un retard, les politiques de résolution des conflits ne prennent pas effet. DTS écrase les données de destination par défaut dans ce cas.
Objets pris en charge
SCHEMA, TABLE (inclut PRIMARY KEY, UNIQUE KEY, FOREIGN KEY, types de données intégrés et DEFAULT CONSTRAINT)
VIEW et PROCEDURE (PostgreSQL 11 et versions ultérieures) : la prise en charge varie selon le type de base de données de destination. Vérifiez la console pour connaître les options disponibles.
Opérations SQL prises en charge
| Type d'opération | Instructions prises en charge |
|---|---|
| DML (Data Manipulation Language) | INSERT, UPDATE, DELETE |
| DDL (Data Definition Language) | CREATE TABLE, DROP TABLE ; ALTER TABLE (RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULT) ; CREATE INDEX ON TABLE |
Restrictions de synchronisation DDL : Les instructions DDL ne sont pas synchronisées dans les cas suivants :
L'instruction DDL inclut des clauses supplémentaires telles que CASCADE ou RESTRICT.
Une transaction contient à la fois des instructions DML et DDL.
Seule une partie des instructions DDL d'une transaction est incluse dans la tâche de synchronisation.
L'instruction DDL est exécutée à partir d'une session créée par
SET session_replication_role = replica.L'instruction DDL est exécutée en appelant une FUNCTION ou une méthode similaire.
L'instruction DDL ne spécifie pas de schéma (dans ce cas, le schéma
publicest implicite viaSHOW search_path).L'instruction DDL contient
IF NOT EXISTS.
Seules les tâches directes prennent en charge la synchronisation DDL. Les tâches inverses filtrent automatiquement toutes les opérations DDL.
Autorisations des comptes de base de données
| Base de données | Autorisations requises | Comment créer et autoriser |
|---|---|---|
| Cluster source PolarDB for PostgreSQL (Compatible avec Oracle) | Un compte privilégié propriétaire de la base de données | Créer un compte de base de données et Gestion de la base de données |
| Cluster de destination PolarDB for PostgreSQL (Compatible avec Oracle) | Un compte privilégié propriétaire de la base de données | Identique à ci-dessus |
Configurer la synchronisation bidirectionnelle
La synchronisation bidirectionnelle est configurée en deux étapes : d'abord la tâche directe (source vers destination), puis la tâche inverse (destination vers source). La tâche inverse devient disponible une fois que la tâche directe atteint l'état Running.
Étape 1 : Ouvrir la liste des tâches de synchronisation
Accédez à la liste des tâches de synchronisation de l'une des deux manières suivantes.
Console DTS
Connectez-vous à la console DTS.
Dans le volet de navigation de gauche, cliquez sur Data Synchronization.
Dans le coin supérieur gauche, sélectionnez la région où se trouve l'instance de synchronisation.
Console DMS
Les étapes peuvent varier selon le mode et la disposition de la console DMS. Consultez Console en mode simple et Personnaliser la disposition et le style de la console DMS .
Connectez-vous à la console DMS.
Dans la barre de menu supérieure, choisissez Data + AI > DTS (DTS) > Data Synchronization.
À droite de Data Synchronization Tasks, sélectionnez la région de l'instance de synchronisation.
Étape 2 : Créer la tâche directe
Cliquez sur Create Task.
-
Configurez les bases de données source et de destination.
Catégorie Paramètre Description — Task Name DTS génère un nom automatiquement. Spécifiez un nom descriptif pour une identification plus facile. Le nom n'a pas besoin d'être unique. Source Database Select Existing Connection Sélectionnez une instance de base de données enregistrée dans la liste pour remplir automatiquement les champs ci-dessous. Dans la console DMS, ce paramètre est Select a DMS database instance. Si vous n'avez pas enregistré l'instance, remplissez les champs manuellement. Database Type Sélectionnez PolarDB (Compatible with Oracle). Access Method Sélectionnez Alibaba Cloud Instance. Instance Region Sélectionnez la région où réside le cluster source. Replicate Data Across Alibaba Cloud Accounts Sélectionnez No pour une synchronisation au sein du même compte. Instance ID Sélectionnez l'ID du cluster source. Database Name Saisissez le nom de la base de données source. Database Account Saisissez le compte de base de données. Consultez Autorisations des comptes de base de données. Database Password Saisissez le mot de passe du compte. Destination Database Select Existing Connection Identique à la source : sélectionnez une instance enregistrée ou remplissez manuellement. Dans la console DMS, il s'agit de Select a DMS database instance. Database Type Sélectionnez PolarDB (Compatible with Oracle). Connection Type Sélectionnez Alibaba Cloud Instance. Instance Region Sélectionnez la région où réside le cluster de destination. Instance ID Sélectionnez l'ID du cluster de destination. Database Name Saisissez le nom de la base de données de destination. Database Account Saisissez le compte de base de données. Consultez Autorisations des comptes de base de données. Database Password Saisissez le mot de passe du compte. -
Cliquez sur Test Connectivity and Proceed.
Ajoutez les blocs CIDR du serveur DTS aux paramètres de sécurité des deux clusters pour autoriser l'accès DTS. Consultez Ajouter la liste d'autorisation IP des serveurs DTS . Si la source ou la destination utilise une méthode d'accès gérée par l'utilisateur (et non Alibaba Cloud Instance ), cliquez également sur Test Connectivity dans la boîte de dialogue CIDR Blocks of DTS Servers .
-
Sur la page Configure Objects, configurez les paramètres suivants.
Paramètre Description Synchronization Types Sélectionnez Schema Synchronization, Full Data Synchronization et Incremental Data Synchronization. DTS synchronise d'abord les données historiques, puis bascule vers la synchronisation incrémentielle. Processing mode of conflicting tables Precheck and Report Errors : vérifie la présence de tables portant le même nom dans la destination. La tâche ne démarre pas si des conflits sont trouvés. Pour continuer, renommez la table conflictuelle dans la destination ou utilisez le mappage de noms d'objets. Consultez Mappage des noms de colonnes de tables de base de données. Ignore Errors and Proceed : ignore la vérification. Pendant la synchronisation complète, DTS conserve l'enregistrement de destination et ignore l'enregistrement source en cas de conflit de clés. Pendant la synchronisation incrémentielle, DTS écrase l'enregistrement de destination. Si les schémas de table diffèrent, l'initialisation peut échouer. Utilisez avec prudence. Synchronization Topology Sélectionnez Two-way Synchronization. Exclude DDL Operations Sélectionnez Yes pour ignorer la synchronisation DDL dans la tâche directe. Sélectionnez No pour l'inclure. Les tâches inverses filtrent toujours les DDL quel que soit ce paramètre. Conflict Resolution Policy Sélectionnez la manière dont DTS gère les conflits. Consultez Détection des conflits prise en charge pour plus de détails sur chaque politique. Capitalization of Object Names in Destination Instance Configurez la politique de casse pour les noms de base de données, de tables et de colonnes. La valeur par défaut est DTS default policy. Consultez Politique de casse pour les noms d'objets de destination. Source Objects Cliquez sur les objets dans la zone Source Objects, puis cliquez sur l'icône de flèche pour les déplacer vers Selected Objects. Sélectionnez au niveau du schéma ou de la table. La sélection de tables n'inclut pas les vues, les déclencheurs ou les procédures stockées. Si les tables contiennent des types de données SERIAL et que Schema Synchronization est sélectionné, sélectionnez également Sequence ou choisissez la synchronisation du schéma entier. Selected Objects Pour renommer un seul objet dans la destination, faites un clic droit dessus et suivez Mapper un nom d'objet unique. Pour renommer plusieurs objets en masse, cliquez sur Batch Edit et suivez Mapper plusieurs noms d'objets en masse. Pour sélectionner des opérations SQL spécifiques ou définir un filtre WHERE pour une table, faites un clic droit sur la table. Consultez Définir une condition de filtre. Le mappage de noms d'objets peut empêcher la synchronisation correcte des objets dépendants. -
Cliquez sur Next: Advanced Settings et configurez les éléments suivants.
Paramètre Description Dedicated Cluster for Task Scheduling DTS utilise un cluster partagé par défaut. Pour une stabilité accrue, achetez un cluster dédié. Consultez Qu'est-ce qu'un cluster dédié DTS ?. Retry Time for Failed Connections Durée pendant laquelle DTS effectue des tentatives après un échec de connexion. Par défaut : 720 minutes. Plage : 10–1 440 minutes. Recommandé : 30 minutes ou plus. Si la connexion est rétablie dans la fenêtre de nouvelle tentative, la tâche reprend automatiquement. RemarqueLorsque plusieurs instances DTS partagent une source ou une destination, DTS utilise la durée de nouvelle tentative la plus courte configurée parmi toutes les instances. DTS facture le temps d'exécution pendant les nouvelles tentatives.
Retry Time for Other Issues Durée pendant laquelle DTS effectue des tentatives après des erreurs autres que les échecs de connexion (telles que les échecs d'exécution DDL ou DML). Par défaut : 10 minutes. Plage : 1–1 440 minutes. Recommandé : 10 minutes ou plus. Cette valeur doit être inférieure à Retry Time for Failed Connections. Enable Throttling for Full Data Migration Limitez le taux de synchronisation complète pour réduire la charge sur la destination. Définissez QPS to the source database, RPS of Full Data Migration et Data migration speed (MB/s). Disponible uniquement lorsque Full Data Synchronization est sélectionné. Vous pouvez également ajuster le taux après le démarrage de la tâche. Enable Throttling for Incremental Data Synchronization Limitez le taux de synchronisation incrémentielle. Définissez RPS of Incremental Data Synchronization et Data synchronization speed (MB/s). Environment Tag Taguez l'instance pour identifier son environnement. Facultatif. Configure ETL Activez la fonctionnalité extract, transform, and load (ETL) pour transformer les données en transit. Consultez Qu'est-ce que l'ETL ? et Configurer l'ETL. Monitoring and Alerting Configurez des alertes pour les échecs de tâche ou la latence dépassant un seuil. Consultez Configurer la surveillance et les alertes. Cliquez sur Next: Data Validation pour configurer éventuellement une tâche de validation des données. Consultez Configurer la validation des données.
-
Enregistrez la tâche et exécutez le précontrôle.
Pour afficher un aperçu des paramètres API pour cette configuration, placez le curseur sur Next: Data Verification et cliquez sur Preview OpenAPI parameters.
Cliquez sur Next: Data Verification.
DTS exécute un précontrôle avant de démarrer la tâche. La tâche ne démarre que si le précontrôle réussit. En cas d'échec, cliquez sur View Details à côté de l'élément ayant échoué, corrigez le problème et relancez le précontrôle. Pour les avertissements non ignorables, corrigez le problème avant de continuer. Pour les avertissements ignorables, cliquez sur Confirm Alert Details > Ignore > OK , puis cliquez sur Precheck Again .
-
Achetez l'instance de synchronisation. La tâche directe apparaît sur la page de synchronisation des données.
Lorsque Success Rate atteint 100 %, cliquez sur Next: Purchase Instance.
-
Sélectionnez la méthode de facturation et les spécifications de l'instance.
Parameter
Description
Billing Method
Subscription : payez à l'avance pour une durée fixe. Options mensuelles : 1 à 9 mois. Options annuelles : 1, 2, 3 ou 5 ans. Rentable pour les tâches de longue durée. Pay-as-you-go : facturé à l'heure pour l'utilisation réelle. Adapté aux tâches à court terme ou aux tests.
Resource Group Settings
Le groupe de ressources pour l'instance. Par défaut : default resource group. Consultez Qu'est-ce que Resource Management ?.
Instance Class
Détermine les performances de synchronisation. Consultez Spécifications des liens de synchronisation des données.
Cochez la case Data Transmission Service (Pay-as-you-go) Service Terms.
Cliquez sur Purchase and Start, puis cliquez sur OK dans la boîte de dialogue de confirmation.
Si Full Data Synchronization et Incremental Data Synchronization sont tous deux sélectionnés, la tâche est répertoriée comme une seule tâche Incremental Data Synchronization sur la page de liste des tâches.
Étape 3 : Configurer la tâche inverse
Une fois la tâche directe en cours d'exécution, configurez la tâche inverse pour finaliser la configuration bidirectionnelle.
Attendez que le Status de la tâche directe soit Running.
Dans la colonne Actions de la tâche inverse, cliquez sur Configure Task.
-
Configurez la tâche inverse en suivant les mêmes étapes que pour la tâche directe (étapes 2 à 7 ci-dessus). La tâche inverse inverse la source et la destination — les principales différences sont indiquées ci-dessous.
ImportantConfirmez que les informations de l'instance (nom de la base de données, compte et mot de passe) sont correctes pour chaque direction. La source et la destination sont inversées dans la tâche inverse.
Paramètre Tâche directe Tâche inverse Source database Cluster A (source originale) Cluster B (destination originale) Destination database Cluster B (destination originale) Cluster A (source originale) DDL synchronization Configurable via Exclude DDL Operations Toujours filtré automatiquement Processing mode of conflicting tables Vérifie les conflits avec toutes les tables de destination Ne vérifie pas les tables synchronisées par la tâche directe Synchronization objects Votre sélection Doit se trouver dans les Selected Objects de la tâche directe Instance Region Configurable Fixe — ne peut pas être modifié Object name mapping Pris en charge À éviter — peut provoquer une incohérence des données Lorsque Success Rate atteint 100 %, cliquez sur Back.
Attendez que le Status des deux tâches soit Running. La synchronisation de données bidirectionnelle est désormais active.