Utilisez Data Transmission Service (DTS) pour migrer des données d'une instance Amazon RDS for Oracle vers un cluster PolarDB for PostgreSQL (Compatible with Oracle). DTS prend en charge la migration de schéma, la migration complète des données et la migration incrémentielle des données, ce qui vous permet de réaliser la migration avec un temps d'arrêt minimal.
Prérequis
Avant de commencer, assurez-vous que :
L'accès public est activé sur l'instance Amazon RDS for Oracle afin que DTS puisse se connecter via Internet.
L'instance Amazon RDS for Oracle exécute Oracle 9i, 10g, 11g ou 12c (ou version ultérieure) dans une architecture non multitenant.
Le cluster de destination PolarDB for PostgreSQL (Compatible with Oracle) dispose d'un espace de stockage suffisant pour accueillir toutes les données de l'instance source.
Vous connaissez les fonctionnalités et les limites de DTS pour la migration Oracle. Utilisez Advanced Database & Application Migration (ADAM) pour évaluer votre base de données avant la migration. Pour plus de détails, consultez Préparer une base de données Oracle et Vue d'ensemble.
Facturation
| Type de migration | Frais de configuration de l'instance | Frais de transfert de données |
|---|---|---|
| Migration de schéma et migration complète des données | Gratuit | Gratuit |
| Migration incrémentielle des données | Facturé. Consultez Vue d'ensemble de la facturation. | — |
Types de migration
| Type de migration | Description |
|---|---|
| Migration de schéma | Migre les schémas vers le cluster de destination. Types d'objets pris en charge : table, vue, synonyme, déclencheur, procédure stockée, fonction stockée, package et type défini par l'utilisateur. Remarque Dans ce scénario, DTS ne prend pas en charge la migration de schéma pour les déclencheurs. Supprimez tous les déclencheurs de la base de données source avant la migration pour éviter toute incohérence des données. Consultez Configurer une tâche de synchronisation de données pour une base de données source contenant un déclencheur. |
| Migration complète des données | Migre toutes les données existantes de l'instance Amazon RDS for Oracle vers le cluster de destination. N'effectuez pas d'opérations DDL sur les objets migrés pendant l'exécution de la migration de schéma ou de la migration complète des données, sous peine d'échec de la migration de ces objets. |
| Migration incrémentielle des données | Une fois la migration complète des données terminée, DTS interroge continuellement les fichiers de journal redo de la source et applique les modifications incrémentielles à la destination. Cela maintient la destination synchronisée sans interrompre votre application source. |
Opérations SQL prises en charge pour la migration incrémentielle
| Type | Instructions prises en charge |
|---|---|
| DML | INSERT, UPDATE, DELETE |
| DDL | CREATE TABLE (à l'exclusion des instructions contenant des clauses de partitionnement, de sous-partitionnement ou des fonctions ; CREATE TABLE AS SELECT n'est pas pris en charge), ALTER TABLE (ADD COLUMN, ADD INDEX, DROP COLUMN, DROP INDEX, MODIFY COLUMN, RENAME COLUMN), DROP TABLE, RENAME TABLE, TRUNCATE TABLE, CREATE INDEX |
Autorisations requises
| Base de données | Migration de schéma | Migration complète des données | Migration incrémentielle des données |
|---|---|---|---|
| Instance Amazon RDS for Oracle | Propriétaire du schéma | Propriétaire du schéma | Utilisateur principal |
| Cluster PolarDB for PostgreSQL (Compatible with Oracle) | Propriétaire du schéma | — | — |
Pour obtenir des instructions sur la création de comptes et l'attribution d'autorisations, consultez :
Amazon RDS for Oracle : Préparer un compte de base de données, CREATE USER et GRANT
Cluster PolarDB for PostgreSQL (Compatible with Oracle) : Créer un compte de base de données
Limites
Lors de la migration de schéma, DTS migre les clés étrangères de la base de données source vers le cluster de destination. Pendant la migration complète des données et la migration incrémentielle des données, DTS désactive temporairement les vérifications de contraintes et les opérations en cascade sur les clés étrangères au niveau de la session. Si vous effectuez des opérations en cascade ou de suppression sur la base de données source pendant la migration, des incohérences de données peuvent survenir.
Limites de la base de données source
Le serveur de la base de données source doit disposer d'une bande passante sortante suffisante. Une bande passante insuffisante réduit la vitesse de migration.
Pour une base de données Oracle Real Application Cluster (RAC) connectée via Express Connect : spécifiez une adresse IP virtuelle (VIP) au lieu d'une adresse IP Single Client Access Name (SCAN). Après avoir spécifié la VIP, le basculement de nœud n'est pas pris en charge.
Pour une base de données Oracle RAC connectée via Express Connect, VPN Gateway, Smart Access Gateway, Database Gateway ou Cloud Enterprise Network (CEN) : vous pouvez utiliser une seule VIP au lieu d'une adresse IP SCAN lors de la configuration de la base de données source. Après avoir spécifié la VIP, le basculement de nœud n'est pas pris en charge pour la base de données Oracle RAC.
Si un champ VARCHAR2 de la base de données source contient une chaîne vide (qu'Oracle évalue comme null) et que le champ correspondant dans la destination possède une contrainte NOT NULL, la tâche de migration échoue.
-
Les tables à migrer doivent posséder une contrainte PRIMARY KEY ou UNIQUE, avec tous les champs uniques. Sinon, la destination peut contenir des enregistrements en double.
En alternative, activez l'option Add a hidden primary key lors de la configuration de la tâche. DTS utilise la colonne ROWID comme clé primaire masquée pour les tables sans clé primaire ni contrainte UNIQUE.
Pour Oracle 12c ou version ultérieure : les noms de table ne peuvent pas dépasser 30 octets.
Si vous renommez des tables ou des colonnes pendant la migration (migration au niveau de la table) : une seule tâche prend en charge jusqu'à 1 000 tables. Pour plus de 1 000 tables, configurez plusieurs tâches par lots ou migrez la base de données entière.
-
Pour la migration incrémentielle des données :
La journalisation redo et la journalisation des archives doivent être activées sur la source.
Pour une migration uniquement incrémentielle : conservez les journaux redo et les journaux d'archive pendant plus de 24 heures.
Pour une migration complète + incrémentielle : conservez les journaux pendant au moins 7 jours. Une fois la migration complète terminée, vous pouvez réduire la période de conservation à plus de 24 heures.
ImportantSi DTS ne parvient pas à récupérer les journaux redo ou les journaux d'archive, la tâche échoue. Dans des cas extrêmes, une perte de données ou une incohérence peut survenir. Le non-respect des exigences de conservation des journaux signifie que l'accord de niveau de service (SLA) de DTS ne s'applique pas.
Pendant la migration de schéma et la migration complète des données : n'effectuez pas d'opérations DDL sur la base de données source. La tâche échoue si les schémas changent en cours de migration.
Pendant la migration complète uniquement (sans incrémentiel) : n'écrivez pas de données dans la source. Pour garantir la cohérence, exécutez conjointement la migration de schéma, la migration complète des données et la migration incrémentielle des données.
Ne mettez pas à jour les champs LONGTEXT pendant la migration. La tâche échoue si les champs LONGTEXT sont modifiés.
Autres limites
Exécutez les migrations pendant les heures creuses. DTS utilise les ressources de lecture et d'écriture à la fois sur la source et la destination, ce qui peut augmenter la charge de la base de données.
Après la migration complète, l'espace de tablespace du cluster de destination est plus grand que celui de la base de données source en raison de la fragmentation causée par les opérations INSERT concurrentes.
DTS retente automatiquement les tâches ayant échoué pendant une durée maximale de 7 jours. Avant de basculer les charges de travail vers la destination, arrêtez ou libérez toutes les tâches ayant échoué. Sinon, une tâche reprise risque d'écraser les données de destination avec les données source. Vous pouvez également exécuter l'instruction
REVOKEpour révoquer les autorisations d'écriture des comptes DTS sur la destination.Le cluster de destination génère des index uniques (tels que
pg_oid_1498503_index) pour correspondre aux valeurs ROWID. La destination aura donc plus d'index que la source.Le cluster de destination ne prend pas en charge le caractère de fin de chaîne
\0. DTS ignore ce caractère lors de l'écriture, ce qui entraîne une incohérence entre la source et la destination.Les contraintes CHECK de la base de données Oracle source sont converties en contraintes NOT NULL dans le cluster de destination.
Les jeux de caractères des bases de données source et de destination doivent être compatibles. Des jeux de caractères incompatibles entraînent une incohérence ou l'échec de la tâche.
Utilisez la fonctionnalité de migration de schéma de DTS. Ignorer la migration de schéma peut entraîner l'échec de la tâche en raison de types de données incompatibles.
Les fuseaux horaires des bases de données source et de destination doivent être identiques.
Les objets de type personnalisé peuvent être migrés. Les objets intégrés Oracle ne peuvent pas être migrés, mais PolarDB for PostgreSQL (Compatible with Oracle) prend déjà nativement en charge les objets intégrés Oracle — aucune migration manuelle n'est nécessaire.
DTS ne valide pas les métadonnées telles que les séquences. Validez les séquences manuellement après la migration.
-
Après avoir basculé les charges de travail vers la destination, les nouvelles séquences écrites ne reprennent pas automatiquement à partir de la valeur de séquence maximale de la source. Avant le basculement, interrogez les valeurs de séquence maximales dans la source et définissez-les comme valeurs de départ dans la destination. Exécutez le bloc PL/SQL suivant dans la base de données source pour générer les instructions
setval:La sortie contient les instructions
setvalpour toutes les séquences de la base de données source. Exécutez uniquement les instructions pertinentes pour votre migration.DECLARE CURSOR cur_data IS SELECT SEQUENCE_NAME, LAST_NUMBER FROM user_sequences; v_column1_value varchar(1000); v_column2_value number(20); BEGIN OPEN cur_data; LOOP FETCH cur_data INTO v_column1_value, v_column2_value; EXIT WHEN cur_data%NOTFOUND; DBMS_OUTPUT.PUT_LINE('select setval(''' || lower(v_column1_value) || ''', ' || v_column2_value || ');'); END LOOP; CLOSE cur_data; END; /
Mappings de types de données
Pour les mappings de types de données entre Oracle et PolarDB for PostgreSQL (Compatible with Oracle), consultez Mappings de types de données entre bases de données hétérogènes.
Configurer la base de données source
Effectuez les étapes suivantes avant de créer la tâche de migration DTS.
Étape 1 : Ajouter les blocs CIDR du serveur DTS au groupe de sécurité
Connectez-vous à la console de gestion Amazon RDS.
Accédez à la page d'informations de base de l'instance Amazon RDS for Oracle.
-
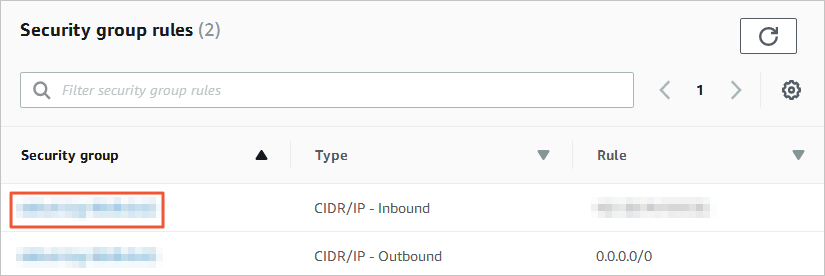
Dans la section Security group rules, cliquez sur le nom du groupe de sécurité contenant la règle entrante existante.
-
Ajoutez les blocs CIDR des serveurs DTS pour la région de la base de données de destination (port 1521) à la règle entrante. Consultez Ajouter les blocs CIDR des serveurs DTS.
Ajoutez uniquement les blocs CIDR de la région où réside la base de données de destination. Par exemple, si la source se trouve à Singapour et la destination en Chine (Hangzhou), ajoutez uniquement les blocs CIDR de Chine (Hangzhou). Vous pouvez ajouter tous les blocs CIDR requis en une seule fois.
Étape 2 : Configurer les paramètres de journal (migration incrémentielle uniquement)
Ignorez cette étape si vous n'effectuez pas de migration incrémentielle des données.
Sélectionnez la configuration correspondant à votre version d'Oracle :
Oracle 12c ou version ultérieure (architecture non multitenant)
Connectez-vous à l'instance Amazon RDS for Oracle à l'aide du compte utilisateur principal et de SQL*Plus.
-
Vérifiez si la journalisation des archives est activée :
SELECT LOG_MODE FROM v$database;Si le résultat est
ARCHIVELOG, la journalisation des archives est déjà activée. Sinon, activez-la avant de continuer. -
Définissez la période de rétention des journaux d'archive sur au moins 72 heures :
-- Check the current configuration exec rdsadmin.rdsadmin_util.show_configuration; -- Set retention to 72 hours exec rdsadmin.rdsadmin_util.set_configuration('archivelog retention hours', 72); -
Activez la journalisation supplémentaire. Choisissez la journalisation supplémentaire au niveau de la base de données ou au niveau de la table :
-
Niveau base de données (recommandé pour la migration de base de données complète) :
-- Check current supplemental logging status SELECT supplemental_log_data_min, supplemental_log_data_pk, supplemental_log_data_ui FROM v$database; -- Enable primary key and unique key supplemental logging exec rdsadmin.rdsadmin_util.alter_supplemental_logging('ADD', 'PRIMARY KEY'); exec rdsadmin.rdsadmin_util.alter_supplemental_logging('ADD', 'UNIQUE'); -
Niveau table (utilisez l'une des options) :
-- Option 1: Enable supplemental logging for all columns exec rdsadmin.rdsadmin_util.alter_supplemental_logging('ADD', 'ALL'); -- Option 2: Enable primary key supplemental logging only exec rdsadmin.rdsadmin_util.alter_supplemental_logging('ADD', 'PRIMARY KEY');
-
-
Créez un compte de base de données et accordez les autorisations requises. L'exemple suivant crée un compte nommé
RDSDT_DTSACCT:-- Create the DTS account create user RDSDT_DTSACCT IDENTIFIED BY RDSDT_DTSACCT; grant create session to RDSDT_DTSACCT; grant connect to RDSDT_DTSACCT; grant resource to RDSDT_DTSACCT; -- Permissions for reading log mining views exec rdsadmin.rdsadmin_util.grant_sys_object('V_$LOGMNR_LOGS','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('V_$LOGMNR_CONTENTS','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('DBMS_LOGMNR','RDSDT_DTSACCT','EXECUTE'); -- Permissions for reading object metadata exec rdsadmin.rdsadmin_util.grant_sys_object('ALL_OBJECTS','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('ALL_TAB_COLS','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('DBA_REGISTRY','RDSDT_DTSACCT','SELECT'); grant select any table to RDSDT_DTSACCT; grant select any transaction to RDSDT_DTSACCT; -- Permissions for reading log-related views exec rdsadmin.rdsadmin_util.grant_sys_object('V_$LOG','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('V_$LOGFILE','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('V_$ARCHIVED_LOG','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('V_$PARAMETER','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('V_$DATABASE','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('V_$ACTIVE_INSTANCES','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('V_$INSTANCE','RDSDT_DTSACCT','SELECT'); -- Permissions for reading internal dictionary tables exec rdsadmin.rdsadmin_util.grant_sys_object('USER$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('OBJ$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('COL$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('IND$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('ICOL$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('CDEF$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('CCOL$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('TABPART$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('TABSUBPART$','RDSDT_DTSACCT','SELECT'); exec rdsadmin.rdsadmin_util.grant_sys_object('TABCOMPART$','RDSDT_DTSACCT','SELECT'); -- Additional privileges grant LOGMINING TO RDSDT_DTSACCT; grant EXECUTE_CATALOG_ROLE to RDSDT_DTSACCT; grant select on v$database to rdsdt_dtsacct; grant select on dba_objects to rdsdt_dtsacct; grant select on DBA_TAB_COMMENTS to rdsdt_dtsacct; grant select on dba_tab_cols to rdsdt_dtsacct; grant select_catalog_role TO rdsdt_dtsacct;
Oracle 9i, 10g ou 11g
Connectez-vous à l'instance Amazon RDS for Oracle à l'aide du compte utilisateur principal et de SQL*Plus.
-
Vérifiez si l'instance s'exécute en mode ARCHIVELOG :
archive log list;Si l'instance est en mode NOARCHIVELOG, passez en mode ARCHIVELOG avant de continuer. Consultez Gestion des journaux redo archivés.
-
Activez la journalisation forcée :
exec rdsadmin.rdsadmin_util.force_logging(p_enable => true); -
Activez la journalisation supplémentaire pour les clés primaires et uniques :
begin rdsadmin.rdsadmin_util.alter_supplemental_logging(p_action => 'ADD',p_type => 'PRIMARY KEY');end;/ begin rdsadmin.rdsadmin_util.alter_supplemental_logging(p_action => 'ADD',p_type => 'UNIQUE');end;/ -
Définissez la période de rétention des journaux d'archive sur au moins 24 heures :
begin rdsadmin.rdsadmin_util.set_configuration(name => 'archivelog retention hours', value => '24');end;/ -
Validez les modifications :
commit;
Créer la tâche de migration
-
Accédez à la page Tâches de migration de données.
Connectez-vous à la console Data Management (DMS).
Dans la barre de navigation supérieure, cliquez sur DTS.
Dans le volet de navigation de gauche, choisissez DTS (DTS) > Data Migration.
Vous pouvez également accéder directement à la page Tâches de migration de données de la nouvelle console DTS . Pour plus de détails sur la navigation dans la console, consultez Mode simple et Personnaliser la disposition et le style de la console DMS .
-
Dans la liste déroulante située à côté de Tâches de migration de données, sélectionnez la région où réside l'instance de migration de données.
Dans la nouvelle console DTS, sélectionnez la région dans le coin supérieur gauche.
-
Cliquez sur Create Task. Dans l'assistant Create Data Migration Task, configurez les bases de données source et de destination.
AvertissementAprès avoir configuré les bases de données source et de destination, examinez les Limits affichées en haut de la page avant de continuer. Ignorer cette étape peut entraîner l'échec de la tâche ou une incohérence des données.
Paramètres de la base de données source
Paramètre Description Task Name Nom descriptif de la tâche. DTS génère automatiquement un nom. L'unicité n'est pas requise. Select an existing DMS database instance Facultatif. Sélectionnez une instance enregistrée existante pour remplir automatiquement les paramètres de connexion, ou configurez-les manuellement. Database Type Sélectionnez Oracle. Access Method Sélectionnez Public IP Address. Instance Region Région où réside l'instance Amazon RDS for Oracle. Si la région ne figure pas dans la liste, sélectionnez la région géographiquement la plus proche. Domain Name or IP Endpoint de l'instance Amazon RDS for Oracle. Port Number Port de service. Par défaut : 1521. Oracle Type Sélectionnez Non-RAC Instance pour configurer le paramètre SID, ou RAC or PDB Instance pour configurer le paramètre Service Name. Cet exemple utilise Non-RAC Instance. Database Account Compte de base de données pour l'instance source. Consultez Autorisations requises. Database Password Mot de passe du compte de base de données. Paramètres de la base de données de destination
Paramètre Description Select an existing DMS database instance Facultatif. Sélectionnez une instance enregistrée existante pour remplir automatiquement les paramètres de connexion, ou configurez-les manuellement. Database Type Sélectionnez PolarDB (Compatible with Oracle). Access Method Sélectionnez Alibaba Cloud Instance. Instance Region Région où réside le cluster de destination PolarDB for PostgreSQL (Compatible with Oracle). Instance ID ID du cluster de destination. Database Name Nom de la base de données de destination dans le cluster. Database Account Compte de base de données pour le cluster de destination. Consultez Autorisations requises. Database Password Mot de passe du compte de base de données. -
Cliquez sur Test Connectivity and Proceed. Si votre base de données source possède une liste d'autorisation d'adresses IP configurée, ajoutez les blocs CIDR des serveurs DTS à la liste d'autorisation, puis cliquez sur Test Connectivity and Proceed.
AvertissementL'ajout de blocs CIDR de serveurs DTS à une liste d'autorisation d'adresses IP ou aux règles de groupe de sécurité introduit une exposition réseau. Prenez des mesures préventives, notamment : renforcer les identifiants de compte, restreindre les ports exposés, authentifier les appels API, auditer régulièrement les règles de liste d'autorisation et supprimer les blocs CIDR non autorisés. Pour une connectivité privée, envisagez d'utiliser Express Connect, VPN Gateway ou Smart Access Gateway.
-
Configurez les objets à migrer et les paramètres de migration.
Paramètre Description Migration Types Sélectionnez les types de migration à exécuter. Pour migrer sans temps d'arrêt, sélectionnez conjointement Schema Migration, Full Data Migration et Incremental Data Migration. Pour une migration avec basculement ponctuel, sélectionnez uniquement Schema Migration et Full Data Migration. RemarqueSans migration incrémentielle, n'écrivez pas de données dans la source pendant la migration.
Add a hidden primary key for a table without a primary key/a table without a unique key Définissez sur Yes si les objets à migrer contiennent des tables sans clé primaire ni clé unique. DTS utilise la colonne ROWID comme clé primaire masquée pour éviter les données en double. Disponible uniquement lorsque les trois types de migration sont sélectionnés. Processing Mode of Conflicting Tables Precheck and Report Errors : vérifie la présence de tables portant des noms identiques dans la source et la destination avant le démarrage. La tâche ne démarre que si aucun conflit n'est détecté. Ignore Errors and Proceed : ignore la vérification préalable. AvertissementLa sélection de cette option peut entraîner une incohérence des données. Plus précisément : si les bases de données source et de destination ont le même schéma, DTS ne migre pas les enregistrements de données ayant les mêmes clés primaires que les enregistrements déjà présents dans la base de données de destination ; si les bases de données source et de destination ont des schémas différents, seules certaines colonnes sont migrées ou la tâche de migration échoue. Procédez avec prudence.
Source Objects Sélectionnez des colonnes, des tables ou des bases de données et cliquez sur l'icône pour les déplacer vers Selected Objects. Selected Objects Pour renommer un seul objet, faites un clic droit dessus. Consultez Mapper le nom d'un seul objet. Pour renommer plusieurs objets à la fois, cliquez sur Batch Edit. Consultez Mapper plusieurs noms d'objets à la fois. RemarqueLe renommage d'un objet peut empêcher la migration des objets dépendants. Pour filtrer les lignes par condition, faites un clic droit sur une table et spécifiez les conditions WHERE. Consultez Définir des conditions de filtre.
-
Cliquez sur Next: Advanced Settings et configurez les options avancées.
Paramètre Description Data Verification Settings Configurez la vérification des données pour contrôler la cohérence entre la source et la destination après la migration. Consultez Configurer la vérification des données. Select the dedicated cluster used to schedule the task Par défaut, DTS planifie la tâche sur un cluster partagé. Pour utiliser un cluster dédié, achetez-en un à l'avance. Consultez Qu'est-ce qu'un cluster dédié DTS ? Retry Time for Failed Connections Durée pendant laquelle DTS effectue des nouvelles tentatives lorsque la source ou la destination est inaccessible. Valeurs valides : 10–1440 minutes. Par défaut : 720. Définissez cette valeur sur au moins 30 minutes. Si DTS se reconnecte dans la fenêtre de nouvelle tentative, la tâche reprend. Sinon, la tâche échoue. RemarqueLorsque plusieurs tâches partagent la même source ou la même destination, la valeur définie le plus récemment prévaut. Le délai de nouvelle tentative engendre des frais d'instance DTS.
The wait time before a retry when other issues occur in the source and destination databases. Durée pendant laquelle DTS effectue des nouvelles tentatives après des échecs DDL ou DML. Valeurs valides : 1–1440 minutes. Par défaut : 10. Définissez cette valeur sur au moins 10 minutes et inférieure à la valeur de Retry Time for Failed Connections. Enable Throttling for Full Data Migration Limite les requêtes par seconde (QPS), les requêtes par seconde (RPS) et la vitesse de migration (Mo/s) pour réduire la charge sur la destination pendant la migration complète. Disponible uniquement lorsque Full Data Migration est sélectionné. Enable Throttling for Incremental Data Migration Limite les RPS et la vitesse de migration (Mo/s) pendant la migration incrémentielle. Disponible uniquement lorsque Incremental Data Migration est sélectionné. Environment Tag Étiquette facultative pour identifier l'instance DTS par environnement (par exemple, production ou staging). Actual Write Code Format d'encodage utilisé lors de l'écriture des données dans la destination. Sélectionnez en fonction du jeu de caractères de votre base de données de destination. Configure ETL Sélectionnez Yes pour activer l'extraction, la transformation et le chargement (ETL) et saisissez les instructions de traitement des données. Consultez Configurer ETL dans une tâche de migration ou de synchronisation de données et Qu'est-ce que l'ETL ? Monitoring and Alerting Sélectionnez Yes pour recevoir des alertes en cas d'échec de la tâche ou si la latence de migration dépasse un seuil. Configurez le seuil et les paramètres de notification. Consultez Configurer la surveillance et les alertes lors de la création d'une tâche DTS. -
Cliquez sur Next: Save Task Settings and Precheck.
DTS exécute une vérification préalable avant que la tâche de migration ne puisse démarrer. Si la vérification préalable échoue, cliquez sur View Details à côté de chaque élément ayant échoué, résolvez les problèmes, puis cliquez sur Precheck Again . Si un élément génère une alerte pouvant être ignorée, cliquez sur Confirm Alert Details , puis sur Ignore dans la boîte de dialogue des détails, puis cliquez sur Precheck Again . Sachez qu'ignorer une alerte peut entraîner une incohérence des données. Pour afficher un aperçu des paramètres API pour cette configuration de tâche, survolez Next: Save Task Settings and Precheck et cliquez sur Preview OpenAPI parameters .
Attendez que le taux de réussite de la vérification préalable atteigne 100 %, puis cliquez sur Next: Purchase Instance.
-
Sur la page Purchase Instance, configurez la classe d'instance.
Paramètre Description Resource Group Settings Groupe de ressources pour l'instance de migration de données. Par défaut : groupe de ressources par défaut. Consultez Qu'est-ce que Resource Management ? Instance Class La classe d'instance détermine le débit de migration. Sélectionnez en fonction de votre charge de travail. Consultez Spécifications des instances de migration de données. Cochez la case Data Transmission Service (Pay-as-you-go) Service Terms.
Cliquez sur Buy and Start. Surveillez la progression de la tâche dans la liste des tâches.
Étapes suivantes
Supprimer la clé primaire masquée (le cas échéant)
Si vous avez activé l'option Add a hidden primary key et que vous avez basculé vos charges de travail vers le cluster de destination, supprimez la clé primaire masquée avant de terminer ou de libérer l'instance DTS :
Sur la page des détails de la tâche, accédez à l'onglet Basic Information du module Full Data Migration ou Incremental Write.
Dans la colonne Actions, cliquez sur Delete Invisible Primary Key.
Après avoir supprimé la clé primaire masquée, vérifiez que les données des bases de données source et de destination sont identiques.
Synchroniser les valeurs de départ des séquences
Après le basculement des charges de travail, les nouvelles séquences écrites dans la destination ne reprennent pas automatiquement à partir des valeurs maximales de la source. Exécutez le bloc PL/SQL indiqué dans la section Limites pour générer les instructions setval pour les séquences source, puis exécutez les instructions applicables dans la base de données de destination.