Data Transmission Service (DTS) vous permet de synchroniser les données d'une instance ApsaraDB RDS for PostgreSQL vers une autre en temps réel. Utilisez ce flux de travail lorsque vous avez besoin d'instances de secours pour la reprise après sinistre, de réplicas en lecture pour la séparation lecture/écriture, d'une migration de base de données inter-comptes ou d'une instance d'analyse distincte qui reste synchronisée avec la production.
DTS prend en charge trois phases de synchronisation — synchronisation du schéma, synchronisation complète des données et synchronisation incrémentielle des données — ainsi que quatre topologies unidirectionnelles : un-à-un, un-à-plusieurs, en cascade et plusieurs-à-un.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Les instances source et destination ApsaraDB RDS for PostgreSQL sont créées. Consultez la rubrique Créer une instance ApsaraDB RDS for PostgreSQL.
La version de l'instance de destination doit être identique ou supérieure à celle de la source. Une version de destination plus ancienne peut entraîner des erreurs de compatibilité.
Un espace de stockage libre suffisant sur l'instance de destination ; il doit dépasser la taille totale des données de l'instance source.
Le paramètre
wal_levelde l'instance source est défini surlogical.-
La rétention des journaux WAL est configurée comme suit :
Synchronisation incrémentielle des données uniquement : conservez les journaux WAL pendant plus de 24 heures.
Synchronisation complète des données + synchronisation incrémentielle des données : conservez les journaux WAL pendant au moins sept jours. Une fois la synchronisation complète des données terminée, vous pouvez réduire la période de rétention à plus de 24 heures.
Si les journaux WAL ne sont pas conservés assez longtemps, DTS peut échouer à les lire, ce qui entraîne l'échec de la tâche et potentiellement une incohérence ou une perte de données. Assurez-vous de définir la période de rétention des journaux WAL conformément aux exigences précédentes. Dans le cas contraire, la fiabilité ou les performances du service garanties par l'accord de niveau de service (SLA) de DTS pourraient ne pas être assurées.
Pour connaître les combinaisons de versions source et destination prises en charge, consultez la rubrique Présentation des scénarios de synchronisation des données.
Facturation
| Type de synchronisation | Frais |
|---|---|
| Synchronisation du schéma et synchronisation complète des données | Gratuit |
| Synchronisation incrémentielle des données | Facturé. Consultez la rubrique Présentation de la facturation. |
Limites
Examinez ces limites avant de commencer.
Exigences relatives à la base de données source
-
Les tables doivent posséder une contrainte PRIMARY KEY ou UNIQUE, avec tous les champs uniques. Sans ces contraintes, la base de données de destination peut contenir des enregistrements en double.
Si vous créez la tâche de synchronisation sans sélectionner Schema Synchronization , la table de destination doit avoir les mêmes contraintes PRIMARY KEY ou NOT NULL UNIQUE que la table source. Sinon, des enregistrements en double peuvent apparaître.
Si vous sélectionnez des tables comme objets de synchronisation et souhaitez renommer des tables ou des colonnes dans la destination, une seule tâche prend en charge un maximum de 5 000 tables. Pour plus de 5 000 tables, répartissez la charge de travail sur plusieurs tâches ou synchronisez au niveau de la base de données plutôt qu'au niveau de la table.
DTS ne peut pas synchroniser les tables temporaires, les déclencheurs internes ni certaines procédures et fonctions internes écrites en C. DTS peut synchroniser les paramètres personnalisés des types COMPOSITE, ENUM et RANGE. Les tables doivent avoir des contraintes PRIMARY KEY, FOREIGN KEY, UNIQUE ou CHECK.
-
DTS crée un slot de réplication préfixé par
dts_sync_sur la base de données source, donnant à DTS accès aux journaux incrémentiels des 15 dernières minutes. L'accumulation de slots de réplication peut épuiser l'espace disque. Configurez une alerte d'utilisation du disque sur l'instance source lorsque la réplication logique est active. Comportement de nettoyage des slots de réplication :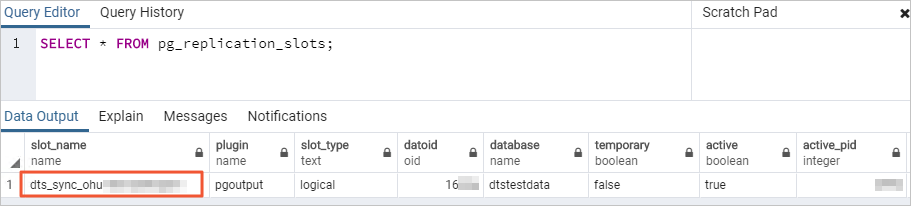
Après la libération de l'instance DTS, le slot est supprimé automatiquement, sauf si vous avez modifié le mot de passe de la base de données source ou retiré les adresses IP de DTS de la liste d'autorisation IP, auquel cas vous devez supprimer le slot manuellement.
En cas de basculement primaire/secondaire sur la source, connectez-vous à la base de données secondaire et supprimez le slot manuellement.
DTS crée les tables temporaires suivantes dans la base de données source pour capturer les instructions DDL, les schémas de table incrémentiels et les informations de pulsation. Ne les supprimez pas pendant l'exécution de la synchronisation ; elles sont supprimées automatiquement lors de la libération de l'instance DTS :
public.dts_pg_class,public.dts_pg_attribute,public.dts_pg_type,public.dts_pg_enum,public.dts_postgres_heartbeat,public.dts_ddl_command,public.dts_args_sessionDTS ajoute une table de pulsation nommée
dts_postgres_heartbeatà la base de données source pour suivre avec précision la latence de synchronisation.Pour effectuer un basculement primaire/secondaire sur l'instance source ApsaraDB RDS for PostgreSQL sans interrompre la synchronisation, activez d'abord la fonctionnalité Logical Replication Slot Failover. Consultez la rubrique Logical Replication Slot Failover.
Si une modification incrémentielle unique des données dépasse 256 Mo, l'instance de synchronisation en cours d'exécution échoue et ne peut pas être récupérée ; vous devez reconfigurer la tâche.
Pendant la synchronisation du schéma et la synchronisation complète des données, n'exécutez pas d'instructions DDL qui modifient les schémas de base de données ou de tables. La tâche échouerait dans ce cas.
Si la base de données source contient des transactions de longue durée pendant la synchronisation incrémentielle des données, les journaux WAL générés avant la validation de ces transactions peuvent s'accumuler et épuiser l'espace disque.
Si une mise à niveau majeure de version est effectuée sur la base de données source pendant l'exécution d'une instance de synchronisation, l'instance échoue et ne peut pas être récupérée ; vous devez reconfigurer la tâche.
Autres exigences
Une seule tâche synchronise les données d'une seule base de données. Pour synchroniser plusieurs bases de données, créez une tâche distincte pour chacune.
DTS ne peut pas synchroniser les tables ayant des relations d'héritage entre différents schémas.
-
Si vous sélectionnez un schéma comme objet de synchronisation, exécutez l'instruction suivante avant d'écrire des données dans toute nouvelle table ou table renommée de ce schéma :
ALTER TABLE schema.table REPLICA IDENTITY FULL;Remplacez
schemaettablepar les noms réels. Exécutez cette instruction pendant les heures creuses et évitez de verrouiller la table ; un verrouillage lors de l'exécution de cette instruction peut provoquer un interblocage. DTS ne valide pas les métadonnées telles que les séquences. Vérifiez manuellement la validité des séquences.
Avant de basculer les charges de travail vers la base de données de destination, mettez à jour la valeur de départ des séquences dans la destination. Après le basculement, les nouvelles séquences écrites ne continuent pas à partir de la valeur maximale de la source.
Lorsque le compte de destination est un compte privilégié ou superutilisateur et que les tables synchronisées contiennent des clés étrangères, des déclencheurs ou des déclencheurs d'événements, DTS définit temporairement
session_replication_rolesurreplicaau niveau de la session. Si le compte de destination ne dispose pas des autorisations requises, définissez ce paramètre manuellement surreplica. Les opérations UPDATE ou DELETE en cascade sur la source pendant cette période peuvent entraîner une incohérence des données. Après la libération de la tâche, redéfinissez le paramètre surorigin.L'écriture de données provenant d'autres sources dans la base de données de destination pendant la synchronisation provoque une incohérence des données. Par exemple, l'exécution d'instructions DDL en ligne depuis DMS pendant que d'autres sources écrivent dans la base de données de destination peut entraîner une perte de données.
En cas d'échec d'une tâche, le support technique DTS tentera de la restaurer sous 8 heures. Pendant la restauration, la tâche peut être redémarrée et les paramètres de la tâche (et non les paramètres de la base de données) peuvent être modifiés.
Exigences pour des types spécifiques de bases de données sources
Source ApsaraDB RDS for PostgreSQL
Ne modifiez pas le point de terminaison ni la zone de l'instance source pendant l'exécution de la synchronisation. Cela entraînerait l'échec de la tâche.
Source PostgreSQL géré soi-même
Les valeurs de max_wal_senders et de max_replication_slots doivent chacune être supérieures à la somme du nombre de slots de réplication actuellement utilisés et du nombre d'instances DTS que vous prévoyez de créer pour cette base de données.
Source Cloud SQL for PostgreSQL (Google Cloud)
Définissez Database Account sur un compte disposant de l'autorisation cloudsqlsuperuser. Lors de la sélection des objets à synchroniser, choisissez uniquement les objets que le compte est autorisé à gérer, ou accordez l'autorisation OWNER sur ces objets au compte.
Un compte disposant de l'autorisation cloudsqlsuperuser ne peut pas gérer les données appartenant à d'autres comptes disposant de la même autorisation.
Objets pris en charge
| Type d'objet | Détails |
|---|---|
| SCHEMA et TABLE | Inclut PRIMARY KEY, UNIQUE KEY, FOREIGN KEY, types de données intégrés et contraintes DEFAULT |
| VIEW, PROCEDURE, FUNCTION, RULE, SEQUENCE, EXTENSION, TRIGGER, AGGREGATE, INDEX, OPERATOR, DOMAIN | PROCEDURE nécessite PostgreSQL V11 ou version ultérieure |
Opérations SQL pouvant être synchronisées
| Type | Instructions |
|---|---|
| DML | INSERT, UPDATE, DELETE |
| DDL | Voir ci-dessous |
La synchronisation DDL est disponible uniquement pour les tâches créées après le 1er octobre 2020.
Pour les tâches créées avant le 12 mai 2023, vous devez créer des déclencheurs et des fonctions dans la base de données source pour capturer les informations DDL avant de configurer la tâche. Consultez la rubrique Utiliser des déclencheurs et des fonctions pour implémenter la migration DDL incrémentielle pour les bases de données PostgreSQL.
La synchronisation DDL nécessite un compte de base de données privilégié sur l'instance source avec une version mineure du moteur 20210228 ou ultérieure. Pour mettre à jour la version mineure, consultez la rubrique Mettre à jour la version mineure du moteur.
Instructions DDL prises en charge :
CREATE TABLE et DROP TABLE
ALTER TABLE : RENAME TABLE, ADD COLUMN, ADD COLUMN DEFAULT, ALTER COLUMN TYPE, DROP COLUMN, ADD CONSTRAINT, ADD CONSTRAINT CHECK, ALTER COLUMN DROP DEFAULT
TRUNCATE TABLE (uniquement pour la version PostgreSQL géré soi-même 11 ou ultérieure de la source)
CREATE INDEX ON TABLE
Limites DDL :
Pour utiliser une tâche de synchronisation des données créée avant le 12 mai 2023 afin de synchroniser des opérations DDL, vous devez créer des déclencheurs et des fonctions dans la base de données source pour capturer les informations DDL avant de configurer la tâche de synchronisation des données. Pour plus d'informations, consultez la rubrique Utiliser des déclencheurs et des fonctions pour implémenter la migration DDL incrémentielle pour les bases de données PostgreSQL.
Les données de type BIT ne peuvent pas être synchronisées lors de la synchronisation incrémentielle des données.
Les clauses DDL supplémentaires telles que CASCADE ou RESTRICT ne sont pas synchronisées.
Les instructions DDL provenant de sessions exécutant
SET session_replication_role = replicane sont pas synchronisées.Les instructions DDL exécutées en appelant des fonctions ne sont pas synchronisées.
Si une transaction contient à la fois des instructions DML et DDL, les instructions DDL ne sont pas synchronisées.
Les instructions DDL pour les objets en dehors de la portée de synchronisation ne sont pas synchronisées.
Créer une tâche de synchronisation
Étape 1 : Ouvrir la page de synchronisation des données
Utilisez la console DTS ou la console DMS.
Console DTS
Connectez-vous à la console DTS.Console DTS
Dans le volet de navigation de gauche, cliquez sur Data Synchronization.
Dans le coin supérieur gauche, sélectionnez la région où réside l'instance de synchronisation.
Console DMS
Remarque
Les étapes peuvent varier selon le mode et la disposition de la console DMS. Consultez les rubriques
et
Personnaliser la disposition et le style de la console DMS
.
Connectez-vous à la console DMS.Console DMS
Dans la barre de navigation supérieure, placez le pointeur sur Data + AI et choisissez DTS (DTS) > Data Synchronization.
Dans la liste déroulante à droite de Data Synchronization Tasks, sélectionnez la région où réside l'instance de synchronisation.
Étape 2 : Créer la tâche
Cliquez sur Create Task.
-
Si la page affiche un bouton New Configuration Page dans le coin supérieur droit, cliquez dessus.
Ignorez cette étape si Back to Previous Version est affiché à la place. Les pages de configuration nouvelle et précédente peuvent différer légèrement ; utilisez la nouvelle version.
Étape 3 : Configurer les bases de données source et de destination
Après avoir configuré les deux bases de données, lisez les Limits affichées sur la page. Ignorer cette étape peut entraîner l'échec de la tâche ou une incohérence des données.
|
Section |
Paramètre |
Description |
|
N/A |
Task Name |
DTS génère automatiquement un nom de tâche. Nous vous recommandons de spécifier un nom descriptif pour une identification facile. Le nom n'a pas besoin d'être unique. |
|
Source Database |
Database Type |
Le type de la base de données source. Sélectionnez PostgreSQL. |
|
Connection Type |
La méthode d'accès à la base de données source. Sélectionnez Alibaba Cloud Instance. |
|
|
Instance Region |
La région dans laquelle réside l'instance ApsaraDB RDS for PostgreSQL source. |
|
|
Replicate Data Across Alibaba Cloud Accounts |
Cet exemple utilise une instance de base de données appartenant au compte Alibaba Cloud actuel. Sélectionnez No. |
|
|
Instance ID |
L'ID de l'instance ApsaraDB RDS for PostgreSQL source. |
|
|
Database Name |
Le nom de la base de données à partir de laquelle les objets sont synchronisés dans l'instance ApsaraDB RDS for PostgreSQL source. |
|
|
Database Account |
Le compte de base de données de l'instance ApsaraDB RDS for PostgreSQL source. Spécifiez un compte privilégié qui est le propriétaire de la base de données. Pour plus d'informations sur la création d'un compte pour une instance ApsaraDB RDS for PostgreSQL et l'octroi d'autorisations au compte, consultez les rubriques Créer un compte et Créer une base de données. Remarque
Si l'instance source est une instance ApsaraDB RDS for PostgreSQL V9.4 et que vous souhaitez synchroniser uniquement les opérations DML, seule l'autorisation REPLICATION est requise pour le compte de base de données. |
|
|
Database Password |
Saisissez le mot de passe correspondant au compte de base de données. |
|
|
Encryption |
Indique s'il faut chiffrer la connexion à la base de données source. Vous pouvez configurer ce paramètre en fonction de vos besoins métier. Dans cet exemple, Non-encrypted est sélectionné. Si vous souhaitez établir une connexion chiffrée SSL à la base de données source, effectuez les étapes suivantes : Sélectionnez SSL-encrypted, téléchargez CA Certificate, Client Certificate et Private Key of Client Certificate selon les besoins, puis spécifiez Private Key Password of Client Certificate. Remarque
|
|
|
Destination Database |
Database Type |
Le type de la base de données de destination. Sélectionnez PostgreSQL. |
|
Connection Type |
La méthode d'accès à la base de données de destination. Sélectionnez Alibaba Cloud Instance. |
|
|
Instance Region |
La région dans laquelle réside l'instance ApsaraDB RDS for PostgreSQL de destination. |
|
|
Instance ID |
L'ID de l'instance ApsaraDB RDS for PostgreSQL de destination. |
|
|
Database Name |
Le nom de la base de données vers laquelle les objets sont synchronisés dans l'instance ApsaraDB RDS for PostgreSQL de destination. |
|
|
Database Account |
Le compte de base de données de l'instance ApsaraDB RDS for PostgreSQL de destination. Le compte doit disposer des autorisations de propriétaire sur les schémas. Pour savoir comment créer un compte pour une instance ApsaraDB RDS for PostgreSQL et lui accorder des autorisations, consultez la rubrique Créer un compte. |
|
|
Database Password |
Saisissez le mot de passe correspondant au compte de base de données. |
|
|
Encryption |
Indique s'il faut chiffrer la connexion à la base de données source. Vous pouvez configurer ce paramètre en fonction de vos besoins métier. Dans cet exemple, Non-encrypted est sélectionné. Si vous souhaitez établir une connexion chiffrée SSL à la base de données source, effectuez les étapes suivantes : Sélectionnez SSL-encrypted, téléchargez CA Certificate, Client Certificate et Private Key of Client Certificate selon les besoins, puis spécifiez Private Key Password of Client Certificate. Remarque
|
Étape 4 : Tester la connectivité
Cliquez sur Test Connectivity and Proceed en bas de la page.
Les blocs CIDR du serveur DTS doivent être ajoutés aux paramètres de sécurité des deux bases de données. Consultez la rubrique Ajouter les blocs CIDR des serveurs DTS . Si l'une des bases de données est gérée soi-même et n'est pas configurée pour l'accès Alibaba Cloud Instance , cliquez sur Test Connectivity dans la boîte de dialogue CIDR Blocks of DTS Servers .
Étape 5 : Configurer les objets à synchroniser
À l'étape Configure Objects , définissez les paramètres suivants :
| Paramètre | Description |
|---|---|
| Synchronization Types | Incremental Data Synchronization est sélectionné par défaut. Sélectionnez également Schema Synchronization et Full Data Synchronization pour synchroniser les données historiques comme référence pour la synchronisation incrémentielle. La sélection de Schema Synchronization amène DTS à synchroniser les schémas de table, y compris les clés étrangères. |
| Synchronization Topology | Sélectionnez One-way Synchronization. |
| Processing Mode of Conflicting Tables | Precheck and Report Errors (par défaut) : la vérification préalable échoue si la source et la destination ont des tables portant le même nom. Utilisez le mappage des noms d'objets pour renommer les tables conflictuelles dans la destination si nécessaire. Ignore Errors and Proceed : ignore la vérification des conflits de noms. Pendant la synchronisation complète, les enregistrements de destination existants avec des valeurs de clé primaire ou unique correspondantes sont conservés. Pendant la synchronisation incrémentielle, ils sont écrasés. Si les schémas diffèrent, l'initialisation peut partiellement échouer. À utiliser avec prudence. |
| Capitalization of Object Names in Destination Instance | Contrôle la mise en majuscule des noms de base de données, de tables et de colonnes dans la destination. La valeur par défaut est DTS default policy. Consultez la rubrique Spécifier la mise en majuscule des noms d'objets. |
| Source Objects | Sélectionnez des colonnes, des tables ou des schémas et cliquez sur l'icône de flèche pour les déplacer vers Selected Objects. |
| Selected Objects | Cliquez avec le bouton droit sur un objet pour le renommer (consultez la rubrique Mapper le nom d'un seul objet), filtrez par opération SQL ou ajoutez des conditions WHERE (consultez la rubrique Définir des conditions de filtrage). Pour renommer plusieurs objets à la fois, cliquez sur Batch Edit. Notez que le renommage d'un objet peut interrompre la synchronisation des objets dépendants. |
Étape 6 : Configurer les paramètres avancés
Cliquez sur Next: Advanced Settings et configurez les éléments suivants :
| Paramètre | Description |
|---|---|
| Dedicated Cluster for Task Scheduling | Par défaut, DTS utilise un cluster partagé. Pour une stabilité accrue des tâches, achetez un cluster dédié. Consultez la rubrique Qu'est-ce qu'un cluster dédié DTS. |
| Retry Time for Failed Connections | Durée pendant laquelle DTS effectue des tentatives après un échec de connexion. Plage valide : 10–1 440 minutes. Valeur par défaut : 720 minutes. Définissez une valeur d'au moins 30 minutes. Si DTS se reconnecte dans ce délai, la tâche reprend ; sinon, la tâche échoue. Si plusieurs tâches partagent la même source ou la même destination, le délai de nouvelle tentative le plus court s'applique. Les frais de l'instance DTS continuent de s'appliquer pendant les tentatives. |
| Retry Time for Other Issues | Durée pendant laquelle DTS effectue des tentatives après des échecs DDL ou DML. Plage valide : 1–1 440 minutes. Valeur par défaut : 10 minutes. Définissez une valeur d'au moins 10 minutes. Cette valeur doit être inférieure à Retry Time for Failed Connections. |
| Enable Throttling for Full Data Migration | Limitez les QPS vers la base de données source, les RPS de la migration complète des données ou la vitesse de migration (Mo/s) pour réduire la charge pendant la synchronisation complète. Visible uniquement lorsque Full Data Synchronization est sélectionné. |
| Enable Throttling for Incremental Data Synchronization | Limitez les RPS ou la vitesse de synchronisation (Mo/s) pour la synchronisation incrémentielle afin de réduire la charge sur la destination. |
| Environment Tag | Un tag facultatif pour identifier l'instance DTS. |
| Configure ETL | Activez la fonctionnalité extract, transform, and load (ETL) pour transformer les données en transit. Sélectionnez Yesles paramètres de notification d'alerte pour saisir les instructions de traitement des données. Consultez la rubrique Configurer ETL dans une tâche de migration ou de synchronisation des données. |
| Monitoring and Alerting | Configurez des alertes pour les échecs de tâche ou la latence dépassant un seuil. Sélectionnez Yes pour configurer le seuil d'alerte et les contacts de notification. Consultez la rubrique Configurer la surveillance et les alertes lors de la création d'une tâche DTS. |
Étape 7 : Configurer la vérification des données (facultatif)
Cliquez sur Next Step: Data Verification pour configurer la vérification. Consultez la rubrique Configurer une tâche de vérification des données.
Étape 8 : Exécuter la vérification préalable
Cliquez sur Next: Save Task Settings and Precheck.
Pour prévisualiser les paramètres API pour cette configuration de tâche, survolez le bouton et cliquez sur Preview OpenAPI parameters avant de continuer.
DTS exécute une vérification préalable avant que la tâche ne puisse démarrer. Si la vérification préalable échoue :
Cliquez sur View Details à côté de chaque élément ayant échoué, résolvez le problème, puis cliquez sur Precheck Again.
Si un élément affiche une alerte pouvant être ignorée, cliquez sur Confirm Alert Details > Ignore > OK, puis cliquez sur Precheck Again. Ignorer les alertes peut entraîner une incohérence des données.
Étape 9 : Acheter et démarrer l'instance
Attendez que le Success Rate atteigne 100%, puis cliquez sur Next: Purchase Instance.
-
Sur la page d'achat, configurez les éléments suivants :
Section
Paramètre
Description
New Instance Class
Méthode de facturation
-
Abonnement : Vous payez un abonnement lors de la création d'une instance de synchronisation des données. La méthode de facturation par abonnement est plus rentable que la méthode de facturation au paiement à l'utilisation pour une utilisation à long terme.
-
Paiement à l'utilisation : Une instance au paiement à l'utilisation est facturée à l'heure. La méthode de facturation au paiement à l'utilisation convient pour une utilisation à court terme. Si vous n'avez plus besoin d'une instance de synchronisation des données au paiement à l'utilisation, vous pouvez la libérer pour réduire les coûts.
Paramètres du groupe de ressources
Le groupe de ressources auquel appartient l'instance de synchronisation des données. Valeur par défaut : default resource group. Pour plus d'informations, consultez la rubrique Qu'est-ce que Resource Management ?
Classe d'instance
DTS propose des classes d'instance variant en fonction de la vitesse de synchronisation. Vous pouvez sélectionner une classe d'instance en fonction de vos besoins métier. Pour plus d'informations, consultez la rubrique Classes d'instance des instances de synchronisation des données.
Durée de l'abonnement
Si vous sélectionnez la méthode de facturation par abonnement, spécifiez la durée de l'abonnement et le nombre d'instances de synchronisation des données que vous souhaitez créer. La durée de l'abonnement peut être de un à neuf mois, un an, deux ans, trois ans ou cinq ans.
RemarqueCe paramètre est disponible uniquement si vous sélectionnez la méthode de facturation Subscription.
-
Lisez et acceptez les Data Transmission Service (Pay-as-you-go) Service Terms.
Cliquez sur Buy and Start, puis cliquez sur OK dans la boîte de dialogue.
Consultez la progression de la tâche dans la liste des tâches.
Actions à effectuer après le démarrage de la tâche
Une fois la tâche démarrée, surveillez la latence de synchronisation dans la liste des tâches. Avant de basculer les charges de travail vers la destination :
Mettez à jour la valeur de départ des séquences dans la base de données de destination. Après le basculement, les nouvelles valeurs de séquence ne continueront pas à partir de la valeur maximale de la source.
Si vous utilisez uniquement DTS pour écrire des données de table dans la base de données de destination, vous pouvez utiliser DMS pour effectuer des opérations DDL en ligne sur les tables sources sans les verrouiller pendant la synchronisation. Consultez la rubrique Modifier les schémas sans verrouiller les tables.
Pour connaître les topologies de synchronisation prises en charge, consultez la rubrique Topologies de synchronisation.