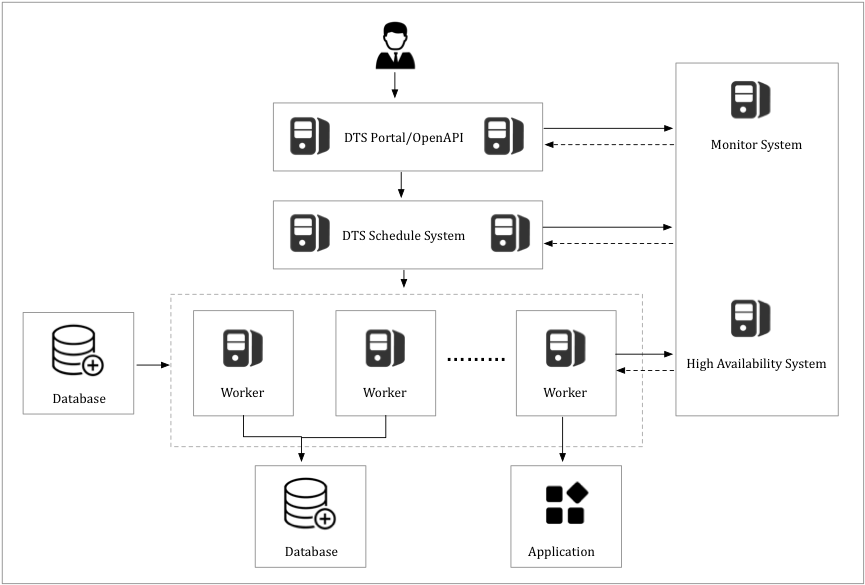
Data Transmission Service (DTS) repose sur une architecture modulaire conçue pour la haute disponibilité. Chaque module s'exécute sur des serveurs en redondance primaire/secondaire. Le gestionnaire de haute disponibilité vérifie en continu l'état de santé de chaque serveur et, en cas d'anomalie, bascule les charges de travail vers un serveur sain avec une latence minimale. Pour les réplications continues (synchronisation des données et suivi des modifications), le gestionnaire détecte également les changements d'endpoint des sources de données et reconfigure automatiquement la connexion.
-
Redondance primaire/secondaire
Chaque module DTS utilise une architecture primaire/secondaire à des fins de redondance. Le système de reprise après sinistre vérifie en continu l'état de santé de chaque serveur. En cas de défaillance d'un serveur, ses charges de travail basculent vers un serveur sain avec une latence minimale.
-
Détection dynamique des endpoints
Pour les tâches de synchronisation des données et de suivi des modifications, le système de reprise après sinistre détecte les changements d'endpoint de la source de données. Si un changement est détecté, le système reconfigure la source de données afin de maintenir la stabilité de la connexion.
Fonctionnement de DTS en mode migration de données
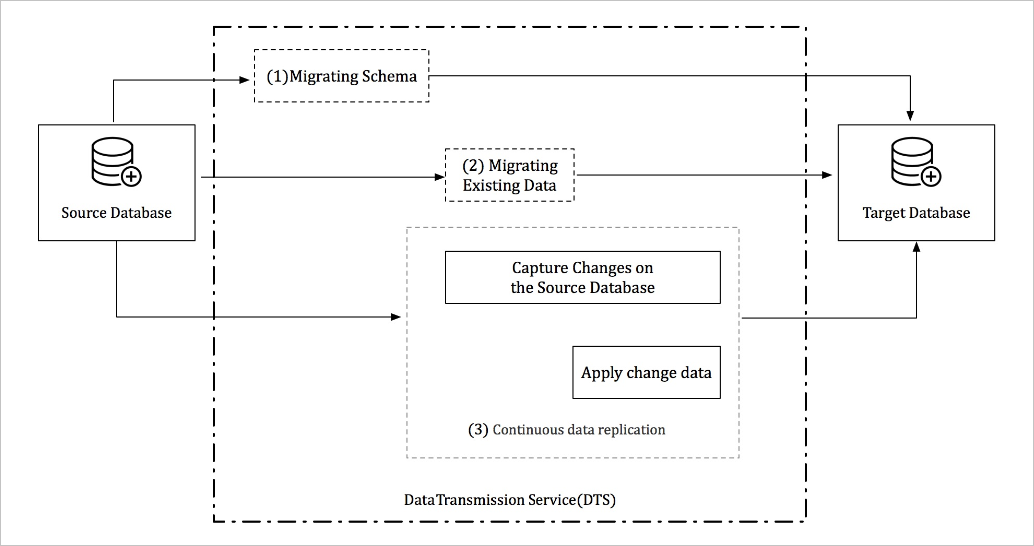
Une migration de données complète se déroule en trois phases séquentielles : migration du schéma, migration complète des données et migration incrémentielle des données. Sélectionnez ces trois phases lors de la configuration d'une tâche de migration de données pour maintenir la base de données source opérationnelle tout au long du processus.
Migration du schéma : DTS recrée le schéma dans la base de données de destination avant tout transfert de données. Pour les migrations entre bases de données hétérogènes, DTS analyse le langage de définition de données (DDL) de la base de données source, le traduit dans la syntaxe de la base de données de destination, puis recrée les objets du schéma.
Migration complète des données : DTS migre les données historiques de la source vers la destination. La base de données source reste en ligne et continue d'accepter les écritures durant cette phase. Pour capturer ces écritures en cours, DTS active un lecteur de données incrémentielles au début de la migration complète. Les données incrémentielles sont analysées, reformattées et stockées localement sur le serveur DTS pendant l'exécution de la migration complète.
Migration incrémentielle des données : Une fois la migration complète des données terminée, DTS récupère les données incrémentielles stockées localement et les applique à la destination. Cette phase se poursuit jusqu'à ce que la destination soit synchronisée avec la source et que le délai de réplication atteigne un état stable.
Fonctionnement de DTS en mode synchronisation de données
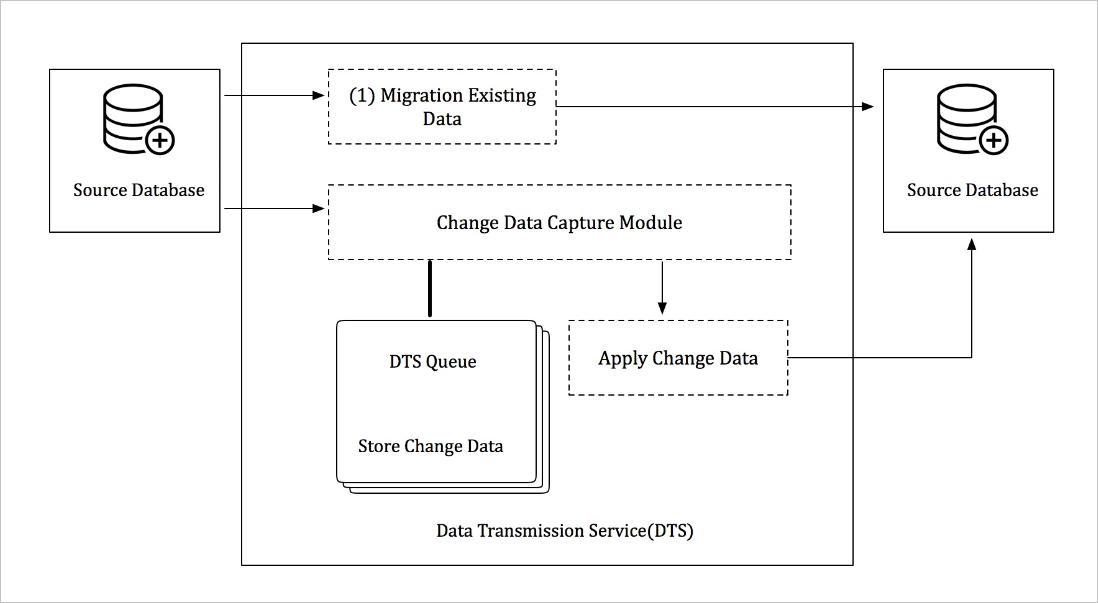
Le mode de synchronisation des données réplique les modifications continues entre deux magasins de données. Il est couramment utilisé pour les réplications OLTP vers OLAP, où le traitement transactionnel en ligne (OLTP) gère les charges de travail transactionnelles et le traitement analytique en ligne (OLAP) traite les requêtes analytiques.
Une tâche de synchronisation de données exécute deux phases de manière séquentielle :
Synchronisation initiale des données : DTS synchronise les données historiques de la source vers la destination.
Synchronisation des données en temps réel : DTS réplique en continu les modifications de données en cours pour maintenir la destination synchronisée avec la source.
Deux composants assurent la réplication continue :
Lecteur de journaux de transactions : Se connecte à l'instance source via le protocole approprié, par exemple le protocole binlog dump pour une instance ApsaraDB RDS for MySQL. Il lit les journaux incrémentiels, puis analyse, filtre et convertit les données avant de les persister localement sur le serveur DTS.
Appliqueur de journaux de transactions : Récupère les mises à jour depuis le lecteur de journaux de transactions, filtre les modifications non liées aux objets répliqués et applique les modifications restantes à la base de données de destination. L'appliqueur préserve les propriétés ACID (atomicité, cohérence, isolation et durabilité) de chaque transaction.
Les deux composants s'exécutent en mode redondant. Si une anomalie survient sur l'un des composants, le gestionnaire de haute disponibilité reprend l'exécution des journaux de transactions sur un serveur sain.
Fonctionnement de DTS en mode suivi des modifications
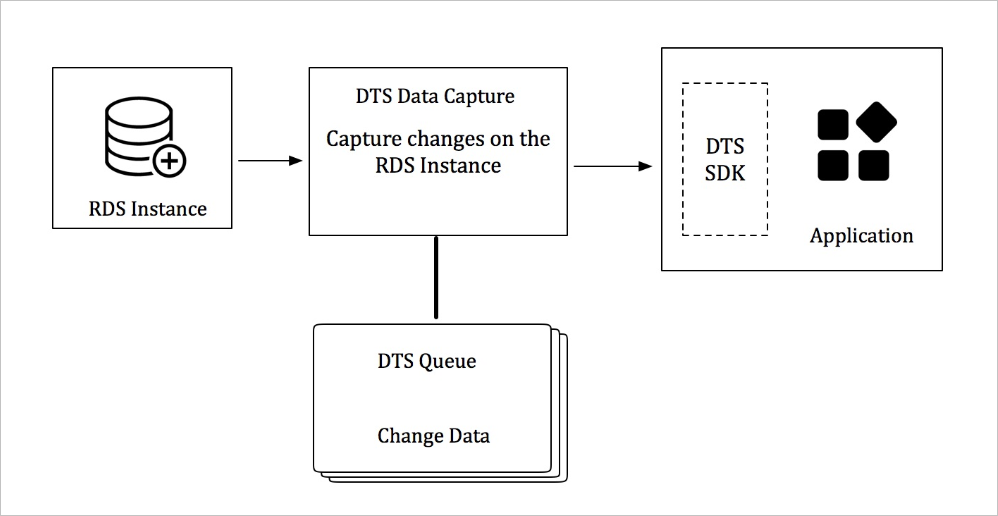
Le mode de suivi des modifications vous offre un accès en temps réel aux journaux de données incrémentielles d'une instance ApsaraDB RDS. Consommez les journaux sur le serveur de suivi des modifications à l'aide des SDK DTS et définissez des règles de consommation de données personnalisées adaptées à vos besoins.
Le processeur de journaux se connecte à l'instance source via le protocole approprié, par exemple le protocole binlog dump pour une instance ApsaraDB RDS for MySQL. Il lit les journaux incrémentiels, puis analyse, filtre et convertit la syntaxe avant de stocker les données localement sur le serveur DTS.
DTS assure la haute disponibilité à deux niveaux :
Haute disponibilité du processeur de journaux : Lorsque le gestionnaire de haute disponibilité détecte une anomalie sur le processeur de journaux, il redémarre ce dernier sur un nœud de service sain.
Haute disponibilité de la consommation par SDK : Démarrez plusieurs processus de consommation basés sur SDK pour une seule tâche de suivi des modifications. Le serveur pousse les données incrémentielles via un processus à la fois. Si ce processus rencontre une anomalie, le serveur bascule automatiquement vers un autre processus de consommation.