DataWorks vous permet de bâtir un système d’entreposage et d’analyse de données hors ligne sur MaxCompute. Depuis la console DataWorks, configurez les nœuds MaxCompute, activez la planification périodique et gérez les métadonnées pour garantir l’efficacité de vos pipelines de données.
Cette rubrique couvre la facturation, la configuration de l’environnement, la gestion des autorisations et les principaux flux de travail de développement.
Fonctionnement
DataWorks et MaxCompute s’articulent autour de trois couches distinctes :
DataWorks — la couche d’orchestration. Elle gère le développement des tâches, la planification, la gouvernance des données ainsi que la supervision et la maintenance (O&M).
MaxCompute — la couche de calcul et de stockage. L’exécution des requêtes SQL, le stockage des données et le traitement des jobs y sont effectués.
Groupes de ressources — la couche d’exécution. Ils fournissent la capacité de calcul nécessaire à l’exécution de vos tâches planifiées et de vos jobs de synchronisation de données.
Un flux de travail type de bout en bout se déroule comme suit :
Synchronisez les données source vers MaxCompute à l’aide de Data Integration.
Développez et planifiez des tâches ODPS SQL dans DataStudio.
Déployez les tâches dans l’environnement de production.
Surveillez et dépannez les exécutions planifiées dans Operation Center.
Comprendre cette séparation est essentiel pour la facturation : DataWorks facture l’orchestration (éditions et groupes de ressources), tandis que MaxCompute facture séparément le calcul et le stockage. Consultez la section Facturation pour plus de détails.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
DataWorks activé. Consultez la page Achat.
MaxCompute activé. Consultez la page Activer MaxCompute.
Un espace de travail DataWorks créé. Consultez la page Créer et gérer des espaces de travail.
Facturation
L’utilisation de DataStudio et d’Operation Center de DataWorks avec MaxCompute génère deux factures distinctes : l’une provenant de DataWorks, l’autre de MaxCompute (et de tout autre service Alibaba Cloud utilisé).
Frais DataWorks
| Frais | Description |
|---|---|
| Frais d’édition | Facturés lors de l’achat de l’édition Standard, Professionnelle ou Entreprise de DataWorks. |
| Frais de ressources de planification | Les ressources de planification sont requises pour exécuter des tâches périodiques. Achetez un groupe de ressources serverless (recommandé) ou un groupe de ressources exclusif d’ancienne version. |
| Frais de ressources de synchronisation | Les tâches de synchronisation de données consomment à la fois des ressources de planification et de synchronisation. Achetez un groupe de ressources serverless (recommandé) ou un groupe de ressources exclusif d’ancienne version. |
Un seul groupe de ressources serverless couvre la planification des tâches, la synchronisation des données et DataService Studio.
Les frais de planification ne s’appliquent pas lorsque vous :
Exécutez manuellement des tâches à l’aide des options Run ou Run with Parameters dans la barre d’outils DataStudio.
Exécutez des tâches qui échouent ou qui sont lancées en mode test (dry run).
Pour plus de détails sur le calcul des frais de planification, consultez la page Logique d’émission des tâches de planification dans DataWorks.
Frais liés aux autres services Alibaba Cloud
Ces frais apparaissent sur les factures des services respectifs, et non sur celle de DataWorks.
| Frais | Condition d’application |
|---|---|
| Frais de base de données | Exécution de tâches de synchronisation de données qui lisent ou écrivent dans des bases de données |
| Frais de calcul et de stockage MaxCompute | Exécution de tâches sur des nœuds ODPS SQL qui créent des tables ou traitent des données dans MaxCompute |
| Frais réseau | Établissement de connexions réseau à l’aide d’Express Connect, d’Elastic IP Address (EIP) ou d’Internet Shared Bandwidth |
Pour plus de détails sur la facturation de MaxCompute, consultez la page Éléments facturables de MaxCompute.
Préparation de l’environnement
Effectuez les étapes de cette section avant de développer des tâches. Une fois terminé, vous disposerez des éléments suivants :
Une édition DataWorks et un groupe de ressources configurés pour votre charge de travail.
Un projet MaxCompute associé à votre espace de travail DataWorks en tant que source de données.
Des membres ajoutés à l’espace de travail avec les rôles appropriés pour le développement collaboratif.
Sélectionner une édition et un groupe de ressources
| Élément | Options | Référence |
|---|---|---|
| DataWorks edition | Basic Edition : Couvre la migration de données vers le cloud, le développement de tâches, la planification et la gouvernance des données. Standard, Professional ou Enterprise Edition : Requises pour les fonctionnalités avancées de gouvernance et de sécurité des données. | Comparer les éditions DataWorks |
| Resource group | Groupe de ressources serverless (recommandé) : Un seul groupe de ressources sert simultanément à la planification, à la synchronisation des données et à DataService Studio. Groupe de ressources exclusif ou partagé d’ancienne version : Répond aux besoins de planification de base. Notez que les groupes de ressources d’ancienne version seront supprimés. | Présentation des groupes de ressources DataWorks |
Configurer l’environnement de développement
| Tâche | Description | Référence |
|---|---|---|
| Configurer la synchronisation des données | Ajoutez un projet MaxCompute à votre espace de travail en tant que source de données. Les tâches de synchronisation ne peuvent être configurées qu’après l’ajout de la source de données. | Associer une ressource de calcul MaxCompute |
| Configurer le développement et l’analyse des données | Ajoutez un projet MaxCompute en tant que source de données et associez-le à DataStudio pour activer le développement de tâches, l’analyse des données et la planification périodique. | Associer une ressource de calcul MaxCompute. Suivez ensuite les instructions de la page Préparatifs avant le développement des données : Associer une ressource de calcul ou un cluster à DataStudio. |
| Configurer le développement collaboratif | Ajoutez des utilisateurs RAM à votre espace de travail en tant que membres et attribuez-leur le rôle Development pour activer le développement collaboratif. | Ajouter et gérer les membres de l’espace de travail et leurs autorisations de rôle |
Gestion des autorisations
DataWorks utilise un modèle d’autorisation à deux niveaux :
Autorisations d’accès aux données — contrôlent les tables MaxCompute qu’un utilisateur RAM peut interroger.
Autorisations de service et de fonctionnalité — contrôlent les fonctionnalités de la console DataWorks auxquelles un utilisateur RAM peut accéder.
Autorisations d’accès aux données
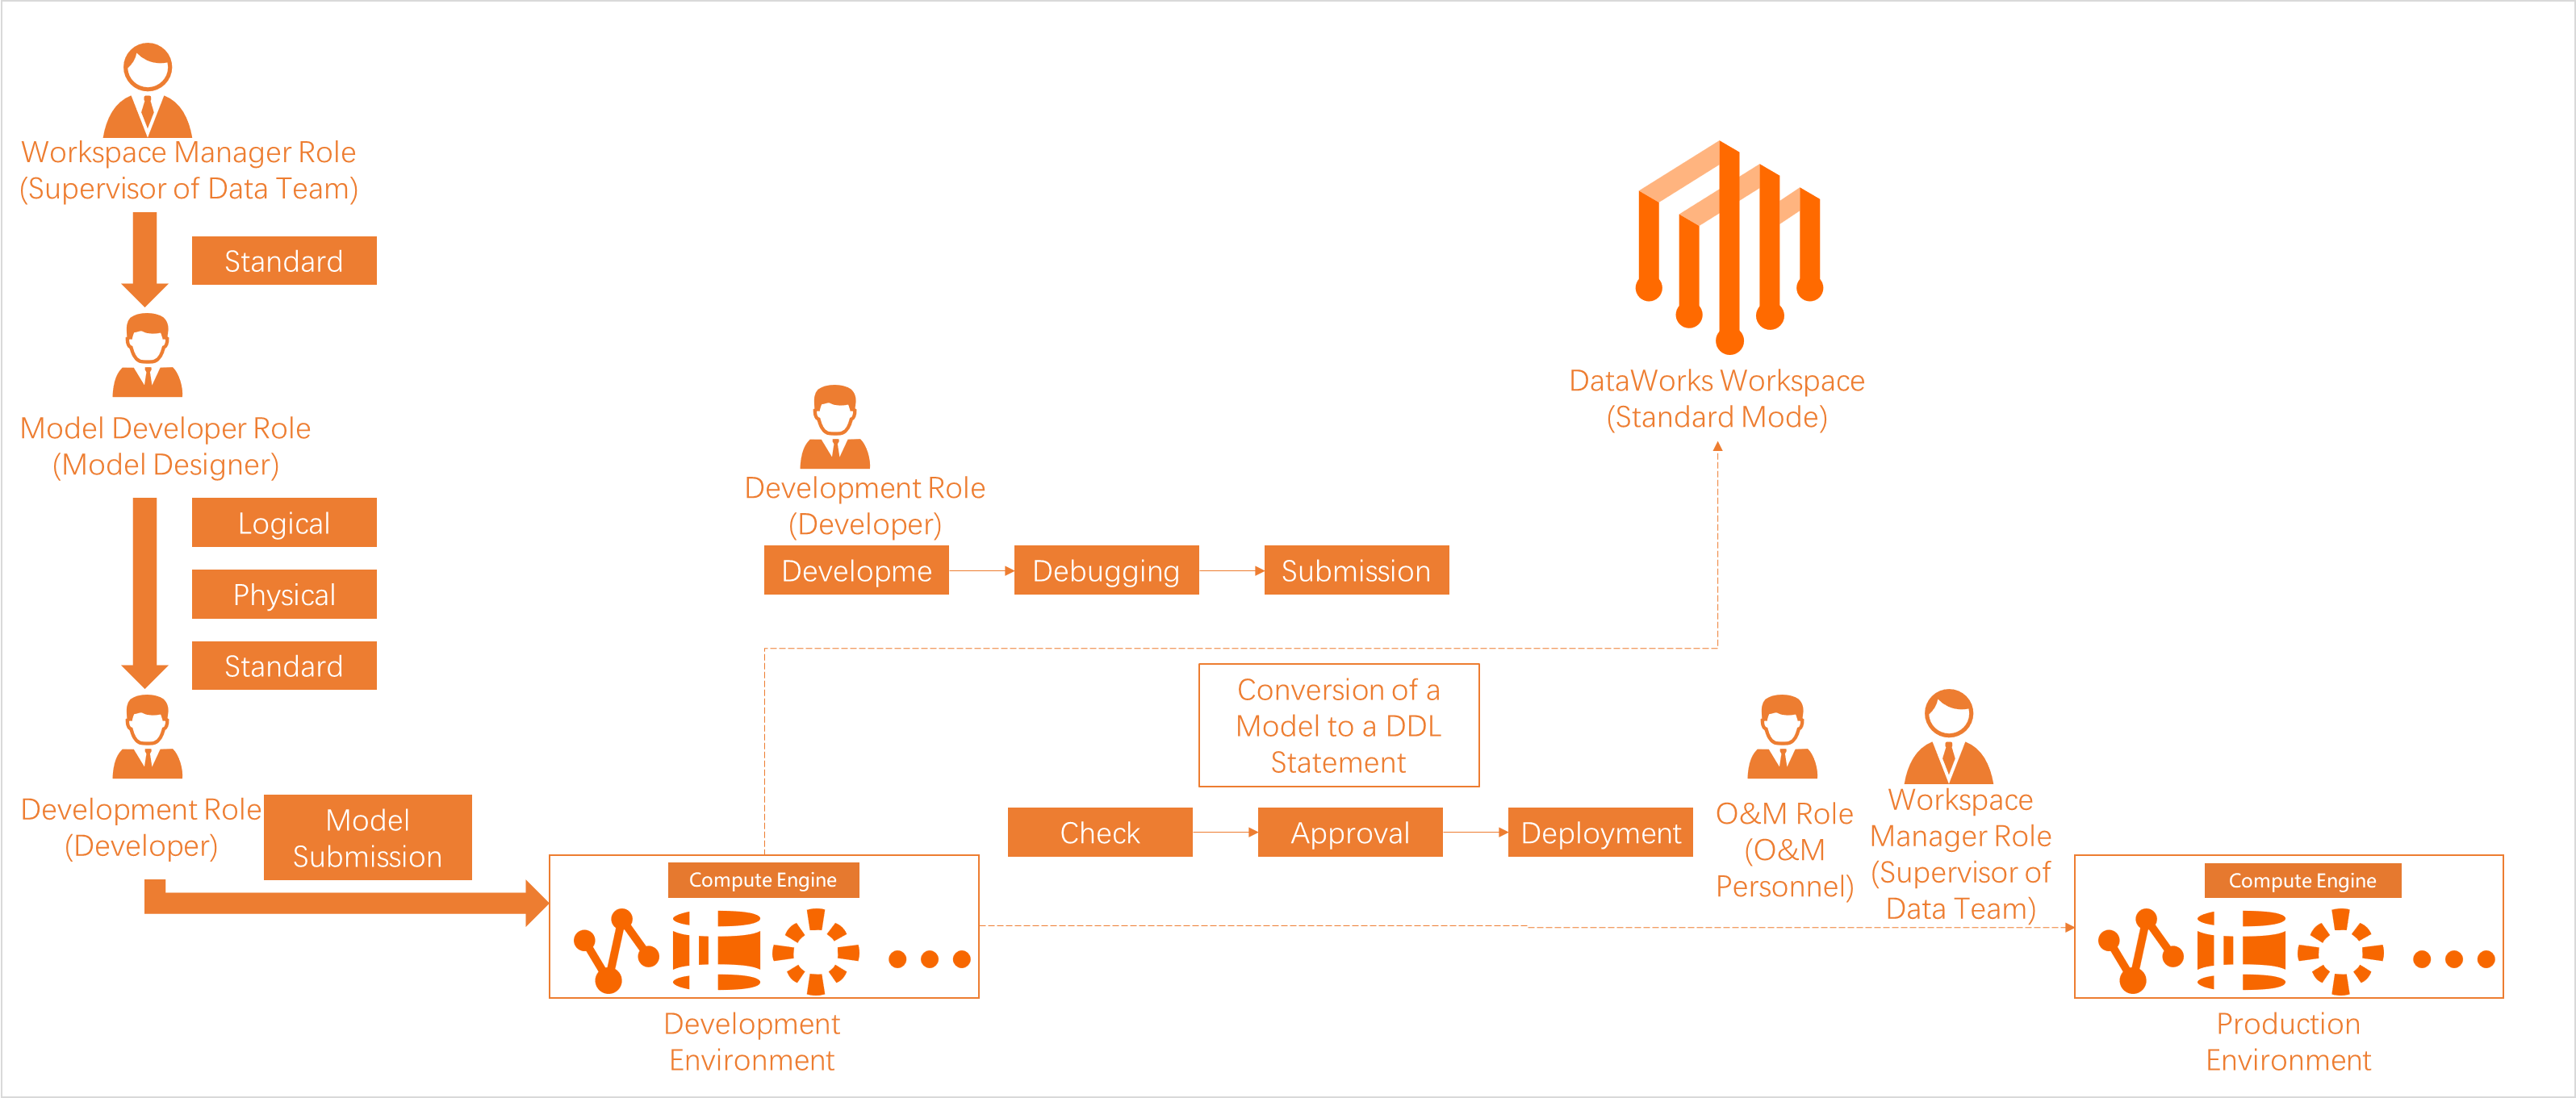
Vous pouvez utiliser un nœud ODPS SQL ou une requête ad hoc pour interroger les données dans les tables MaxCompute. Les espaces de travail DataWorks fonctionnent en mode basique ou en mode standard. Cette rubrique utilise un espace de travail en mode standard, qui prend en charge une gestion fine des autorisations et l’isolation entre les environnements de développement et de production.
En mode standard, deux identités différentes exécutent les tâches :
Environnement de développement : Le compte Alibaba Cloud personnel de l’exécuteur de la tâche exécute les tâches par défaut.
Environnement de production : Une identité d’accès de planification (un compte Alibaba Cloud) exécute les tâches. Cette identité dispose d’autorisations élevées sur le projet MaxCompute de production.
Le compte qui exécute une requête dépend de la manière dont vous référencez le projet dans le code SQL :
| Modèle SQL | Environnement de développement | Environnement de production |
|---|---|---|
select col1 from projectname_dev.tablename; (projet dev) |
Compte personnel de l’exécuteur de la tâche | Identité d’accès de planification |
select col1 from projectname.tablename; (projet prod par nom) |
Compte personnel de l’exécuteur de la tâche (nécessite une demande d’autorisation via Security Center pour accéder aux données de production) | Identité d’accès de planification |
select col1 from tablename; (projet actuel) |
Compte personnel de l’exécuteur de la tâche | Identité d’accès de planification |
Pour voir quels projets MaxCompute sont associés à chaque environnement et quels comptes y sont configurés, accédez à la page Workspace et vérifiez la section Compute Engine Information . Pour plus de détails, consultez la page Associer une ressource de calcul MaxCompute .
Autorisations des utilisateurs RAM par environnement :
Après avoir attribué un rôle au niveau de l’espace de travail à un utilisateur RAM, ses autorisations MaxCompute diffèrent selon l’environnement :
Environnement de développement : L’utilisateur RAM reçoit automatiquement les autorisations du rôle correspondant dans le projet de développement MaxCompute.
Environnement de production : L’utilisateur RAM ne dispose d’aucune autorisation par défaut. Pour interroger les tables du projet MaxCompute de production, accédez à Security Center afin de demander les autorisations requises.
Pour une référence complète sur les autorisations de données MaxCompute, consultez la page Autorisations de données MaxCompute.
Autorisations de service et de fonctionnalité
Avant qu’un utilisateur RAM puisse développer des données dans DataWorks, attribuez-lui un rôle au niveau de l’espace de travail. Consultez la page Bonnes pratiques : Accorder des autorisations aux utilisateurs RAM.
Deux mécanismes d’autorisation sont disponibles :
Autorisation basée sur la politique RAM : Contrôle l’accès aux modules de service DataWorks (comme empêcher l’accès à Data Map) et aux opérations au niveau de la console (comme la suppression d’un espace de travail).
Contrôle d’accès basé sur les rôles (RBAC) : Contrôle l’accès aux modules au niveau de l’espace de travail (comme les opérations de développement DataStudio) et aux modules globaux (comme Data Security Guard).
Prise en main
Intégration des données
Data Integration lit les données depuis MaxCompute et y écrit des données. Les flux de synchronisation fonctionnent dans les deux sens : depuis une source de données externe vers MaxCompute, ou depuis MaxCompute vers un système externe.
Scénarios de synchronisation pris en charge : synchronisation par lots, synchronisation en temps réel, et synchronisation complète et incrémentielle.
Pour choisir le scénario de synchronisation approprié, consultez la page Présentation de Data Integration.
Modélisation et développement des données
Modélisation des données
La modélisation des données est le point de départ d’une gouvernance des données de bout en bout. Elle applique la méthodologie Alibaba Data Mid-End pour structurer les données de l’entreprise à l’aide de quatre modules : planification de l’entrepôt de données, norme de données, modélisation dimensionnelle et métrique de données. Cela offre aux équipes un cadre commun pour interpréter les données métier de manière cohérente.
Consultez la page Présentation de la modélisation des données.
DataStudio
DataStudio encapsule le moteur de calcul MaxCompute afin que vous puissiez développer et planifier des tâches sans écrire de scripts complexes en ligne de commande. Il prend en charge :
Développement de données : Créez et planifiez différents types de nœuds — ODPS SQL, PyODPS 2, PyODPS 3, ODPS Spark, MaxCompute Script, MaxCompute MR, ainsi que des nœuds polyvalents tels que Shell, Branch, Assignment, Do-while et For-each.
Synchronisation des données : Un sous-ensemble de scénarios de synchronisation par lots et en temps réel. Consultez la section Intégration des données pour la liste complète des scénarios.
Références utiles pour le développement de tâches :
Après avoir développé les tâches, effectuez les étapes suivantes avant la mise en production :
Configurer les propriétés de planification — Définissez les dépendances de planification et les paramètres pour activer l’exécution périodique.
Déboguer les nœuds — Exécutez les tâches dans l’environnement de développement pour valider la logique et éviter de gaspiller des ressources de calcul en production.
Déployer les nœuds — Déployez les tâches dans l’environnement de production. Les tâches déployées apparaissent sur la page Auto Triggered Nodes dans Operation Center.
Gérer les nœuds — Déployez, annulez le déploiement ou mettez à jour par lot les propriétés de planification de plusieurs tâches.
Gérer le processus de développement — Utilisez la revue de code, les tests de fumée forcés et des workflows de revue de code personnalisables pour faire respecter les normes de développement.
Références : Présentation des propriétés de planification, Processus de débogage des tâches, Publier des tâches, Opérations par lot, Contrôle du processus de développement.
Operation Center
Operation Center est une plateforme de supervision et de maintenance (O&M) de bout en bout pour les tâches planifiées. Utilisez-la pour :
Consulter l’état des tâches et l’historique des exécutions.
Exécuter des diagnostics intelligents et relancer les tâches ayant échoué.
Configurer des lignes de base intelligentes pour surveiller et faire respecter les SLA de temps de sortie pour les tâches critiques.
Consultez la page Effectuer des opérations O&M de base sur les tâches planifiées.
Data Quality
Data Quality surveille les données tout au long du processus de R&D de bout en bout en combinant des contrôles de qualité basés sur des règles avec la planification des tâches. Lorsqu’une règle de qualité est violée, DataWorks vous alerte et peut bloquer l’exécution des tâches en aval jusqu’à ce que le problème soit résolu.
Consultez la page Présentation de Data Quality.
Gouvernance des données
Après avoir associé une source de données MaxCompute à un espace de travail, DataWorks collecte automatiquement les métadonnées de celle-ci. Trois modules prennent en charge la gouvernance des données :
| Module | Description | Référence |
|---|---|---|
| Data Map | Plateforme de gestion des métadonnées de niveau entreprise. Recherchez, parcourez et comprenez les actifs de données dans toute votre organisation grâce à des services de métadonnées unifiés. | Présentation de Data Map |
| Security Center / Data Security Guard / Approval Center | Gouvernance de la sécurité des données de bout en bout. Couvre la classification des actifs de données, l’identification des données sensibles, la gestion des autorisations d’accès, le masquage des données, l’audit d’accès et la détection des risques. | Présentation de Security Center, Présentation de Data Security Guard, Présentation d’Approval Center |
| Data Governance Center | Identifie automatiquement les problèmes de gouvernance sur la base de règles dérivées de l’expérience et fournit des solutions couvrant à la fois la prévention en amont et la remédiation en aval. | Présentation de Data Governance Center |
Analyse et services de données
| Module | Description | Référence |
|---|---|---|
| DataAnalysis | Exécutez des requêtes basées sur SQL en ligne, explorez les données, modifiez et partagez les résultats de requête, enregistrez les résultats sous forme de cartes graphiques et générez des rapports visualisés pour les rapports quotidiens. | Présentation de DataAnalysis |
| DataService Studio | Créez et publiez des services API pour les consommateurs internes et externes. Gère les API de manière centralisée afin que les équipes puissent partager et accéder aux données via une couche de service unifiée. | Présentation de DataService Studio |
Open Platform
Open Platform permet à vos systèmes d’applications de s’intégrer programmatiquement avec DataWorks.
| Module | Fonction | Référence |
|---|---|---|
| OpenAPI | Appelez les opérations API DataWorks depuis vos applications pour automatiser le traitement des big data, réduire la maintenance manuelle et minimiser les risques liés aux données. | OpenAPI |
| OpenEvent | Abonnez-vous aux événements de changement DataWorks afin que vos applications puissent détecter et réagir aux changements d’état du pipeline en temps réel. | Présentation d’OpenEvent |
| Extensions | Enregistrez un programme local en tant qu’extension pour gérer les événements et les processus des points d’extension dans votre espace de travail DataWorks. | Présentation des extensions |
Annexe : Relation entre DataWorks et MaxCompute
DataWorks fournit des capacités d’orchestration — planification, gestion des métadonnées, gouvernance des données et sécurité des données — tandis que MaxCompute gère tout le calcul et le stockage des données.
Dans un espace de travail en mode standard, vous associez des moteurs de calcul MaxCompute distincts aux environnements de développement et de production. Cela isole le stockage et les ressources entre les deux environnements.
Pour les espaces de travail en mode basique, seul l’environnement de production est disponible et vous ne pouvez associer qu’un seul moteur de calcul MaxCompute.
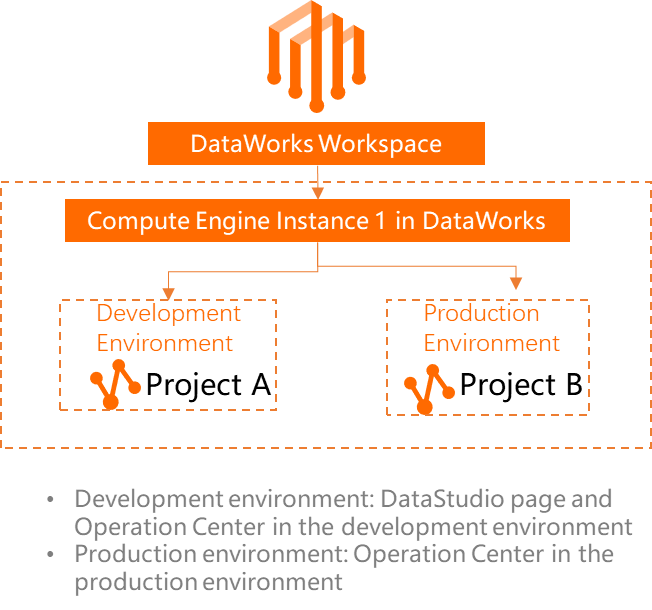
Pour ajouter une source de données MaxCompute, l’associer à DataStudio et voir quels projets MaxCompute sont utilisés dans chaque environnement, consultez la page Associer une ressource de calcul MaxCompute.
Pour comprendre comment DataWorks émet et suit les tâches planifiées, consultez la page Logique d’émission des nœuds de planification dans DataWorks.