Database Autonomy Service (DAS) utilise l'analyse du cache pour examiner les fichiers de sauvegarde Redis et identifier rapidement les grandes clés. Cette analyse vous aide à comprendre la distribution des clés, l'utilisation de la mémoire et les détails d'expiration afin d'optimiser les performances et de prévenir les erreurs de mémoire insuffisante causées par une répartition déséquilibrée des clés.
Fonctionnalités
La fonctionnalité d'analyse du cache prend en charge les instances basées sur la mémoire et celles basées sur le disque : les instances basées sur la mémoire sont analysées via des snapshots de persistance RDB, tandis que les instances basées sur le disque le sont via des statistiques de scan natives au moteur.
Limites
L'instance de base de données cible doit être connectée à DAS et son statut doit être Normal Access.
Seules les structures de données Redis et les structures de données propriétaires Tair suivantes sont prises en charge pour l'analyse : TairString, TairHash, TairGIS, TairBloom, TairDoc, TairCpc et TairZset.
Si la spécification de l'instance a été modifiée, vous ne pouvez pas analyser les fichiers de sauvegarde créés avant cette modification.
Procédure
Connectez-vous à la console DAS.
Dans le volet de navigation de gauche, cliquez sur .
Recherchez l'instance cible et cliquez sur son ID pour ouvrir la page des détails de l'instance.
Dans le volet de navigation de gauche, choisissez Request Analysis > Cache Analysis.
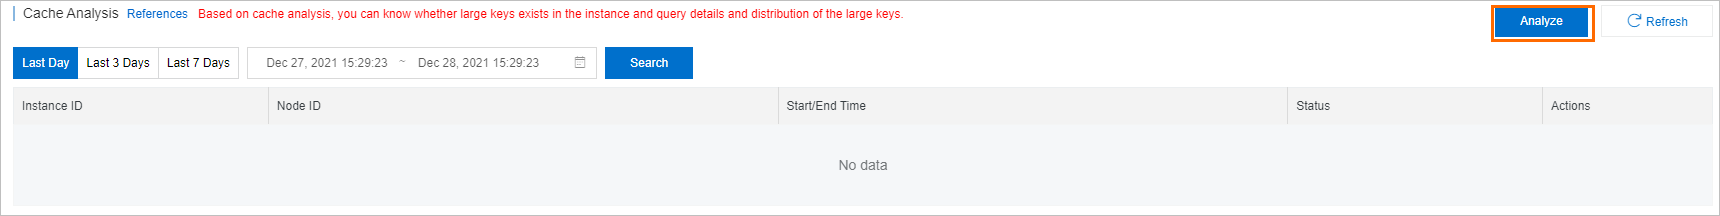
Sur la page Cache Analysis, cliquez sur Analyze dans le coin supérieur droit.
-
Dans la boîte de dialogue Cache Analysis, configurez les paramètres suivants.
Paramètre
Description
Node
Sélectionnez l'ID du nœud à analyser.
RemarqueVous pouvez choisir d'analyser une instance entière ou un nœud spécifique.
Analysis Method
Sélectionnez un fichier de sauvegarde pour l'analyse selon vos besoins :
Use Recent Backup File : analyse le fichier de sauvegarde le plus récent.
Create New Backup for Analysis : crée et analyse une nouvelle sauvegarde pour refléter l'état actuel de l'instance.
Select a historical backup file : sélectionne et analyse un fichier de sauvegarde historique.
RemarqueLors de l'analyse d'un fichier de sauvegarde existant, vérifiez que son horodatage correspond à vos attentes.
Delimiter
Saisissez les délimiteurs utilisés pour identifier les préfixes de clé. Vous n'avez rien à saisir si vous utilisez les délimiteurs par défaut :
:;,_-+@=|#. Cliquez sur OK.
-
Recherchez la tâche d'analyse terminée dans la liste Cache Analysis. Dans la colonne Actions, cliquez sur Details pour afficher les résultats d'analyse suivants :
Basic Information : fournit les propriétés de base de l'instance cible et la méthode d'analyse utilisée.
-
Relevant Nodes : affiche l'état de la mémoire et les statistiques des clés pour chaque nœud d'un cluster Redis Community Edition. La zone Relevant nodes affiche l'ID du nœud, l'utilisation de la mémoire (octets) et le nombre de clés pour chaque nœud dans un tableau.
RemarqueCes informations s'affichent uniquement lorsque vous analysez une instance de cluster Redis Community Edition entière.
Details : fournit une ventilation de l'utilisation de la mémoire de l'instance, y compris des métriques telles que Daily Growth within Seven Days, Total Number of Keys, Memory Usage of Keys, Distribution of Keys, Memory Usage of Elements, Distribution of Elements, Distribution of Key Expiration Time (Memory) et Distribution of Key Expiration Time (Quantity). Cette section répertorie également les 100 plus grandes clés classées par utilisation de la mémoire, nombre total et préfixe de clé.
FAQ
-
Q : Pourquoi l'Memory Usage of Keys affichée dans les résultats de l'analyse du cache est-elle inférieure à l'utilisation réelle de la mémoire ?
R : L'analyse du cache ne parse que la taille sérialisée des clés et des valeurs dans le fichier RDB, ce qui ne représente qu'une partie de la valeur
used_memory. La métriqueused_memoryinclut également les composants suivants, qui ne sont pas calculés dans l'analyse :La surcharge liée aux structures de données et aux pointeurs pour les clés et les valeurs. L'analyse exclut également la surcharge mémoire due à l'alignement des octets jemalloc. Par exemple, pour 250 millions de clés, cette surcharge peut représenter 2 à 3 Go.
Les tampons de sortie client, les tampons de requête, le tampon de réécriture AOF et l'historique de réplication.
-
Q : Quels sont les délimiteurs de préfixe de clé pour l'analyse du cache Redis ?
R : Les délimiteurs par défaut sont
:;,_-+@=|#. -
Q : Pour les clés de type String dans l'analyse du cache Redis, pourquoi le nombre d'éléments et la longueur des éléments sont-ils identiques ?
R : Pour une clé de type String, le nombre d'éléments est identique à sa longueur.
-
Q : Comment gérer l'erreur
decode rdbfile error: rdb: unknown object type 116 for key XX?R : Cette erreur indique qu'une structure Bloom non standard existe dans l'instance Redis. Vous pouvez soit supprimer les clés avec la structure Bloom, soit mettre à niveau l'instance Redis vers Tair (Enterprise Edition) et changer la structure Bloom non standard en une structure TairBloom.
-
Q : Comment gérer l'erreur
decode rdbfile error: rdb: invalid file format?R : Cette erreur indique que le fichier de sauvegarde sélectionné n'est pas valide. Vérifiez si la spécification de l'instance a été modifiée après la création de la sauvegarde. Vérifiez également si le chiffrement transparent des données (TDE) est activé, car les informations chiffrées ne peuvent pas être analysées.
-
Q : Comment gérer l'erreur
decode rdbfile error: rdb: unknown module type?R : Cette erreur indique que le fichier de sauvegarde contient une structure de données propriétaire qui n'est pas prise en charge pour l'analyse.
-
Q : Comment gérer l'erreur
XXX backup failedaprès avoir sélectionné « Create New Backup for Analysis » ?R : Une commande BGSAVE ou BGREWRITEAOF est actuellement en cours d'exécution sur l'instance, ce qui a entraîné l'échec de la sauvegarde pour la tâche d'analyse du cache. Créez une nouvelle sauvegarde pour l'analyse pendant les heures creuses ou sélectionnez un fichier de sauvegarde historique pour l'analyse.
-
Q : Pourquoi les résultats de l'analyse du cache pour les structures de données Stream sont-ils plusieurs fois supérieurs aux valeurs réelles ?
R : La fonctionnalité d'analyse du cache ne fournit qu'une estimation pour la structure de données Stream complexe, qui utilise un arbre radix et un listpack. Cette estimation peut entraîner des écarts dans les résultats d'analyse.
RemarqueCet écart dans les résultats d'analyse est purement statistique et n'affecte pas la fonctionnalité de l'instance de base de données.
Documentation connexe
Pour plus d'informations sur l'utilisation de la fonctionnalité d'analyse du cache dans la console Redis, consultez Analyse hors ligne des clés.
Référence API
|
API |
Description |
|
Crée une tâche d'analyse du cache. |
|
|
Interroge les détails d'une tâche d'analyse du cache. |
|
|
Interroge une liste de tâches d'analyse du cache. |