Le moteur de diagnostic SQL basé sur les coûts du service Database Autonomy Service (DAS) analyse les instructions SQL, recommande des index et suggère des réécritures de requêtes en estimant les gains de performance avant l'application des modifications. Il évalue les candidats à l'optimisation à l'aide du même modèle de coût que l'optimiseur de base de données, garantissant ainsi que les recommandations reposent sur le coût d'exécution réel plutôt que sur des heuristiques.
Pourquoi l'optimisation SQL est complexe
Environ 80 % des problèmes de performance des bases de données proviennent des instructions SQL. Pourtant, l'optimisation SQL reste l'une des tâches les plus chronophages de la gestion des bases de données : le plan d'exécution optimal dépend du volume de données, des statistiques, des combinaisons d'index et de la structure des requêtes, autant d'éléments qui évoluent constamment.
Les développeurs passent souvent plusieurs heures à identifier les requêtes lentes, à analyser les plans d'exécution et à tester les modifications d'index. Le moteur de diagnostic SQL basé sur les coûts automatise ce processus, transformant un flux de travail manuel dépendant de l'expertise humaine en une solution capable de s'exécuter en continu et à grande échelle.
Fonctionnement du moteur
Ce moteur est un optimiseur fonctionnant indépendamment du noyau de la base de données. Il collecte automatiquement les statistiques et calcule les coûts des plans d'exécution sans s'appuyer sur la fonctionnalité What-If Tool (WIT) intégrée à la base de données, une limitation courante dans les bases de données open source telles que MySQL.
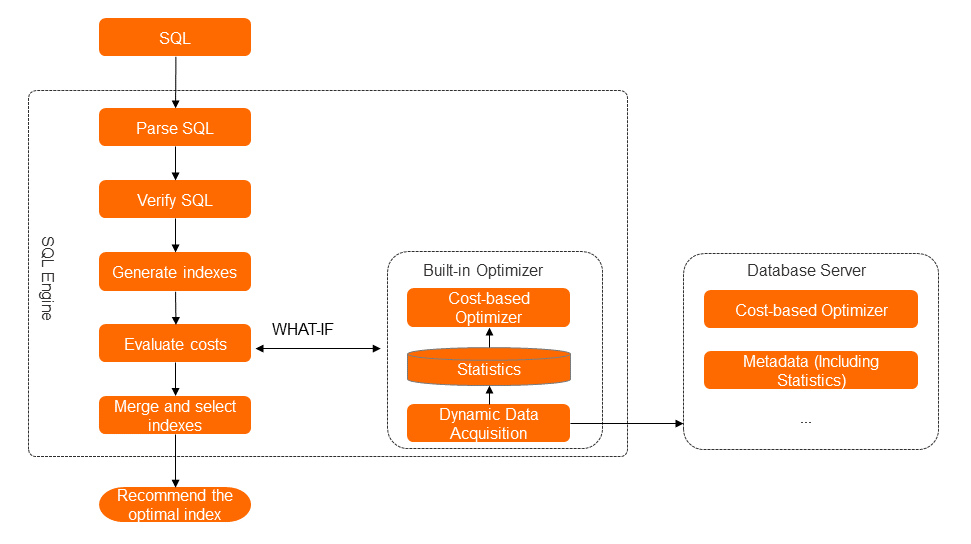
Le moteur traite chaque instruction SQL en suivant quatre étapes :
Analyse et vérification SQL : Analysez l'instruction SQL, vérifiez la syntaxe, identifiez les prédicats, les champs de tri, les champs d'agrégation et les champs de requête, puis construisez un arbre syntaxique. Vérifiez que toutes les tables et tous les champs référencés correspondent au schéma de la base de données.
Génération des index candidats : Générez plusieurs combinaisons d'index à partir de l'arbre syntaxique.
Évaluation basée sur les coûts : Utilisez un optimiseur intégré, indépendant du noyau de la base de données, pour récupérer les statistiques de la base de données (mises en cache dans le moteur de diagnostic) et calculer le coût de chaque index candidat et de chaque réécriture SQL candidate. Sélectionnez l'option présentant le coût le plus faible.
Fusion des index et sélection de l'index optimal : Lors du diagnostic de plusieurs instructions SQL sur la même instance, consolidez les recommandations d'index. Identifiez les index qui se chevauchent, ceux partageant des préfixes communs et les candidats redondants afin de produire un ensemble d'index minimal et efficace.
Recommandations basées sur les coûts par rapport aux recommandations basées sur des règles
Il existe deux approches pour formuler des recommandations d'optimisation SQL : l'approche basée sur des règles et l'approche basée sur les coûts. DAS utilise la méthode basée sur les coûts.
Méthode basée sur des règles
La méthode basée sur des règles applique des modèles fixes pour générer des index candidats sans évaluer leur coût. Pour une requête telle que :
SELECT *
FROM t1
WHERE time_created >= '2017-11-25'
AND consuming_time > 1000
ORDER BY consuming_time DESC;
La méthode basée sur des règles génère plusieurs candidats sans permettre de les classer :
IX1(time_created)
IX2(time_created, consuming_time)
IX3(consuming_time)
IX4(consuming_time, time_created)
Si la requête implique des jointures de tables ou des sous-requêtes, l'ambiguïté s'accroît encore davantage. La méthode basée sur des règles ne permet pas de déterminer quel index réduit réellement le coût d'exécution.
Méthode basée sur les coûts
La méthode basée sur les coûts évalue chaque candidat à l'aide des statistiques de la base de données et sélectionne celui dont le coût calculé est le plus faible, selon le même principe que l'optimiseur de base de données. Pour les problèmes NP (non déterministes polynomiaux) où une évaluation exhaustive est irréalisable, le moteur évalue autant de candidats que possible afin de trouver une solution quasi optimale.
Cette approche nécessite deux capacités dont les bases de données open source comme MySQL ne disposent pas par défaut :
Fonctionnalité WIT : Nécessaire pour simuler le coût d'un index hypothétique sans avoir à le créer. DAS implémente cette fonctionnalité indépendamment du noyau de la base de données.
Statistiques : Indispensables pour calculer avec précision les coûts des plans d'exécution. DAS collecte et met en cache les statistiques automatiquement.
Validation des capacités
La qualité des recommandations du moteur est mesurée en continu à l'aide d'une bibliothèque de cas de test basée sur des signatures. Chaque cas de test est décrit par sa signature, qui constitue une empreinte digitale du modèle SQL, du schéma, des statistiques et des paramètres environnementaux impliqués.
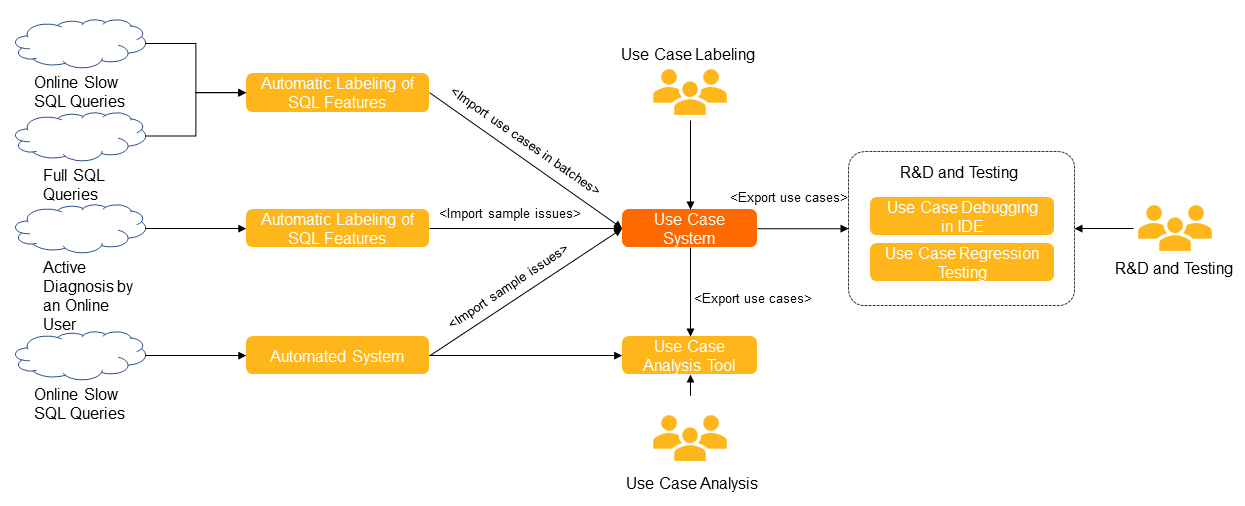
Les cas de test proviennent des instructions SQL exécutées au sein des services internes d'Alibaba Group. Toutes les données extraites, y compris les informations statistiques, sont chiffrées et anonymisées via un processus automatisé.
La bibliothèque est évaluée selon quatre dimensions :
Couverture des signatures : signatures de la bibliothèque couvertes par les cas de test existants
Analyse des écarts : signatures non encore couvertes ou échouant à la vérification SQL
Suivi des régressions : signatures présentant des échecs récurrents dans le temps
Taux de couverture par niveau de capacité
Cette boucle de rétroaction améliore continuellement la précision des recommandations du moteur.
Modes d'optimisation
Avant son lancement sur Alibaba Cloud, le moteur a fonctionné pendant des années au sein des services internes d'Alibaba Group, diagnostiquant en moyenne environ 50 000 instructions SQL par jour. DAS expose cette capacité via deux modes :
Optimisation personnalisée : Soumettez des instructions SQL spécifiques pour diagnostic. Le moteur renvoie des recommandations d'index et des suggestions de réécriture SQL accompagnées d'une estimation de l'amélioration des performances.
Optimisation automatique : DAS surveille les charges de travail des instances, identifie les requêtes lentes, les diagnostique et génère des suggestions d'optimisation. Après validation de chaque suggestion, DAS planifie l'optimisation, l'applique en ligne et surveille les performances après modification. L'intégralité du processus s'exécute sans intervention manuelle.
Les cas de restauration issus de l'optimisation automatique, les diagnostics ayant échoué et les problèmes signalés par les utilisateurs sont automatiquement réinjectés dans la bibliothèque de cas de test afin d'améliorer les futures recommandations.
Moteurs de base de données pris en charge
Le moteur de diagnostic SQL basé sur les coûts prend en charge les moteurs de base de données suivants :
ApsaraDB RDS for MySQL
PolarDB for MySQL
ApsaraDB RDS for PostgreSQL
PolarDB for PostgreSQL (Compatible with Oracle)
Pour PolarDB for MySQL, le moteur peut également recommander des In-Memory Column Indexes (IMCI) optimaux. Pour plus de détails, consultez
.