Knative Pod Autoscaler (KPA) met à l'échelle les pods en fonction du trafic en temps réel. KPA surveille la concurrence des pods et le nombre de requêtes par seconde (RPS) pour déterminer le nombre optimal de pods. Lorsque le trafic tombe à zéro, KPA réduit par défaut le nombre de pods à zéro, éliminant ainsi les coûts liés aux ressources inactives. Lorsque le trafic reprend, KPA crée des pods à la demande.
Prérequis
Déployer Knative dans le cluster ACS.
Fonctionnement
Knative Serving injecte un conteneur Queue Proxy nommé queue-proxy dans chaque pod. Ce conteneur signale les métriques de concurrence des requêtes à KPA. Sur la base des métriques signalées et de l'algorithme de mise à l'échelle, KPA ajuste le nombre de pods dans le Deployment.

KPA calcule le nombre cible de pods à l'aide de la formule suivante :
Pod count = Concurrent requests / (Max concurrency per pod x Target utilization)Par défaut, chaque pod gère jusqu'à 100 requêtes concurrentes et l'utilisation cible est de 70 %.
Exemple : La concurrence maximale est définie sur 10, l'utilisation cible sur 0,7 et 100 requêtes concurrentes arrivent. KPA calcule : 100 / (10 x 0,7) = 15 pods.
Configurer la ConfigMap config-autoscaler
Certains paramètres prennent en charge à la fois les annotations au niveau de la révision et les paramètres globaux de la ConfigMap. Lorsque les deux sont configurés, l'annotation au niveau de la révision est prioritaire.
Le comportement de KPA est contrôlé via la ConfigMap config-autoscaler. Consultez la configuration actuelle :
kubectl -n knative-serving describe cm config-autoscalerLe tableau suivant décrit les paramètres de la ConfigMap et leurs valeurs par défaut :
| Paramètre | Valeur par défaut | Description |
|---|---|---|
container-concurrency-target-default |
100 |
Nombre maximal par défaut de requêtes concurrentes par pod. |
container-concurrency-target-percentage |
70 |
Pourcentage d'utilisation cible de la concurrence. |
requests-per-second-target-default |
200 |
Cible RPS par défaut par pod. |
target-burst-capacity |
211 |
Seuil de capacité de pointe qui contrôle le routage de l'Activator. Lorsqu'il est défini sur 0, l'Activator ne gère les requêtes que lors de la réduction à zéro. Lorsqu'il est défini sur -1, toutes les requêtes passent toujours par l'Activator (capacité de pointe infinie). Les autres valeurs négatives ne sont pas valides. Lorsqu'elle est supérieure à 0 et que container-concurrency-target-percentage est 100, les requêtes passent toujours par l'Activator. Si (ready pods x max concurrency) - target-burst-capacity - panic concurrency < 0, la pointe de trafic dépasse la capacité et le système bascule vers l'Activator pour la mise en tampon des requêtes. |
stable-window |
60s |
Durée de la fenêtre de moyenne en mode stable. |
panic-window-percentage |
10.0 |
Fenêtre de panique exprimée en pourcentage de la fenêtre stable. La valeur par défaut donne une fenêtre de panique de 6 secondes. |
panic-threshold-percentage |
200.0 |
Pourcentage de seuil qui déclenche le mode panique. |
max-scale-up-rate |
1000.0 |
Nombre maximal de pods pour un seul événement de montée en puissance. Limite réelle : math.Ceil(MaxScaleUpRate x readyPodsCount). |
max-scale-down-rate |
2.0 |
Taux maximal de réduction d'échelle. Par défaut, la moitié des pods sont supprimés par cycle de réduction. |
enable-scale-to-zero |
true |
Active ou désactive la réduction à zéro. |
scale-to-zero-grace-period |
30s |
Délai avant la réduction à zéro après la dernière requête. |
scale-to-zero-pod-retention-period |
0s |
Durée minimale de conservation d'un pod avant la réduction à zéro. Utile lorsque le démarrage des pods est coûteux. |
pod-autoscaler-class |
kpa.autoscaling.knative.dev |
Plugin d'autoscaling. Valeurs prises en charge : KPA, Horizontal Pod Autoscaler (HPA) et Advanced Horizontal Pod Autoscaler (AHPA). |
activator-capacity |
100.0 |
Capacité de requête de l'Activator. |
initial-scale |
1 |
Nombre de pods créés au démarrage d'une révision. |
allow-zero-initial-scale |
false |
Autoriser une révision à démarrer avec zéro pod. |
min-scale |
0 |
Nombre minimal de pods pour une révision. 0 permet la réduction à zéro. |
max-scale |
0 |
Nombre maximal de pods pour une révision. 0 signifie qu'il n'y a pas de limite supérieure. |
scale-down-delay |
0s |
Délai avant la réduction d'échelle. 0s signifie une réduction immédiate. |
ConfigMap par défaut :
apiVersion: v1
kind: ConfigMap
metadata:
 name: config-autoscaler
 namespace: knative-serving
data:
 container-concurrency-target-default: "100"
 container-concurrency-target-percentage: "70"
 requests-per-second-target-default: "200"
 target-burst-capacity: "211"
 stable-window: "60s"
 panic-window-percentage: "10.0"
 panic-threshold-percentage: "200.0"
 max-scale-up-rate: "1000.0"
 max-scale-down-rate: "2.0"
 enable-scale-to-zero: "true"
 scale-to-zero-grace-period: "30s"
 scale-to-zero-pod-retention-period: "0s"
 pod-autoscaler-class: "kpa.autoscaling.knative.dev"
 activator-capacity: "100.0"
 initial-scale: "1"
 allow-zero-initial-scale: "false"
 min-scale: "0"
 max-scale: "0"
 scale-down-delay: "0s"
Configurer les métriques
Définissez la métrique de mise à l'échelle pour chaque révision à l'aide de l'annotation autoscaling.knative.dev/metric.
Métriques prises en charge :
concurrency,rps,cpu,memoryet métriques personnaliséesMétrique par défaut :
concurrency
Métrique de concurrence
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/metric: "concurrency"
Métrique RPS
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/metric: "rps"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Métrique CPU
Les métriques CPU et mémoire nécessitent la classe Horizontal Pod Autoscaler (HPA).
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/class: "hpa.autoscaling.knative.dev"
        autoscaling.knative.dev/metric: "cpu"
Métrique mémoire
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/class: "hpa.autoscaling.knative.dev"
        autoscaling.knative.dev/metric: "memory"
Configurer la concurrence
La concurrence définit le nombre maximal de requêtes simultanées qu'un seul pod peut gérer. Configurez la concurrence via des limites souples, des limites strictes, l'utilisation cible et les paramètres RPS.
Limite souple
Une limite souple est une cible de mise à l'échelle, pas une frontière stricte. Lors des pointes de trafic, la concurrence réelle peut temporairement dépasser cette valeur.
Niveau de la révision
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "200"
Niveau global (ConfigMap)
apiVersion: v1
kind: ConfigMap
metadata:
 name: config-autoscaler
 namespace: knative-serving
data:
 container-concurrency-target-default: "200"
Limite stricte
Une limite stricte est une borne supérieure rigide pour les requêtes concurrentes. Lorsque la concurrence atteint cette limite, les requêtes excédentaires sont mises en tampon par le queue-proxy ou l'Activator jusqu'à ce que la capacité soit disponible.
Utilisez une limite stricte uniquement lorsque votre application possède un plafond de concurrence clair. Définir une limite stricte basse peut dégrader le débit et augmenter la latence.
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
      containerConcurrency: 50
Utilisation cible
L'utilisation cible déclenche la mise à l'échelle avant que la concurrence n'atteigne la limite stricte. Cela réduit la latence de démarrage à froid en créant des pods à l'avance.
Exemple : containerConcurrency est de 10 et l'utilisation cible est de 70 %. Un nouveau pod est créé lorsque la concurrence moyenne sur les pods existants atteint 7. Comme le démarrage des pods prend du temps, une valeur d'utilisation cible plus faible déclenche une montée en puissance plus précoce.
Niveau de la révision
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target-utilization-percentage: "70"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Niveau global (ConfigMap)
apiVersion: v1
kind: ConfigMap
metadata:
 name: config-autoscaler
 namespace: knative-serving
data:
 container-concurrency-target-percentage: "70"
Mise à l'échelle basée sur les RPS
Les RPS définissent le nombre de requêtes qu'un seul pod gère par seconde.
Niveau de la révision
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "150"
        autoscaling.knative.dev/metric: "rps"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Niveau global (ConfigMap)
apiVersion: v1
kind: ConfigMap
metadata:
 name: config-autoscaler
 namespace: knative-serving
data:
 requests-per-second-target-default: "150"
Configurer la réduction à zéro
Activer ou désactiver la réduction à zéro (global)
Définissez enable-scale-to-zero sur "true" ou "false" pour contrôler si les services Knative inactifs sont réduits à zéro pod.
apiVersion: v1
kind: ConfigMap
metadata:
 name: config-autoscaler
 namespace: knative-serving
data:
 enable-scale-to-zero: "false"
Période de grâce (global)
Définissez scale-to-zero-grace-period pour spécifier le temps d'attente avant qu'un service inactif ne soit réduit à zéro.
apiVersion: v1
kind: ConfigMap
metadata:
 name: config-autoscaler
 namespace: knative-serving
data:
 scale-to-zero-grace-period: "40s"
Période de rétention des pods
Contrôlez la durée pendant laquelle un pod est conservé après que le service devient inactif. Cela s'avère utile lorsque les coûts de démarrage des pods sont élevés.
Niveau de la révision
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/scale-to-zero-pod-retention-period: "1m5s"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Niveau global (ConfigMap)
apiVersion: v1
kind: ConfigMap
metadata:
 name: config-autoscaler
 namespace: knative-serving
data:
 scale-to-zero-pod-retention-period: "42s"
Configurer les seuils cibles de mise à l'échelle
Définissez le seuil cible de mise à l'échelle par révision à l'aide de l'annotation autoscaling.knative.dev/target. Pour un seuil global, utilisez container-concurrency-target-default dans la ConfigMap.
Niveau de la révision
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "50"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Niveau global (ConfigMap)
apiVersion: v1
kind: ConfigMap
metadata:
 name: config-autoscaler
 namespace: knative-serving
data:
 container-concurrency-target-default: "200"
Modes stable et panique
KPA fonctionne selon deux modes pour équilibrer réactivité et stabilité.
Mode stable
KPA fait la moyenne des requêtes concurrentes sur tous les pods au sein de la fenêtre stable (par défaut : 60 secondes). Il ajuste le nombre de pods en fonction de cette moyenne pour maintenir une distribution de charge régulière.
Mode panique
KPA fait la moyenne des requêtes concurrentes sur une fenêtre de panique plus courte (par défaut : 6 secondes). La fenêtre de panique est dérivée de la fenêtre stable :
Panic window = Stable window x panic-window-percentageLa valeur par défaut de panic-window-percentage est de 0,1 (10 %), donc la fenêtre de panique par défaut est de 60 x 0,1 = 6 secondes.
KPA entre en mode panique lorsque le nombre de pods calculé en mode panique atteint ou dépasse le seuil de panique. Le seuil de panique est :
Panic threshold = panic-threshold-percentage / 100La valeur par défaut de panic-threshold-percentage est de 200, donc le seuil de panique par défaut est de 2. Si le nombre de pods issu du calcul en mode panique est supérieur ou égal au double des pods prêts actuels, KPA effectue une mise à l'échelle vers le nombre de pods du mode panique. Sinon, KPA utilise le nombre de pods du mode stable.
Exemples de scénarios
Mise à l'échelle basée sur les requêtes concurrentes
Déployez un service avec une cible de concurrence de 10 et vérifiez que KPA met à l'échelle les pods en réponse au trafic.
-
Créez un fichier nommé
autoscale-go.yamlet déployez-le sur le cluster.apiVersion: serving.knative.dev/v1 kind: Service metadata: name: autoscale-go namespace: default spec: template: metadata: labels: app: autoscale-go annotations: autoscaling.knative.dev/target: "10" spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/autoscale-go:0.1kubectl apply -f autoscale-go.yaml -
Récupérez la passerelle d'accès au service. Exécutez l'une des commandes suivantes selon le contrôleur d'entrée utilisé :
ALB
Exécutez la commande suivante pour récupérer la passerelle d'accès au service.
kubectl get albconfig knative-internetRésultat attendu :
    NAME               ALBID                    DNSNAME                                              PORT&PROTOCOL   CERTID   AGE
    knative-internet   alb-hvd8nngl0lsdra15g0   alb-hvd8nng******.cn-beijing.alb.aliyuncs.com                            2
MSE
Exécutez la commande suivante pour récupérer la passerelle d'accès au service.
kubectl -n knative-serving get ing stats-ingressRésultat attendu :
    NAME            CLASS                  HOSTS   ADDRESS                         PORTS   AGE
    stats-ingress   knative-ingressclass   *       101.201.XX.XX,192.168.XX.XX   80      15d
ASM
Exécutez la commande suivante pour récupérer la passerelle d'accès au service.
kubectl get svc istio-ingressgateway --namespace istio-system --output jsonpath="{.status.loadBalancer.ingress[*]['ip']}"Résultat attendu :
121.XX.XX.XXKourier
Exécutez la commande suivante pour obtenir la passerelle d'accès au service.
kubectl -n knative-serving get svc kourierRésultat attendu :
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kourier LoadBalancer 10.0.XX.XX 39.104.XX.XX 80:31133/TCP,443:32515/TCP 49m -
Envoyez 50 requêtes concurrentes pendant 30 secondes à l'aide de l'outil de test de charge Hey. Remplacez
121.199.XXX.XXXpar l'adresse IP de la passerelle obtenue à l'étape précédente. Résultat attendu : KPA effectue une montée en puissance vers 5 pods (50 requêtes concurrentes / cible de concurrence de 10 = 5 pods).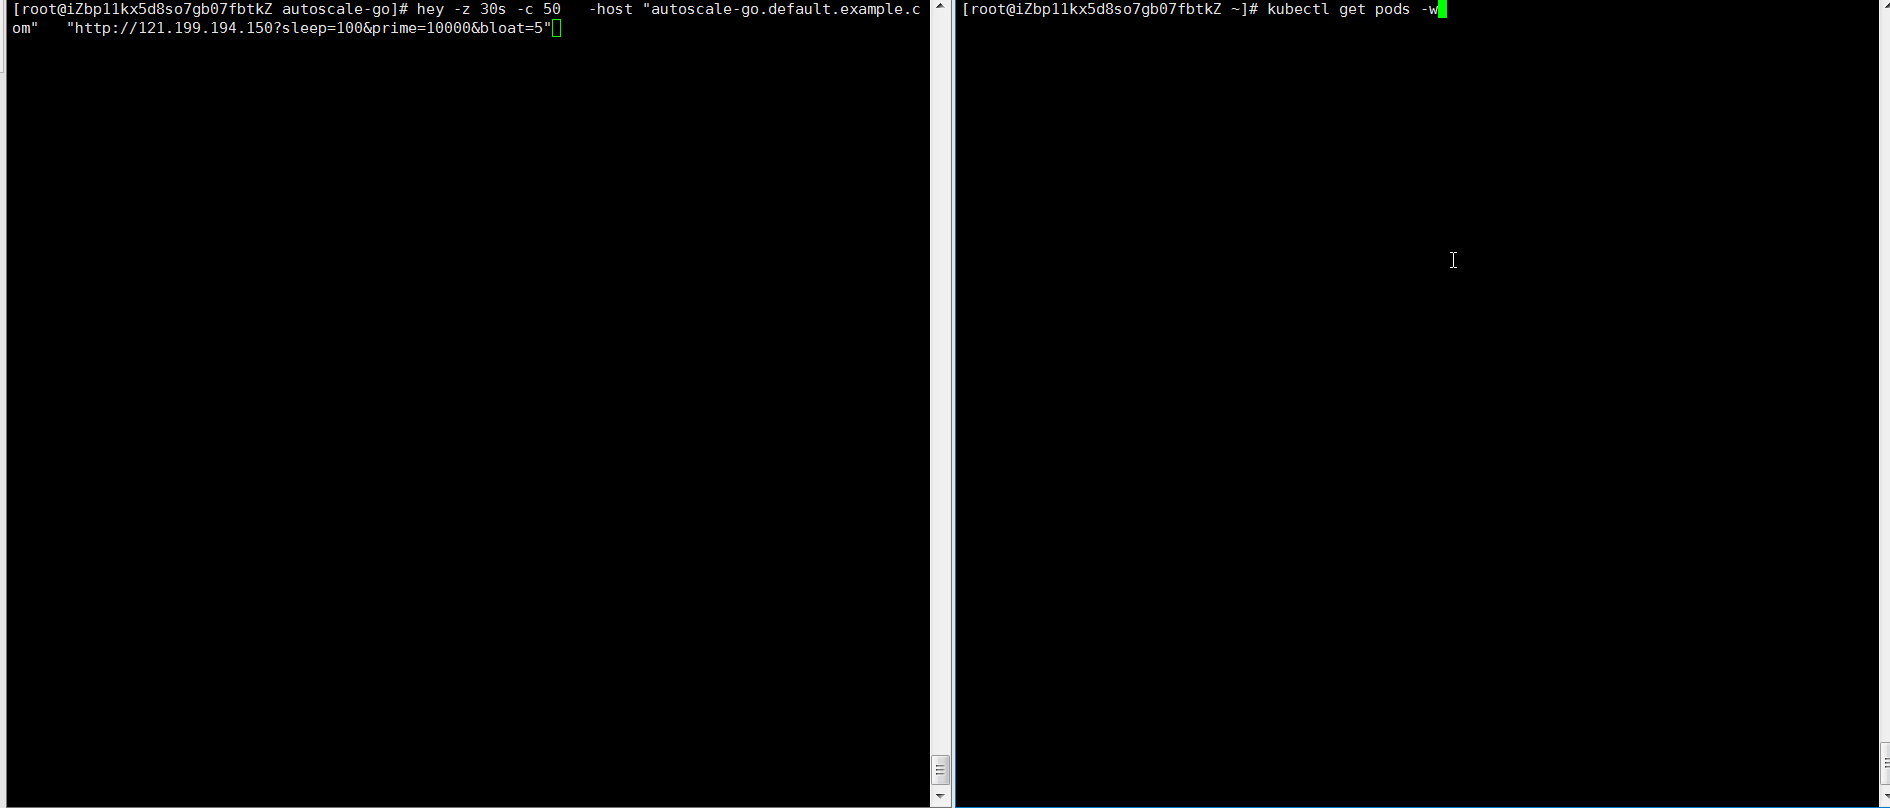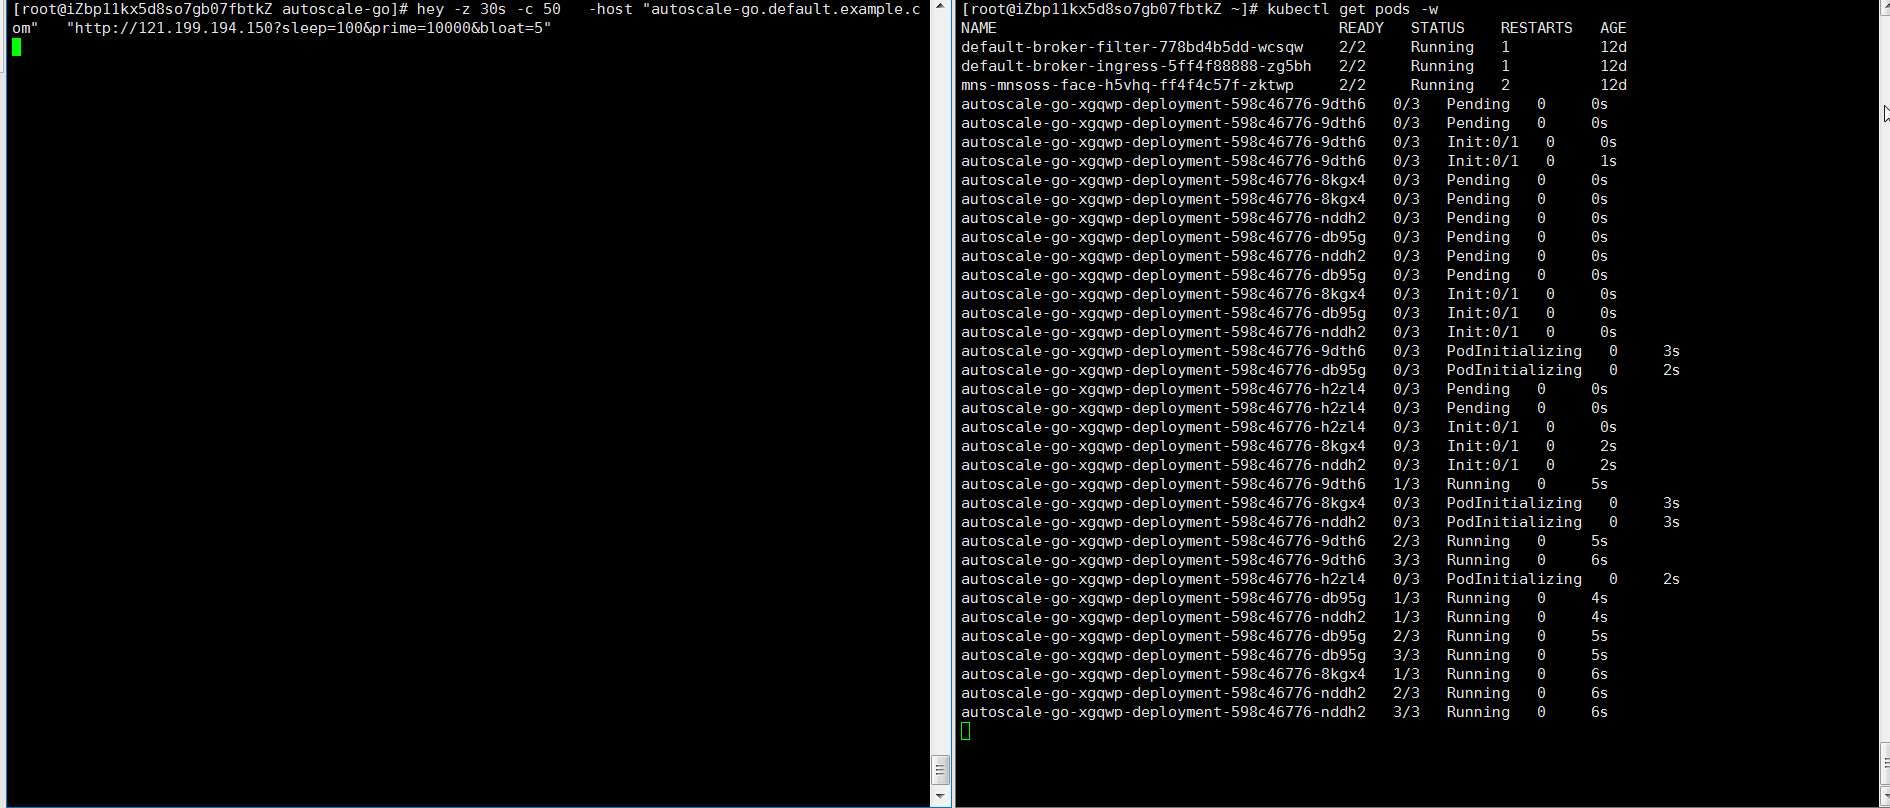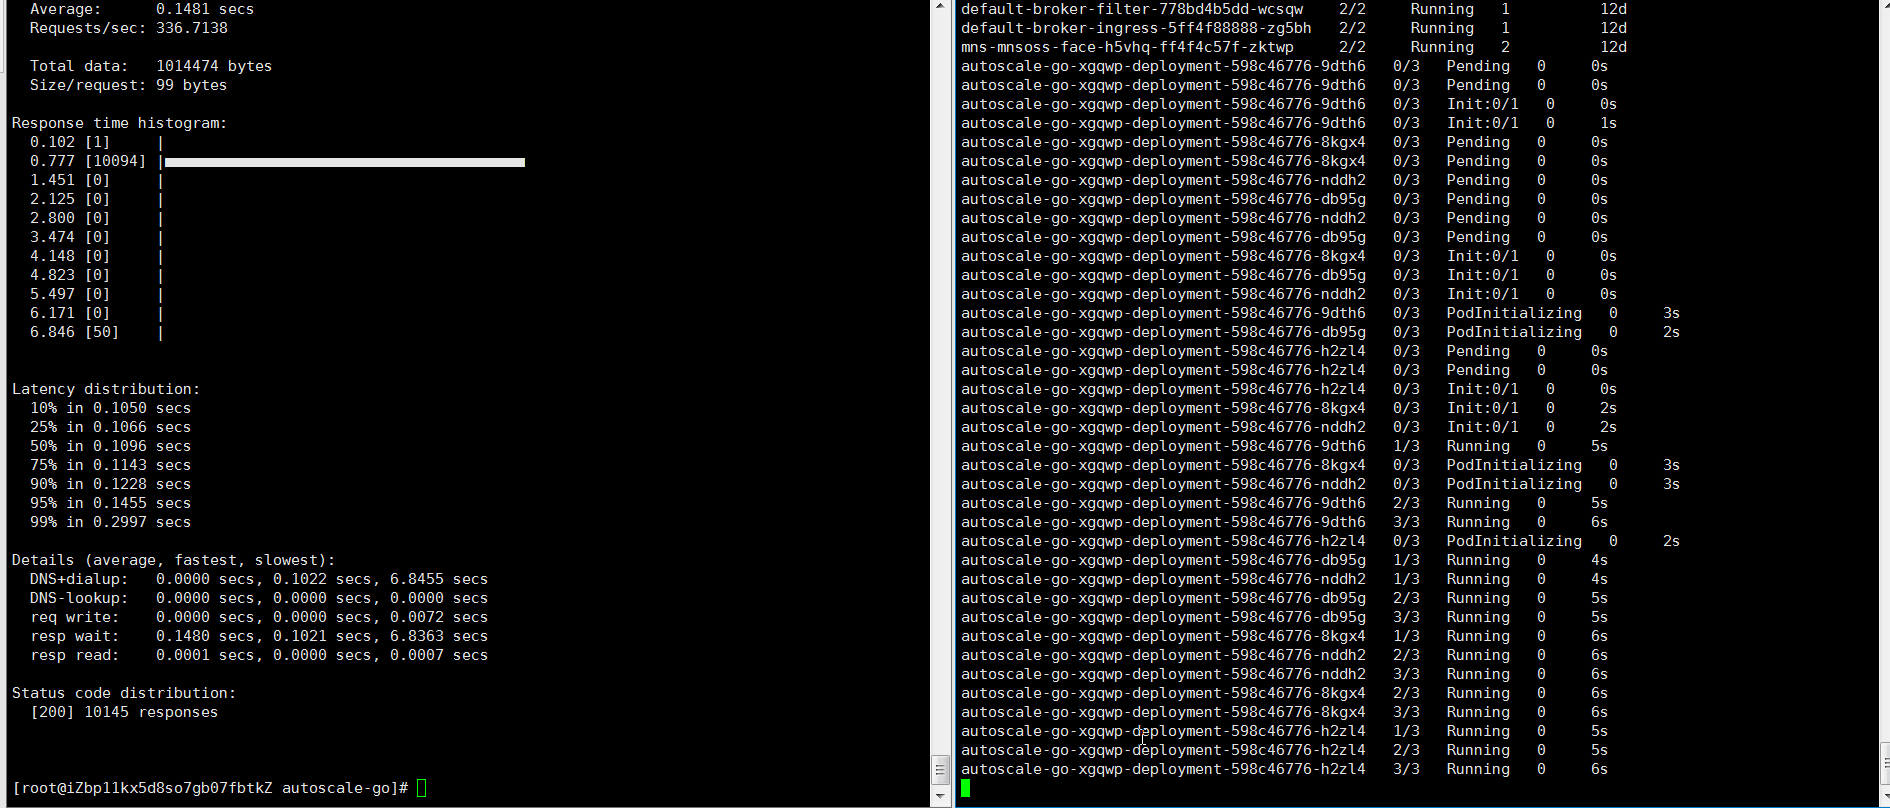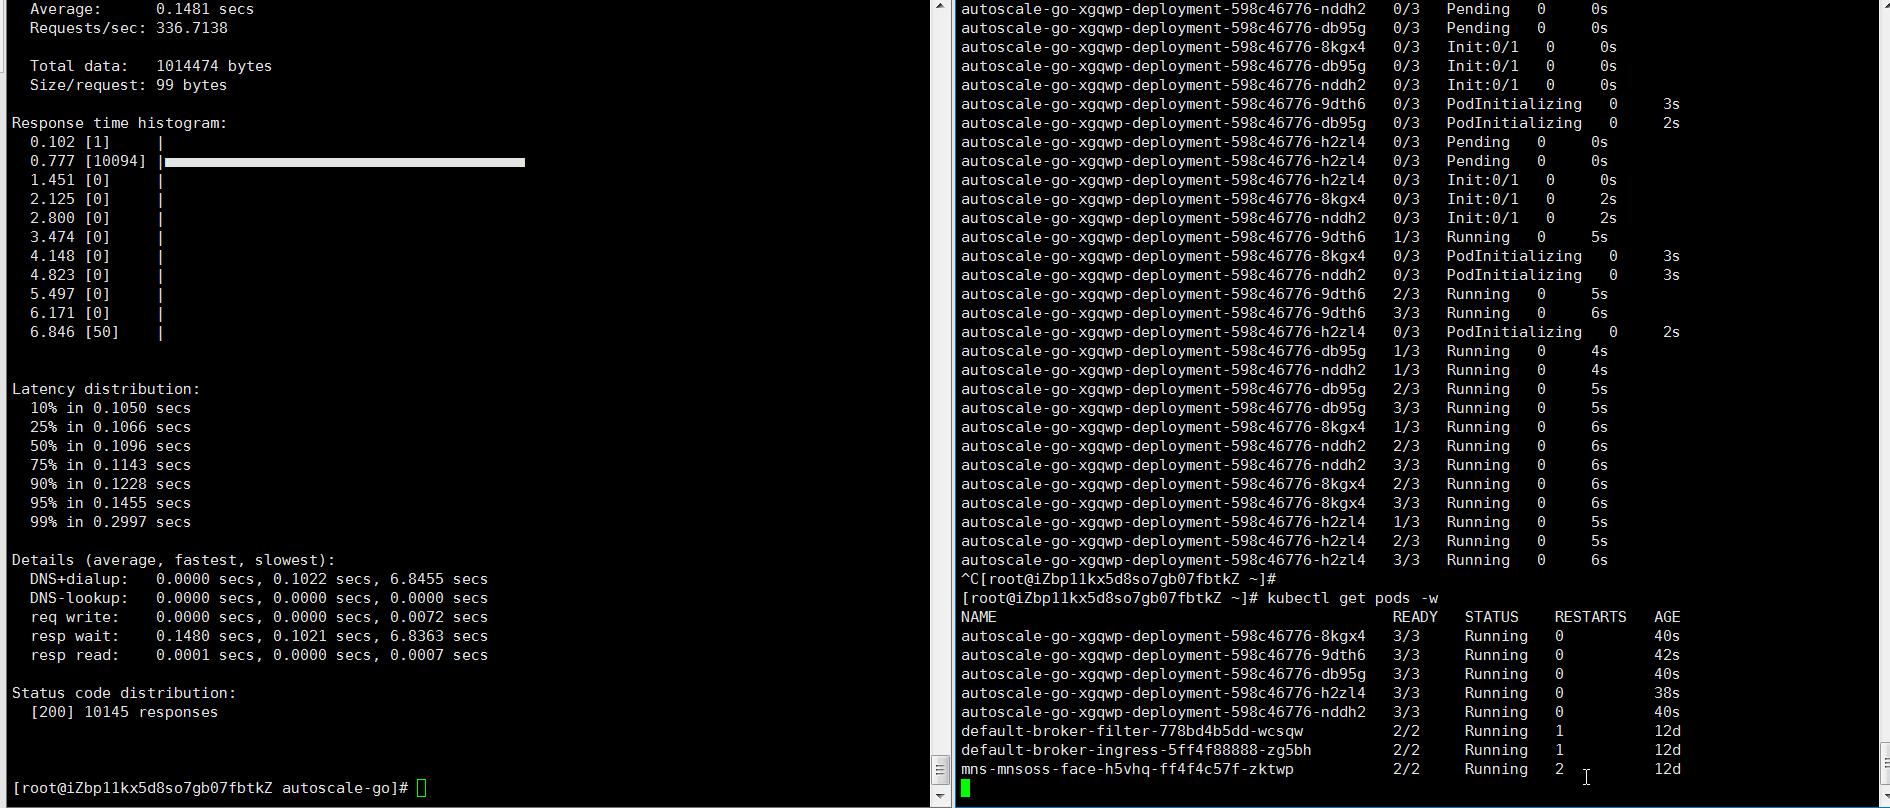
    hey -z 30s -c 50 \
      -host "autoscale-go.default.example.com" \
      "http://121.199.XXX.XXX"
Mise à l'échelle avec des limites
Déployez un service avec une cible de concurrence de 10, un minimum de 1 pod et un maximum de 3 pods.
-
Créez un fichier nommé
autoscale-go.yamlet déployez-le sur le cluster.apiVersion: serving.knative.dev/v1 kind: Service metadata: name: autoscale-go namespace: default spec: template: metadata: labels: app: autoscale-go annotations: autoscaling.knative.dev/target: "10" autoscaling.knative.dev/min-scale: "1" autoscaling.knative.dev/max-scale: "3" spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/autoscale-go:0.1kubectl apply -f autoscale-go.yaml -
Récupérez la passerelle d'accès au service. Exécutez l'une des commandes suivantes selon le contrôleur d'entrée utilisé :
ALB
Exécutez la commande suivante pour récupérer la passerelle d'accès au service.
kubectl get albconfig knative-internetRésultat attendu :
    NAME               ALBID                    DNSNAME                                              PORT&PROTOCOL   CERTID   AGE
    knative-internet   alb-hvd8nngl0lsdra15g0   alb-hvd8nng******.cn-beijing.alb.aliyuncs.com                            2
MSE
Exécutez la commande suivante pour récupérer la passerelle d'accès au service.
kubectl -n knative-serving get ing stats-ingressRésultat attendu :
    NAME            CLASS                  HOSTS   ADDRESS                         PORTS   AGE
    stats-ingress   knative-ingressclass   *       101.201.XX.XX,192.168.XX.XX   80      15d
ASM
Exécutez la commande suivante pour récupérer la passerelle d'accès au service.
kubectl get svc istio-ingressgateway --namespace istio-system --output jsonpath="{.status.loadBalancer.ingress[*]['ip']}"Résultat attendu :
121.XX.XX.XXKourier
Exécutez la commande suivante pour obtenir la passerelle d'accès au service.
kubectl -n knative-serving get svc kourierRésultat attendu :
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kourier LoadBalancer 10.0.XX.XX 39.104.XX.XX 80:31133/TCP,443:32515/TCP 49m -
Envoyez 50 requêtes concurrentes pendant 30 secondes à l'aide de l'outil de test de charge Hey. Remplacez
121.199.XXX.XXXpar l'adresse IP de la passerelle obtenue à l'étape précédente. Résultat attendu : KPA effectue une montée en puissance jusqu'à un maximum de 3 pods (limité parmax-scale). Lorsque le trafic s'arrête, 1 pod reste en cours d'exécution (limité parmin-scale).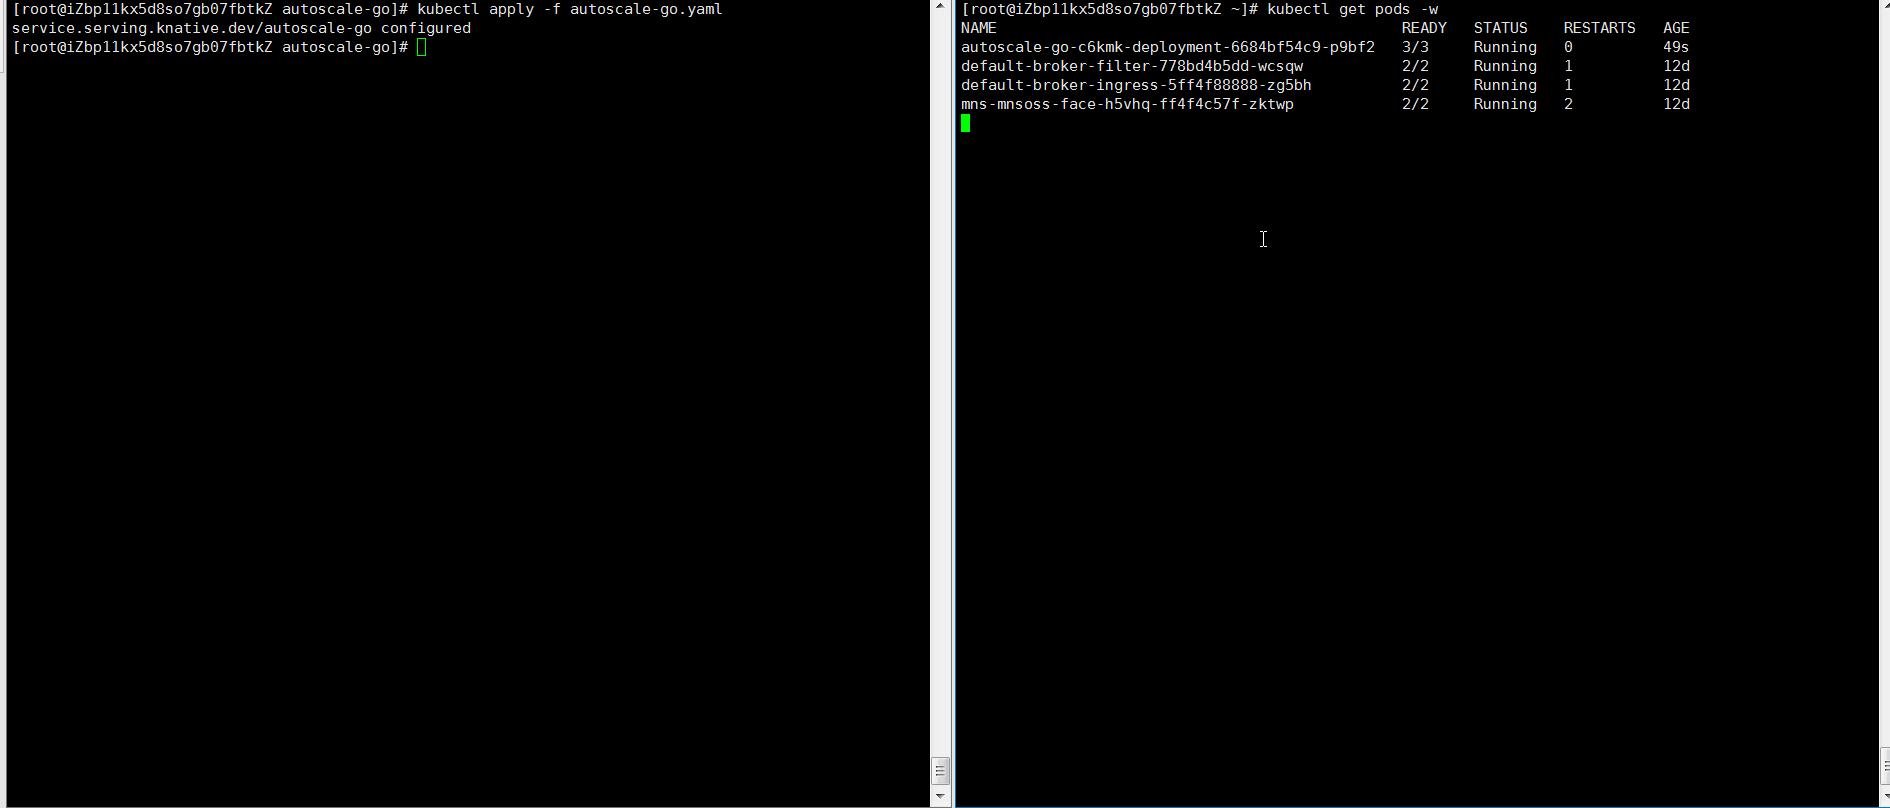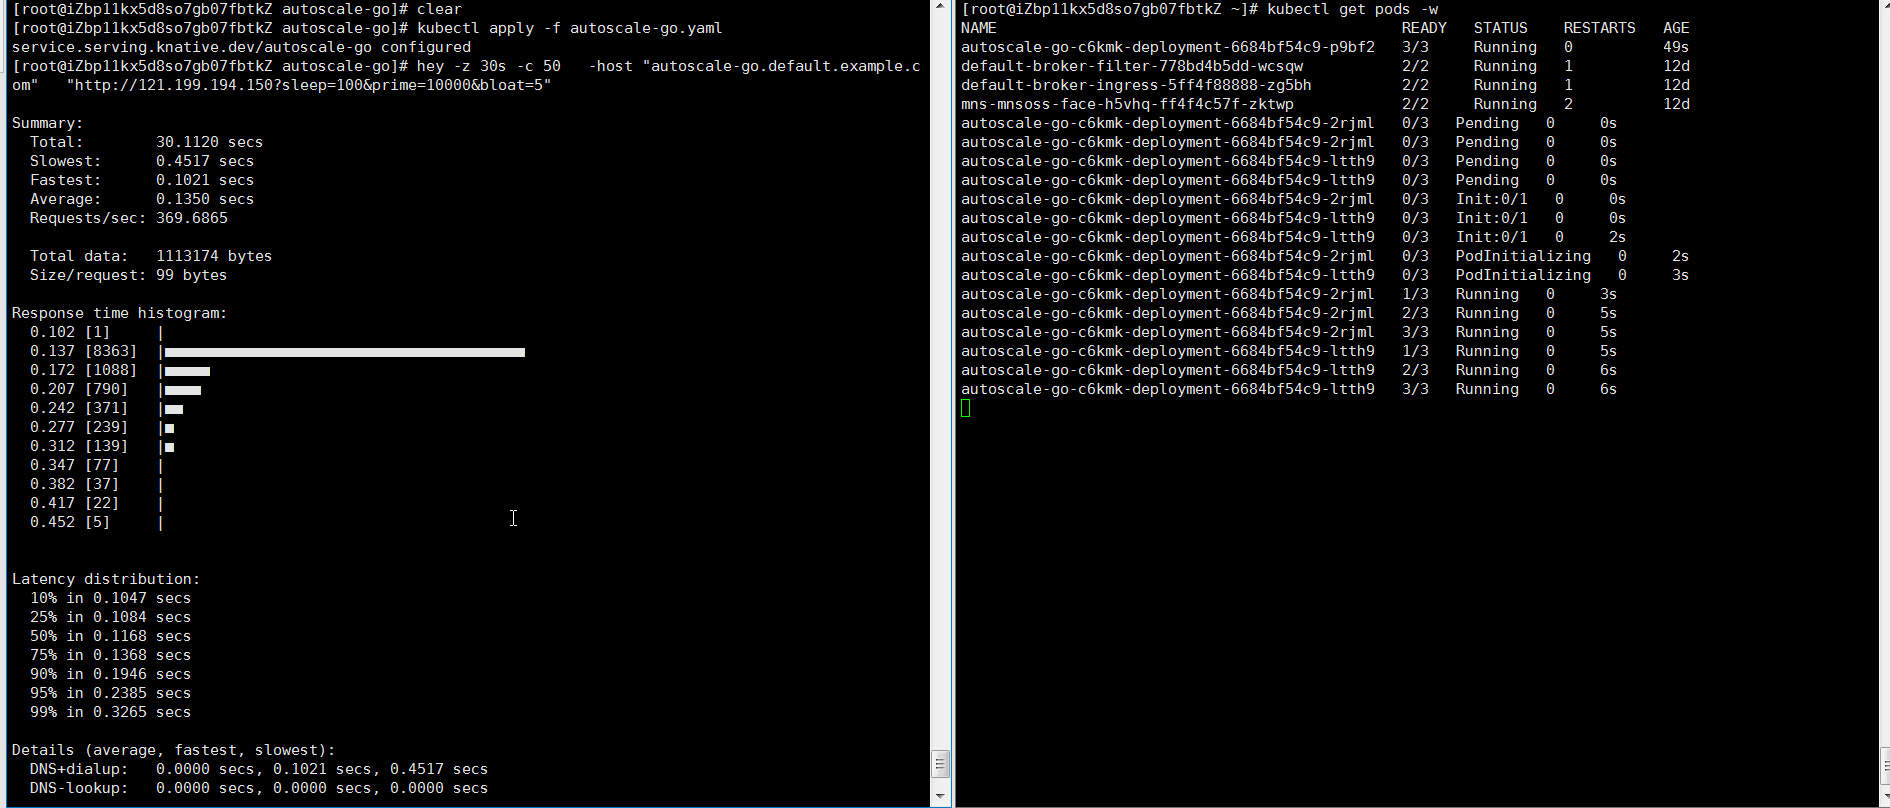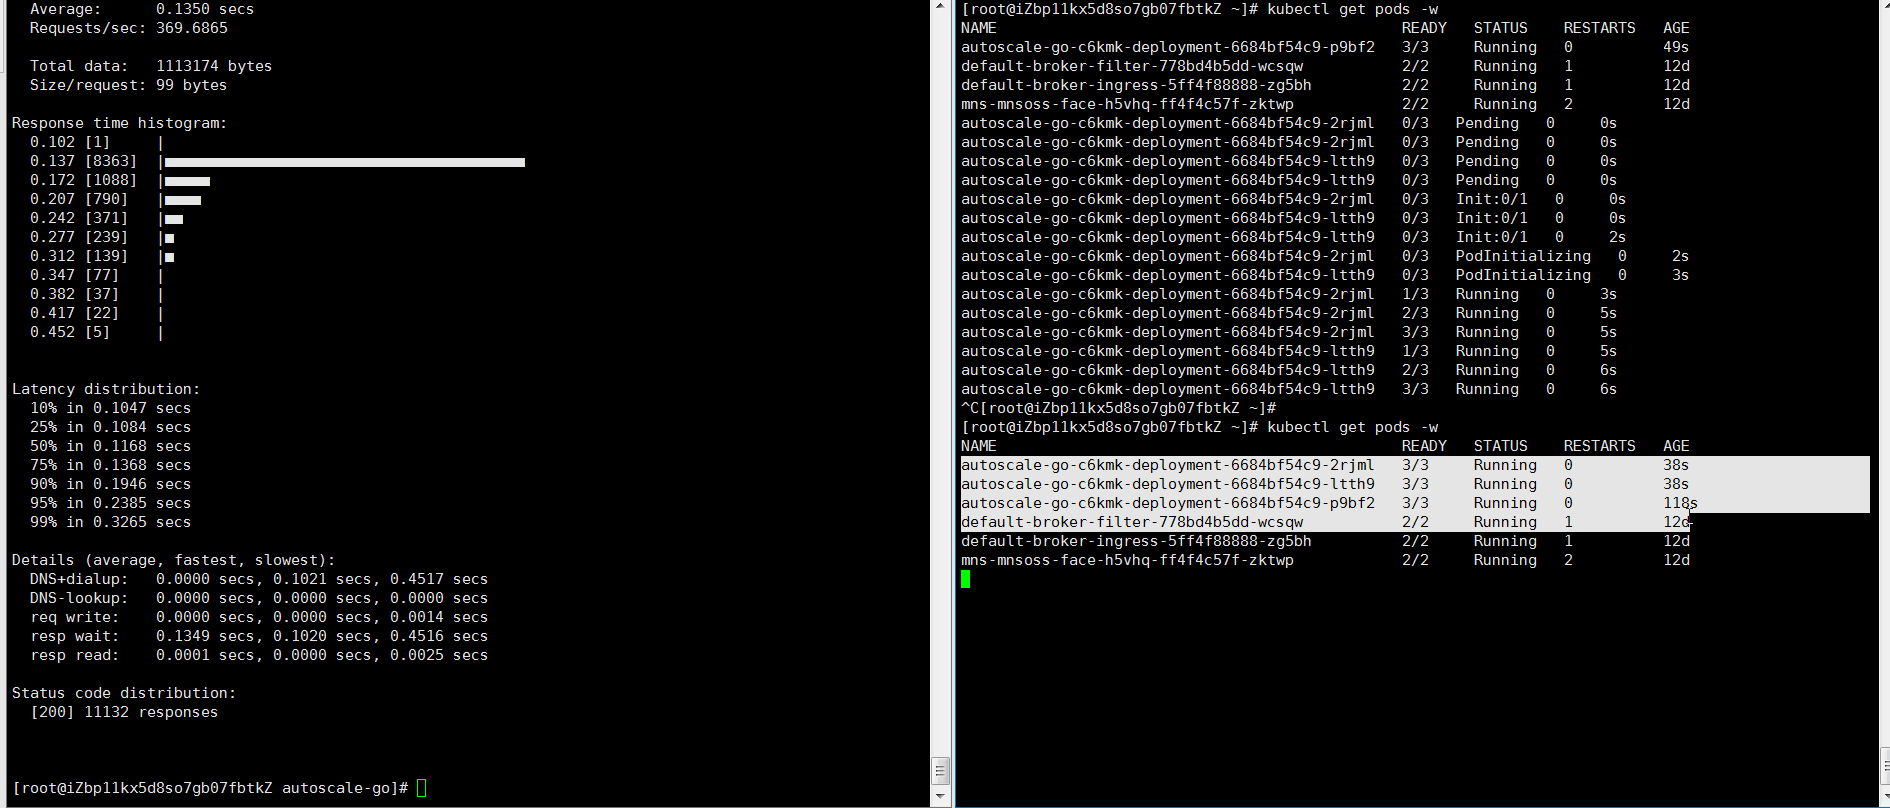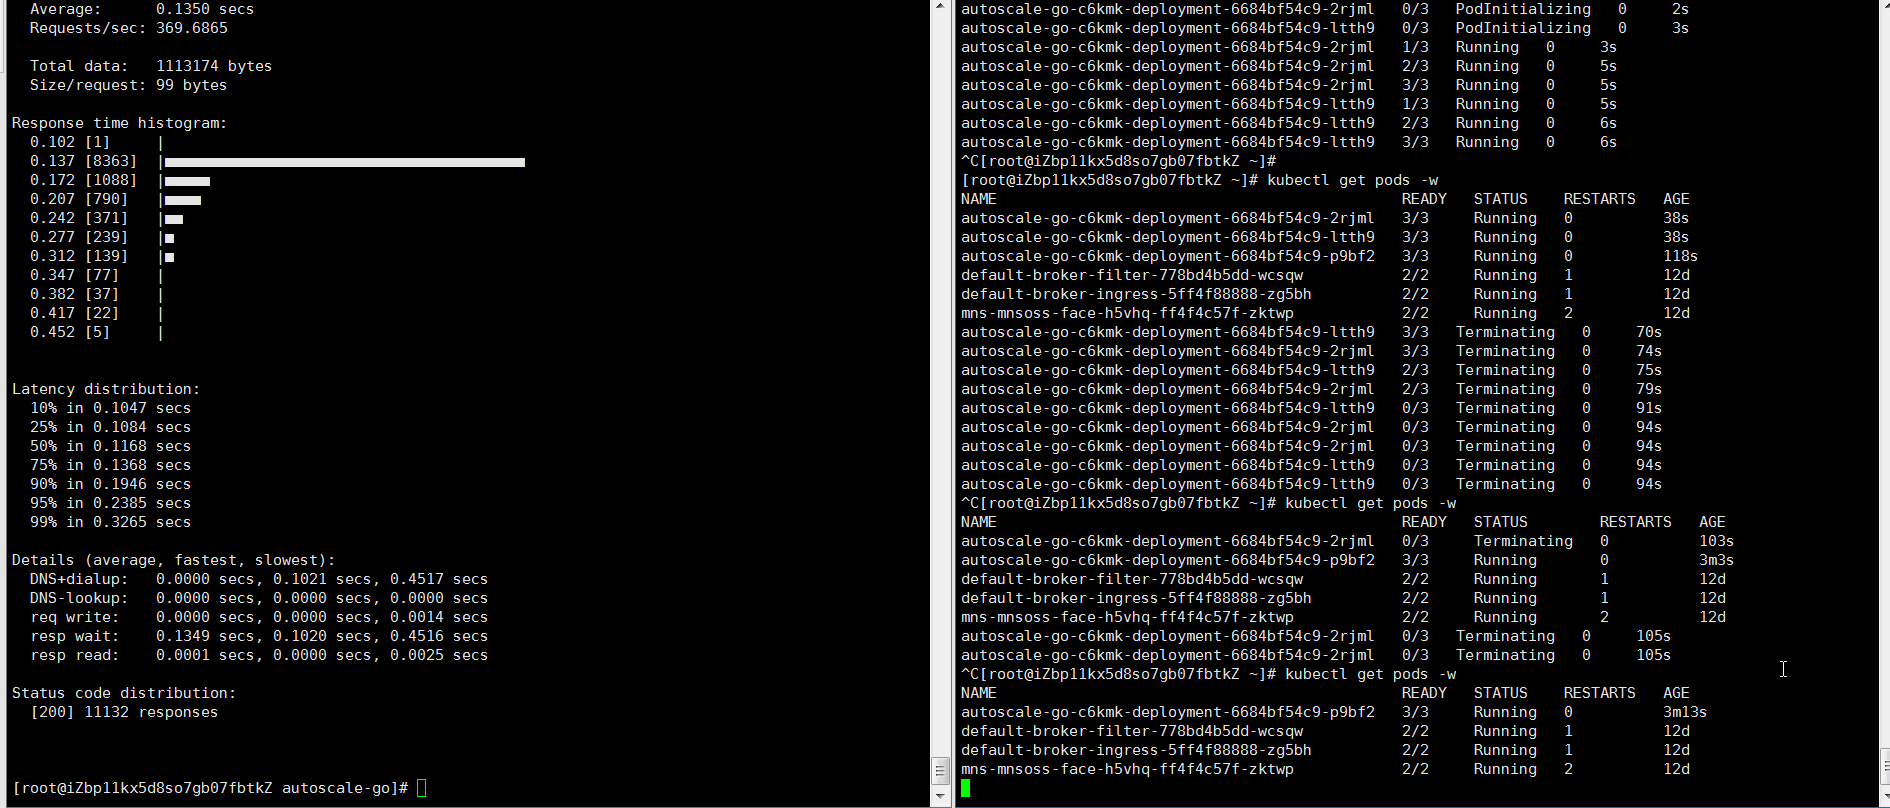
    hey -z 30s -c 50 \
      -host "autoscale-go.default.example.com" \
      "http://121.199.XXX.XXX"
Références
Utilisez un Advanced Horizontal Pod Autoscaler (AHPA) dans Knative pour mettre à l'échelle les ressources de manière proactive en fonction des métriques historiques. Pour plus d'informations, consultez Utiliser AHPA pour implémenter la mise à l'échelle automatique planifiée.