Une fois la sonde installée pour votre application, ARMS commence à la surveiller. Sur la page Application Overview, vous pouvez consulter les métriques clés telles que le nombre de requêtes, le nombre d'erreurs, la latence et le nombre d'instances.
Prérequis
ARMS Application Monitoring propose une nouvelle page de détails de surveillance pour les utilisateurs ayant activé le nouveau modèle de facturation. Pour plus d'informations sur ce nouveau modèle, consultez la rubrique Product Billing (New).
Si vous n'avez pas activé le nouveau modèle de facturation mais souhaitez accéder à la nouvelle page de détails de surveillance, cliquez sur Switch to New Version dans la page Application List.
Vous avez installé une sonde pour votre application. Pour obtenir des instructions, consultez la rubrique Overview of Application Monitoring Integration.
Afficher la vue d'ensemble de l'application
Connectez-vous à la console ARMS. Dans le volet de navigation de gauche, choisissez .
-
Dans la page Application List, sélectionnez la région dans la barre de navigation supérieure, puis cliquez sur le nom de l'application.
RemarqueLes icônes de la colonne Language ont les significations suivantes :
 : une application Java connectée à Application Monitoring.
 : une application Golang connectée à Application Monitoring.
 : une application Python connectée à Application Monitoring.
- : une application connectée à Managed Service for OpenTelemetry.
Dans la barre de navigation supérieure, cliquez sur Application Overview.
Description du tableau de bord
La page Application Overview adapte automatiquement son tableau de bord en fonction du mode d'intégration de votre application. Les métriques CPU s'affichent différemment selon que l'environnement est ECS ou conteneurisé.
Dans les scénarios conteneurisés, si vous avez intégré Managed Service for Prometheus, le tableau de bord privilégie les données issues de Managed Service for Prometheus pour afficher les métriques des conteneurs. Pour savoir comment intégrer des conteneurs à Managed Service for Prometheus, consultez la rubrique Container Observability.
Si votre environnement conteneurisé n'a pas intégré Managed Service for Prometheus, assurez-vous que la version de votre sonde Application Monitoring est 4.1.0 ou ultérieure. Cette version affiche les métriques de base des conteneurs. Pour plus de détails sur la sonde, consultez la rubrique Probe (Java Agent) Version Guide.
Environnement ECS
|
Panneau |
Style |
Description |
|
Nombre de requêtes |
Indicateur numérique |
Nombre total de requêtes pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre de requêtes par rapport à la même période de la veille. |
|
Nombre d'erreurs |
Indicateur numérique |
Nombre total d'erreurs pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre d'erreurs par rapport à la même période de la veille. |
|
Latence moyenne |
Indicateur numérique |
Latence moyenne pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage de la latence moyenne par rapport à la même période de la veille. |
|
Nombre d'instances |
Indicateur numérique |
Nombre total d'instances pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre d'instances par rapport à la même période de la veille. |
|
Nombre de requêtes |
Graphique en colonnes |
Tendance du nombre de requêtes sur la période spécifiée, empilée par type d'appel. |
|
Nombre d'erreurs |
Graphique en colonnes / graphique linéaire |
Nombre d'erreurs : Tendance du nombre d'erreurs sur la période spécifiée, affichée sous forme de graphique en colonnes avec le nombre d'erreurs sur l'axe y gauche. Taux d'erreur : Tendance du taux d'erreur sur la période spécifiée, affichée avec le taux d'erreur sur l'axe y droit. |
|
Temps écoulé |
Graphique linéaire |
Tendance de la latence sur la période spécifiée, indiquant les valeurs moyennes, P99, P90 et P75. |
|
Utilisation maximale du processeur |
Graphique en nid d'abeille |
Utilisation maximale du processeur de l'hôte exécutant l'application pendant la période spécifiée. Les états suivants sont disponibles :
|
|
Principaux services par nombre de requêtes |
TOP 5 |
Cinq principales interfaces de service par nombre total de requêtes pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Principaux services par nombre d'erreurs |
TOP 5 |
Cinq principales interfaces de service par nombre total d'erreurs pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Principaux services par latence moyenne |
TOP 5 |
Cinq principales interfaces de service par latence moyenne pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Principales instances par utilisation maximale du processeur |
TOP 5 |
Hôtes présentant l'utilisation du processeur la plus élevée pendant la période spécifiée. |
Environnement conteneurisé (édition Prometheus)
|
Panneau |
Style |
Description |
|
Nombre de requêtes |
Indicateur numérique |
Nombre total de requêtes pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre de requêtes par rapport à la même période de la veille. |
|
Nombre d'erreurs |
Indicateur numérique |
Nombre total d'erreurs pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre d'erreurs par rapport à la même période de la veille. |
|
Latence moyenne |
Indicateur numérique |
Latence moyenne pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage de la latence moyenne par rapport à la même période de la veille. |
|
Nombre d'instances |
Indicateur numérique |
Nombre total d'instances pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre d'instances par rapport à la même période de la veille. |
|
Nombre de requêtes |
Graphique en colonnes |
Tendance du nombre de requêtes sur la période spécifiée, empilée par type d'appel. |
|
Nombre d'erreurs |
Graphique en colonnes / graphique linéaire |
Nombre d'erreurs : Tendance du nombre d'erreurs sur la période spécifiée, affichée sous forme de graphique en colonnes avec le nombre d'erreurs sur l'axe y gauche. Taux d'erreur : Tendance du taux d'erreur sur la période spécifiée, affichée avec le taux d'erreur sur l'axe y droit. |
|
Temps écoulé |
Graphique linéaire |
Tendance de la latence sur la période spécifiée, indiquant les valeurs moyennes, P99, P90 et P75. |
|
Utilisation du processeur |
Graphique en nid d'abeille |
Utilisation du processeur du conteneur pendant la période spécifiée. Dans les scénarios multi-clusters, seul le cluster ayant signalé les données en premier est affiché. |
|
Principaux services par nombre de requêtes |
TOP 5 |
Cinq principales interfaces de service par nombre total de requêtes pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Principaux services par nombre d'erreurs |
TOP 5 |
Cinq principales interfaces de service par nombre total d'erreurs pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Principaux services par latence moyenne |
TOP 5 |
Cinq principales interfaces de service par latence moyenne pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Classement par utilisation du processeur |
TOP 5 |
Conteneurs présentant l'utilisation du processeur la plus élevée pendant la période spécifiée. Dans les scénarios multi-clusters, seul le cluster ayant signalé les données en premier est affiché. |
Environnement conteneurisé (édition Auto-collecte ARMS)
|
Panneau |
Style |
Description |
|
Nombre de requêtes |
Indicateur numérique |
Nombre total de requêtes pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre de requêtes par rapport à la même période de la veille. |
|
Nombre d'erreurs |
Indicateur numérique |
Nombre total d'erreurs pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre d'erreurs par rapport à la même période de la veille. |
|
Latence moyenne |
Indicateur numérique |
Latence moyenne pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage de la latence moyenne par rapport à la même période de la veille. |
|
Nombre d'instances |
Indicateur numérique |
Nombre total d'instances pour l'application pendant la période spécifiée. Variation jour par jour : Variation en pourcentage du nombre d'instances par rapport à la même période de la veille. |
|
Nombre de requêtes |
Graphique en colonnes |
Tendance du nombre de requêtes sur la période spécifiée, empilée par type d'appel. |
|
Nombre d'erreurs |
Graphique en colonnes / graphique linéaire |
Nombre d'erreurs : Tendance du nombre d'erreurs sur la période spécifiée, affichée sous forme de graphique en colonnes avec le nombre d'erreurs sur l'axe y gauche. Taux d'erreur : Tendance du taux d'erreur sur la période spécifiée, affichée avec le taux d'erreur sur l'axe y droit. |
|
Temps écoulé |
Graphique linéaire |
Tendance de la latence sur la période spécifiée, indiquant les valeurs moyennes, P99, P90 et P75. |
|
Utilisation du processeur |
Graphique en nid d'abeille |
Utilisation du processeur du conteneur pendant la période spécifiée. |
|
Principaux services par nombre de requêtes |
TOP 5 |
Cinq principales interfaces de service par nombre total de requêtes pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Principaux services par nombre d'erreurs |
TOP 5 |
Cinq principales interfaces de service par nombre total d'erreurs pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Principaux services par latence moyenne |
TOP 5 |
Cinq principales interfaces de service par latence moyenne pendant la période spécifiée. Les types d'appels pris en charge incluent les éléments suivants :
|
|
Principaux conteneurs par utilisation du processeur |
TOP 5 |
Conteneurs présentant l'utilisation du processeur la plus élevée pendant la période spécifiée. |
Fonctionnalités des panneaux
Points d'action
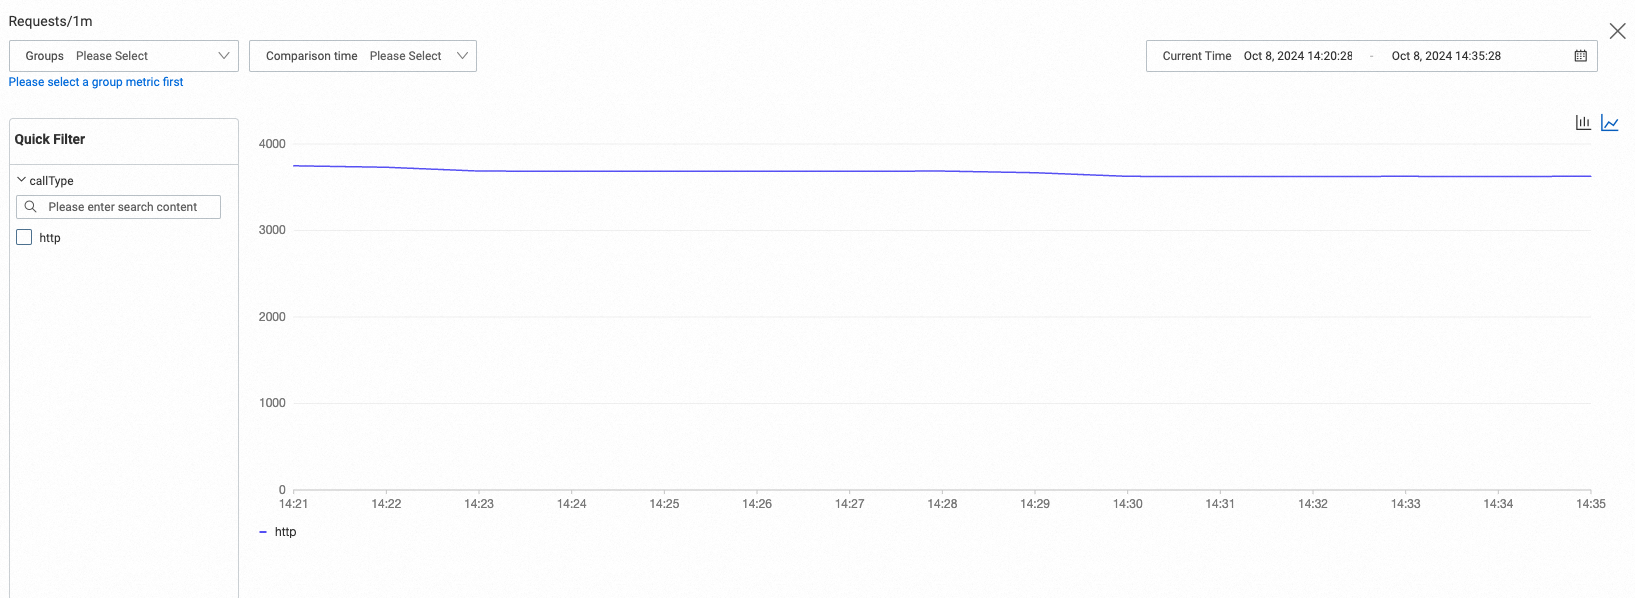
Cliquez sur l'icône  d'un panneau de graphique de tendance pour afficher les comparaisons groupées et les comparaisons historiques.
-
Les options de regroupement incluent les champs de base et les tags d'instance :
Les champs de base incluent _traffic_mse_gray (grayscale). Les tags d'instance par défaut incluent app, workloadKind, app_kubernetes_io_managed_by, armsBPFCreateAppName et d'autres champs.
Champs de base : libellés communs à toutes les métriques. Actuellement, serverIp est exposé pour les comparaisons de regroupement.
Tags d'instance : en plus des tags d'instance par défaut, vous pouvez ajouter des tags d'instance personnalisés pour activer davantage de capacités de comparaison de regroupement. Pour obtenir des instructions, consultez la rubrique Add and Use Tags.
Heure de comparaison : sélectionnez une plage horaire de comparaison à comparer avec la plage horaire actuelle.
Instructions de requête
Cliquez sur l'icône  d'un panneau pour afficher le PromQL correspondant. Vous pouvez utiliser ce PromQL directement dans Prometheus ou Grafana pour des configurations personnalisées.
Par exemple, l'expression de requête pour le panneau Request Count / 1m est sum by (callType,)(sum_over_time(arms_app_requests_count_...[1m])), qui agrège le nombre de requêtes par minute selon la dimension callType. Cliquez sur l'icône de copie à côté de la zone de saisie de la requête pour obtenir le PromQL complet.
Exécutez des requêtes PromQL pour afficher les métriques associées sur la page Metric Explorer de la console Managed Service for Prometheus. Pour obtenir des instructions, consultez la rubrique Metric Explorer.
Lors de la configuration de tableaux de bord dans Grafana, vous pouvez utiliser directement le PromQL correspondant aux panneaux. Pour savoir comment intégrer des sources de données, consultez la rubrique Cloud Service Integration.
FAQ
Aucune donnée pour la latence P99
Les métriques de quantile sont désactivées par défaut. Pour afficher les données de quantile, activez les statistiques de quantile sur la page Custom Configuration. Pour obtenir des instructions, consultez la rubrique Custom Configuration for Java Applications.
Le volume total de requêtes sur la page Vue d'ensemble de l'application de l'ancienne console ne correspond pas à la somme des cinq dernières minutes
ARMS affiche les données sur une durée supérieure d'une minute à la plage horaire sélectionnée. Par exemple, « 5 dernières minutes » affiche en réalité 6 minutes de données, et « 30 dernières minutes » affiche 31 minutes de données.
Le nombre de requêtes SQL lentes sur la page Vue d'ensemble de l'application de l'ancienne console diffère des résultats de requête de l'API POP
Les requêtes via l'API POP incluent les requêtes lentes provenant des bases de données, des bases de données NoSQL et des caches, tandis que la console n'inclut que les requêtes lentes liées aux bases de données. Cela entraîne des divergences.
Pour faire correspondre les résultats de requête POP aux données de la console, ajoutez une condition de filtre rpcType à votre requête.
Exemple :
QueryMetricByPageRequest.Filters filters2 = QueryMetricByPageRequest
.Filters
.builder()
.key("rpcType")
.value("60|62|63|65|66|67|68|69|58|59")
.build();
Le nombre d'instances dépasse le nombre d'instances en cours d'exécution réelles
Si la plage horaire de la requête est trop longue, les instances détruites sont également incluses dans le décompte des instances.
Incohérence du nombre total de requêtes entre les pages Vue d'ensemble de l'application de la nouvelle et de l'ancienne console
La page Application Overview de la nouvelle console affiche les données du point de vue de la fourniture de service et inclut les tâches planifiées. La page Application Overview de l'ancienne console n'inclut pas les données des tâches planifiées.