L'outil d'importation AnalyticDB for MySQL charge des fichiers délimités locaux dans un cluster AnalyticDB for MySQL Data Warehouse Edition via Java Database Connectivity (JDBC). Il offre de meilleures performances que l'instruction LOAD DATA en prenant en charge l'importation simultanée de plusieurs fichiers et en vous permettant d'ajuster les paramètres batchSize et concurrency afin de maximiser le débit d'écriture.
Fonctionnement
L'outil se connecte à une instance Server Load Balancer (SLB), qui répartit le trafic entre plusieurs nœuds frontaux. Les nœuds frontaux analysent les protocoles MySQL et les instructions SQL, écrivent les données et planifient les requêtes. Les données transitent des nœuds frontaux vers les nœuds de stockage pour la persistance.
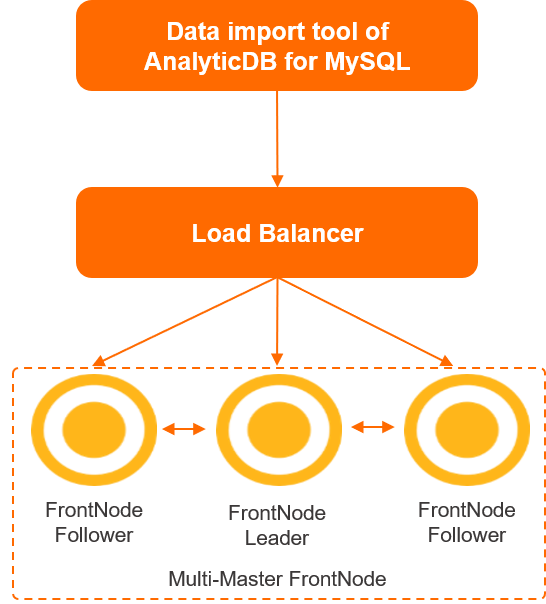
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Java 1.8 ou version ultérieure installé (exécutez
java -versionpour vérifier)Un accès réseau au endpoint du cluster AnalyticDB for MySQL
Une base de données et une table cible déjà créées dans le cluster
Importation de données
| Étape | Description |
|---|---|
| Étape 1 : Téléchargement et décompression de l'outil d'importation | Téléchargez et décompressez le package de l'outil. |
| Étape 2 : Préparation des fichiers de données | Vérifiez le format des fichiers, l'ordre des colonnes et les délimiteurs. |
| Étape 3 : Configuration du script d'importation | Définissez les paramètres de connexion, de fichier et de performance. |
| Étape 4 : Exécution de l'importation | Exécutez le script et surveillez la progression. |
Étape 1 : Téléchargement et décompression de l'outil d'importation
-
Créez un répertoire de travail :
mkdir -p /u01/loadata -
Accédez au répertoire :
# cd /u01/loadata -
Téléchargez l'outil :
wget https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20220811/gpvn/adb-import-tool.tar.gz -
Décompressez le package :
tar zxvf adb-import-tool.tar.gz
Le package extrait les fichiers suivants :
adb-import.sh.template
adb-import.sh.template.md5
adb-import-tool.jar
adb-import-tool.jar.md5
Étape 2 : Préparation des fichiers de données
Vérification du format des fichiers
Notez le chemin absolu des fichiers ou dossiers à importer.
Identifiez le délimiteur de ligne et le délimiteur de colonne. Vous définirez ces valeurs dans les paramètres du script.
-
Vérifiez que l'ordre des colonnes dans vos fichiers correspond à l'instruction
CREATE TABLE. ExécutezSHOW CREATE TABLEdans la base de données pour effectuer cette vérification. Votre table et un fichier de données correspondant pourraient ressembler à ceci :CREATE TABLE `product_info` ( `id` bigint NOT NULL, `name` varchar, `price` decimal(15, 2) NOT NULL ) DISTRIBUTED BY HASH(`id`) INDEX_ALL='Y';1|tv|1000.0 2|computer|2000.0 3|cup|15.8Les fichiers doivent contenir au moins deux colonnes. Un délimiteur final sur la dernière colonne est accepté :
1|abc|3.0et1|abc|3.0|sont tous deux valides.
Par défaut, les champs vides sont traités comme null. Par exemple,4||5.0insère la valeur null dans la colonnename, et non une chaîne vide. Les colonnes à incrémentation automatique sont gérées automatiquement ; aucun prétraitement n'est nécessaire.
Fractionnement des fichiers volumineux
Le fractionnement d'un fichier volumineux en segments permet à l'outil d'importation de les lire simultanément. Une taille de segment comprise entre 1 et 2 Go est recommandée.
Pour un fichier de 128 Go nommé filename.txt, divisez-le en 64 segments de 2 Go chacun :
# split -l$((`wc -l < filename.txt`/64 + 1)) filename.txt filename.txt.split -da 2;L'outil lit les 64 segments simultanément lors de l'importation.
Étape 3 : Configuration du script d'importation
Le fichier adb-import.sh.template est un modèle réutilisable. Copiez-le et renommez-le pour chaque table — par exemple, adb-import-product_info.sh pour la table product_info .
Paramètres obligatoires
Définissez ces paramètres pour chaque tâche d'importation :
####################################
# Path to the Java command.
# If Java is already on your PATH, leave this as-is.
####################################
java_cmd=java

####################################
# Absolute path to the import tool JAR.
# If the script and JAR are in the same directory, leave this as-is.
####################################
jar_path=adb-import-tool.jar

####################################
# Database connection settings.
# If encryptPassword=true, provide a Base64-encoded password.
####################################
host=host
port=3306
user=adbuser
password=pwd
database=dbname
encryptPassword=false

####################################
# Table name.
####################################
tableName=please_set_table_name

####################################
# Path to the file or folder to import.
# For multiple files, separate paths with commas (,).
####################################
dataPath=please_set_data_file_path_or_dir_path

####################################
# The number of files that are imported in a concurrent manner.
# To fully leverage the performance of AnalyticDB for MySQL, set this
# parameter to a number within the range of 16 to 96.
####################################
concurrency=64

####################################
# The number of values that are written when the import operation is performed.
# Specify this parameter based on the lengths of individual rows.
# To fully leverage the performance of AnalyticDB for MySQL, set this
# parameter to a number within the range of 1024 to 4096.
# Smaller batches make individual failed rows easier to identify.
####################################
batchSize=4096

####################################
# File encoding. Valid values: UTF-8, GBK.
####################################
encoding=UTF-8

####################################
# Row delimiter.
# For non-printable characters, use hexadecimal notation.
# Example: \x0d\x06\x08\x0a -> hex0d06080a
####################################
lineSeparator="\\n"

####################################
# Column delimiter.
# For non-printable characters, use hexadecimal notation.
# Example: \x07\x07 -> hex0707
####################################
delimiter="\\|"
Paramètres facultatifs
Ajustez ces paramètres selon les scénarios spécifiques :
####################################
# JVM heap size. Increase if you see frequent garbage collection (GC).
####################################
jvmopts="-Xmx12G -Xms12G"

####################################
# Max number of files read concurrently from a folder.
####################################
maxConcurrentNumOfFilesToImport=64

####################################
# How to handle empty fields.
# false (default): empty fields become null.
# true: empty fields become '' (empty string).
####################################
nullAsQuotes=false

####################################
# Print the actual row count of the destination table after each file.
####################################
printRowCount=false

####################################
# Max characters to display for failed SQL statements.
####################################
failureSqlPrintLengthLimit=1000

####################################
# Dry-run mode. true=display INSERT statements only, false=execute them.
####################################
disableInsertOnlyPrintSql=false

####################################
# Skip the header row in each file.
####################################
skipHeader=false

####################################
# Buffer pool size for INSERT batches.
# Separates I/O and compute, improving client throughput.
####################################
windowSize=128

####################################
# Escape backslashes (\) and apostrophes (') in column values.
# true (default): safe for all data but slightly slower.
# false: faster, but only use if your data contains neither character.
####################################
escapeSlashAndSingleQuote=true

####################################
# Ignore batches that fail to import instead of stopping.
####################################
ignoreErrors=false

####################################
# Print failed SQL statements.
####################################
printErrorSql=true

####################################
# Print the stack trace when a SQL error occurs.
####################################
printErrorStackTrace=true
Étape 4 : Exécution de l'importation
-
Exécutez le script d'importation :
sh adb-import-product_info.sh;L'entrée de journal suivante confirme le démarrage du script :
[2021-03-13 17:50:24.730] add consumer consumer-01 -
L'outil n'affiche pas de barre de progression. Pour vérifier le nombre de lignes chargées, interrogez la table de destination :
mysql > select count(*) from dbname.product_info; -
À la fin de l'importation, l'outil imprime un résumé indiquant le nombre de lignes lues par fichier, la durée prise par chaque fichier, le temps total écoulé et si tous les fichiers ont été traités avec succès.
Succès pour tous les fichiers :
all import finished successfullyÉchec d'un ou plusieurs fichiers :
all import finished with ERROR!
Si une erreur survient pendant le processus d'importation des données, l'outil d'importation met immédiatement fin à l'opération et fournit les détails des instructions SQL ayant échoué. La table de destination contient des données partielles. ExécutezTRUNCATE TABLE table_namepour vider la table de destination, puis relancez l'opération d'importation. Vous pouvez également exécuterDROP TABLE table_namepour supprimer la table de destination, puis créer une nouvelle table pour l'importation.
FAQ
Comment déterminer si le goulot d'étranglement se situe côté client ou côté serveur ?
Exécutez les commandes suivantes sur la machine cliente pour identifier la saturation des ressources :
| Commande | Informations affichées |
|---|---|
top |
Utilisation du CPU |
free |
Utilisation de la mémoire |
vmstat 1 1000 |
Charge globale du système |
dstat -all --disk-util ou iostat 1 1000 |
Bande passante et utilisation du disque en lecture |
jstat -gc <pid> 1000 |
Détails du garbage collection Java |
Si jstat indique un garbage collection fréquent, augmentez le tas JVM en définissant jvmopts sur -Xmx16G -Xms16G .
Comment importer plusieurs tables avec un seul script ?
Si toutes les tables partagent les mêmes délimiteurs, paramétrez tableName et dataPath :
tableName=$1
dataPath=$2
Ensuite, effectuez un appel distinct par table :
# sh adb-import.sh table_name001 /path/table_001
# sh adb-import.sh table_name002 /path/table_002
# sh adb-import.sh table_name003 /path/table_003
Comment exécuter l'importation en arrière-plan ?
# nohup sh adb-import.sh &Consultez les journaux :
# tail -f nohup.outVérifiez que le processus est en cours d'exécution :
# ps -ef|grep importComment ignorer les erreurs d'importation ?
En cas d'erreurs d'exécution SQL, définissez ignoreErrors=true . L'outil poursuit l'importation et consigne les fichiers concernés, les numéros de ligne de départ et les instructions ayant échoué. Si le paramètre batchSize est spécifié, le numéro de ligne défectueuse est inférieur ou égal au numéro de ligne de départ plus la valeur de batchSize .
Les incompatibilités du nombre de colonnes ne peuvent pas être ignorées. Lorsque le nombre de colonnes dans une ligne ne correspond pas à la définition de la table, l'outil arrête immédiatement le traitement de ce fichier. Vérifiez manuellement le fichier avant de réessayer. Le message d'erreur ressemble à ceci :
[ERROR] 2021-03-22 00:46:40,444 [producer- /test2/data/lineitem.csv.split00.100-41] analyticdb.tool.ImportTool
(ImportTool.java:591) -bad line found and stop import! 16, file = /test2/data/tpch100g/lineitem.csv.split00.100, rowCount = 7, current row = 3|123|179698|145|73200.15|0.06|0.00|R|F|1994-02-02|1994-01-04|1994-02-
23|NONE|AIR|ongside of the furiously brave acco|
Comment identifier la cause d'une erreur d'importation ?
Trois approches sont possibles :
-
Augmentez la longueur d'impression SQL pour afficher davantage de l'instruction défaillante :
printErrorSql=true failureSqlPrintLengthLimit=1500 -
Réduisez `batchSize` pour cibler précisément la ligne défectueuse :
batchSize=10 -
Isolez un segment de fichier spécifique si vous avez déjà identifié le fichier fragmenté contenant l'erreur :
dataPath=/u01/this/is/the/directory/where/product_info/stores/file007
Comment exécuter l'outil sous Windows ?
Sous Windows, aucun script shell n'est fourni. Appelez directement le fichier JAR à l'aide de l'interface CLI :
usage: java -jar adb-import-tool.jar [-a <arg>] [-b <arg>] [-B <arg>] [-c <arg>]
      [-D <arg>] [-d <arg>] [-E <arg>] [-f <arg>] [-h <arg>] [-I <arg>]
      [-k <arg>] [-l <arg>] [-m <arg>] [-n <arg>] [-N <arg>] [-O <arg>]
      [-o <arg>] [-p <arg>] [-P <arg>] [-Q <arg>] [-s <arg>]  [-S <arg>]
      [-t <arg>] [-T <arg>] [-u <arg>] [-w <arg>][-x <arg>] [-y <arg>] [-z <arg>]
Paramètres obligatoires :
| Indicateur | Description |
|---|---|
-h, --ip <arg> |
Endpoint du cluster |
-u, --username <arg> |
Compte de base de données |
-p, --password <arg> |
Mot de passe du compte |
-P, --port <arg> |
Numéro de port |
-D, --databaseName <arg> |
Nom de la base de données |
-f, --dataFile <arg> |
Chemin absolu vers le fichier ou le dossier. Pour plusieurs fichiers, séparez les chemins par des virgules (,). |
-t, --tableName <arg> |
Nom de la table de destination |
Paramètres facultatifs :
| Indicateur | Valeur par défaut | Description |
|---|---|---|
-a, --createEmptyFinishFilePath <arg> |
(vide) | Crée un fichier marqueur à la fin de l'importation. Laissez vide pour désactiver. |
-b, --batchSize <arg> |
1 |
Nombre de lignes par lot INSERT. Définissez une valeur comprise entre 1024 et 4096 pour un débit optimal. |
-B, --encryptPassword <arg> |
false |
Active le chiffrement Base64 du mot de passe. |
-c, --printRowCount <arg> |
false |
Affiche le nombre de lignes de la table de destination après chaque fichier. |
-d, --skipHeader <arg> |
false |
Ignore la première ligne de chaque fichier. |
-E, --escapeSlashAndSingleQuote <arg> |
true |
Échappe les caractères \ et ' dans les valeurs de colonne. Définissez sur false si vos données ne contiennent aucun de ces caractères. |
-I, --ignoreErrors <arg> |
false |
Poursuit l'importation en cas d'erreurs SQL. |
-k, --skipLineNum <arg> |
0 |
Nombre de lignes à ignorer au début de chaque fichier (similaire à IGNORE number LINES ). |
-l, --delimiter <arg> |
| |
Délimiteur de colonne. Pour les caractères non imprimables, utilisez la notation hexadécimale (par exemple, \x07\x07 -> hex0707 ). |
-m, --maxConcurrentNumOfFilesToImport <arg> |
Integer.MAX_VALUE |
Nombre maximal de fichiers lus simultanément depuis un dossier. |
-n, --nullAsQuotes <arg> |
false |
false : les champs vides deviennent null. true : les champs vides deviennent '' . |
-N, --printErrorSql <arg> |
true |
Affiche les instructions SQL dont l'exécution a échoué. |
-O, --connectionPoolSize <arg> |
2 |
Taille du pool de connexions à la base de données. |
-o, --encoding <arg> |
UTF-8 |
Encodage du fichier. Valeurs valides : GBK , UTF-8 . |
-Q, --disableInsertOnlyPrintSql <arg> |
false |
true : affiche les instructions INSERT sans les exécuter. false : les exécute. |
-s, --lineSeparator <arg> |
\n |
Délimiteur de ligne. Pour les caractères non imprimables, utilisez la notation hexadécimale (par exemple, \x0d\x06\x08\x0a -> hex0d06080a ). |
-S, --printErrorStackTrace <arg> |
false |
Affiche la trace de la pile lorsqu'une erreur SQL se produit. |
-w, --windowSize <arg> |
128 |
Taille du pool tampon pour les lots INSERT. Sépare les E/S du calcul pour améliorer les performances du client. |
-x, --insertWithColumnNames <arg> |
true |
Ajoute les noms de colonne aux instructions INSERT (par exemple, INSERT INTO tb(column1, column2) ). |
-y, --failureSqlPrintLengthLimit <arg> |
1000 |
Nombre maximal de caractères à afficher pour les instructions SQL ayant échoué. |
-z, --connectionUrlParam <arg> |
?characterEncoding=utf-8 |
Paramètres de connexion JDBC supplémentaires. Exemple : ?characterEncoding=utf-8&autoReconnect=true . |
Exemples :
Importation d'un seul fichier avec les paramètres par défaut :
java -Xmx8G -Xms8G -jar adb-import-tool.jar \
  -hyourhost.ads.aliyuncs.com -uadbuser -ppassword -P3306 -Dtest \
  --dataFile /data/lineitem.sample --tableName LINEITEM
Importation de tous les fichiers d'un dossier avec un débit maximal :
java -Xmx16G -Xms16G -jar adb-import-tool.jar \
  -hyourhost.ads.aliyuncs.com -uadbuser -ppassword -P3306 -Dtest \
  --dataFile /data/tpch100g --tableName LINEITEM \
  --concurrency 64 --batchSize 2048