Lorsqu'AnalyticDB for MySQL reçoit une requête, il la divise en plusieurs étapes. Ces étapes sont distribuées sur les nœuds de travail et les nœuds d'exécution pour lire et traiter les données. Certaines étapes s'exécutent en parallèle, tandis que d'autres, liées par des dépendances, s'exécutent de manière séquentielle. Cette complexité rend difficile l'analyse de la durée des instructions SQL complexes. Utilisez les détails des étapes et des tâches disponibles dans la console ou via une API pour analyser les requêtes lentes.
Procédure
Connectez-vous à la console AnalyticDB for MySQL. Dans le coin supérieur gauche de la console, sélectionnez une région. Dans le volet de navigation de gauche, cliquez sur Clusters. Recherchez le cluster à gérer et cliquez sur son ID.
Dans le volet de navigation de gauche, cliquez sur Diagnostics and Optimization.
Dans la section SQL Queries, cliquez sur Diagnose pour la requête souhaitée.
Cliquez sur l'onglet Stages & Tasks. La section Query Properties située en haut de la page affiche diverses informations, telles que l'heure de début et de fin, le nom d'utilisateur, la durée de mise en file d'attente, la durée totale, la mémoire maximale utilisée, le volume de données analysées, le volume de données renvoyées, l'état et le groupe de ressources. L'onglet Stages & Tasks répertorie les détails d'exécution de chaque étape, notamment l'ID de l'étape, l'état, le nombre de lignes et le volume de données en entrée/sortie, la mémoire maximale utilisée et la durée cumulée. Pour une description des résultats de la requête concernant les étapes, consultez les Paramètres des étapes.
-
Pour résoudre les problèmes liés à une requête lente, cliquez sur un Stage ID afin d'afficher les détails de toutes les tâches de cette étape. Pour une description des résultats de la requête concernant les tâches, consultez les Paramètres des tâches.
ImportantLes détails des tâches sont disponibles uniquement pour les requêtes dont la durée d'exécution dépasse 1 seconde.
Paramètres
Paramètres des étapes
|
Parameter |
Description |
|
Stage ID |
Identifiant unique de l'étape. Cet ID correspond à l'ID de l'étape dans l'arborescence du plan d'exécution. |
|
Status |
État d'exécution de l'étape. Les valeurs possibles sont :
|
|
Input rows |
Nombre de lignes dans les données d'entrée de l'étape. |
|
Input data size |
Taille des données d'entrée de l'étape. |
|
Output rows |
Nombre de lignes dans les données de sortie de l'étape. |
|
Output data size |
Taille des données de sortie de l'étape. |
|
Peak memory |
Utilisation maximale de la mémoire par l'étape. |
|
Cumulative duration |
Somme du temps consommé par tous les opérateurs de l'étape. Ce paramètre vous aide à identifier les étapes gourmandes en temps ou en processeur. Vous ne pouvez pas comparer directement la durée cumulée avec la durée de la requête. Vous devez également prendre en compte le parallélisme de l'étape pour déterminer la relation entre la durée de la requête et la durée cumulée. |
Paramètres des tâches
|
Parameter |
Description |
|
Task ID |
Identifiant unique de la tâche. Par exemple, dans |
|
Status |
État d'exécution de la tâche. Les valeurs possibles sont :
|
|
Input data |
Nombre de lignes et taille des données d'entrée de la tâche. Triez les tâches selon cette valeur pour vérifier s'il existe un déséquilibre des données dans les données d'entrée de l'étape. Si un déséquilibre existe, cela indique que la clé de distribution de la clause GROUP BY ou JOIN est inefficace. Remontez à l'étape en amont pour résoudre le problème. Remarque
Un déséquilibre des données se produit lorsqu'une clé de distribution inefficace entraîne une répartition inégale des données sur les nœuds de travail. |
|
Output data |
Nombre de lignes et taille des données de sortie de la tâche. En examinant les propriétés du nœud Aggregation ou Join dans le plan d'opérateur de l'étape actuelle, vous pouvez le mapper à l'instruction SQL et vérifier si des champs combinés sont utilisés dans la clé de partition ou la condition JOIN. Par exemple, |
|
Peak memory |
Mémoire maximale utilisée lors de l'exécution de la tâche. La mémoire maximale est proportionnelle à la taille des données d'entrée. Elle peut vous aider à déterminer si une requête a échoué en raison d'une utilisation de la mémoire très déséquilibrée sur certains nœuds. |
|
Table read duration |
Lorsque l'arborescence des opérateurs d'une étape contient un opérateur TableScan, ce paramètre indique le temps total passé par tous les opérateurs TableScan de l'étape à lire les données de la table. Cette durée est une valeur cumulative provenant de plusieurs machines et threads et ne peut pas être comparée directement à la durée de la requête. En la comparant avec la durée cumulée, vous pouvez déterminer si le temps d'exécution d'une étape est principalement consacré à l'analyse des données. |
|
Data read from tables |
Lorsque l'arborescence des opérateurs d'une étape contient un opérateur TableScan, ce paramètre indique le nombre de lignes et la quantité de données lues depuis la table source par tous les opérateurs TableScan de l'étape. En triant ce champ, vous pouvez déterminer s'il existe un déséquilibre des données dans la table source. Le cas échéant, utilisez la console pour diagnostiquer le déséquilibre de la clé de distribution. Pour plus d'informations, consultez Data modeling diagnostics. |
|
Created at |
Heure de création de la tâche. |
|
Queuing duration |
Temps passé par la tâche dans la file d'attente avant le début de l'exécution. |
|
Ended at |
Heure de fin d'exécution de la tâche. |
|
Interval between start and end time |
Temps écoulé entre l'heure de création de la tâche et son heure de fin. Par exemple, si une tâche a été créée à 12:00:00 le 12/12/2022 et s'est terminée à 12:00:04 le 12/12/2022, l'intervalle est de 4 s. En comparant cet intervalle avec la durée de la requête, vous pouvez identifier où se situent les goulots d'étranglement de performance. Par exemple, si la durée de la requête est de 6 s et que l'intervalle est de 4 s, le goulot d'étranglement se situe dans l'étape actuelle. Pour une méthode de calcul détaillée, consultez l'Exemple : Calcul de la durée et de la concurrence des tâches. |
|
Cumulative duration |
Somme du temps d'exécution de tous les threads au sein de cette tâche. Pour une méthode de calcul détaillée, consultez l'Exemple : Calcul de la durée et de la concurrence des tâches. |
|
Computing time ratio |
Ratio entre le temps réel de traitement des données et le cycle de vie de la sous-tâche. Formule : Ratio de temps de calcul = (Durée cumulée / Concurrence des sous-tâches) / Intervalle entre l'heure de début et de fin. Dans cette formule, (Durée cumulée / Concurrence des sous-tâches) représente le temps moyen passé par chaque thread à traiter les données, tandis que l'intervalle inclut le temps de traitement réel, la durée de mise en file d'attente des sous-tâches et la latence réseau. Pour une méthode de calcul détaillée, consultez l'Exemple : Calcul de la durée et de la concurrence des tâches. Remarque
Un ratio de temps de calcul plus faible suggère un intervalle plus long entre l'heure de début et de fin, ce qui signifie que vous devez identifier les opérateurs qui consomment beaucoup de temps. À l'inverse, un ratio plus élevé suggère un intervalle plus court, ce qui indique des problèmes tels que des attentes de ressources ou une latence réseau. |
|
Subtask concurrency |
Chaque tâche est exécutée par plusieurs threads concurrents sur une seule machine. Le nombre de threads exécutant simultanément des tâches de calcul constitue la concurrence des sous-tâches. Pour une méthode de calcul détaillée, consultez l'Exemple : Calcul de la durée et de la concurrence des tâches. |
|
Execution node |
Adresse IP interne du nœud sur lequel la tâche a été exécutée. Si plusieurs requêtes présentent une longue traîne sur le même nœud, vous devez enquêter sur ce nœud spécifique. Remarque
Une longue traîne se produit lorsque certaines tâches d'une exécution distribuée AnalyticDB for MySQL prennent considérablement plus de temps à s'achever que les autres tâches. |
Exemple : Calcul de la durée et de la concurrence des tâches
Cet exemple montre comment calculer l'intervalle entre l'heure de début et de fin, la durée cumulée, le ratio de temps de calcul et la concurrence des sous-tâches pour une tâche nommée Task 2.1.
Supposons que Task 2.1 appartienne à stage[2], qui contient quatre opérateurs : StageOutput, Join, TableScan et RemoteSource. La figure suivante illustre l'arborescence des opérateurs.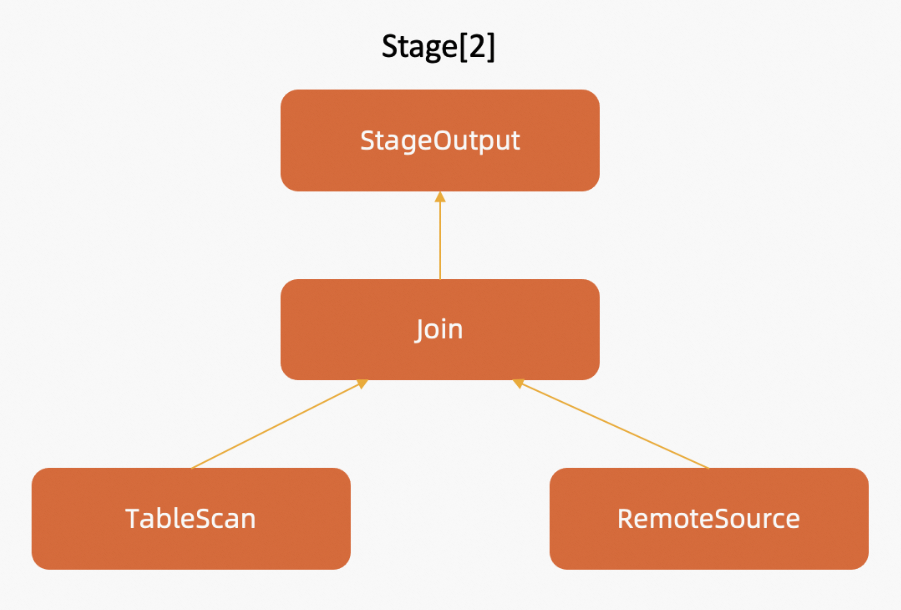
Les opérateurs de l'arborescence sont exécutés en parallèle sur plusieurs nœuds, en suivant la direction des flèches. Task 2.1 s'exécute sur quatre threads concurrents sur le nœud dont l'adresse IP est 192.168.12.23. Les temps de traitement des données sont de 5 s pour le thread 1 et le thread 2, et de 6 s pour le thread 3 et le thread 4. La figure suivante illustre le processus.
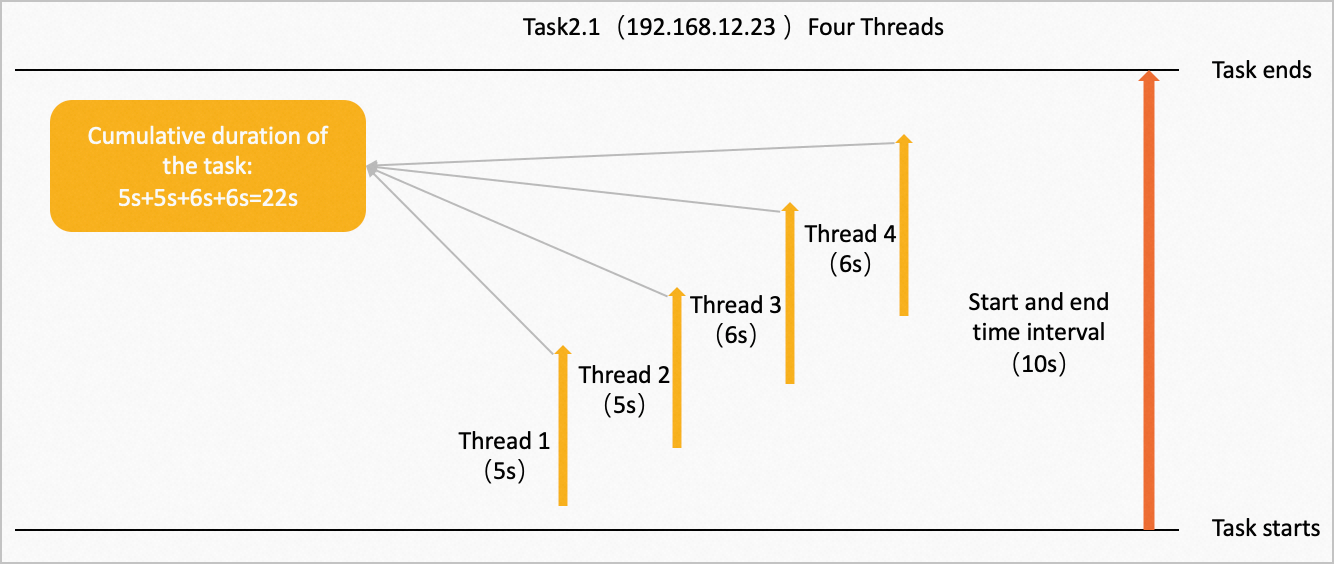
La durée cumulée de la tâche correspond à la somme des temps d'exécution de tous les threads : 5 + 5 + 6 + 6 = 22 s.
L'intervalle entre l'heure de début et de fin est de 10 s.
Le ratio de temps de calcul est (durée cumulée / concurrence des sous-tâches) / intervalle entre l'heure de début et de fin : (22 s / 4) / 10 s = 0,55.
API connexes
|**API**
|
**Description**
| | --- | --- | |
[DescribeDiagnosisSQLInfo](t2310878.xdita#)
|
Récupère les détails d'exécution d'une instruction SQL.
| |
[DescribeDiagnosisTasks](t2310890.xdita#)
|
Récupère les détails d'exécution des sous-tâches distribuées pour un ID de requête et un ID d'étape spécifiés.
|