Lorsque les champs utilisés dans une clause GROUP BY présentent une cardinalité élevée, comme un numéro de mobile ou un identifiant utilisateur, l'agrégation en deux étapes par défaut d'AnalyticDB for MySQL génère un travail inutile : l'agrégation partielle calcule des hachages, déduplique les données et applique des fonctions d'agrégation, mais produit presque autant de lignes qu'elle n'en reçoit, sans réduire le volume de données transmis sur le réseau. Utilisez l'indicateur /*+ aggregation_path_type=single_agg*/ pour ignorer l'agrégation partielle et éliminer cette surcharge.
Fonctionnement de l'agrégation en deux étapes
AnalyticDB for MySQL est un service d'entreposage de données distribué. Par défaut, il exécute une requête GROUP BY en deux étapes :
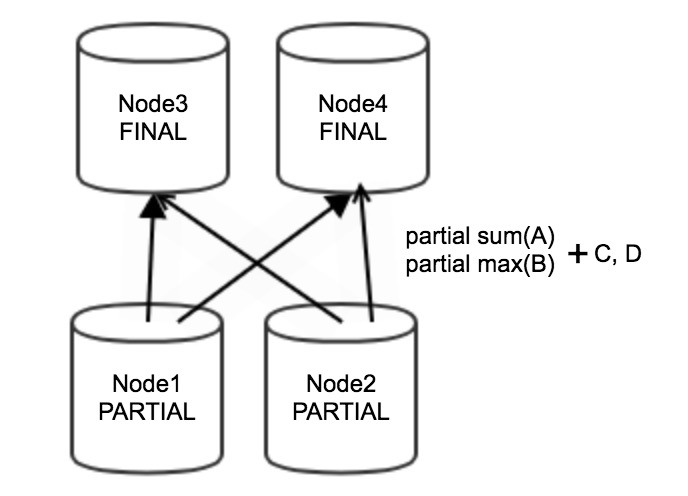
Agrégation partielle — Les nœuds en amont (par exemple, les nœuds 1 et 2) agrègent partiellement les données locales. Ce processus étant basé sur un flux, les données ne s'accumulent pas sur les nœuds d'agrégation et l'utilisation de la mémoire reste faible. L'agrégation partielle réduit le volume de données envoyé sur le réseau vers les nœuds en aval.
Redistribution des données et agrégation finale — Après l'agrégation partielle, les données sont redistribuées entre les nœuds selon les champs GROUP BY. Les nœuds en aval (par exemple, les nœuds 3 et 4) effectuent l'agrégation finale. Le nœud d'agrégation finale doit conserver en mémoire toutes les valeurs et les données d'état d'agrégation pour chaque groupe jusqu'au traitement complet de toutes ses lignes, ce qui peut entraîner une forte consommation de mémoire. Pour plus d'informations sur la circulation des données entre les étapes, consultez la rubrique Facteurs influant sur les performances des requêtes.
Exemple : La requête suivante regroupe les données selon deux colonnes et calcule une agrégation par groupe :
SELECT sum(A), max(B) FROM tb1 GROUP BY C,D;Les nœuds 1 et 2 produisent chacun des résultats partiels — partial sum(A), partial max(B), C et D — qu'ils envoient ensuite aux nœuds 3 et 4 pour l'agrégation finale.
Ignorer l'agrégation partielle pour les champs GROUP BY à forte cardinalité
Quand appliquer cette optimisation
L'agrégation en deux étapes est efficace lorsque l'agrégation partielle réduit significativement le nombre de lignes. Elle devient un goulot d'étranglement lorsque les champs GROUP BY présentent une cardinalité élevée (nombre important de valeurs uniques), comme un numéro de mobile ou un identifiant utilisateur :
Condition : Le taux d'agrégation est faible. L'agrégation partielle produit presque autant de lignes qu'elle n'en reçoit, ce qui ne réduit pas le volume de données envoyé aux nœuds en aval.
Effet : L'étape d'agrégation partielle calcule toujours des hachages, déduplique les données et exécute des fonctions d'agrégation, consommant ainsi des ressources de calcul sans réduire le trafic réseau.
Solution : Ajoutez l'indicateur
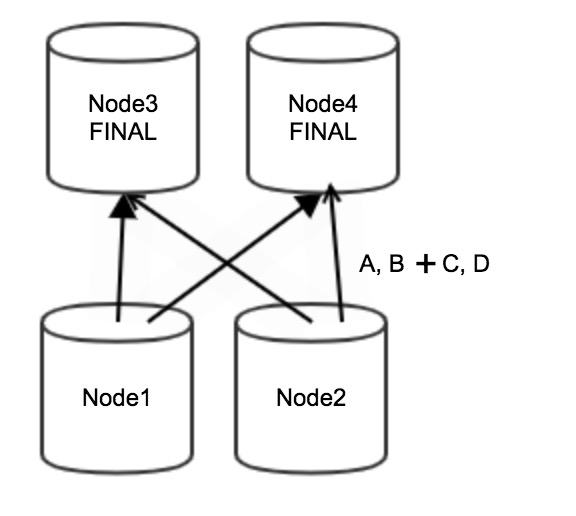
/*+ aggregation_path_type=single_agg*/pour ignorer complètement l'agrégation partielle. Toutes les données sont envoyées directement aux nœuds en aval pour l'agrégation finale, éliminant ainsi la surcharge de calcul inutile.
Appliquer l'indicateur
Ajoutez l'indicateur immédiatement après SELECT :
SELECT /*+ aggregation_path_type=single_agg*/ sum(A), max(B) FROM tb1 GROUP BY C,D;Après l'application de l'indicateur, les nœuds 1 et 2 ignorent l'agrégation partielle. Toutes les données brutes (A, B, C et D) sont redistribuées directement aux nœuds 3 et 4 pour l'agrégation finale.
Compromis
| Facteur | Agrégation en deux étapes (par défaut) | Agrégation unique (indicateur) |
|---|---|---|
| Idéal pour | Champs GROUP BY à faible cardinalité | Champs GROUP BY à forte cardinalité |
| Utilisation du réseau | Plus faible — l'agrégation partielle réduit le volume de données | Plus élevée — toutes les données brutes sont redistribuées |
| Surcharge de calcul | Plus élevée lorsque le taux d'agrégation est faible | Plus faible — aucune étape d'agrégation partielle |
| Mémoire sur le nœud final | Volume de données plus faible, mais toujours conservé en mémoire | Potentiellement élevé — accumulation de toutes les lignes |
Quand ne pas utiliser cette optimisation
Évitez d'utiliser l'indicateur dans les situations suivantes :
Champs GROUP BY à faible cardinalité — S'il existe peu de valeurs de groupe uniques, l'agrégation partielle réduit efficacement le trafic réseau. L'ignorer revient à perdre cet avantage.
Environnements à mémoire limitée — Cet indicateur ne réduit pas l'utilisation de la mémoire sur le nœud d'agrégation finale. Lorsque le taux d'agrégation est faible, toutes les données s'accumulent en mémoire sur les nœuds en aval pour la déduplication et l'agrégation. Vérifiez que les nœuds en aval disposent de suffisamment de mémoire avant d'appliquer l'indicateur.
Notes d'utilisation
L'indicateur s'applique à toutes les requêtes de regroupement et d'agrégation dans l'instruction SQL, et non pas uniquement à des opérateurs spécifiques.
Avant d'ajouter l'indicateur, examinez le plan d'exécution pour identifier quels opérateurs d'agrégation ont un faible taux d'agrégation et confirmez que le bénéfice attendu compense la pression accrue sur la mémoire des nœuds d'agrégation finale.