Le désordonnanceur ack-koordinator détecte les nœuds surchargés en fonction de l'utilisation réelle des ressources et expulse les Pods afin de rééquilibrer le cluster.
Cette rubrique explique comment installer le désordonnanceur, activer le désordonnancement sensible aux points chauds et configurer ses paramètres avancés.
Limitations
Seuls les clusters managés ACK Pro sont pris en charge.
-
Versions des composants requises :
Composant Version Planificateur ACK v1.22.15-ack-4.0 ou ultérieure, v1.24.6-ack-4.0 ou ultérieure ack-koordinator v1.1.1-ack.1 ou ultérieure Helm v3.0 ou ultérieure
Le désordonnanceur Koordinator se contente d'expulser les Pods ; c'est le planificateur ACK qui gère leur replanification. Utilisez le désordonnancement conjointement avec la planification consciente de la charge pour éviter que les Pods expulsés ne soient redistribués sur les mêmes nœuds surchargés.
Lors du désordonnancement, les anciens Pods sont expulsés avant la création des nouveaux. Assurez-vous que votre application dispose d'un nombre suffisant de réplicas redondants pour maintenir sa disponibilité.
Le désordonnancement utilise l'API standard Kubernetes eviction API. Vérifiez que vos Pods sont réentrants afin que leurs redémarrages après expulsion n'interrompent pas votre service.
Facturation
L'installation et l'utilisation d'ack-koordinator sont gratuites. Des frais supplémentaires peuvent s'appliquer dans les scénarios suivants :
Ressources des nœuds de calcul : ack-koordinator est un composant autogéré qui consomme des ressources sur les nœuds de calcul. Configurez les demandes de ressources pour chaque module lors de l'installation.
Métriques personnalisées Prometheus : Si vous activez l'option Enable Prometheus Monitoring for ACK-Koordinator et utilisez Managed Service for Prometheus, les métriques exposées sont comptabilisées comme des métriques personnalisées et entraînent des frais. Le montant dépend de la taille du cluster et du nombre d'applications. Consultez la section relative à la facturation des instances Prometheus avant d'activer cette fonctionnalité. Interrogez les données d'utilisation pour surveiller votre consommation de ressources.
Fonctionnement
Cycle d'exécution
Le désordonnanceur Koordinator s'exécute périodiquement. Chaque cycle d'exécution comprend trois étapes :
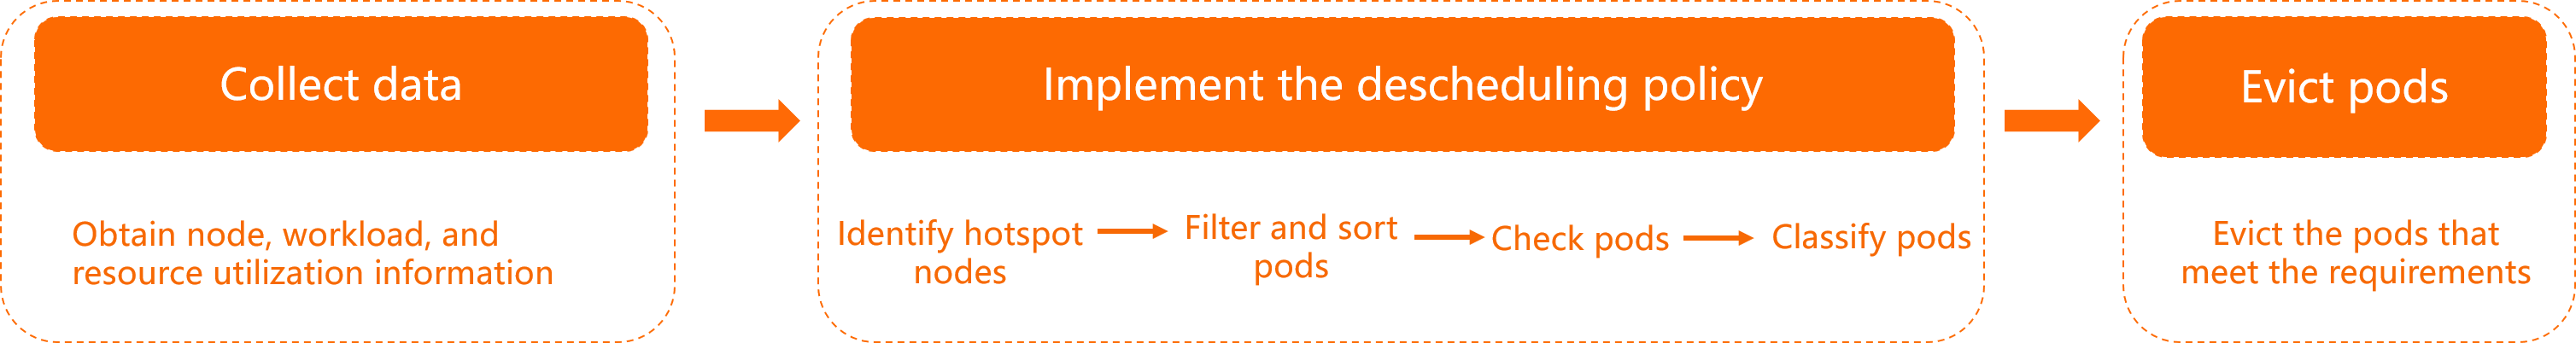
Collecte des données : Récupération des informations relatives aux nœuds et aux charges de travail, ainsi que des données d'utilisation des ressources.
-
Exécution des plug-ins (exemple avec LowNodeLoad) :
Identification des nœuds constituant des points chauds en fonction des seuils
highThresholdsetlowThresholds.Parcours de tous les nœuds identifiés comme points chauds, notation des Pods éligibles et tri en vue de leur expulsion. Voir la section Politique de notation des Pods.
Vérification de chaque Pod candidat par rapport aux contraintes de migration : capacité du cluster, utilisation des ressources et limites du ratio de réplicas. Consultez la section Politiques de désordonnancement des points chauds conscientes de la charge.
Marquage des Pods validés comme candidats à la migration et exclusion des autres.
Expulsion et migration des Pods : Expulsion des candidats à la migration via l'API d'expulsion.
Classification des nœuds
Le plug-in LowNodeLoad classe les nœuds en trois catégories selon deux seuils : lowThresholds (seuil d'inactivité) et highThresholds (seuil de point chaud).
Exemple avec lowThresholds = 45 % et highThresholds = 70 % :

Nœud inactif : L'utilisation des ressources est inférieure à
lowThresholds(< 45 %).Nœud normal : L'utilisation des ressources se situe entre
lowThresholdsethighThresholds(45–70 %). Il s'agit de la plage cible.Nœud constituant un point chaud : L'utilisation des ressources dépasse
highThresholds(> 70 %). Les Pods sont expulsés jusqu'à ce que la charge du nœud descende à 70 % ou moins.
Les données d'utilisation des ressources sont mises à jour toutes les minutes et reflètent la moyenne sur 5 minutes.
Si tous les nœuds dépassentlowThresholds, la charge du cluster est considérée comme élevée et le désordonnancement est suspendu, même si certains nœuds dépassenthighThresholds.
Politiques de désordonnancement des points chauds conscientes de la charge
| Politique | Description |
|---|---|
| Nouvelle tentative de vérification des points chauds | Un nœud n'est classé comme point chaud qu'après avoir dépassé highThresholds pendant plusieurs cycles consécutifs (par défaut : 5), ce qui permet d'éviter les faux positifs dus à des pics momentanés. |
| Tri des nœuds | Le désordonnancement commence par le nœud constituant un point chaud ayant l'utilisation la plus élevée. Le processeur et la mémoire sont comparés dans cet ordre. |
| Notation des Pods | Pour chaque nœud constituant un point chaud, les Pods sont notés et triés avant l'expulsion : (1) priorité de classe la plus faible en premier (la valeur par défaut est 0, soit la plus basse) ; (2) classe QoS la plus faible ; (3) pour une priorité et une classe QoS égales, les Pods sont classés selon l'utilisation des ressources et l'heure de démarrage. Configurez les classes Priority ou QoS pour contrôler l'ordre d'expulsion. |
| Filtre | Limite le périmètre du désordonnancement à des namespaces, Pods ou nœuds spécifiques à l'aide de sélecteurs d'étiquettes. Consultez evictableNamespaces, podSelectors et nodeSelector dans la section Configuration du plug-in LowNodeLoad. |
| Prévérification | Avant l'expulsion, le désordonnanceur vérifie : (1) l'existence de nœuds correspondant à l'affinité de nœud, au sélecteur de nœud, aux tolérations et aux exigences en matière de ressources ; (2) que le nœud cible dispose d'une capacité suffisante sans dépasser highThresholds. La capacité disponible est calculée comme suit : (highThresholds − current load) × total capacity. Exemple : charge de 20 %, highThresholds de 70 %, 96 cœurs virtuels → (70 % − 20 %) × 96 = 48 cœurs virtuels disponibles. |
| Limitation de la migration | Limite le nombre de migrations de Pods simultanées par nœud, namespace et charge de travail. Une fenêtre temporelle empêche les Pods d'une même charge de travail de migrer trop fréquemment. Compatible avec le Pod Disruption Budget (PDB) de Kubernetes pour un contrôle fin de la disponibilité. |
| Observabilité | Des événements de migration sont émis pour chaque Pod, indiquant la raison et l'état. Exécutez kubectl get event | grep <pod-name> pour afficher les détails de la migration. |
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Planificateur ACK v1.22.15-ack-4.0 ou ultérieure, ack-koordinator v1.1.1-ack.1 ou ultérieure et Helm v3.0 ou ultérieure
Étape 1 : Activer le désordonnancement dans ack-koordinator
Nouvelle installation : Installez ack-koordinator et sélectionnez l'option Enable Descheduling For Ack-koordinator sur la page de configuration.
Installation existante : Sur la page de configuration, sélectionnez l'option Enable Descheduling For Ack-koordinator. Consultez la section Modifier ack-koordinator.
Étape 2 : Activer le plug-in LowNodeLoad
-
Créez une ConfigMap
koord-descheduler-config.yamlpour activer le plug-in LowNodeLoad.# koord-descheduler-config.yaml apiVersion: v1 kind: ConfigMap metadata: name: koord-descheduler-config namespace: kube-system data: koord-descheduler-config: | # System configuration for koord-descheduler. Do not modify this section. apiVersion: descheduler/v1alpha2 kind: DeschedulerConfiguration leaderElection: resourceLock: leases resourceName: koord-descheduler resourceNamespace: kube-system deschedulingInterval: 120s # Execution interval. The descheduler runs every 120s. # Must not exceed detectorCacheTimeout (default: 5m). dryRun: false # Set to true to run in read-only mode (no evictions). # End of system configuration. profiles: - name: koord-descheduler plugins: balance: enabled: - name: LowNodeLoad # Enable the LowNodeLoad plugin for hot spot descheduling. evict: enabled: - name: MigrationController # Enable the eviction and migration controller. pluginConfig: - name: MigrationController args: apiVersion: descheduler/v1alpha2 kind: MigrationControllerArgs defaultJobMode: EvictDirectly - name: LowNodeLoad args: apiVersion: descheduler/v1alpha2 kind: LowNodeLoadArgs # A node is idle if usage of ALL resources is below lowThresholds. lowThresholds: cpu: 20 # 20% CPU utilization memory: 30 # 30% memory utilization # A node is a hot spot if usage of ANY resource exceeds highThresholds. highThresholds: cpu: 50 # 50% CPU utilization memory: 60 # 60% memory utilization # Scopes descheduling to specific namespaces. # include and exclude are mutually exclusive—configure only one. evictableNamespaces: include: - default # exclude: # - "kube-system" # - "koordinator-system" -
Appliquez la ConfigMap au cluster.
kubectl apply -f koord-descheduler-config.yaml -
Redémarrez le désordonnanceur Koordinator pour charger la nouvelle configuration.
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 0
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 1
Étape 3 (facultative) : Activer la planification consciente de la charge
Pour obtenir un équilibrage de charge optimal, activez la planification consciente de la charge afin que le planificateur ACK évite de placer les Pods sur des nœuds constituant des points chauds après leur expulsion.
Définissez loadAwareThreshold de manière à correspondre à highThresholds. Des valeurs incompatibles risquent de provoquer la replanification des Pods expulsés sur des nœuds constituant des points chauds, en particulier lorsque peu de nœuds présentent une utilisation similaire.
Étape 4 : Vérifier le désordonnancement
Cet exemple utilise un cluster de trois nœuds, chacun disposant de 104 cœurs et de 396 GiB de mémoire.
-
Créez un fichier
stress-demo.yamlavec le contenu suivant.apiVersion: apps/v1 kind: Deployment metadata: name: stress-demo namespace: default labels: app: stress-demo spec: replicas: 6 selector: matchLabels: app: stress-demo template: metadata: name: stress-demo labels: app: stress-demo spec: containers: - args: - '--vm' - '2' - '--vm-bytes' - '1600M' - '-c' - '2' - '--vm-hang' - '2' command: - stress image: polinux/stress imagePullPolicy: Always name: stress resources: limits: cpu: '2' memory: 4Gi requests: cpu: '2' memory: 4Gi restartPolicy: Always -
Déployez la charge de travail de test de stress.
kubectl create -f stress-demo.yamlSortie attendue :
deployment.apps/stress-demo created -
Vérifiez que les Pods sont en cours d'exécution et notez le nœud auquel ils ont été attribués.
kubectl get pod -o wideSortie attendue :
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Running 0 82s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none> -
Augmentez la charge sur le nœud
cn-beijing.10.XX.XX.53et vérifiez l'utilisation des nœuds.kubectl top nodeSortie attendue :
NAME                      CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
cn-beijing.10.XX.XX.215   17611m       17%    24358Mi         6%
cn-beijing.10.XX.XX.53    63472m       63%    11969Mi         3%
Le nœud
cn-beijing.10.XX.XX.53affiche une utilisation du processeur de 63 %, dépassant ainsi le seuil de point chaud de 50 %. Le nœudcn-beijing.10.XX.XX.215affiche une utilisation du processeur de 17 %, inférieure au seuil d'inactivité de 20 %. Activez le plug-in LowNodeLoad comme décrit dans l'Étape 2 : Activer le plug-in LowNodeLoad.
-
Surveillez les modifications apportées aux Pods.
Par défaut, un nœud doit dépasser
highThresholdslors de cinq vérifications consécutives (environ 10 minutes avec l'intervalle par défaut de 120 secondes) pour être classé comme point chaud.kubectl get pod -wSortie attendue :
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Terminating 0 59s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none> stress-demo-588f9646cf-7**** 1/1 ContainerCreating 0 10s 10.XX.XX.215 cn-beijing.10.XX.XX.215 <none> <none> -
Consultez l'événement d'expulsion.
kubectl get event | grep stress-demo-588f9646cf-s****Sortie attendue :
2m14s   Normal   Evicting        podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
101s    Normal   EvictComplete   podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" has been evicted
2m14s   Normal   Descheduled     pod/stress-demo-588f9646cf-s****   Pod evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
2m14s   Normal   Killing         pod/stress-demo-588f9646cf-s****   Stopping container stress
Le Pod présent sur le nœud constituant un point chaud a été expulsé et migré vers le nœud
cn-beijing.10.XX.XX.215.
Configuration avancée
Tous les paramètres du désordonnanceur Koordinator sont configurés dans la ConfigMap créée à l'étape 2.
# koord-descheduler-config.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: koord-descheduler-config
  namespace: kube-system
data:
  koord-descheduler-config: |
    # System configuration. Do not modify this section.
    apiVersion: descheduler/v1alpha2
    kind: DeschedulerConfiguration
    leaderElection:
      resourceLock: leases
      resourceName: koord-descheduler
      resourceNamespace: kube-system
    deschedulingInterval: 120s  # Execution interval. Must not exceed detectorCacheTimeout.
    dryRun: false               # Set to true for read-only mode (no evictions).
    # End of system configuration.

    profiles:
    - name: koord-descheduler
      plugins:
        deschedule:
          disabled:
            - name: "*"  # All plugins disabled by default (shown for reference only).
        balance:
          enabled:
            - name: LowNodeLoad
        evict:
          disabled:
            - name: "*"  # All plugins disabled by default (shown for reference only).
          enabled:
            - name: MigrationController

      pluginConfig:
      - name: MigrationController
        args:
          apiVersion: descheduler/v1alpha2
          kind: MigrationControllerArgs
          defaultJobMode: EvictDirectly
          maxMigratingPerNode: 1       # Max Pods migrating simultaneously per node. 0 = unlimited.
          maxMigratingPerNamespace: 1  # Max Pods migrating simultaneously per namespace.
          maxMigratingPerWorkload: 1   # Max Pods migrating simultaneously per workload (e.g., Deployment).
          maxUnavailablePerWorkload: 2 # Max unavailable replicas per workload during migration.
          evictLocalStoragePods: false # Whether to evict Pods using HostPath or emptyDir volumes.
          objectLimiters:
            workload:               # At most 1 replica migrated per workload within 5 minutes.
              duration: 5m
              maxMigrating: 1

      - name: LowNodeLoad
        args:
          apiVersion: descheduler/v1alpha2
          kind: LowNodeLoadArgs

          lowThresholds:
            cpu: 20
            memory: 30
          highThresholds:
            cpu: 50
            memory: 60

          anomalyCondition:
            consecutiveAbnormalities: 5  # Number of consecutive checks above highThresholds
                                          # before a node is classified as a hot spot.
                                          # Counter resets after eviction.

          detectorCacheTimeout: "5m"  # Cache duration for hot spot checks.
                                      # Must be >= deschedulingInterval.

          evictableNamespaces:
            include:
              - default
            # exclude:
            #   - "kube-system"
            #   - "koordinator-system"

          nodeSelector:  # Process only the specified nodes.
            matchLabels:
              alibabacloud.com/nodepool-id: np77f520e1108f47559e63809713ce****

          podSelectors:  # Process only the specified Pods.
          - name: lsPods
            selector:
              matchLabels:
                koordinator.sh/qosClass: "LS"
Configuration système du désordonnanceur Koordinator
| Paramètre | Type | Valeur | Description | Exemple |
|---|---|---|---|---|
dryRun |
boolean | true / false (par défaut) |
Commutateur du mode lecture seule. Lorsqu'il est activé, aucune migration de Pod n'est initiée. | false |
deschedulingInterval |
time.Duration | > 0s | Intervalle d'exécution. Ne doit pas dépasser detectorCacheTimeout dans le plug-in LowNodeLoad. |
120s |
Configuration du contrôle d'expulsion et de migration
| Paramètre | Type | Valeur | Description | Exemple |
|---|---|---|---|---|
maxMigratingPerNode |
int64 | ≥ 0 (par défaut : 2) | Nombre maximal de Pods migrant simultanément par nœud. 0 = illimité. |
2 |
maxMigratingPerNamespace |
int64 | ≥ 0 (par défaut : illimité) | Nombre maximal de Pods migrant simultanément par namespace. 0 = illimité. |
1 |
maxMigratingPerWorkload |
intOrString | ≥ 0 (par défaut : 10 %) | Nombre maximal de Pods migrants ou pourcentage par charge de travail (par exemple, Deployment). 0 = illimité. Les charges de travail à réplica unique sont exclues. |
1 ou 10% |
maxUnavailablePerWorkload |
intOrString | ≥ 0 (par défaut : 10 %), inférieur au nombre total de réplicas | Nombre maximal de réplicas indisponibles ou pourcentage par charge de travail. 0 = illimité. |
1 ou 10% |
evictLocalStoragePods |
boolean | true / false (par défaut) |
Indique s'il faut expulser les Pods utilisant des volumes HostPath ou emptyDir. Désactivé par défaut pour garantir la sécurité des données. | false |
objectLimiters.workload |
struct | Durée > 0s (par défaut : 5m); MaxMigrating ≥ 0 (par défaut : 10 %) |
Limitation de la migration au niveau de la charge de travail. Duration : fenêtre temporelle. MaxMigrating : nombre maximal de réplicas migrés durant cette fenêtre. La valeur par défaut correspond à maxMigratingPerWorkload. |
duration: 5m / maxMigrating: 1 — maximum 1 réplica par charge de travail sur une période de 5 minutes. |
Configuration du plug-in LowNodeLoad
| Paramètre | Type | Valeur | Description | Exemple |
|---|---|---|---|---|
highThresholds |
map[string]float64 | [0, 100] (processeur et mémoire, en pourcentages) | Seuil de point chaud. Les Pods présents sur les nœuds dépassant ce seuil sont éligibles à l'expulsion. Si tous les nœuds dépassent lowThresholds, le désordonnancement est suspendu. |
cpu: 55 / memory: 75 |
lowThresholds |
map[string]float64 | [0, 100] (processeur et mémoire, en pourcentages) | Seuil d'inactivité. Si tous les nœuds dépassent ce seuil, la charge globale du cluster est considérée comme élevée et le désordonnancement est suspendu. | cpu: 25 / memory: 25 |
anomalyCondition.consecutiveAbnormalities |
int64 | > 0 (par défaut : 5) | Nombre de cycles consécutifs pendant lesquels un nœud doit dépasser highThresholds pour être classé comme point chaud. Le compteur est réinitialisé après une expulsion. |
5 |
detectorCacheTimeout |
\*metav1.Duration | Voir le format Duration (par défaut : 5m) |
Durée de mise en cache pour les vérifications des points chauds. Doit être supérieure ou égale à deschedulingInterval. |
1h, 300s, 2m30s |
evictableNamespaces |
include: string / exclude: string | Namespaces du cluster | Limite le périmètre du désordonnancement à des namespaces spécifiques. Laissez vide pour traiter tous les Pods. Les options include et exclude s'excluent mutuellement. |
exclude: ["kube-system", "koordinator-system"] |
nodeSelector |
metav1.LabelSelector | Voir la section Étiquettes et sélecteurs | Limite le périmètre du désordonnancement à des nœuds spécifiques à l'aide d'un sélecteur d'étiquettes. Prend en charge un pool de nœuds unique (matchLabels) et plusieurs pools de nœuds (matchExpressions). |
matchLabels: {alibabacloud.com/nodepool-id: np****} |
podSelectors |
liste de PodSelector | Voir la section Étiquettes et sélecteurs | Limite le périmètre du désordonnancement à des Pods spécifiques à l'aide de sélecteurs d'étiquettes. Plusieurs groupes de sélecteurs sont pris en charge. | matchLabels: {koordinator.sh/qosClass: "LS"} |
FAQ
L'utilisation du nœud dépasse le seuil, mais les Pods ne sont pas expulsés
La cause la plus fréquente est une configuration inactive du désordonnanceur. Vérifiez les points suivants dans l'ordre :
Périmètre non configuré : Le désordonnanceur traite uniquement les namespaces et les nœuds explicitement inclus (ou non exclus). Vérifiez les paramètres
evictableNamespacesetnodeSelector.Désordonnanceur non redémarré après modification de la configuration : Les modifications de configuration nécessitent un redémarrage. Consultez l'Étape 2 pour obtenir les instructions.
Intervalle supérieur au délai d'expiration du cache :
deschedulingInterval(par défaut : 2 min) ne doit pas dépasserdetectorCacheTimeout(par défaut : 5 min), sinon la détection des points chauds échoue. Ajustez ces valeurs et redémarrez.Nœud ne dépassant pas systématiquement le seuil : Le désordonnanceur utilise une moyenne lissée. Un nœud n'est classé comme point chaud qu'après avoir dépassé
highThresholdspendantconsecutiveAbnormalitiescycles consécutifs (par défaut : 5, soit environ 10 minutes). La commandekubectl top nodene reflète que la dernière minute ; effectuez une surveillance sur une période plus longue pour confirmer une utilisation soutenue.Capacité insuffisante du cluster : Avant d'expulser un Pod, le désordonnanceur vérifie qu'un autre nœud dispose d'une capacité libre suffisante. Si ce n'est pas le cas, l'expulsion est ignorée. Ajoutez des nœuds pour augmenter la capacité.
Charge de travail à réplica unique : Les Pods à réplica unique ne sont pas expulsés par défaut. Pour contourner cette restriction, ajoutez l'annotation
descheduler.alpha.kubernetes.io/evict: "true"au Pod ou aux métadonnées du modèle de la charge de travail (spec.template.metadata). Cette fonctionnalité n'est pas prise en charge dans les versions ack-koordinator v1.3.0-ack1.6 à v1.3.0-ack1.8. Effectuez la mise à niveau vers la dernière version pour utiliser cette fonctionnalité.Pod utilisant HostPath ou emptyDir : Ces Pods sont exclus du désordonnancement par défaut. Définissez
evictLocalStoragePods: truedans MigrationController pour activer l'expulsion. Consultez la section Configuration du contrôle d'expulsion et de migration.Nombre excessif de réplicas indisponibles ou en cours de migration : Si le nombre de réplicas indisponibles ou en cours de migration atteint
maxUnavailablePerWorkloadoumaxMigratingPerWorkload, les expulsions suivantes sont bloquées. Attendez la fin des expulsions en cours ou augmentez ces limites.Nombre de réplicas inférieur ou égal à la limite de migration : Si le nombre total de réplicas est inférieur ou égal à
maxMigratingPerWorkloadoumaxUnavailablePerWorkload, la charge de travail est ignorée. Diminuez ces valeurs ou utilisez des pourcentages.
Le désordonnanceur redémarre fréquemment
Une ConfigMap manquante ou invalide provoque des boucles de redémarrage. Vérifiez le format de la ConfigMap en vous référant à la section Configuration avancée, puis procédez au redémarrage comme indiqué à l'Étape 2.
Interaction entre la planification consciente de la charge et le désordonnancement des points chauds
Activez les deux fonctionnalités pour obtenir un équilibrage de charge optimal. Le désordonnancement expulse les Pods des nœuds surchargés, tandis que la planification consciente de la charge place les Pods replanifiés sur des nœuds dont l'utilisation est plus faible.
Définissez loadAwareThreshold de manière à correspondre à highThresholds. Consultez les sections Utiliser la planification consciente de la charge et Politiques de planification.
Quelles données d'utilisation le désordonnanceur utilise-t-il ?
Le désordonnanceur calcule une moyenne lissée sur plusieurs cycles. L'expulsion ne se déclenche que lorsque l'utilisation moyenne reste supérieure à highThresholds pendant le nombre de cycles consécutifs configuré (par défaut : environ 10 minutes).
Le désordonnanceur exclut le cache de page des calculs de mémoire (celui-ci pouvant être libéré par le système d'exploitation). La commande kubectl top node inclut le cache de page ; utilisez Managed Service for Prometheus pour consulter la métrique réelle.