Dans un cluster Kubernetes, l'équilibrage de charge traditionnel des services d'inférence de grands modèles de langage (LLM) repose souvent sur une allocation simple du trafic. Cette approche s'avère généralement insuffisante face à la complexité des requêtes et à la dynamique des charges. Cette rubrique explique comment utiliser le composant Gateway with Inference Extension pour configurer des extensions de service d'inférence afin d'assurer un routage intelligent et une gestion efficace du trafic.
Contexte
KV cache
Procédure
Le diagramme suivant illustre le flux de travail.

Sur l'inference-gateway, le port 8080 utilise une route HTTP standard pour transférer les requêtes vers le service d'inférence backend. Le port 8081 achemine les requêtes via l'extension LLM Route, qui les transfère ensuite au même service.
Dans une route HTTP, utilisez une ressource
InferencePoolpour déclarer un groupe de charges de travail de service d'inférence LLM, ainsi qu'une ressourceInferenceModelpour spécifier la politique de distribution du trafic d'un modèle dans cetInferencePool. Cette configuration achemine les requêtes du port 8081 de l'inference-gateway vers les charges de travail de service d'inférence LLM spécifiées, à l'aide d'un algorithme d'équilibrage de charge optimisé pour les services d'inférence.
Prérequis
Vous disposez d'un cluster ACK géré avec un pool de nœuds GPU. Vous pouvez également installer le composant ACK Virtual Node dans le cluster ACK géré pour utiliser la puissance de calcul GPU ACS.
Procédure
Étape 1 : Déployer un service d'inférence exemple
-
Créez un fichier nommé vllm-service.yaml avec le contenu suivant.
RemarquePour cette image, nous recommandons d'utiliser des cartes A10 dans les clusters ACK et des cartes L20 (GN8IS) dans Alibaba Cloud Container Compute Service.
Par ailleurs, comme les images LLM sont volumineuses, nous vous conseillons de les pousser vers Container Registry et de les récupérer via une adresse interne. Le téléchargement direct d'une image depuis le réseau public peut être lent, car la vitesse dépend de la bande passante de l'adresse IP élastique (EIP) du cluster.
-
Déployez le service d'inférence exemple.
kubectl apply -f vllm-service.yaml
Étape 2 : Installer le composant Gateway with Inference Extension****
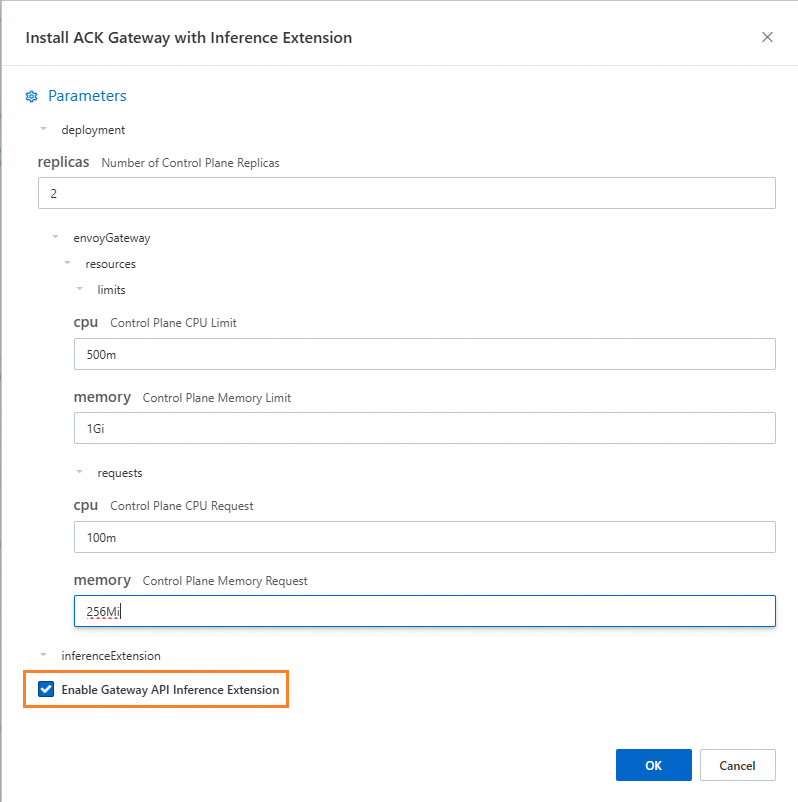
Installez le composant ACK Gateway with Inference Extension ou , et assurez-vous que l'option Enable Gateway API Inference Extension (Requires a deployed inference service) est sélectionnée.
Étape 3 : Déployer le routage d'inférence
Cette étape crée les ressources InferencePool et InferenceModel.
-
Créez le fichier
inference-pool.yaml.apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferencePool metadata: name: vllm-qwen-pool spec: targetPortNumber: 8000 selector: app: qwen extensionRef: name: inference-gateway-ext-proc --- apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceModel metadata: name: inferencemodel-qwen spec: modelName: /model/qwen criticality: Critical poolRef: group: inference.networking.x-k8s.io kind: InferencePool name: vllm-qwen-pool targetModels: - name: /model/qwen weight: 100 -
Déployez le routage d'inférence.
kubectl apply -f inference-pool.yaml
Étape 4 : Déployer et vérifier la passerelle
Au cours de cette étape, créez une passerelle qui écoute sur les ports 8080 et 8081.
-
Créez un fichier nommé
inference-gateway.yaml.apiVersion: gateway.networking.k8s.io/v1 kind: GatewayClass metadata: name: qwen-inference-gateway-class spec: controllerName: gateway.envoyproxy.io/gatewayclass-controller --- apiVersion: gateway.networking.k8s.io/v1 kind: Gateway metadata: name: qwen-inference-gateway spec: gatewayClassName: qwen-inference-gateway-class listeners: - name: http protocol: HTTP port: 8080 - name: llm-gw protocol: HTTP port: 8081 --- apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: qwen-backend spec: parentRefs: - name: qwen-inference-gateway sectionName: llm-gw rules: - backendRefs: - group: inference.networking.x-k8s.io kind: InferencePool name: vllm-qwen-pool matches: - path: type: PathPrefix value: / --- apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: qwen-backend-no-inference spec: parentRefs: - group: gateway.networking.k8s.io kind: Gateway name: qwen-inference-gateway sectionName: http rules: - backendRefs: - group: "" kind: Service name: qwen port: 8000 weight: 1 matches: - path: type: PathPrefix value: / --- apiVersion: gateway.envoyproxy.io/v1alpha1 kind: BackendTrafficPolicy metadata: name: backend-timeout spec: timeout: http: requestTimeout: 1h targetRef: group: gateway.networking.k8s.io kind: Gateway name: qwen-inference-gateway -
Déployez la passerelle.
kubectl apply -f inference-gateway.yamlCette configuration crée un namespace nommé
envoy-gateway-systemet un service nomméenvoy-default-inference-gateway-645xxxxxdans le cluster. -
Obtenez l'adresse IP publique de la passerelle.
export GATEWAY_HOST=$(kubectl get gateway/qwen-inference-gateway -o jsonpath='{.status.addresses[0].value}') -
Vérifiez que la passerelle achemine les requêtes vers le service d'inférence via le routage HTTP standard sur le port 8080.
curl -X POST ${GATEWAY_HOST}:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{
    "model": "/model/qwen",
    "max_completion_tokens": 100,
    "temperature": 0,
    "messages": [
      {
        "role": "user",
        "content": "Write as if you were a critic: San Francisco"
      }
    ]
}'
Sortie attendue :
{"id":"chatcmpl-aa6438e2-d65b-4211-afb8-ae8e76e7a692","object":"chat.completion","created":1747191180,"model":"/model/qwen","choices":[{"index":0,"message":{"role":"assistant","reasoning_content":null,"content":"San Francisco, a city that has long been a beacon of innovation, culture, and diversity, continues to captivate the world with its unique charm and character. As a critic, I find myself both enamored and occasionally perplexed by the city's multifaceted personality.\n\nSan Francisco's architecture is a testament to its rich history and progressive spirit. The iconic cable cars, Victorian houses, and the Golden Gate Bridge are not just tourist attractions but symbols of the city's enduring appeal. However, the","tool_calls":[]},"logprobs":null,"finish_reason":"length","stop_reason":null}],"usage":{"prompt_tokens":39,"total_tokens":139,"completion_tokens":100,"prompt_tokens_details":null},"prompt_logprobs":null} -
Vérifiez que la passerelle achemine les requêtes vers le service d'inférence via l'extension de service d'inférence sur le port 8081.
curl -X POST ${GATEWAY_HOST}:8081/v1/chat/completions -H 'Content-Type: application/json' -d '{
    "model": "/model/qwen",
    "max_completion_tokens": 100,
    "temperature": 0,
    "messages": [
      {
        "role": "user",
        "content": "Write as if you were a critic: Los Angeles"
      }
    ]
}'
Sortie attendue :
{"id":"chatcmpl-cc4fcd0a-6a66-4684-8dc9-284d4eb77bb7","object":"chat.completion","created":1747191969,"model":"/model/qwen","choices":[{"index":0,"message":{"role":"assistant","reasoning_content":null,"content":"Los Angeles, the sprawling metropolis often referred to as \"L.A.,\" is a city that defies easy description. It is a place where dreams are made and broken, where the sun never sets, and where the line between reality and fantasy is as blurred as the smog that often hangs over its valleys. As a critic, I find myself both captivated and perplexed by this city that is as much a state of mind as it is a physical place.\n\nOn one hand, Los","tool_calls":[]},"logprobs":null,"finish_reason":"length","stop_reason":null}],"usage":{"prompt_tokens":39,"total_tokens":139,"completion_tokens":100,"prompt_tokens_details":null},"prompt_logprobs":null}
(Facultatif) Étape 5 : Configurer les métriques d'observabilité et le tableau de bord
Activez et configurez Managed Service for Prometheus pour votre cluster. Cette opération peut entraîner des frais supplémentaires.
-
Ajoutez des annotations Prometheus au pod du service vLLM pour activer la collecte de métriques. Une instance Prometheus pourra alors utiliser son mécanisme de découverte de services par défaut pour récupérer les métriques du service vLLM et surveiller son état interne.
...
annotations:
  prometheus.io/path: /metrics # The HTTP path where metrics are exposed.
  prometheus.io/port: "8000" # The port for exposing metrics, which is the listening port of the vLLM server.
  prometheus.io/scrape: "true" # Whether to scrape metrics from the current pod.
...
Le tableau suivant décrit certaines métriques de surveillance fournies par le service vLLM :
Métrique
Description
vllm:gpu_cache_usage_perc
Pourcentage du cache GPU utilisé par vLLM. Au démarrage, vLLM alloue préventivement autant de mémoire vidéo GPU que possible pour le KV cache. Pour un serveur vLLM, une utilisation plus faible signifie que le GPU dispose de suffisamment d'espace pour traiter de nouvelles requêtes.
vllm:request_queue_time_seconds_sum
Temps total passé par les requêtes dans la file d'attente. Lorsqu'une requête d'inférence LLM arrive sur le serveur vLLM, elle n'est pas nécessairement traitée immédiatement. Elle doit attendre d'être planifiée par l'ordonnanceur vLLM pour les phases de pré-remplissage et de décodage.
vllm:num_requests_running
vllm:num_requests_waiting
vllm:num_requests_swapped
Nombre de requêtes actuellement en cours d'exécution, en attente ou basculées en mémoire. Ces métriques permettent d'évaluer la charge actuelle des requêtes sur le service vLLM.
vllm:avg_generation_throughput_toks_per_s
vllm:avg_prompt_throughput_toks_per_s
Nombre de tokens consommés par seconde lors de la phase de pré-remplissage et nombre de tokens générés par seconde lors de la phase de décodage.
vllm:time_to_first_token_seconds_bucket
Latence entre l'envoi d'une requête au service vLLM et la réception du premier token. Communément appelé Time to First Token (TTFT), cet indicateur mesure le délai entre l'émission d'une requête par un client et la réception de la première partie de la réponse. Le TTFT est un critère essentiel pour évaluer l'expérience utilisateur des LLM.
Configurez des règles d'alerte basées sur ces métriques pour surveiller le service vLLM et détecter les anomalies en temps réel.
-
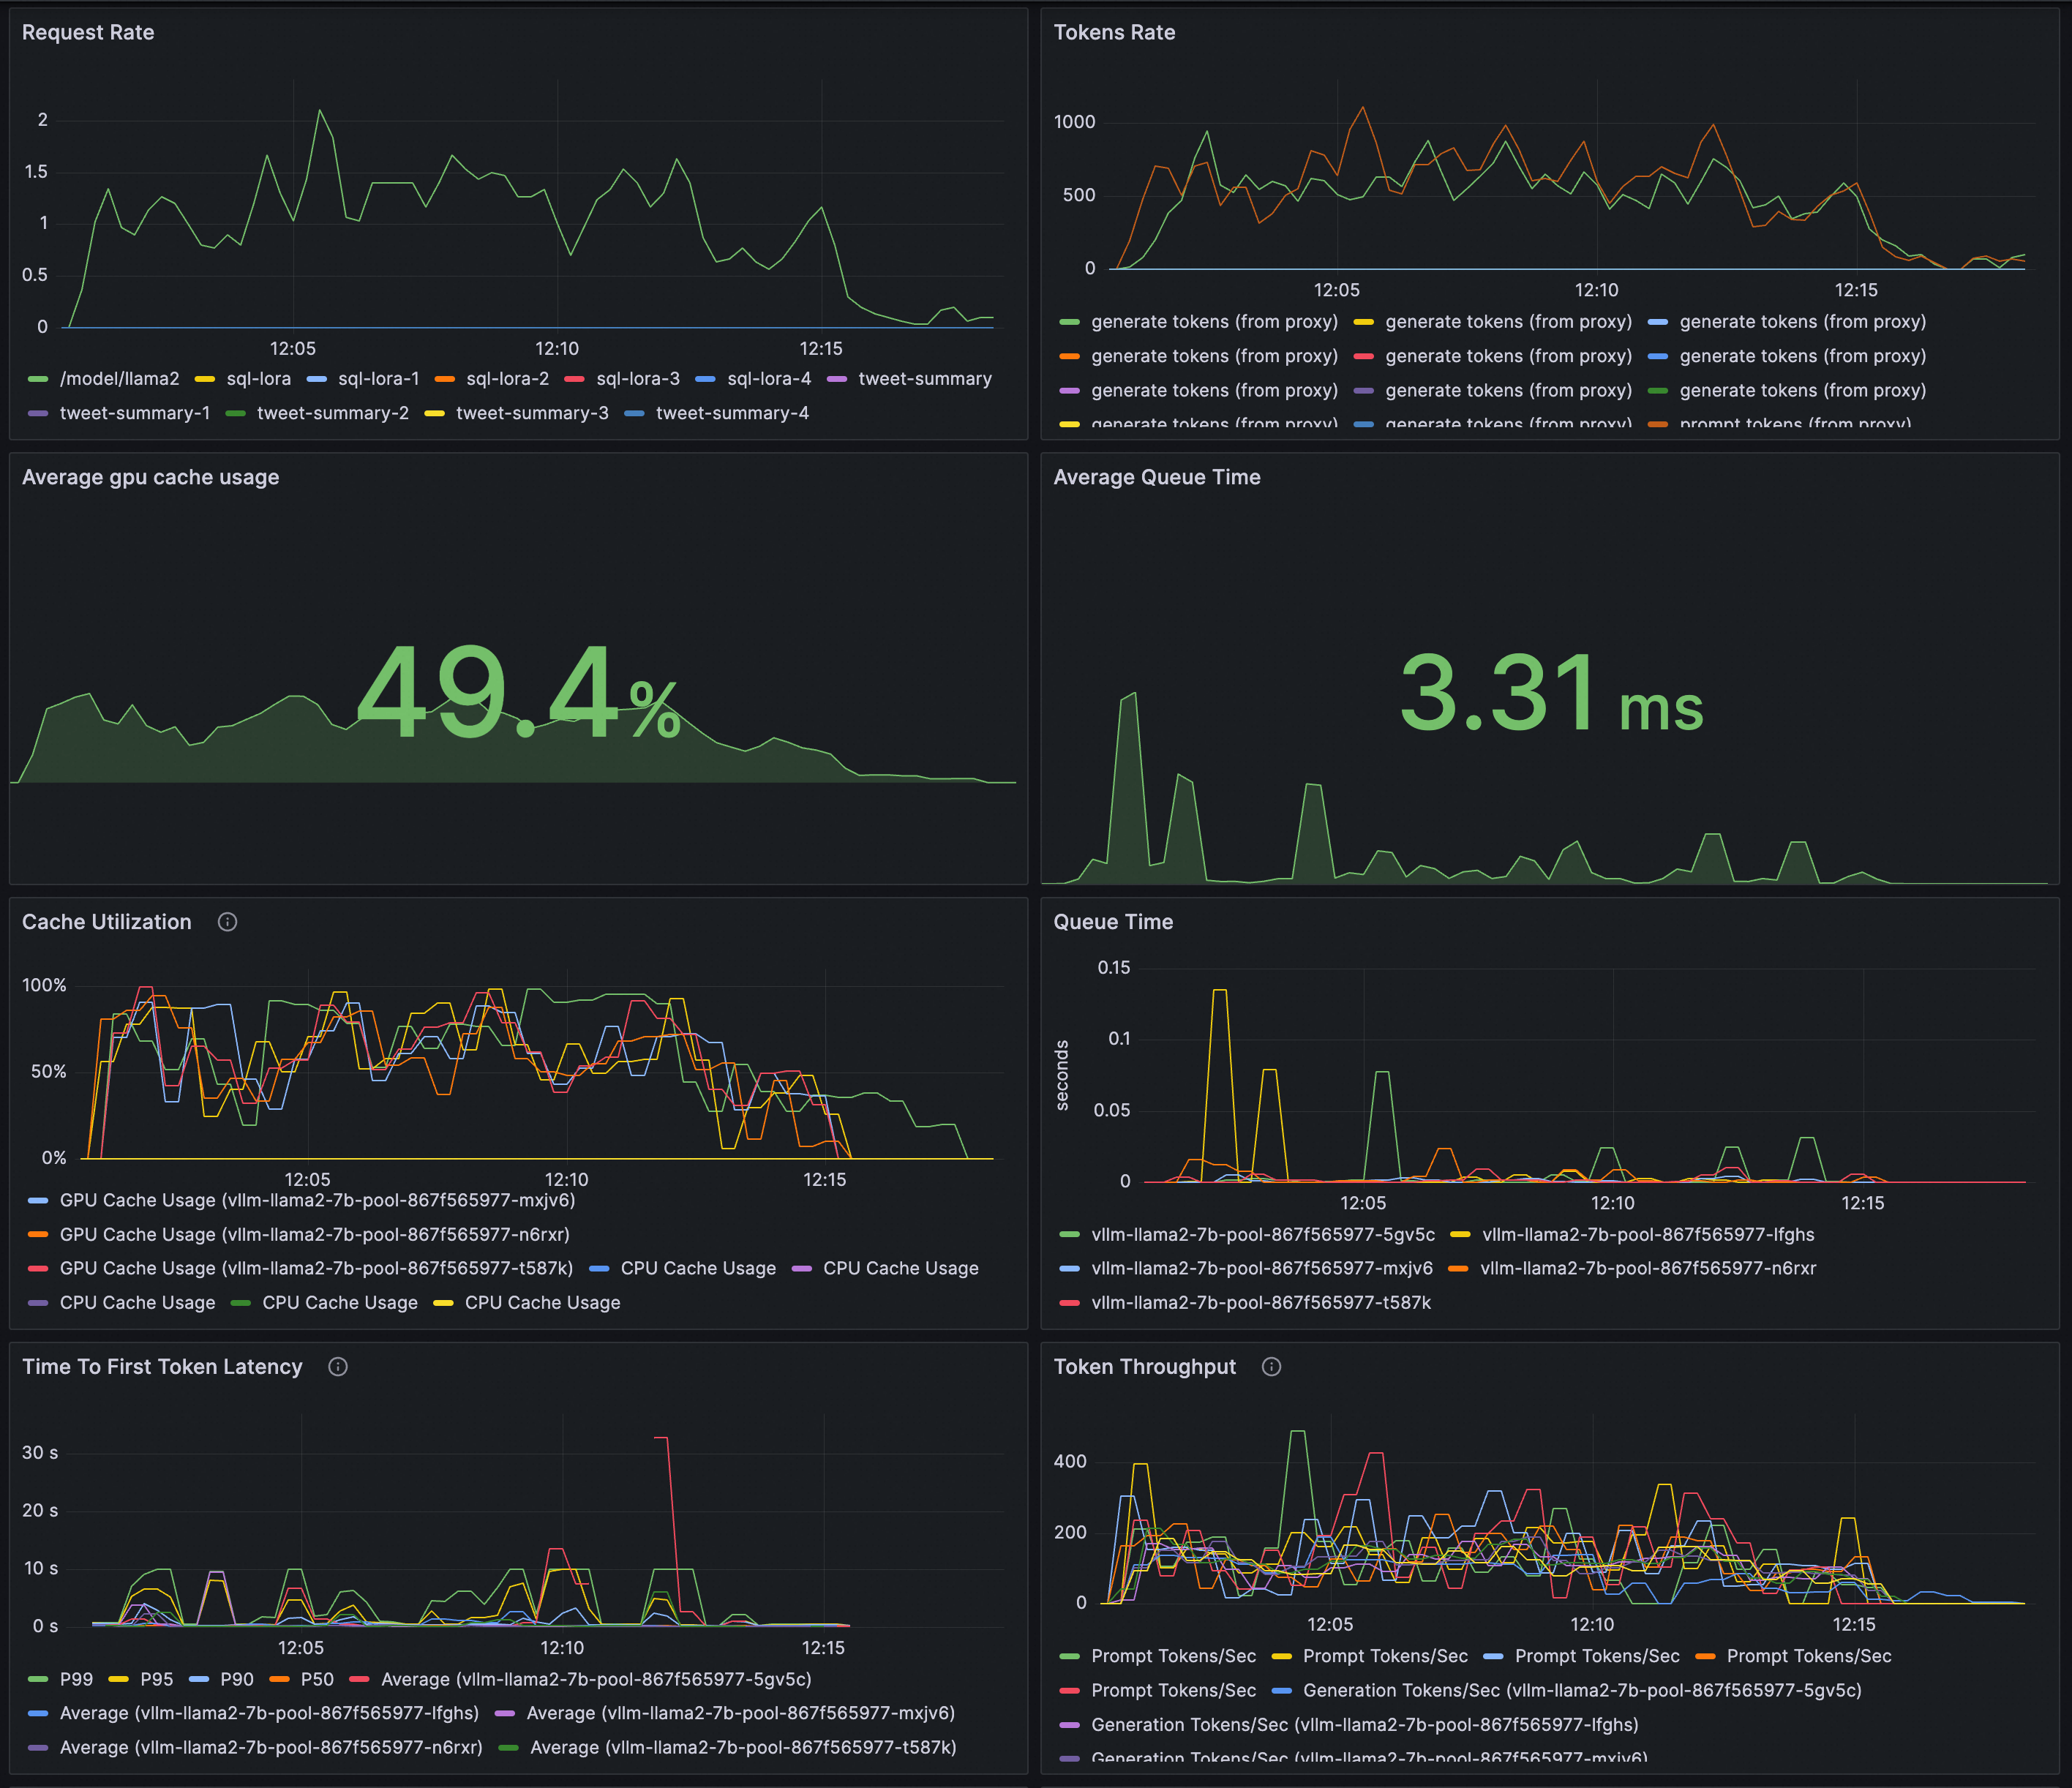
Configurez un tableau de bord Grafana pour la surveillance en temps réel du service d'inférence LLM. Ce tableau de bord permet de :
Suivre le taux de requêtes et le débit total de tokens du service LLM.
Surveiller l'état interne de la charge de travail d'inférence.
Assurez-vous que l'instance Prometheus utilisée comme source de données pour Grafana a bien collecté les métriques de surveillance vLLM. Pour créer le tableau de bord, importez le contenu JSON suivant dans Grafana.
Aperçu :
-
Dans un cluster ACK, utilisez vllm benchmark pour tester la charge du service d'inférence et comparer l'équilibrage de charge entre une HTTP Route et une LLM Route.
-
Déployez la charge de travail de benchmark.
kubectl apply -f- <<EOF apiVersion: apps/v1 kind: Deployment metadata: labels: app: vllm-benchmark name: vllm-benchmark namespace: default spec: progressDeadlineSeconds: 600 replicas: 1 revisionHistoryLimit: 10 selector: matchLabels: app: vllm-benchmark strategy: rollingUpdate: maxSurge: 25% maxUnavailable: 25% type: RollingUpdate template: metadata: creationTimestamp: null labels: app: vllm-benchmark spec: containers: - command: - sh - -c - sleep inf image: registry-cn-hangzhou.ack.aliyuncs.com/dev/llm-benchmark:random-and-qa imagePullPolicy: IfNotPresent name: vllm-benchmark resources: {} terminationMessagePath: /dev/termination-log terminationMessagePolicy: File dnsPolicy: ClusterFirst restartPolicy: Always schedulerName: default-scheduler securityContext: {} terminationGracePeriodSeconds: 30 EOF -
Lancez le test de charge.
-
Obtenez l'adresse IP interne de la passerelle.
export GW_IP=$(kubectl get svc -n envoy-gateway-system -l gateway.envoyproxy.io/owning-gateway-namespace=default,gateway.envoyproxy.io/owning-gateway-name=qwen-inference-gateway -o jsonpath='{.items[0].spec.clusterIP}') -
Exécutez le test de charge.
HTTP route
kubectl exec -it deploy/vllm-benchmark -- env GW_IP=${GW_IP} python3 /root/vllm/benchmarks/benchmark_serving.py \
--backend vllm \
--model /models/DeepSeek-R1-Distill-Qwen-7B \
--served-model-name /model/qwen \
--trust-remote-code \
--dataset-name random \
--random-prefix-len 10 \
--random-input-len 1550 \
--random-output-len 1800 \
--random-range-ratio 0.2 \
--num-prompts 3000 \
--max-concurrency 200 \
--host $GW_IP \
--port 8080 \
--endpoint /v1/completions \
--save-result \
2>&1 | tee benchmark_serving.txt
LLM route
kubectl exec -it deploy/vllm-benchmark -- env GW_IP=${GW_IP} python3 /root/vllm/benchmarks/benchmark_serving.py \
--backend vllm \
--model /models/DeepSeek-R1-Distill-Qwen-7B \
--served-model-name /model/qwen \
--trust-remote-code \
--dataset-name random \
--random-prefix-len 10 \
--random-input-len 1550 \
--random-output-len 1800 \
--random-range-ratio 0.2 \
--num-prompts 3000 \
--max-concurrency 200 \
--host $GW_IP \
--port 8081 \
--endpoint /v1/completions \
--save-result \
2>&1 | tee benchmark_serving.txt
-
Une fois les deux tests terminés, consultez le tableau de bord pour comparer les performances de routage de la HTTP Route et de la LLM Route.
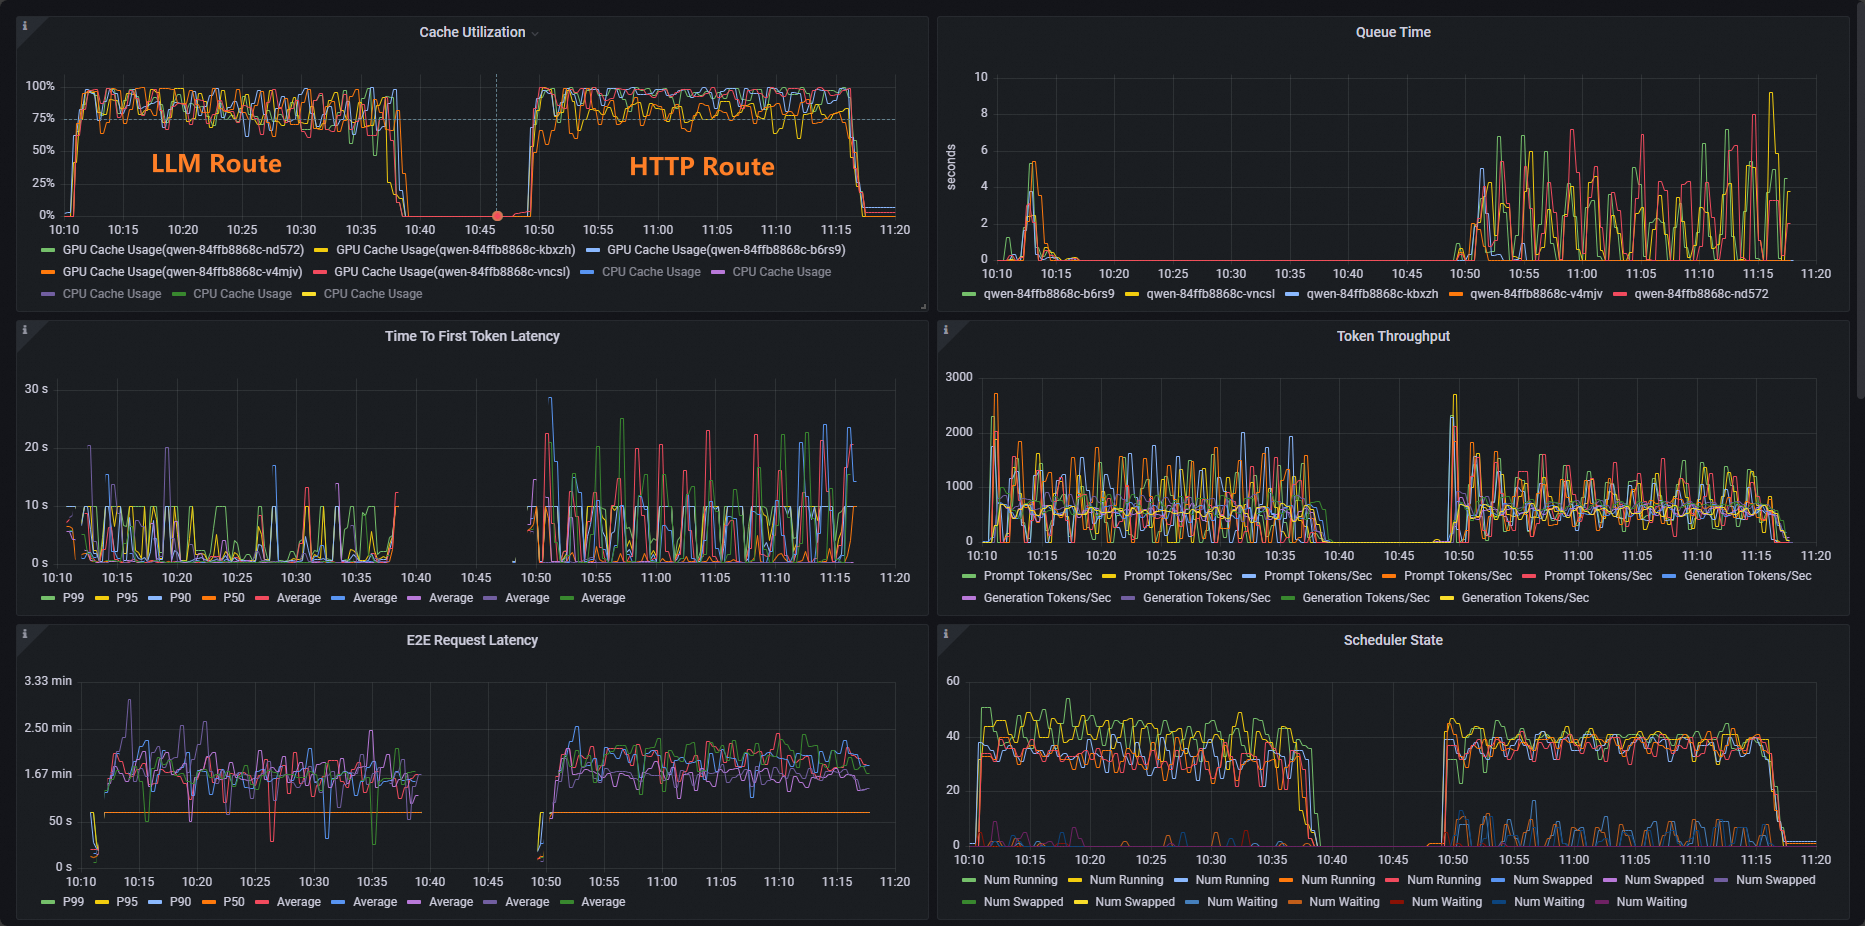
Le tableau de bord montre que les charges de travail de la HTTP Route présentent une distribution inégale de l'utilisation du cache, tandis que celles de la LLM Route affichent une distribution normale.
-
Opérations associées
Gateway with Inference Extension prend en charge différentes stratégies d'équilibrage de charge adaptées à divers cas d'utilisation des services d'inférence. Pour configurer la stratégie d'équilibrage de charge des requêtes d'inférence acheminées vers les pods d'un InferencePool, ajoutez l'annotation inference.networking.x-k8s.io/routing-strategy à la ressource InferencePool.
L'exemple suivant utilise le sélecteur app: vllm-app pour cibler les pods du service d'inférence et définit la stratégie d'équilibrage de charge sur la stratégie par défaut, basée sur les métriques.
apiVersion: inference.networking.x-k8s.io/v1alpha2
kind: InferencePool
metadata:
  name: vllm-app-pool
  annotations:
    inference.networking.x-k8s.io/routing-strategy: "DEFAULT"
spec:
  targetPortNumber: 8000
  selector:
    app: vllm-app
  extensionRef:
    name: inference-gateway-ext-proc
Les stratégies d'équilibrage de charge suivantes sont prises en charge :
|
Stratégie |
Description |
|
DEFAULT |
Stratégie d'équilibrage de charge basée sur les métriques. Elle évalue l'état interne des serveurs d'inférence à l'aide de métriques multidimensionnelles, telles que la longueur de la file d'attente des requêtes et l'utilisation du cache GPU. Le trafic est ensuite réparti entre plusieurs charges de travail de serveurs d'inférence en fonction de cet état. |
|
PREFIX_CACHE |
Stratégie d'équilibrage de charge utilisant la correspondance de préfixes de requêtes. Elle tente d'acheminer les requêtes partageant un préfixe commun vers le même pod de serveur d'inférence. Cette approche est idéale pour les scénarios impliquant un volume élevé de requêtes avec un préfixe partagé, particulièrement lorsque la mise en cache automatique des préfixes est activée sur le serveur d'inférence. Cas d'utilisation typiques :
|