Configurez Knative Pod Autoscaler (KPA) pour mettre à l'échelle les pods Knative Serving en fonction de la concurrence ou des RPS sur ACK.
Prérequis
Avant de commencer, vérifiez que :
Un cluster ACK managé ou cluster ACK Serverless exécutant Kubernetes 1.20 ou une version ultérieure est créé.
Knative est déployé dans le cluster.
Fonctionnement
Knative Serving injecte un conteneur sidecar queue-proxy dans chaque pod. Le sidecar transmet les métriques de concurrence au KPA, qui ajuste le nombre de pods en fonction de ces métriques et de l'algorithme configuré.

Algorithme de mise à l'échelle
Le KPA calcule le nombre cible de pods à l'aide de la formule suivante :
Number of pods = Number of concurrent requests / (Pod maximum concurrency × Target utilization)Exemple : Avec containerConcurrency défini sur 10 et une utilisation cible de 70 %, 100 requêtes simultanées produisent : 100 / (10 × 0,7) = 15 pods (arrondi supérieur).
Modes stable et panique
Le KPA utilise deux modes pour répondre aux variations de trafic :
Mode stable — mode par défaut. Le KPA fait la moyenne de la concurrence sur tous les pods pendant la fenêtre stable (par défaut : 60 s) et ajuste le nombre de pods en conséquence.
Mode panique — déclenché lors de pics de trafic. Le KPA utilise une fenêtre de panique plus courte (par défaut : 6 s ; stable window × panic-window-percentage) pour détecter les pics. Lorsque le nombre de pods en mode panique ≥ panic-threshold-percentage / 100 × pods prêts (par défaut : 2×), le KPA utilise le compte de panique au lieu du compte stable.
Configurer la ConfigMap config-autoscaler
Les valeurs par défaut globales du KPA se trouvent dans la ConfigMap config-autoscaler du namespace knative-serving. Les annotations par révision remplacent ces valeurs par défaut.
Consultez la configuration actuelle :
kubectl -n knative-serving describe cm config-autoscalerLe tableau suivant répertorie les paramètres clés. Toutes les valeurs indiquées sont des valeurs par défaut.
| Paramètre | Par défaut | Description |
|---|---|---|
container-concurrency-target-default |
100 |
Nombre maximal de requêtes simultanées par pod (limite souple, globale) |
container-concurrency-target-percentage |
70 |
Pourcentage d'utilisation cible pour la mise à l'échelle basée sur la concurrence |
requests-per-second-target-default |
200 |
RPS cible par pod |
target-burst-capacity |
211 |
Capacité de burst avant que l'Activator ne mette les requêtes en tampon. 0 : Activator uniquement à l'échelle zéro. Supérieur à 0 avec container-concurrency-target-percentage à 100 : utiliser toujours l'Activator. -1 : illimité. |
stable-window |
60s |
Fenêtre temporelle pour la moyenne en mode stable |
panic-window-percentage |
10.0 |
Fenêtre de panique en pourcentage de la fenêtre stable (par défaut : 6 s) |
panic-threshold-percentage |
200.0 |
La panique se déclenche lorsque les pods souhaités ≥ panic-threshold-percentage / 100 × pods prêts |
max-scale-up-rate |
1000.0 |
Ratio maximal de pods souhaités par événement de montée en charge : ceil(max-scale-up-rate × readyPodsCount) |
max-scale-down-rate |
2.0 |
La réduction de capacité des pods atteint au maximum la moitié du nombre actuel par activité |
enable-scale-to-zero |
true |
Indique s'il faut réduire à zéro le nombre de pods des services inactifs |
scale-to-zero-grace-period |
30s |
Temps maximal alloué à la programmation réseau lors de la réduction à zéro |
scale-to-zero-pod-retention-period |
0s |
Durée minimale pendant laquelle le dernier pod est conservé après l'arrêt du trafic |
pod-autoscaler-class |
kpa.autoscaling.knative.dev |
Type d'autoscaler. Valeurs prises en charge : kpa.autoscaling.knative.dev, hpa.autoscaling.knative.dev, aha.autoscaling.knative.dev. Utilisez mpa avec MSE dans les clusters ACK Serverless pour réduire à zéro. |
activator-capacity |
100.0 |
Capacité de requête du service Activator |
initial-scale |
1 |
Nombre initial de pods par révision |
allow-zero-initial-scale |
false |
Indique si une révision peut démarrer avec zéro pod |
min-scale |
0 |
Nombre minimal de pods par révision (0 = aucun plancher) |
max-scale |
0 |
Nombre maximal de pods par révision (0 = illimité) |
scale-down-delay |
0s |
Délai à concurrence réduite avant la réduction de capacité. Contrairement à min-scale, les pods finissent par être réduits après le délai. Évite les démarrages à froid lors de courtes accalmies de trafic. |
scale-to-zero-grace-period limite la durée pendant laquelle la programmation réseau peut avoir lieu lors de la réduction à zéro. Ajustez ce paramètre uniquement si vous constatez des requêtes abandonnées lors de la réduction à zéro ; cela ne contrôle pas la durée pendant laquelle le dernier pod reste actif. Pour conserver le dernier pod après la fin du trafic, utilisez plutôt scale-to-zero-pod-retention-period.
Configurer les métriques de mise à l'échelle
Définissez la métrique de mise à l'échelle par révision avec l'annotation autoscaling.knative.dev/metric. Par défaut : concurrency.
| Métrique | Classe d'autoscaler requise | Description |
|---|---|---|
concurrency |
kpa.autoscaling.knative.dev (par défaut) |
Requêtes simultanées en cours par pod |
rps |
kpa.autoscaling.knative.dev (par défaut) |
Requêtes par seconde par pod |
cpu |
hpa.autoscaling.knative.dev |
Utilisation du CPU |
memory |
hpa.autoscaling.knative.dev |
Utilisation de la mémoire |
| Métriques personnalisées | Varie | Métriques personnalisées selon les exigences de l'application |
Métrique de concurrence (par défaut)
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/metric: "concurrency"
Métrique RPS
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/metric: "rps"
Métrique CPU
La mise à l'échelle basée sur le CPU nécessite la classe d'autoscaler HPA.
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/class: "hpa.autoscaling.knative.dev"
        autoscaling.knative.dev/metric: "cpu"
Métrique de mémoire
La mise à l'échelle basée sur la mémoire nécessite également la classe d'autoscaler HPA.
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/class: "hpa.autoscaling.knative.dev"
        autoscaling.knative.dev/metric: "memory"
Configurer les cibles de mise à l'échelle
Les cibles de mise à l'échelle définissent la valeur de métrique que le KPA maintient par pod. Configurez-les par révision ou globalement.
Cible de concurrence
Par révision — utilisez autoscaling.knative.dev/target :
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "50"
Globalement — mettez à jour la ConfigMap config-autoscaler :
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-default: "200"
Cible RPS
Par révision :
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "150"
        autoscaling.knative.dev/metric: "rps"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Globalement :
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  requests-per-second-target-default: "150"
Configurer les limites de concurrence
Les limites de concurrence plafonnent les requêtes simultanées par pod. Le KPA prend en charge deux types de limites.
Limite de concurrence souple
Une limite souple est la cible vers laquelle le KPA effectue la mise à l'échelle. Elle n'est pas strictement appliquée : les bursts peuvent la dépasser momentanément.
Par révision :
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target: "200"
Globalement :
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-default: "200"
Limite de concurrence stricte
Une limite stricte est appliquée rigoureusement : les requêtes excédentaires sont mises en tampon. Définissez une limite stricte uniquement lorsque votre application possède une limite supérieure ferme en matière de concurrence ; des valeurs faibles réduisent le débit et augmentent la latence.
Par révision — utilisez le champ de spécification containerConcurrency (et non une annotation) :
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    spec:
      containerConcurrency: 50
Utilisation cible
L'utilisation cible contrôle le niveau de remplissage des pods avant que le KPA n'effectue une montée en charge. À 70 % d'utilisation avec containerConcurrency: 10, le KPA crée un nouveau pod lorsque la concurrence moyenne sur les pods existants atteint 7. Des valeurs plus faibles incitent le KPA à effectuer une montée en charge plus tôt, réduisant ainsi la latence de démarrage à froid.
Par révision :
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/target-utilization-percentage: "70"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Globalement :
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  container-concurrency-target-percentage: "70"
Configurer la réduction à zéro
Activer ou désactiver la réduction à zéro globalement
Définissez enable-scale-to-zero sur "false" pour maintenir au moins un pod en cours d'exécution lorsqu'un service est inactif :
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  enable-scale-to-zero: "false"
Configurer la période de grâce de réduction à zéro
scale-to-zero-grace-period limite la durée pendant laquelle la programmation réseau peut avoir lieu lors de la réduction à zéro.
Augmentez cette valeur uniquement si vous constatez des requêtes abandonnées lors de la réduction à zéro. Cela ne contrôle pas la durée pendant laquelle le dernier pod reste actif. Pour conserver le dernier pod, utilisez plutôt scale-to-zero-pod-retention-period.
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  scale-to-zero-grace-period: "40s"
Configurer la période de rétention des pods
scale-to-zero-pod-retention-period conserve le dernier pod pendant une durée minimale après l'arrêt du trafic, évitant ainsi les démarrages à froid sur les services au trafic intermittent.
Par révision :
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: helloworld-go
  namespace: default
spec:
  template:
    metadata:
      annotations:
        autoscaling.knative.dev/scale-to-zero-pod-retention-period: "1m5s"
    spec:
      containers:
        - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/helloworld-go:73fbdd56
Globalement :
apiVersion: v1
kind: ConfigMap
metadata:
  name: config-autoscaler
  namespace: knative-serving
data:
  scale-to-zero-pod-retention-period: "42s"
Configurer les limites de mise à l'échelle
Les limites de mise à l'échelle définissent les nombres minimal et maximal de réplicas pour une révision.
| Annotation | Paramètre (global) | Objectif |
|---|---|---|
autoscaling.knative.dev/min-scale |
min-scale |
Plancher — le KPA ne réduit jamais en dessous de ce nombre |
autoscaling.knative.dev/max-scale |
max-scale |
Plafond — le KPA ne dépasse jamais ce nombre (0 = illimité) |
min-scalemaintient un plancher permanent de pods. Pour retarder la réduction de capacité sans plancher permanent, utilisezscale-down-delaydansconfig-autoscalerà la place — les pods finiront par être réduits après le délai.
Exemples
Exemple 1 : Mise à l'échelle par cible de concurrence
Déployez une application avec mise à l'échelle automatique avec une cible de concurrence de 10 et testez avec 50 requêtes simultanées.
Déployez Knative dans un cluster ACK ou un cluster ACK Serverless.
-
Créez
autoscale-go.yamlavec le contenu suivant :apiVersion: serving.knative.dev/v1 kind: Service metadata: name: autoscale-go namespace: default spec: template: metadata: labels: app: autoscale-go annotations: autoscaling.knative.dev/target: "10" # Concurrency target: 10 requests per pod spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/autoscale-go:0.1 -
Appliquez le manifeste :
kubectl apply -f autoscale-go.yaml -
Obtenez l'adresse de la passerelle Ingress. ALB :
kubectl get albconfig knative-internetSortie attendue :
NAME               ALBID                    DNSNAME                                              PORT&PROTOCOL   CERTID   AGE
knative-internet   alb-hvd8nngl0lsdra15g0   alb-hvd8nng******.cn-beijing.alb.aliyuncs.com                            2
MSE :
kubectl -n knative-serving get ing stats-ingressSortie attendue :
NAME            CLASS                  HOSTS   ADDRESS                         PORTS   AGE
stats-ingress   knative-ingressclass   *       101.201.XX.XX,192.168.XX.XX   80      15d
ASM :
kubectl get svc istio-ingressgateway --namespace istio-system --output jsonpath="{.status.loadBalancer.ingress[*]['ip']}"Sortie attendue :
121.XX.XX.XXKourier :
kubectl -n knative-serving get svc kourierSortie attendue :
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kourier LoadBalancer 10.0.XX.XX 39.104.XX.XX 80:31133/TCP,443:32515/TCP 49m -
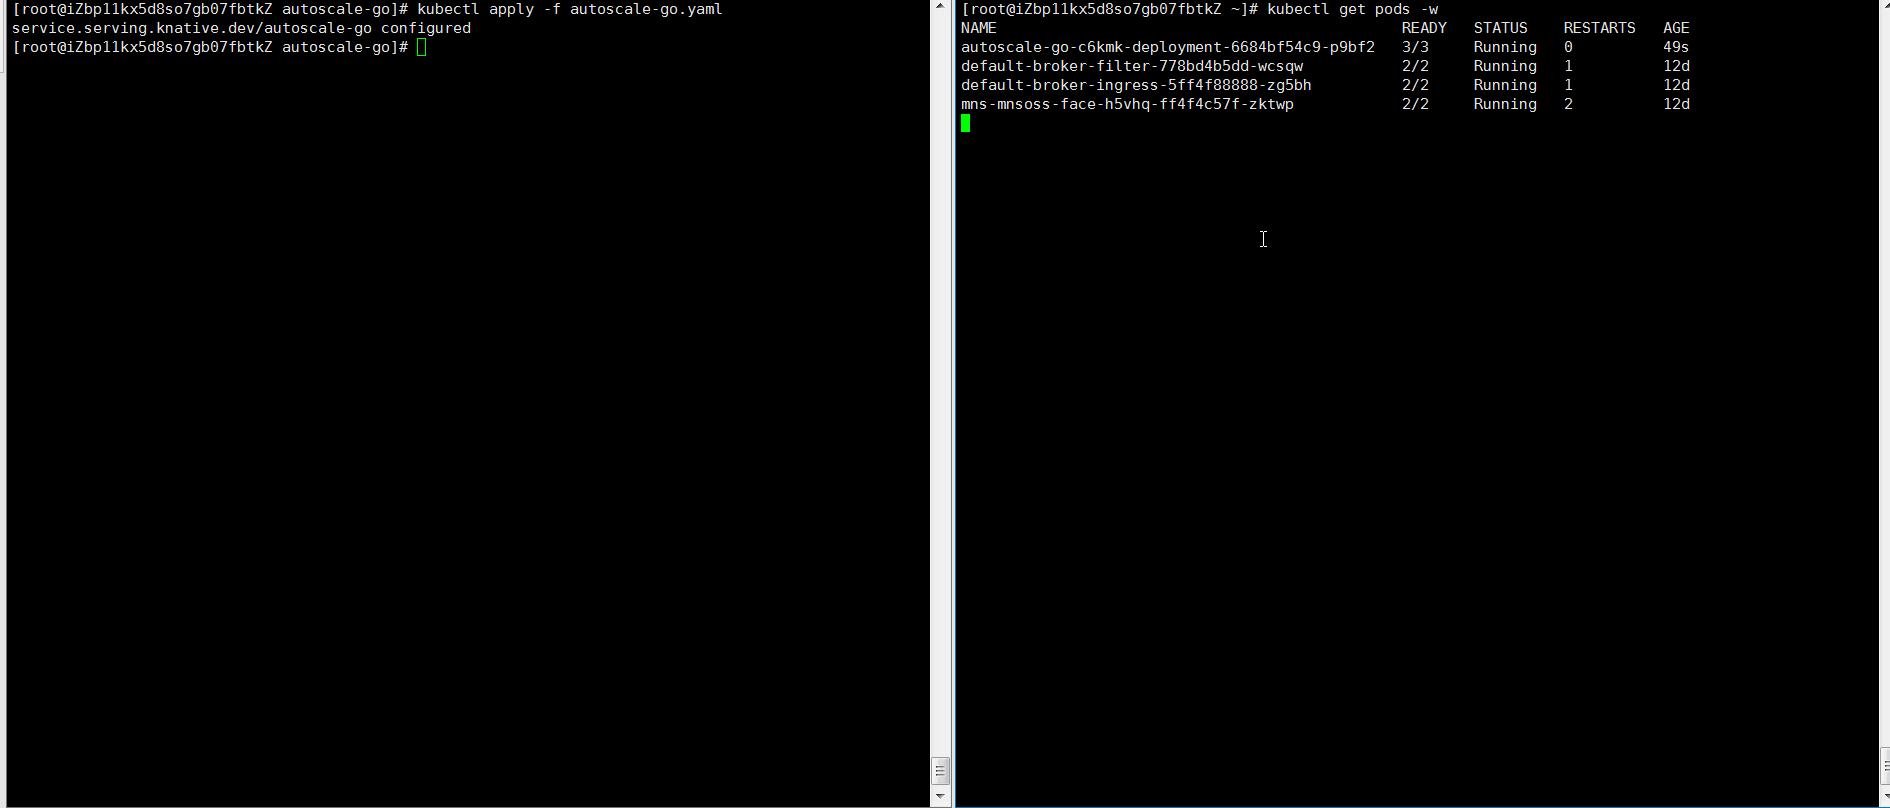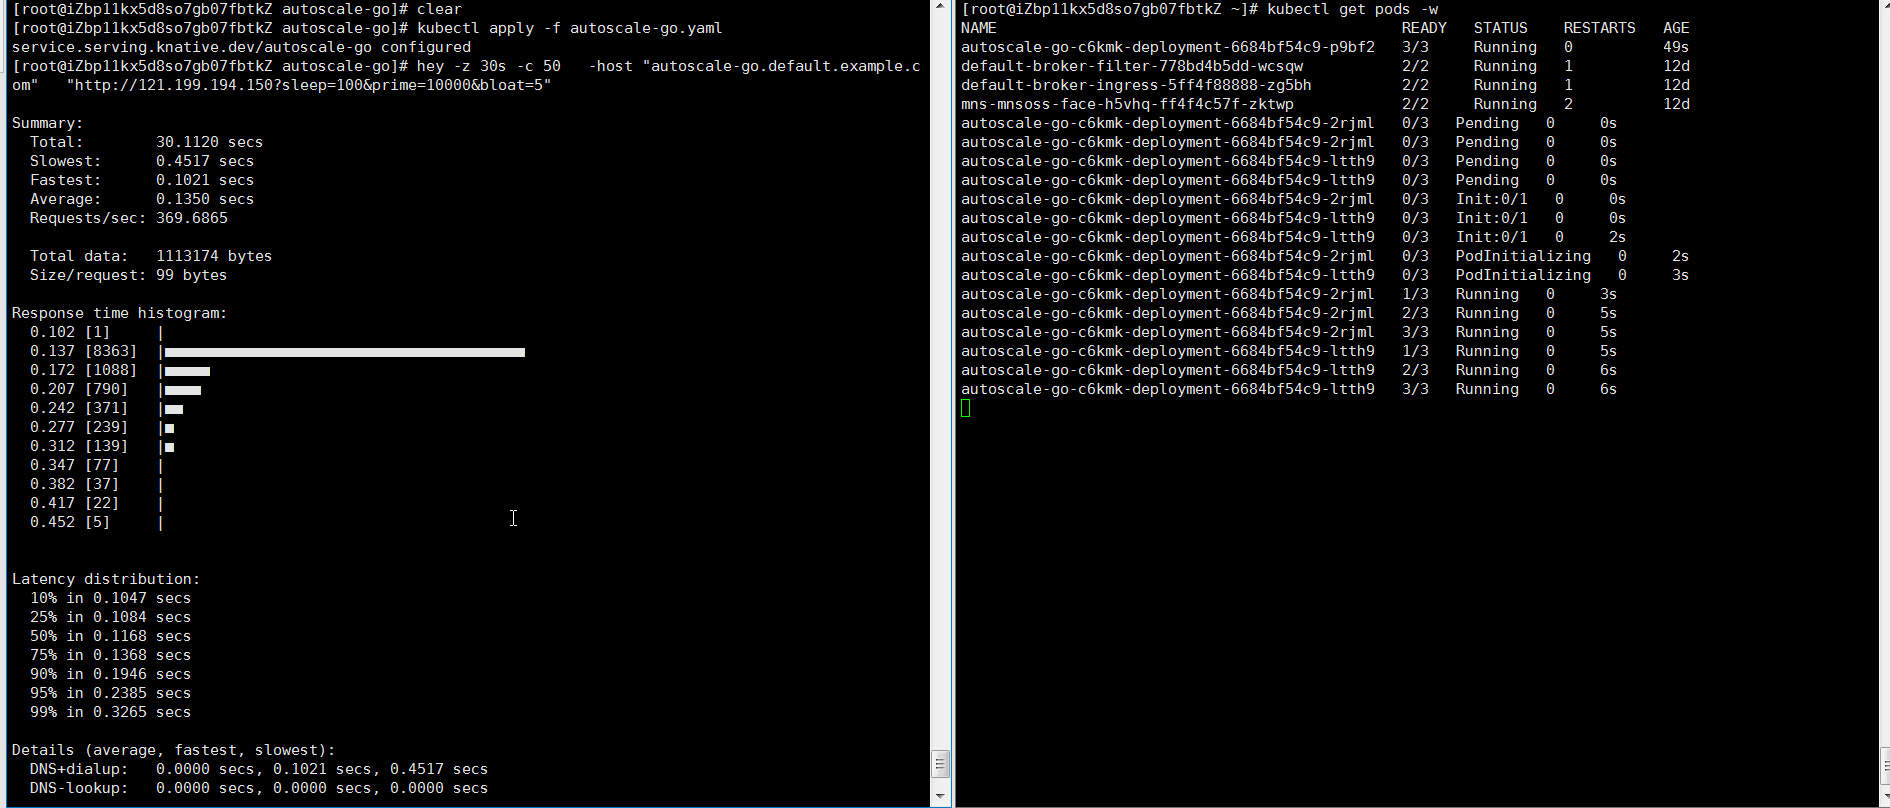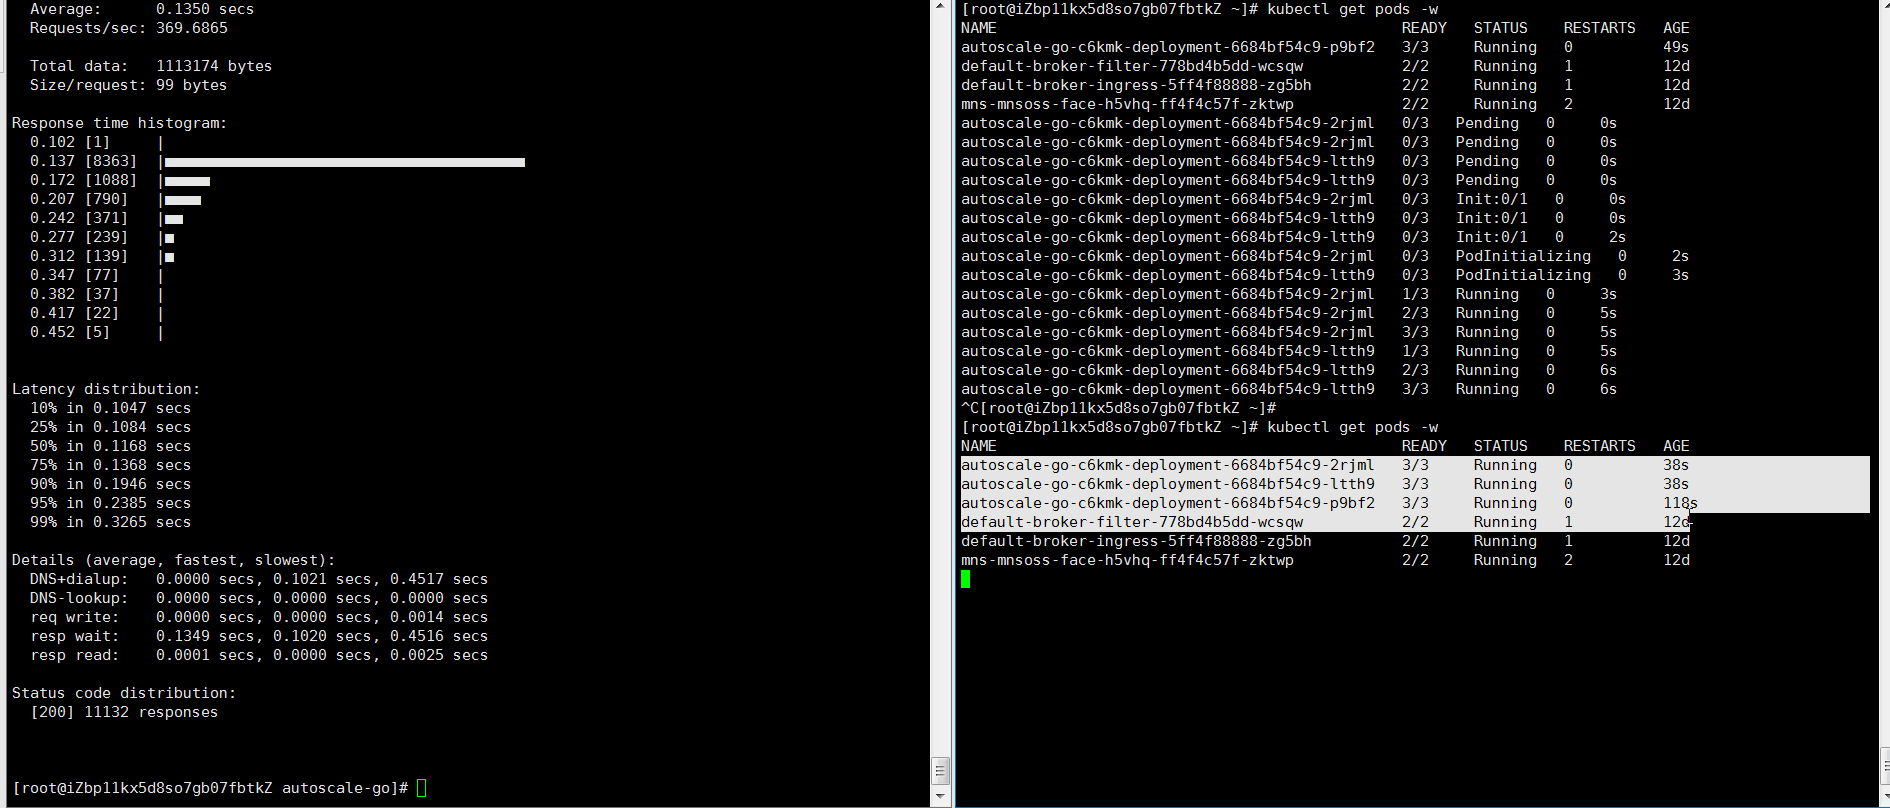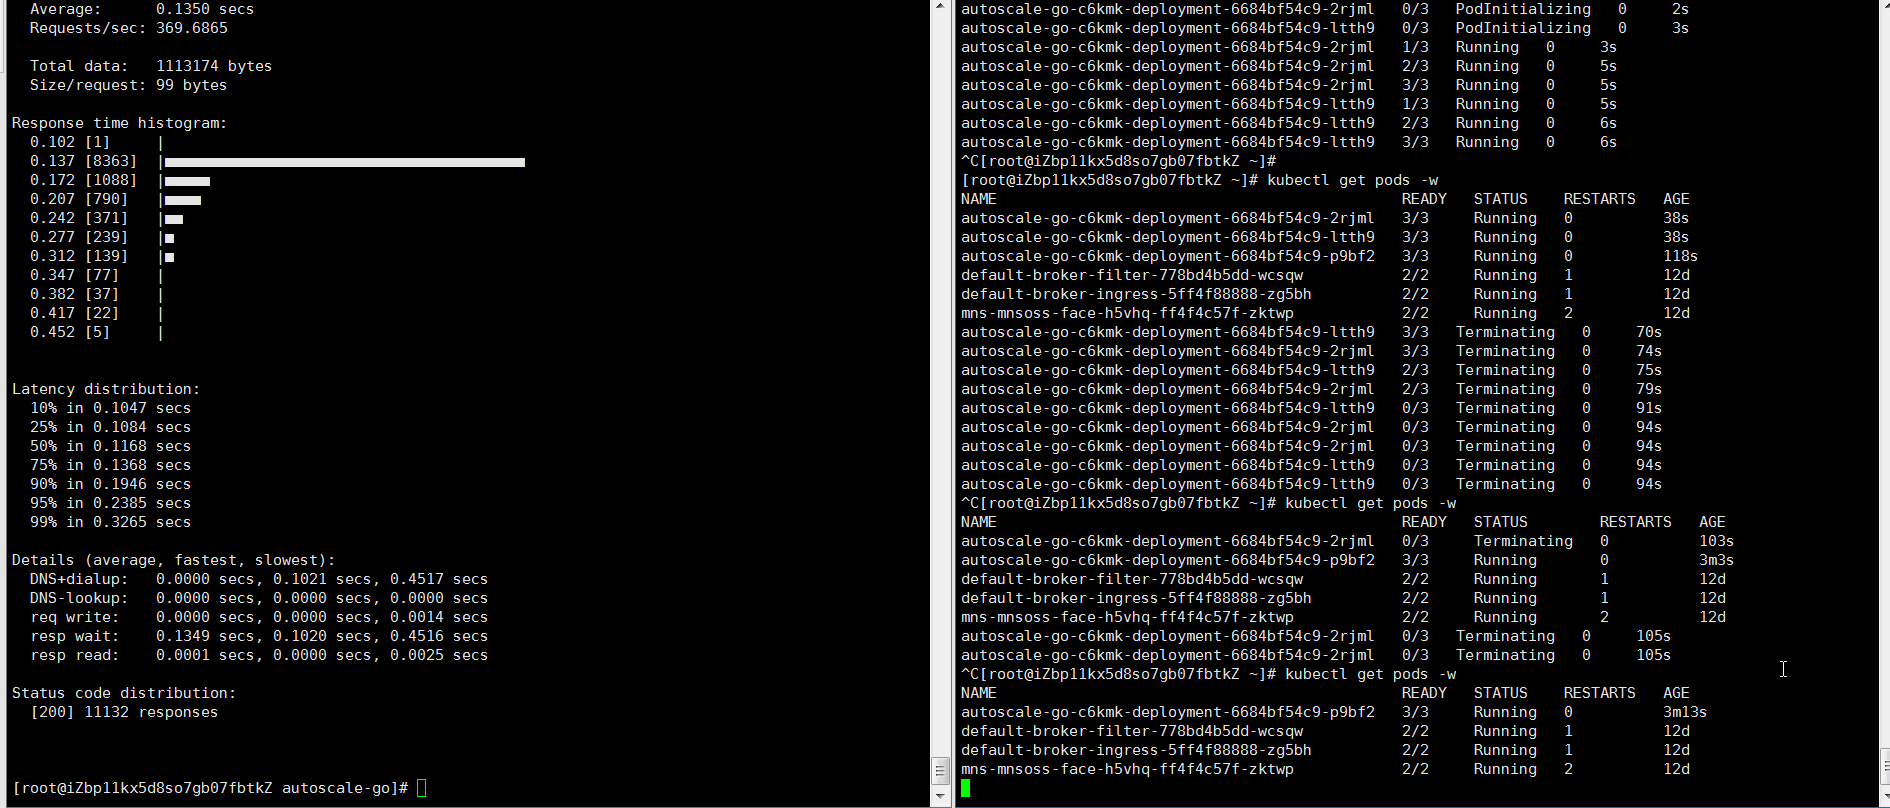
Envoyez 50 requêtes simultanées pendant 30 secondes avec hey :
hey -z 30s -c 50 \
  -host "autoscale-go.default.example.com" \
  "http://121.199.XXX.XXX"  # Replace with your Ingress gateway address
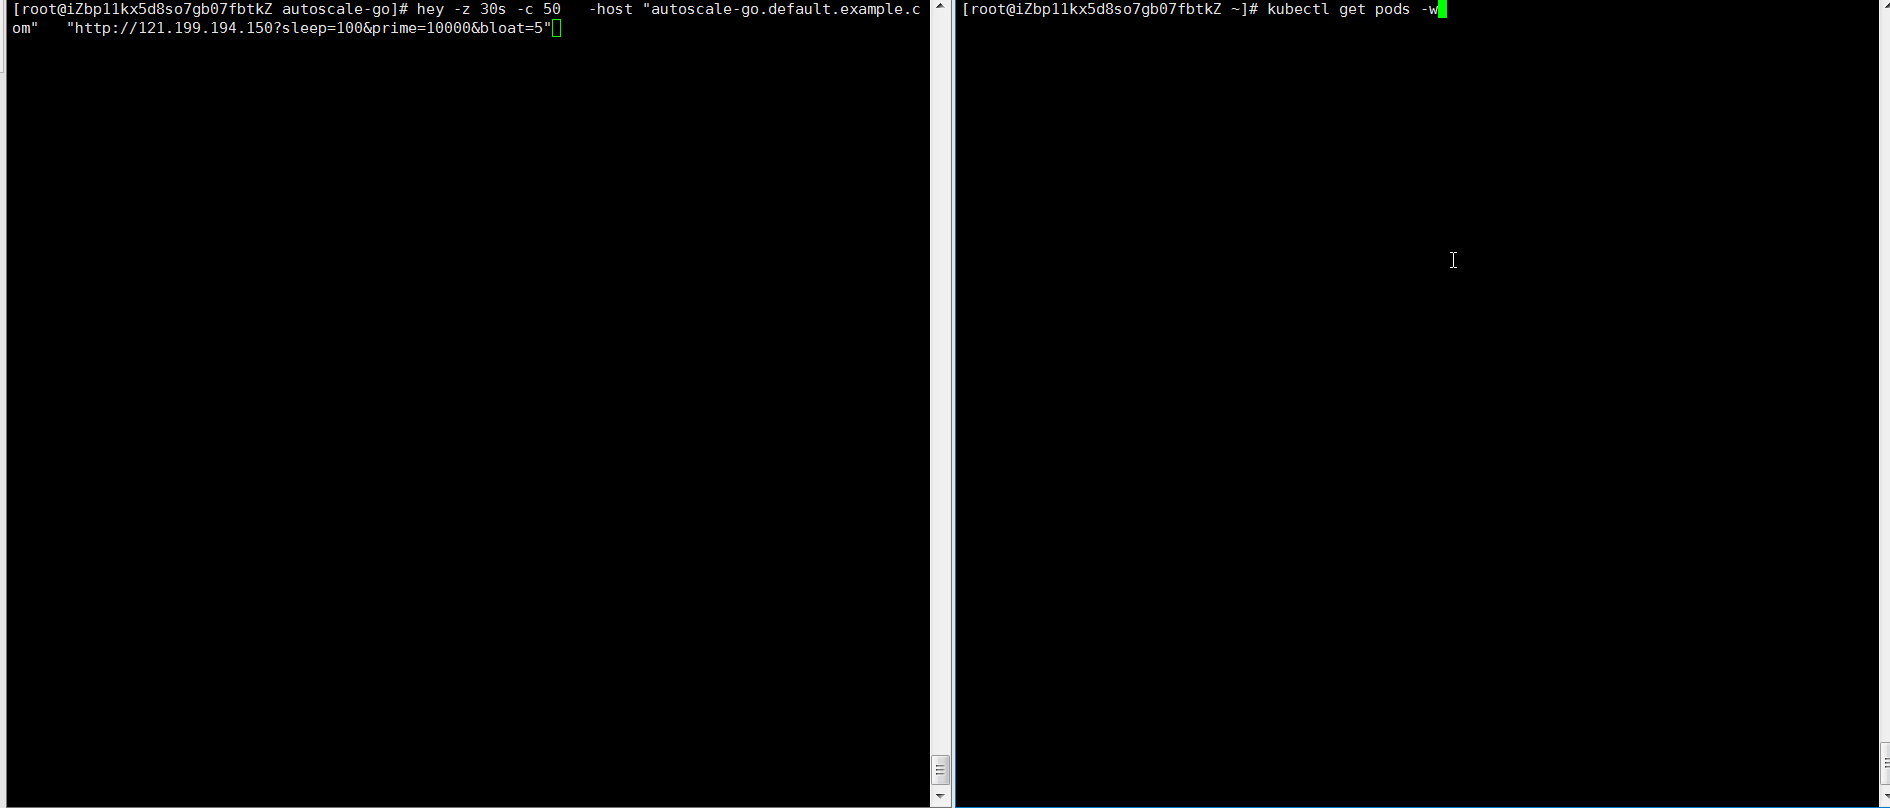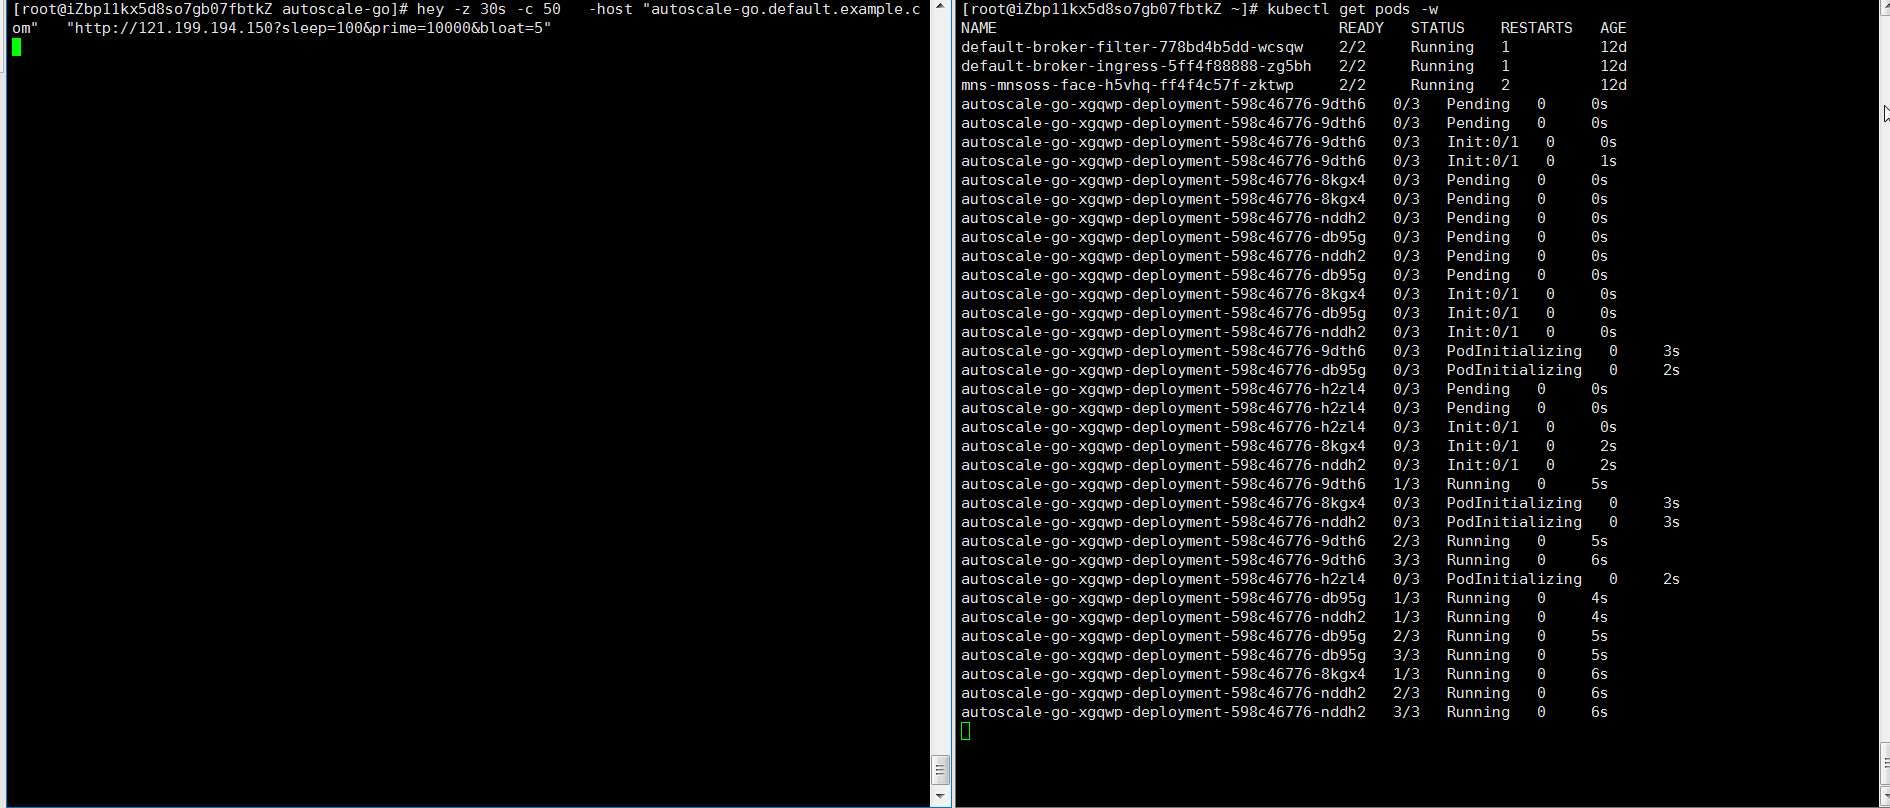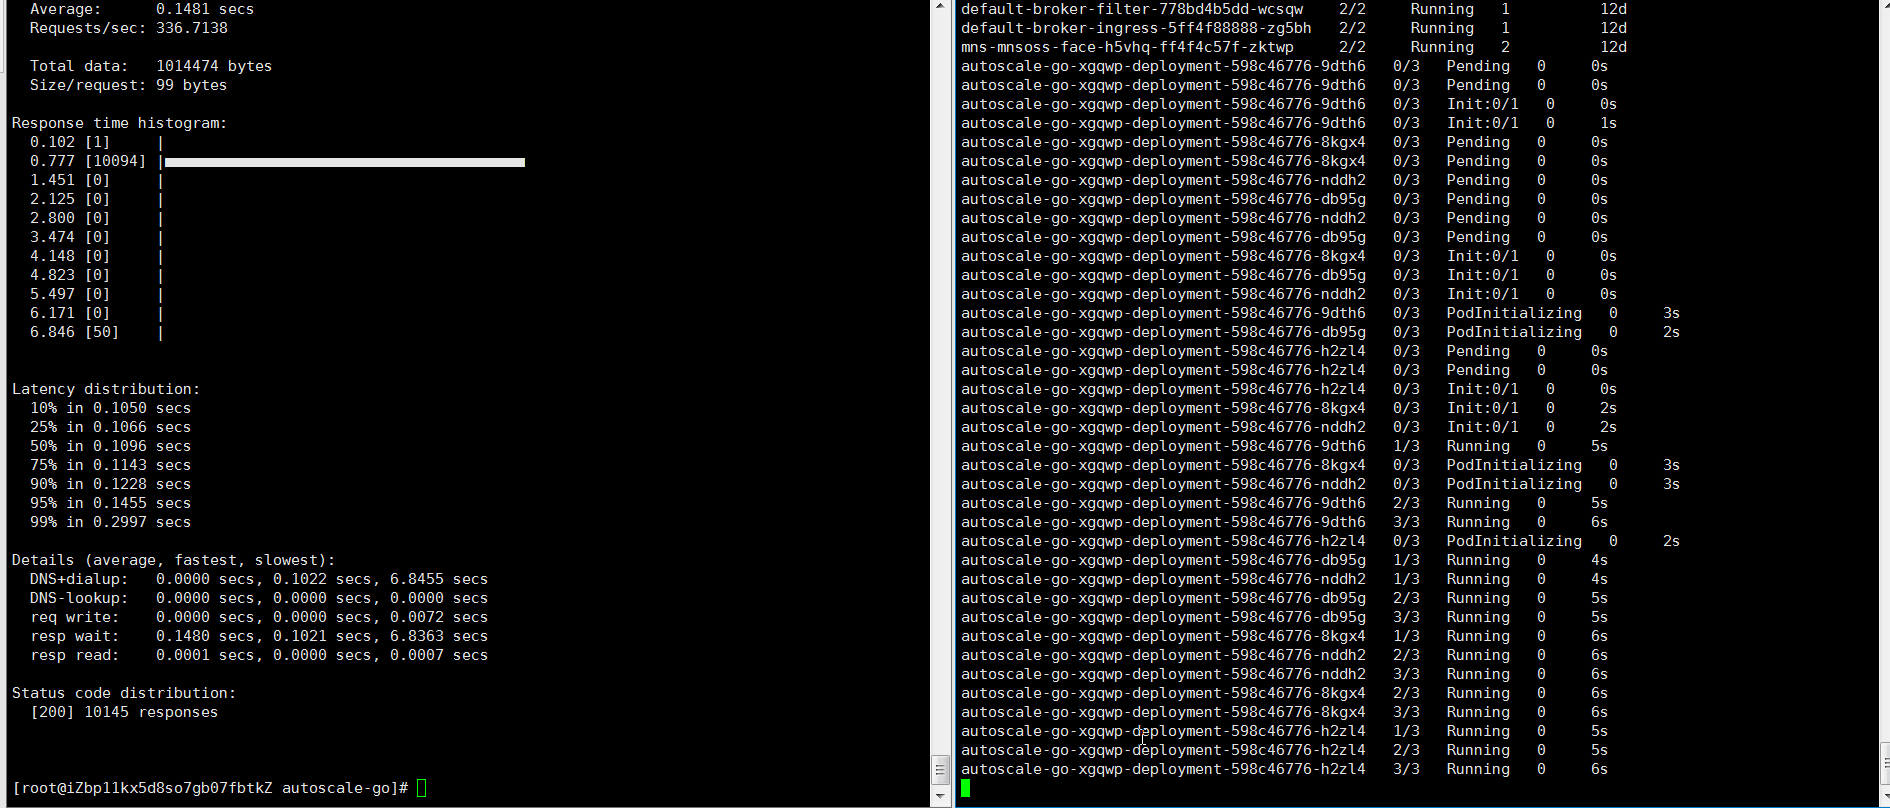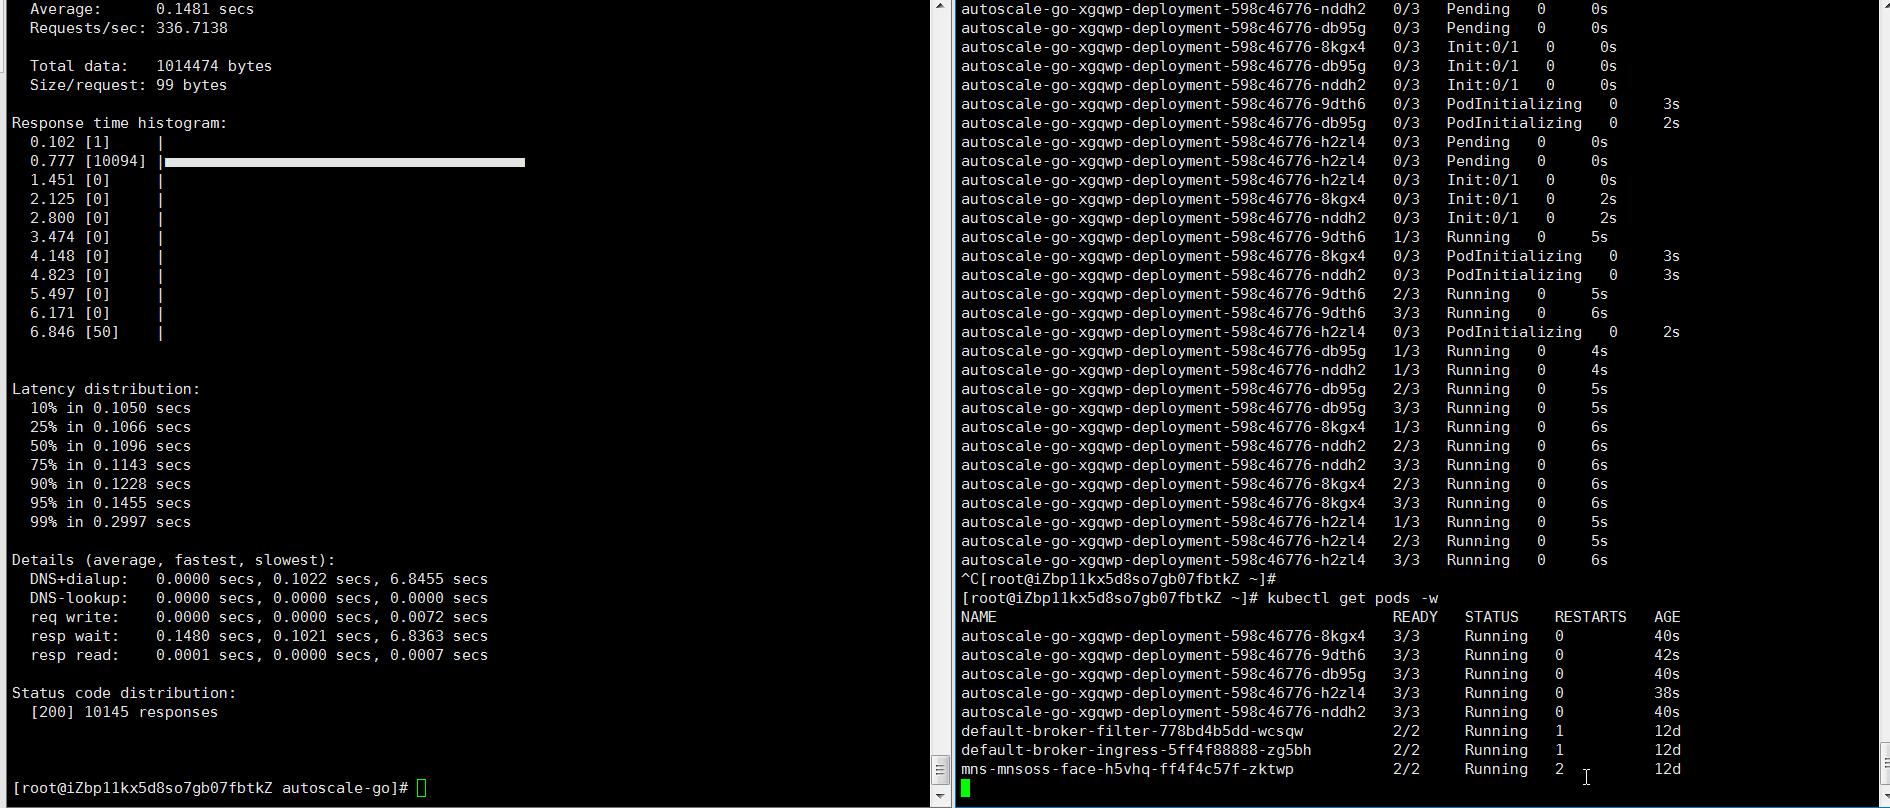
Sortie attendue : le KPA ajoute 5 pods : 50 requêtes simultanées ÷ cible de 10 = 5 pods.
Exemple 2 : Mise à l'échelle avec limites
Ajoutez min-scale: 1 et max-scale: 3 pour maintenir un pod en cours d'exécution et limiter le déploiement à trois pods.
Déployez Knative dans un cluster ACK ou un cluster ACK Serverless.
-
Créez
autoscale-go.yamlavec le contenu suivant :apiVersion: serving.knative.dev/v1 kind: Service metadata: name: autoscale-go namespace: default spec: template: metadata: labels: app: autoscale-go annotations: autoscaling.knative.dev/target: "10" autoscaling.knative.dev/min-scale: "1" # Keep at least 1 pod running autoscaling.knative.dev/max-scale: "3" # Cap at 3 pods spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/autoscale-go:0.1 -
Appliquez le manifeste :
kubectl apply -f autoscale-go.yaml Obtenez l'adresse de la passerelle Ingress (Exemple 1, étape 4).
-
Envoyez 50 requêtes simultanées pendant 30 secondes :
hey -z 30s -c 50 \
  -host "autoscale-go.default.example.com" \
  "http://121.199.XXX.XXX"  # Replace with your Ingress gateway address
Sortie attendue : le KPA passe à 3 pods (maximum) pendant la charge, puis revient à 1 pod (minimum) — aucun démarrage à froid lors de la prochaine requête.