Les limites de CPU empêchent les conteneurs de consommer plus que leur part allouée de temps de calcul. Toutefois, le noyau Linux applique ces limites sur des cycles d'ordonnancement de 100 millisecondes : un conteneur peut ainsi épuiser son quota en un seul cycle, même si sa consommation moyenne sur la dernière seconde semble correcte. Il en résulte une limitation du CPU (throttling) : les threads sont suspendus jusqu'au cycle suivant, ce qui ajoute une latence invisible dans les métriques au niveau de la seconde.
CPU Burst résout ce problème en permettant aux conteneurs d'accumuler le quota de CPU non utilisé et de le dépenser lors de pics de demande de courte durée. ack-koordinator surveille les événements de limitation et ajuste dynamiquement les paramètres de quota cgroup, sans modifier la limite de CPU définie dans la spécification du pod. Cela réduit la latence de queue pour les charges de travail sensibles à la latence, sans qu'il soit nécessaire d'augmenter les limites de CPU de manière générale.
Pour tirer le meilleur parti de cette rubrique, familiarisez-vous avec le planificateur CFS et les politiques de gestion du CPU des nœuds.
Fonctionnement
Le CPU est une ressource partagée dans le temps. Le noyau utilise le Completely Fair Scheduler (CFS) pour allouer le temps CPU selon des cycles d'ordonnancement fixes. La durée du cycle est contrôlée par cpu.cfs_period_us (généralement 100 ms). Le temps CPU qu'un conteneur peut utiliser par cycle est contrôlé par cpu.cfs_quota_us. Un conteneur avec une limite de CPU de 4 obtient 400 ms de temps CPU par cycle de 100 ms.
Le problème réside dans le fait que l'utilisation du CPU est sporadique au niveau de la milliseconde, même lorsque les moyennes à la seconde semblent faibles. Le graphique ci-dessous illustre ce phénomène : la ligne violette montre une utilisation du CPU par seconde restant bien en dessous de 4 cœurs, tandis que la ligne verte montre des pics d'utilisation au niveau de la milliseconde dépassant 4 cœurs à certains moments. Lorsque ces pics épuisent le quota CFS, le noyau limite le conteneur.
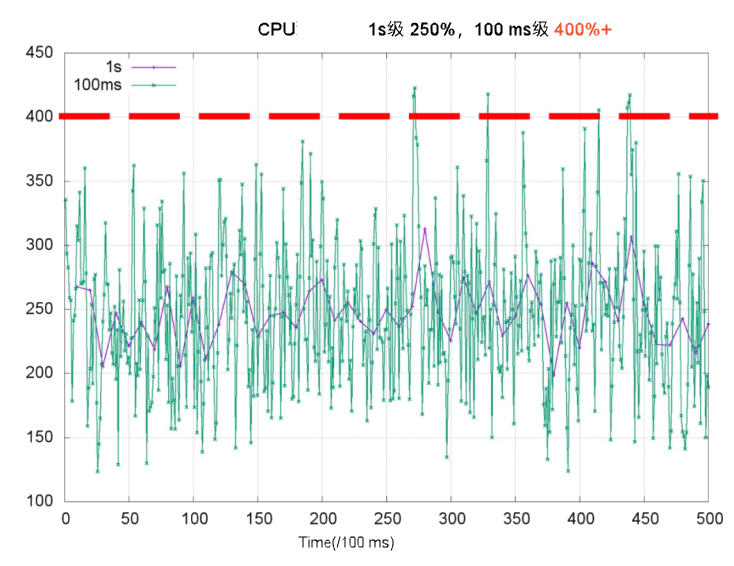
La limitation force les threads à attendre le prochain cycle d'ordonnancement, ce qui augmente le temps de réponse (RT) et provoque une latence de longue traîne. Le tableau ci-dessous montre à quoi cela ressemble concrètement pour un conteneur de service web avec une limite de CPU de 2 sur un nœud de 4 cœurs.
<table> <thead> <tr> <td><p>Même lorsque l'utilisation globale du CPU sur la dernière seconde est faible, la limitation force le thread 2 à attendre le prochain cycle d'ordonnancement pour terminer le traitement de la requête 2. Cela augmente le RT de la requête. C'est une cause fréquente de RT de longue traîne.<img></p></td> <td><p>Après avoir activé CPU Burst, le conteneur accumule le temps CPU inutilisé. Il utilise ce temps pendant les pics. Cela améliore les performances et réduit la latence.<img></p><p></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <tbody></tbody> </table>
Lorsque la demande dépasse ce que le quota accumulé peut couvrir, par exemple lors d'une augmentation soudaine du trafic, ack-koordinator résout le goulot d'étranglement du CPU en quelques secondes tout en maintenant la charge totale du nœud dans des limites sûres.
ack-koordinator ajuste uniquement le paramètre cfs quota dans le cgroup du nœud. Il ne modifie pas le champ de limite de CPU dans la spécification du pod.
Cas d'utilisation
Limitation malgré une faible utilisation moyenne. L'utilisation du CPU reste inférieure à la limite de CPU la plupart du temps, mais de courts pics au sein des cycles d'ordonnancement déclenchent tout de même la limitation. CPU Burst permet au conteneur de dépenser le quota accumulé pendant ces pics, réduisant ainsi la limitation et améliorant la qualité de service.
Démarrage lent dû à une initialisation intensive en CPU. Le conteneur nécessite un CPU élevé lors du démarrage et du chargement, puis se stabilise à un état stationnaire plus faible. CPU Burst permet au conteneur d'utiliser du temps CPU supplémentaire lors du démarrage sans exiger une limite de CPU élevée en permanence.
Facturation
L'installation et l'utilisation d'ack-koordinator sont gratuites. Des frais supplémentaires peuvent s'appliquer dans les deux cas suivants :
Ressources des nœuds de travail : ack-koordinator est un composant non géré. Après l'installation, il s'exécute sur vos nœuds de travail et consomme leurs ressources. Configurez les demandes de ressources pour chaque module lors de l'installation.
Métriques Prometheus : ack-koordinator expose des métriques de profilage des ressources et d'ordonnancement au format Prometheus. Si vous activez l'option Enable Prometheus monitoring metrics for ACK-Koordinator et utilisez Alibaba Cloud Prometheus, ces métriques sont comptées comme des métriques personnalisées et engendrent des frais. Consultez la tarification des instances Prometheus avant d'activer cette option, et utilisez les requêtes d'utilisation pour surveiller la consommation.
Prérequis
Avant de commencer, assurez-vous que :
Vous disposez d'un cluster ACK managé édition Pro exécutant Kubernetes 1.18 ou version ultérieure. Consultez Créer un cluster ACK managé et Mettre à jour manuellement un cluster.
ack-koordinator version 0.8.0 ou ultérieure est installé sur le cluster. Consultez ack-koordinator.
Utilisez Alibaba Cloud Linux comme système d'exploitation des nœuds. Sa prise en charge de CPU Burst au niveau du noyau offre un contrôle plus fin du quota. Consultez Dois-je utiliser Alibaba Cloud Linux pour activer la politique CPU Burst ?.
Activer CPU Burst
CPU Burst peut être activé à trois niveaux. La configuration à un niveau plus spécifique a la priorité : les annotations de pod remplacent les ConfigMaps au niveau du namespace, qui remplacent elles-mêmes le ConfigMap au niveau du cluster.
| Niveau | Méthode | Priorité |
|---|---|---|
| Pod unique | Annotation de pod | La plus élevée |
| Namespace | ConfigMap ack-slo-pod-config |
Moyenne |
| Cluster entier | ConfigMap ack-slo-config |
La plus basse |
Activer pour un pod spécifique
Ajoutez l'annotation sous metadata dans le YAML du pod. Pour un Deployment ou une autre charge de travail, définissez l'annotation dans template.metadata à la place.
annotations:
  # Enable CPU Burst for this pod.
  koordinator.sh/cpuBurst: '{"policy": "auto"}'
  # Disable CPU Burst for this pod.
  koordinator.sh/cpuBurst: '{"policy": "none"}'
Activer pour un cluster entier
-
Créez
configmap.yamlavec le contenu suivant.apiVersion: v1 data: cpu-burst-config: '{"clusterStrategy": {"policy": "auto"}}' #cpu-burst-config: '{"clusterStrategy": {"policy": "cpuBurstOnly"}}' #cpu-burst-config: '{"clusterStrategy": {"policy": "none"}}' kind: ConfigMap metadata: name: ack-slo-config namespace: kube-system -
Appliquez le ConfigMap. Utilisez PATCH si
ack-slo-configexiste déjà dans le namespacekube-systempour éviter d'écraser d'autres paramètres.Si le ConfigMap existe : `
bash kubectl patch cm -n kube-system ack-slo-config --patch "$(cat configmap.yaml)"```S'il n'existe pas : `
bash kubectl apply -f configmap.yaml```
Activer pour un namespace spécifique
-
Créez
configmap.yamlavec le contenu suivant.apiVersion: v1 kind: ConfigMap metadata: name: ack-slo-pod-config namespace: koordinator-system # Create this namespace manually before first use. data: # Enable or disable CPU Burst for selected namespaces. cpu-burst: | { "enabledNamespaces": ["allowed-ns"], "disabledNamespaces": ["blocked-ns"] } # Enables CPU Burst for all pods in the allowed-ns namespace. Policy is auto. # Disables CPU Burst for all pods in the blocked-ns namespace. Policy is none. -
Appliquez le ConfigMap. Utilisez PATCH si
ack-slo-pod-configexiste déjà dans le namespacekoordinator-systempour éviter d'écraser d'autres paramètres.Si le ConfigMap existe : `
bash kubectl patch cm -n koordinator-system ack-slo-pod-config --patch "$(cat configmap.yaml)"```S'il n'existe pas : `
bash kubectl apply -f configmap.yaml```
Vérifier avec un test de charge
Cet exemple utilise un pod Apache HTTP Server pour démontrer que CPU Burst réduit la latence d'accès.
-
Créez
apache-demo.yamlavec le contenu suivant. L'annotation active CPU Burst pour ce pod.apiVersion: v1 kind: Pod metadata: name: apache-demo annotations: koordinator.sh/cpuBurst: '{"policy": "auto"}' # Enable CPU Burst. spec: containers: - command: - httpd - -D - FOREGROUND image: registry.cn-zhangjiakou.aliyuncs.com/acs/apache-2-4-51-for-slo-test:v0.1 imagePullPolicy: Always name: apache resources: limits: cpu: "4" memory: 10Gi requests: cpu: "4" memory: 10Gi nodeName: $nodeName # Replace with the actual node name. hostNetwork: False restartPolicy: Never schedulerName: default-scheduler -
Déployez le serveur Apache HTTP.
kubectl apply -f apache-demo.yaml -
Exécutez un test de charge à l'aide de wrk2. Remplacez
$target_ip_addresspar l'adresse IP du pod Apache.# Download and extract the open-source wrk2 tool. See https://github.com/giltene/wrk2. # The Apache image has Gzip compression enabled to simulate server-side request processing. # Adjust QPS pressure by changing the -R parameter. ./wrk -H "Accept-Encoding: deflate, gzip" -t 2 -c 12 -d 120 --latency --timeout 2s -R 24 http://$target_ip_address:8010/static/file.1m.test
Résultats
Les tableaux ci-dessous comparent le temps de réponse p99, le ratio de limitation du CPU et l'utilisation moyenne du CPU du pod, avec et sans CPU Burst, sur Alibaba Cloud Linux et CentOS.
All disabled : Politique CPU Burst définie sur
none.All enabled : Politique CPU Burst définie sur
auto.
Les valeurs ci-dessous sont théoriques. Les résultats réels dépendent de votre environnement.
<table> <thead> <tr> <td><p><b>Alibaba Cloud Linux</b></p></td> <td><p><b>All disabled</b></p></td> <td><p><b>All enabled</b></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p>apache RT-p99</p></td> <td><p>107,37 ms</p></td> <td><p>67,18 ms (-37,4 %)</p></td> </tr> <tr> <td><p>CPU Throttled Ratio</p></td> <td><p>33,3 %</p></td> <td><p>0 %</p></td> </tr> <tr> <td><p>Average Pod CPU utilization</p></td> <td><p>31,8 %</p></td> <td><p>32,6 %</p></td> </tr> </tbody> </table><table> <thead> <tr> <td><p><b>CentOS</b></p></td> <td><p><b>All disabled</b></p></td> <td><p><b>All enabled</b></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p>apache RT-p99</p></td> <td><p>111,69 ms</p></td> <td><p>71,30 ms (-36,2 %)</p></td> </tr> <tr> <td><p>CPU Throttled Ratio</p></td> <td><p>33 %</p></td> <td><p>0 %</p></td> </tr> <tr> <td><p>Average Pod CPU utilization</p></td> <td><p>32,5 %</p></td> <td><p>33,8 %</p></td> </tr> </tbody> </table>
L'activation de CPU Burst réduit le temps de réponse p99 d'environ 37 % et ramène le ratio de limitation du CPU à 0 %, avec une variation négligeable de l'utilisation moyenne du CPU.
Configuration avancée
Configurez les paramètres avancés dans une annotation de pod ou un ConfigMap. Les annotations de pod ont la priorité, suivies des ConfigMaps au niveau du namespace, puis du ConfigMap au niveau du cluster.
# Example ConfigMap ack-slo-config.
data:
  cpu-burst-config: |
    {
      "clusterStrategy": {
        "policy": "auto",
        "cpuBurstPercent": 1000,
        "cfsQuotaBurstPercent": 300,
        "sharePoolThresholdPercent": 50,
        "cfsQuotaBurstPeriodSeconds": -1
      }
    }

# Example pod annotation.
koordinator.sh/cpuBurst: '{"policy": "auto", "cpuBurstPercent": 1000, "cfsQuotaBurstPercent": 300, "cfsQuotaBurstPeriodSeconds": -1}'Les colonnes Annotation et ConfigMap indiquent si chaque paramètre prend en charge la configuration via une annotation de pod ou un ConfigMap.  signifie pris en charge.
 signifie non pris en charge.
<table> <thead> <tr> <td><p><b>Paramètre</b></p></td> <td><p><b>Type</b></p></td> <td><p><b>Description</b></p></td> <td><p><b>Annotation</b></p></td> <td><p><b>ConfigMap</b></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p><code>policy</code></p></td> <td><p>string</p></td> <td> <ul> <li><p><code>none</code> (par défaut) : Désactive CPU Burst. Tous les paramètres associés sont réinitialisés à leurs valeurs initiales.</p></li> <li><p><code>cpuBurstOnly</code> : Active uniquement l'élasticité CPU Burst au niveau du noyau Alibaba Cloud Linux.</p></li> <li><p><code>cfsQuotaBurstOnly</code> : Active uniquement l'élasticité du quota CFS. Fonctionne avec toutes les versions du noyau.</p></li> <li><p><code>auto</code> : Active automatiquement les deux élasticités — fonctionnalités du noyau Alibaba Cloud Linux et élasticité du quota CFS.</p></li> </ul></td> <td><p><img></p></td> <td><p><img></p></td> </tr> <tr> <td><p><code>cpuBurstPercent</code></p></td> <td><p>int</p></td> <td><p>Par défaut : <code>1000</code>. Unité : pourcentage.</p><p>Pour l'élasticité CPU Burst au niveau du noyau Alibaba Cloud Linux, cela définit l'amplification de CPU Burst au-delà de la limite de CPU. Correspond au paramètre cgroup <code>cpu.cfs_burst_us</code>. Pour plus de détails, consultez <a href="https://www.alibabacloud.com/help/en/document_detail/306980.html#task-2108025">Activer CPU Burst à l'aide de l'interface cgroup v1</a>.</p><p>Par exemple, avec le paramètre par défaut, <code>CPU Limit = 1</code> définit <code>cpu.cfs_quota_us</code> à 100 000. Ensuite, <code>cpu.cfs_burst_us</code> devient 1 000 000, soit une augmentation de 10 fois.</p></td> <td><p><img></p></td> <td><p><img></p></td> </tr> <tr> <td><p><code>cfsQuotaBurstPercent</code></p></td> <td><p>int</p></td> <td><p>Par défaut : <code>300</code>. Unité : pourcentage.</p><p>Lorsque l'élasticité du quota CFS est activée, cela définit l'augmentation maximale autorisée pour le paramètre cgroup <code>cpu.cfs_quota_us</code>. La valeur par défaut est 3x.</p></td> <td><p><img></p></td> <td><p><img></p></td> </tr> <tr> <td><p><code>cfsQuotaBurstPeriodSeconds</code></p></td> <td><p>int</p></td> <td><p>Par défaut : <code>-1</code>. Unité : secondes. -1 signifie illimité.</p><p>Lorsque l'élasticité du quota CFS est activée, cela définit la durée pendant laquelle un pod peut consommer du CPU avec le quota augmenté (<code>cfsQuotaBurstPercent</code>). Après cette période, le <code>cpu.cfs_quota_us</code> du pod est réinitialisé à sa valeur d'origine. Les autres pods ne sont pas affectés.</p></td> <td><p><img></p></td> <td><p><img></p></td> </tr> <tr> <td><p><code>sharePoolThresholdPercent</code></p></td> <td><p>int</p></td> <td><p>Par défaut : <code>50</code>. Unité : pourcentage.</p><p>Lorsque l'élasticité du quota CFS est activée, cela définit le seuil d'utilisation sécurisée du CPU pour le nœud. Si l'utilisation dépasse ce seuil, tous les pods avec un <code>cpu.cfs_quota_us</code> augmenté sont réinitialisés à leurs valeurs d'origine.</p></td> <td><p><img></p></td> <td><p><img></p></td> </tr> </tbody> </table>
Lorsque
policyest défini surcfsQuotaBurstOnlyouauto,cpu.cfs_quota_uschange dynamiquement en fonction des événements de limitation.Pendant les tests de stress, surveillez l'utilisation du CPU du pod ou définissez
policysurcpuBurstOnlyounonepour désactiver l'ajustement automatique du quota CFS. Cela maintient la stabilité de l'élasticité en production.
FAQ
J'ai utilisé CPU Burst avec l'ancien protocole ack-slo-manager. Cela fonctionne-t-il toujours après la mise à niveau vers ack-koordinator ?
Oui. L'ancienne clé d'annotation était alibabacloud.com/cpuBurst. ack-koordinator prend entièrement en charge cet ancien protocole, ce qui rend les mises à niveau transparentes.
La période de compatibilité d'ack-koordinator pour la version antérieure du protocole a pris fin le 30 juillet 2023. Mettez à niveau les paramètres de ressources de la version antérieure du protocole vers la dernière version.
ack-koordinator est compatible avec les versions de protocole suivantes.
<table> <thead> <tr> <td><p><span>ack-koordinator</span><b> version</b></p></td> <td><p><b>Protocole alibabacloud.com</b></p></td> <td><p><b>Protocole koordinator.sh</b></p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p>≥0.2.0</p></td> <td><p>Pris en charge</p></td> <td><p>Non pris en charge</p></td> </tr> <tr> <td><p>≥0.8.0</p></td> <td><p>Pris en charge</p></td> <td><p>Pris en charge</p></td> </tr> </tbody> </table>
Pourquoi la limitation du CPU se produit-elle toujours après l'activation de CPU Burst ?
La cause la plus fréquente est une erreur de syntaxe dans la configuration qui empêche la politique de prendre effet. Vérifiez votre annotation ou ConfigMap par rapport aux exemples de la section Configuration avancée.
Si la configuration est valide, la limitation peut toujours se produire lorsque la demande en CPU atteint le plafond cfsQuotaBurstPercent. Ajustez les valeurs de demande et de limite de CPU pour mieux correspondre aux besoins réels de la charge de travail.
Deux autres facteurs à prendre en compte :
cpu.cfs_quota_usn'est mis à jour qu'après qu'ack-koordinator a détecté un événement de limitation, il y a donc un léger délai.cpu.cfs_burst_us, en revanche, est appliqué immédiatement et répond plus rapidement. Pour de meilleurs résultats, utilisez Alibaba Cloud Linux.Lorsque l'utilisation globale du CPU du nœud dépasse
sharePoolThresholdPercent, ack-koordinator réinitialisecpu.cfs_quota_uspour tous les pods afin d'éviter qu'un seul pod ne cause des interférences. DéfinissezsharePoolThresholdPercentsur une valeur qui reflète les modèles de charge réels de votre nœud.
Dois-je utiliser Alibaba Cloud Linux pour activer la politique CPU Burst ?
CPU Burst fonctionne sur tous les noyaux Alibaba Cloud Linux et CentOS. Alibaba Cloud Linux est recommandé : sa prise en charge de cpu.cfs_burst_us au niveau du noyau permet à ack-koordinator de fournir une élasticité CPU plus fine que le simple ajustement du quota CFS. Pour plus de détails, consultez Activer CPU Burst à l'aide de l'interface cgroup v1.
Après avoir activé CPU Burst, pourquoi mon application signale-t-elle un nombre de threads différent ?
ack-koordinator ajuste dynamiquement cpu.cfs_quota_us—le quota de temps CPU du conteneur pour chaque cycle d'ordonnancement—en réponse aux variations de charge. De nombreuses applications, y compris celles utilisant Runtime.getRuntime().availableProcessors() de Java, lisent cpu.cfs_quota_us pour calculer les cœurs CPU disponibles. Lorsque le quota change, le nombre de cœurs signalé change également, ce qui entraîne des fluctuations de la taille des pools de threads et d'autres paramètres dépendant du quota.
Pour résoudre ce problème, configurez votre application afin qu'elle lise la valeur fixe limits.cpu de la spécification du pod.
-
Injectez
limits.cpuen tant que variable d'environnement à l'aide deresourceFieldRef.env: - name: CPU_LIMIT valueFrom: resourceFieldRef: resource: limits.cpu Mettez à jour la logique de démarrage de votre application pour lire
CPU_LIMITlors du calcul et de la définition de la taille du pool de threads. Cela permet de maintenir un nombre de threads stable, indépendamment des ajustements du quota CFS effectués par ack-koordinator.