Cette rubrique présente la solution de partage de GPU proposée par Alibaba Cloud, décrit les avantages de l'édition Professionnelle du partage de GPU et compare les fonctionnalités et les cas d'utilisation des éditions Basique et Professionnelle. Elle vous aide à mieux comprendre et utiliser le partage de GPU.
Contexte
Le partage de GPU permet d'exécuter plusieurs conteneurs sur le même périphérique GPU. Depuis qu'Alibaba Cloud a rendu open source le partage de GPU via Container Service for Kubernetes (ACK), vous pouvez déployer un framework de partage de GPU sur des clusters de conteneurs, que ce soit sur Alibaba Cloud ou dans des centres de données sur site. Plusieurs conteneurs peuvent ainsi partager le même périphérique GPU, ce qui réduit les coûts d'utilisation.
Toutefois, outre l'efficacité économique, il est essentiel de garantir la stabilité des conteneurs s'exécutant sur le GPU. L'isolation des ressources GPU allouées à chaque conteneur permet de limiter l'utilisation des ressources par chacun d'eux sur un même GPU et d'éviter les interférences mutuelles dues à une surconsommation. Pour résoudre ce problème, l'industrie informatique propose diverses solutions, telles que NVIDIA vGPU, Multi-Process Service (MPS) et vCUDA, afin d'affiner la gestion de l'utilisation du GPU.
Pour répondre à ces besoins, ACK intègre une solution de partage de GPU. Celle-ci permet non seulement à plusieurs tâches de partager un seul GPU, mais assure également l'isolation de la mémoire et le partitionnement de la puissance de calcul GPU pour différentes applications s'exécutant sur le même GPU.
Fonctionnalités et avantages
La solution de partage de GPU s'appuie sur le pilote kernel serveur développé par Alibaba Cloud pour optimiser l'utilisation des pilotes sous-jacents des GPU NVIDIA. Le partage de GPU offre les fonctionnalités suivantes :
Haute compatibilité : le partage de GPU est compatible avec les solutions open source standard, telles que Kubernetes et NVIDIA Docker.
Facilité d'utilisation : le partage de GPU offre une excellente expérience utilisateur. Pour remplacer une bibliothèque Compute Unified Device Architecture (CUDA) d'une application d'IA, nul besoin de recompiler l'application ni de créer une nouvelle image de conteneur.
Stabilité : le partage de GPU assure une stabilité opérationnelle sous-jacente sur les GPU NVIDIA. Les appels API aux bibliothèques CUDA et certaines opérations API privées sur CUDA Deep Neural Network (cuDNN) sont complexes à gérer.
Isolation des ressources : le partage de GPU garantit que la mémoire GPU et la puissance de calcul allouées n'interfèrent pas entre elles.
Le partage de GPU propose une solution rentable, fiable et conviviale permettant d'activer la planification GPU et l'isolation de la mémoire.
Avantage | Description |
Prend en charge le partage, la planification et l'isolation de la mémoire GPU. |
|
Prend en charge des politiques flexibles de partage de GPU et d'isolation de la mémoire. |
|
Prend en charge une surveillance complète des ressources GPU. | Prend en charge la surveillance des GPU dédiés et des GPU partagés. |
Gratuit | Vous devez activer la suite AI cloud-native avant d'utiliser le partage de GPU. Depuis le 6 juin 2024 à 00:00:00 (UTC+8), la suite Cloud Native AI Suite est entièrement gratuite. |
Remarques sur l'utilisation
Le partage de GPU prend uniquement en charge les clusters ACK Pro. Pour plus d'informations sur l'installation et l'utilisation du partage de GPU, consultez les rubriques suivantes :
Vous pouvez également exploiter les fonctionnalités avancées suivantes du partage de GPU :
Activer le partage multi-GPU avec la planification de GPU partagé
Configurer la politique de sélection de GPU pour le partage de GPU
Configurer le partage de GPU sans isolation de la mémoire GPU
Désactiver la fonctionnalité d'isolation de la mémoire de cGPU
Configurer une politique de planification cGPU pour le partage de GPU
Termes
Mode partagé et mode exclusif
Le mode partagé permet à plusieurs pods de partager un seul GPU, comme illustré dans la figure suivante. 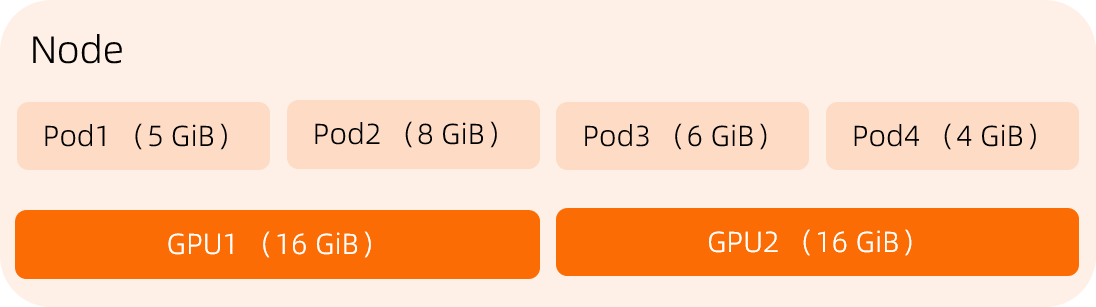
Le mode exclusif permet à un pod d'occuper exclusivement un ou plusieurs GPU, comme illustré dans la figure suivante. 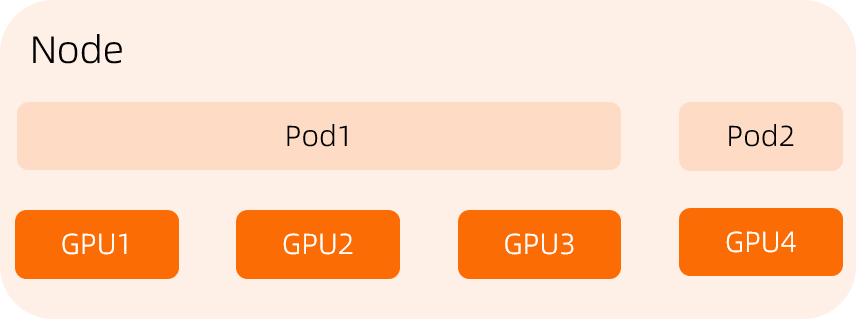
Isolation de la mémoire GPU
Le partage de GPU garantit uniquement que plusieurs pods s'exécutent sur un seul GPU, mais n'empêche pas la contention des ressources entre les pods lorsque l'isolation de la mémoire GPU est désactivée. La section suivante illustre ce cas.
Le pod 1 demande 5 GiB de mémoire GPU et le pod 2 demande 10 GiB de mémoire GPU. Lorsque l'isolation de la mémoire GPU est désactivée, le pod 1 peut utiliser jusqu'à 10 GiB de mémoire GPU, empiétant ainsi sur les 5 GiB demandés par le pod 2. Par conséquent, le pod 2 ne parvient pas à démarrer en raison d'un manque de mémoire GPU. Une fois l'isolation de la mémoire GPU activée, si le pod 1 tente d'utiliser une quantité de mémoire GPU supérieure à celle demandée, le module d'isolation force l'échec du pod 1. 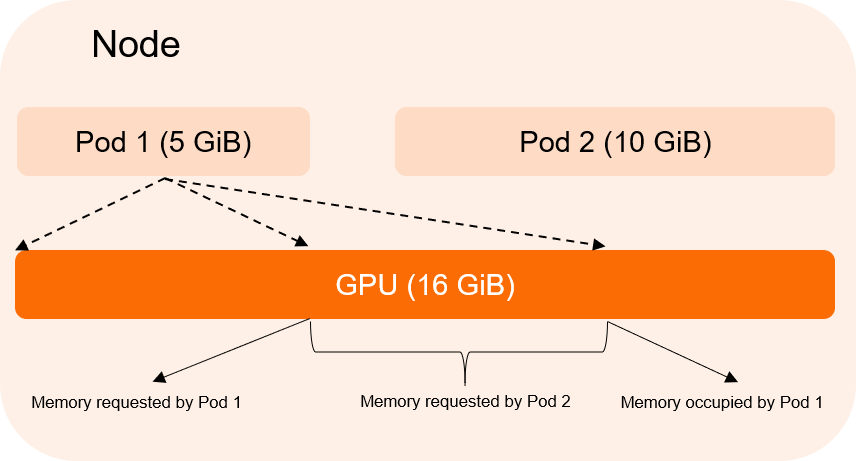
Politiques de planification GPU : binpack et spread
Si un nœud disposant de la fonctionnalité de partage de GPU activée possède plusieurs GPU, vous pouvez choisir l'une des politiques de sélection de GPU suivantes :
Binpack : par défaut, la politique binpack est appliquée. Le planificateur alloue toutes les ressources d'un GPU aux pods avant de passer à un autre GPU. Cela permet d'éviter la fragmentation des GPU.
Spread : le planificateur tente de répartir les pods sur différents GPU du nœud afin de prévenir les interruptions de service en cas de défaillance d'un GPU.
Dans cet exemple, un nœud dispose de deux GPU. Chaque GPU offre 15 GiB de mémoire. Pod1 demande 2 GiB de mémoire et Pod2 demande 3 GiB de mémoire.

Partage de GPU unique et partage de GPU multiple
Partage de GPU unique : un pod peut demander des ressources GPU allouées par un seul GPU.
Partage de GPU multiple : un pod peut demander des ressources GPU allouées uniformément par plusieurs GPU.
