1. ¿Qué sucede durante las operaciones de Doc si no se especifica el parámetro Partition?
Cada colección tiene una partición default que se crea automáticamente y no se puede eliminar. Las operaciones de Doc sin una partición especificada utilizan default. Por ejemplo, retrieving a Doc sin especificar una partición solo busca en default, no en otras particiones.
2. Operaciones de Insert Doc, Update Doc y Insert or Update Doc: ¿cuáles son las diferencias?
Insert Doc: falla si el ID de Doc ya existe. El Doc existente no se sobrescribe.
Update Doc: sobrescribe un Doc existente. Falla si el ID de Doc no existe.
Insert or Update Doc: actualiza el Doc si el ID existe; inserta un nuevo Doc si no existe.
3. ¿Cómo se vacía una colección?
No se puede vaciar una colección directamente. En su lugar, delete the Collection y create a new Collection.
4. ¿Cómo se utiliza la función asíncrona para las operaciones de Doc?
Insert Doc, Update Doc, Insert or Update Doc, Retrieve Doc, Delete Doc y Get Doc admiten la ejecución asíncrona. Establezca async_req=True:
# Asynchronously write 1,000 times. Dimension = 20000, batch size = 8.
batch_size = 8
loop = 1000
start = time.time()

async_results = [
    collection.insert(
        [(j + i * batch_size, np.random.rand(20000)) for j in range(batch_size)],
        async_req=True
    ) for i in range(loop)
]

# Wait for all write operations to complete.
print([async_result.get() for async_result in async_results])

print(f"async insert {loop} times with batch-size = {batch_size}, cost = {time.time() - start}")

# output:
# async insert 1000 times with batch-size = 8, cost = 31.13356590270996

# For comparison, synchronous write (code omitted)
# sync insert 1000 times with batch-size = 8, cost = 408.63447427749634Las operaciones asíncronas pueden activar los límites descritos en Constraints and Limitations. Gestione estas situaciones adecuadamente.
5. ¿Los ID de Doc son únicos por colección o por partición?
Los ID de Doc son únicos en cada partición. Distintas particiones de la misma colección pueden tener Docs con el mismo ID.
6. ¿Por qué hay pérdida de precisión en los datos vectoriales insertados?
DashVector almacena los vectores como números de punto flotante de precisión simple (FP32/float32). El rango de precisión es:
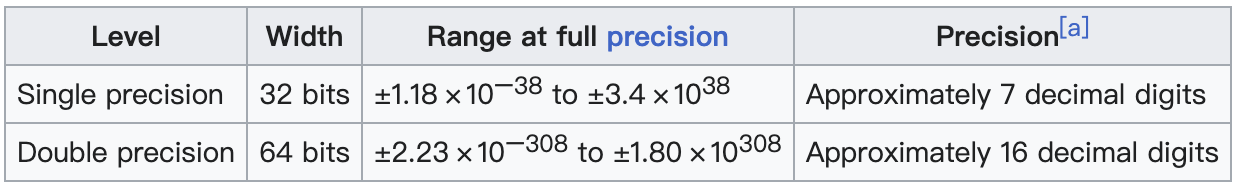
Los datos de entrada fuera de este rango se redondean al valor FP32 más cercano, lo que provoca una pérdida de precisión.
7. ¿Se pueden especificar varias particiones cuando retrieving a Doc?
No. Cada llamada a Retrieve Doc acepta solo una partición. Para consultar varias particiones, llame a la operación varias veces.
8. El comando pip install dashvector es muy lento. ¿Cómo puedo acelerarlo?
Las descargas lentas generalmente se deben a una alta latencia hacia el índice de paquetes predeterminado. Utilice un espejo para acelerar la instalación.
Por ejemplo, para usar el espejo de Alibaba Cloud:
Abra una terminal (para Linux o macOS) o Command Prompt/PowerShell (para Windows).
-
Especifique el espejo mediante el parámetro
-io--index-url.pip3 install dashvector -i https://mirrors.aliyun.com/pypi/simple/
9. ¿Puedo crear un clúster mediante un SDK?
No. Los clústeres solo se pueden crear en la Management Console. Create a cluster.
10. ¿Existe un límite en la cantidad de colecciones que puedo crear en un clúster de pago?
Sí. Un clúster de pago admite hasta 32 colecciones. El límite de particiones depende de las especificaciones del clúster y es independiente de la cantidad de colecciones. Constraints and Limits.
11. ¿Las condiciones de filtro admiten la búsqueda aproximada de texto al recuperar un Doc?
No. En AISearch, los filtros solo admiten la coincidencia de prefijos en el texto. Filtered retrieval.
12. DashVector devuelve el error: "Query qps exceeds limit 0 for collection ××××"
Este error ocurre cuando se proporciona un collectionName incorrecto en una solicitud de recuperación HTTP en un clúster gratuito o cuando se excede el límite de QPS del clúster gratuito. Los clústeres de pago no tienen límites estrictos de QPS ni de capacidad. Constraints and Limits.
13. Cuando uso un SDK para llamar a DashVector, devuelve el error: DashVectorSDK RPCHandler endpoint({××××}) is invalid and cannot contain protocol header
El endpoint proporcionado al cliente no es válido. Compruebe que el parámetro endpoint no contiene {}.