Tablestore utiliza su función de índice de búsqueda para ofrecer la recuperación de vectores. Esta función le permite encontrar los elementos de datos más similares dentro de conjuntos de datos grandes. Si los resultados de la recuperación de vectores para búsquedas semánticas no son satisfactorios, consulte este tema para optimizar el rendimiento.
Fórmulas de puntuación de la recuperación de vectores
La recuperación de vectores de Tablestore (KnnVectorQuery) utiliza vectores numéricos para ejecutar consultas aproximadas de vecinos más cercanos. Este método es adecuado para escenarios como generación aumentada por recuperación (RAG), sistemas de recomendación, detección de similitudes, procesamiento de lenguaje natural y búsqueda semántica. Para obtener más información sobre cómo usar la recuperación de vectores, consulte Vector retrieval.
La recuperación de vectores es compatible con las medidas de distancia euclidiana (euclidean), similitud del coseno (cosine) y producto punto (dot_product). Cada medida de distancia tiene una fórmula de puntuación distinta. Tablestore utiliza estas fórmulas para evaluar la similitud entre los vectores. A continuación se describen dichas fórmulas.
|
MetricType |
Fórmula de puntuación |
|
Distancia euclidiana (euclidean) |
|
|
Producto punto (dot_product) |
|
|
Similitud del coseno (cosine) |
|
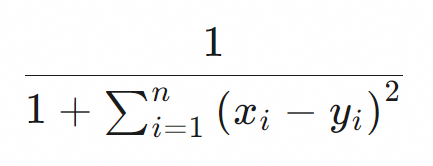
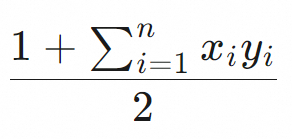
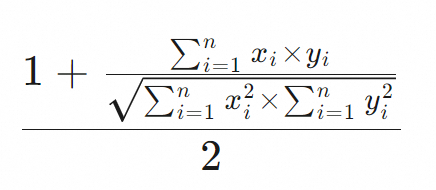
Solución de problemas y análisis
1. Compruebe el método de ordenamiento
Cuando utilice la recuperación de vectores, ordene los resultados por puntuación mediante ScoreSort. De forma predeterminada, los resultados se ordenan por clave principal.
2. Ajuste el uso de BoolQuery
Si combina una consulta KnnVectorQuery (recuperación de vectores) con una consulta BoolQuery (consulta multicondicional), establezca el tipo de consulta del índice de búsqueda en KnnVectorQuery y agregue las condiciones de BoolQuery al parámetro Filter (filtro de recuperación de vectores). Este método no afecta el cálculo de la puntuación.
Si establece el tipo de consulta en BoolQuery y usa KnnVectorQuery como subcondición, las demás condiciones de BoolQuery podrían afectar el cálculo de la puntuación. Para obtener más información, consulte Usage with BoolQuery.
El siguiente código Java muestra un ejemplo de recuperación de vectores.
private static void knnVectorQuery(SyncClient client) {
    SearchQuery searchQuery = new SearchQuery();
    KnnVectorQuery query = new KnnVectorQuery();
    query.setFieldName("Col_Vector");
    query.setTopK(10); // Return the top K nearest neighbors.
    query.setFloat32QueryVector(new float[]{0.1f, 0.2f, 0.3f, 0.4f});
    // The nearest neighbor vectors must meet the condition: Col_Keyword=hangzhou && Col_Long<4.
    query.setFilter(QueryBuilders.bool()
            .must(QueryBuilders.term("Col_Keyword", "hangzhou"))
            .must(QueryBuilders.range("Col_Long").lessThan(4))
    );
    searchQuery.setQuery(query);
    searchQuery.setLimit(10);
    // Sort by score.
    searchQuery.setSort(new Sort(Collections.singletonList(new ScoreSort())));
    SearchRequest searchRequest = new SearchRequest("<TABLE_NAME>", "<SEARCH_INDEX_NAME>", searchQuery);
    SearchRequest.ColumnsToGet columnsToGet = new SearchRequest.ColumnsToGet();
    columnsToGet.setColumns(Arrays.asList("Col_Keyword", "Col_Long"));
    searchRequest.setColumnsToGet(columnsToGet);
    // Access the Search interface.
    SearchResponse resp = client.search(searchRequest);
    for (SearchHit hit : resp.getSearchHits()) {
        // Print the score.
        System.out.println(hit.getScore());
        // Print the data.
        System.out.println(hit.getRow());
    }
}
3. Compruebe la calidad de la generación de vectores
Tablestore calcula la similitud de los datos vectoriales, pero no evalúa la calidad de la generación de vectores. Un modelo de embedding externo genera tanto los vectores almacenados en la base de datos como los vectores de consulta. En escenarios altamente especializados, es posible que los vectores generados no sean eficaces. Siga estos pasos para solucionar este problema:
-
Calcule la puntuación directamente sin usar Tablestore.
-
Defina el vector de consulta como
vector ay el vector que desea recuperar de la tabla de Tablestore comovector b.NotaObtenga los datos de
vector bmediante las API de lectura de datos del índice de búsqueda, del índice secundario o de la tabla ancha. Calcule
score acon el métodoMetricFunction.COSINE.compare(a, b). Este método está available en el código de demostración de Appendix: Demo code for vector retrieval scoring formulas.
-
-
Calcule la puntuación con Tablestore.
Utilice la función de recuperación de vectores de Tablestore para consultar
vector a. Después, compruebescore bde cada fila en los resultados devueltos. -
Análisis comparativo
Si los resultados de la recuperación de vectores de Tablestore no incluyen la fila que contiene
vector b, teóricamentescore bde cada fila devuelta será mayor quescore a.Este resultado confirma que los resultados insatisfactorios de la recuperación de vectores se deben al bajo rendimiento del modelo de embedding. Los resultados de la recuperación solo contienen datos vectoriales con puntuaciones superiores al resultado esperado, por lo que dicho resultado no se devuelve.
-
Soluciones recomendadas.
Este problema suele presentarse en dominios especializados. Por ejemplo, ciertos términos de biomedicina podrían no funcionar bien con un modelo de embedding de propósito general. El modelo podría no considerar semánticamente similares algunos términos que sí lo son dentro de un dominio especializado. En estos casos, considere las siguientes soluciones:
-
Busque un modelo de embedding diseñado para su dominio específico.
ModelScope ofrece muchos modelos de embedding listos para usarse. Elija modelos para dominios especializados como asuntos gubernamentales, comercio electrónico, atención médica, derecho y finanzas. Para obtener más información, consulte Lista de modelos de embedding.
Recopile una gran cantidad de datos de corpus profesional y utilícelos para entrenar un modelo de embedding adecuado.
-
Apéndice: Código de demostración de las fórmulas de puntuación de la recuperación de vectores
El siguiente código Java muestra las fórmulas de puntuación de las medidas de distancia compatibles.
import java.util.concurrent.ThreadLocalRandom;

public class CompareVector {

    public static void main(String[] args) {
        // a is the query vector
        float[] a = randomVector(512);
        // b is the vector from the row in the index that you expect to be returned
        float[] b = randomVector(512);
        // Select the similarity measure algorithm that you set in your search index and output the score
        System.out.println(MetricFunction.COSINE.compare(a, b));
    }

    public static float[] randomVector(int dim) {
        float[] vec = new float[dim];
        for (int i = 0; i < dim; i++) {
            vec[i] = ThreadLocalRandom.current().nextFloat();
            if (ThreadLocalRandom.current().nextBoolean()) {
                vec[i] = -vec[i];
            }
        }
        return l2normalize(vec, true);
    }

    public static float[] l2normalize(float[] v, boolean throwOnZero) {
        double squareSum = 0.0f;
        int dim = v.length;
        for (float x : v) {
            squareSum += x * x;
        }
        if (squareSum == 0) {
            if (throwOnZero) {
                throw new IllegalArgumentException("normalize a zero-length vector");
            } else {
                return v;
            }
        }
        double length = Math.sqrt(squareSum);
        for (int i = 0; i < dim; i++) {
            v[i] /= length;
        }
        return v;
    }

    public enum MetricFunction {
        /**
         * Euclidean distance.
         */
        EUCLIDEAN {
            @Override
            public float compare(float[] v1, float[] v2) {
                return 1 / (1 + VectorUtil.squareDistance(v1, v2));
            }
        },

        /**
         * Dot product.
         */
        DOT_PRODUCT {
            @Override
            public float compare(float[] v1, float[] v2) {
                return (1 + VectorUtil.dotProduct(v1, v2)) / 2;
            }
        },

        /**
         * Cosine.
         */
        COSINE {
            @Override
            public float compare(float[] v1, float[] v2) {
                return (1 + VectorUtil.cosine(v1, v2)) / 2;
            }
        };

        public abstract float compare(float[] v1, float[] v2);
    }

    static final class VectorUtil {

        private static void checkParam(float[] a, float[] b) {
            if (a.length != b.length) {
                throw new IllegalArgumentException("vector dimensions differ: " + a.length + "!=" + b.length);
            }
        }

        public static float dotProduct(float[] a, float[] b) {
            checkParam(a, b);
            float res = 0f;
            for (int i = 0; i < a.length; i++) {
                res += b[i] * a[i];
            }
            return res;
        }

        public static float cosine(float[] a, float[] b) {
            checkParam(a, b);
            float sum = 0.0f;
            float norm1 = 0.0f;
            float norm2 = 0.0f;
            for (int i = 0; i < a.length; i++) {
                float elem1 = a[i];
                float elem2 = b[i];
                sum += elem1 * elem2;
                norm1 += elem1 * elem1;
                norm2 += elem2 * elem2;
            }
            return (float) (sum / Math.sqrt((double) norm1 * (double) norm2));
        }

        public static float squareDistance(float[] a, float[] b) {
            checkParam(a, b);
            float sum = 0.0f;
            for (int i = 0; i < a.length; i++) {
                float difference = a[i] - b[i];
                sum += difference * difference;
            }
            return sum;
        }
    }
}