Puede correlacionar resultados de monitoreo en varios conjuntos de resultados de consulta mediante operaciones de conjuntos y configurar alertas por falta de datos para detectar interrupciones en la recolección.
Oportunidad del monitoreo
-
Funcionamiento del monitoreo
El sistema de alertas ejecuta periódicamente la instrucción de consulta configurada según la Check Frequency, la aplica a los datos de un intervalo de tiempo especificado y evalúa los resultados con respecto a la condición de alerta. Si la condición se cumple, se activa una alerta.
-
Análisis de problemas de oportunidad
-
Latencia de indexación de datos: existe un retraso entre el momento en que los datos se escriben en Simple Log Service y el momento en que están disponibles para su consulta. Incluso un retraso breve puede provocar que se omitan datos.
Por ejemplo, una verificación de alerta se ejecuta a las 12:03:30. La consulta está configurada para un intervalo de tiempo relativo del último minuto, y la Check Frequency tiene un intervalo fijo de 1 minuto. Esto establece el intervalo de tiempo de la consulta en [12:02:30, 12:03:30). Una entrada de registro escrita a las 12:03:29 podría no estar indexada ni disponible para consultas a las 12:03:30 y, por lo tanto, la consulta podría omitirla.
-
Precisión de la consulta: cuando se escriben registros con diferentes marcas de tiempo dentro del mismo minuto en un lote, Simple Log Service puede indexar todo el lote utilizando la marca de tiempo del registro más antiguo.
Por ejemplo, una verificación de alerta se ejecuta a las 12:03:30 con un intervalo de tiempo relativo de un minuto, es decir, [12:02:30, 12:03:30). Suponga que varias entradas de registro se escriben como un lote a las 12:02:50, pero sus marcas de tiempo individuales son 12:02:20, 12:02:50, etc. Todo el lote podría indexarse bajo la marca de tiempo 12:02:20. Como resultado, una consulta que utilice el intervalo de tiempo [12:02:30, 12:03:30) no encontraría estos registros.
-
-
Recomendaciones para optimizar la oportunidad
-
Priorizar la precisión: siga estas recomendaciones si requiere una alta precisión en las alertas, sin duplicados ni omisiones.
Para abordar la latencia de indexación de datos: en el cuadro de diálogo Query Statistics, establezca un Query Time Range relativo que termine ligeramente en el pasado. Por ejemplo, configure el Start At relativo a hace 70 segundos y la End Time a hace 10 segundos. Este margen de 10 segundos ayuda a evitar la omisión de datos causada por retrasos en la indexación.
Para abordar la imprecisión de la consulta: en el cuadro de diálogo Query Time Range, alinee su Query Time Range a ventanas de tiempo fijas, como 1 Minute (Time Frame), 5 Minute (Time Frame) o 1 Hour (Time Frame). Configure la Check Frequency para que coincida con la ventana de tiempo seleccionada, como 1 minuto, 5 minutos o 1 hora.
-
Priorizar la oportunidad: siga estas recomendaciones si requiere alertas inmediatas y puede tolerar la posibilidad de alertas duplicadas.
Para abordar la latencia de indexación de datos: en el cuadro de diálogo Query Statistics, en Query Time Range, desplace la hora relativa de Start At más hacia el pasado; por ejemplo, a hace 70 segundos (relativo).
Para abordar la imprecisión de la consulta: en el cuadro de diálogo Query Statistics, asegúrese de que el Query Time Range sea lo suficientemente amplio para cubrir el intervalo anterior; por ejemplo, establézcalo en 90 segundos relativos y configure la Check Frequency en 1 minuto.
-
Asociación de resultados de consulta y análisis
El sistema de alertas de Simple Log Service trata los resultados de consulta como conjuntos y admite el monitoreo correlacionado en varios conjuntos.
En la página de configuración, cada consulta se identifica con un número (0, 1 o 2) e incluye un editor de consultas y ajustes de intervalo de tiempo. Las consultas adyacentes se vinculan mediante la lista desplegable de set operations. Puede usar los botones de ordenamiento para reorganizar o eliminar consultas. La opción Grouped Evaluation se encuentra en la parte inferior.
Simple Log Service admite el monitoreo correlacionado en hasta tres conjuntos.
De forma predeterminada, se utilizan las primeras 1,000 filas de los resultados de consulta para las operaciones de conjuntos. Si utiliza tres consultas y establece la set operation en un valor distinto de No Merge, solo se utilizarán las primeras 100 filas de cada consulta.
-
Si utiliza tres conjuntos, el sistema realiza primero una operación de conjunto en los dos primeros y luego efectúa una segunda operación entre ese resultado y el tercer conjunto. Por ejemplo:
Set A LEFT JOIN Set B LEFT JOIN Set C: el sistema realiza primero un LEFT JOIN entre Set A y Set B, y luego une ese resultado con Set C mediante otro LEFT JOIN.
Set A JOIN Set B INNER JOIN Set C: el sistema realiza primero un JOIN entre Set A y Set B, y luego une ese resultado con Set C mediante un INNER JOIN.
Set A LEFT EXCLUDE JOIN Set B No Merge Set C: el sistema realiza un LEFT EXCLUDE JOIN entre Set A y Set B, e ignora Set C.
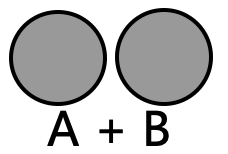
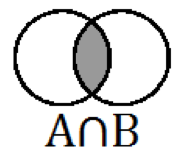
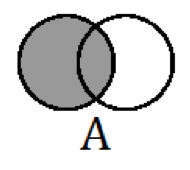
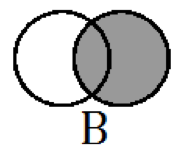
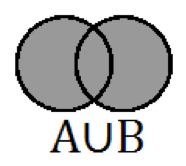
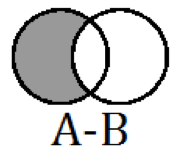
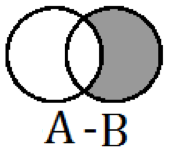
La lista desplegable de set operations ofrece las siguientes nueve opciones.
|
Operaciones de conjuntos |
Ilustración |
Descripción |
|
|
Los dos conjuntos no se asocian. Set A proporciona los resultados de la consulta, mientras que Set B solo sirve como fuente de variables para la plantilla de notificación de alertas. |
|
|
Ninguna |
Combina cada fila de Set A con cada fila de Set B. Esta operación se usa normalmente para filtrar datos antes de la evaluación. |
|
|
|
Fusiona los datos de Set B en las filas coincidentes de Set A, alineando las filas por nombre de campo. |
|
|
|
Devuelve solo las filas de Set A que tienen una fila coincidente en Set B. Esto utiliza eficazmente Set B como lista de permitidos para Set A. |
|
|
|
Enriquece Set A con datos coincidentes de Set B. En este caso, Set B actúa como tabla de dimensiones para Set A. |
|
|
|
Enriquece Set B con datos coincidentes de Set A. En este caso, Set A actúa como tabla de dimensiones para Set B. |
|
|
|
Fusiona todas las filas de Set A y Set B, y enriquece las filas coincidentes con datos del otro conjunto. |
|
|
|
Devuelve solo las filas de Set A que no tienen coincidencia en Set B. Esto utiliza eficazmente Set B como lista de bloqueados para Set A. |
|
|
|
Devuelve solo las filas de Set B que no tienen coincidencia en Set A. Esto utiliza eficazmente Set A como lista de bloqueados para Set B. |
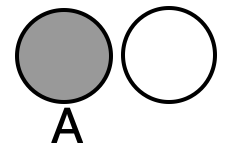
No merge
-
Requisito
Monitorear registros de acceso de NGINX. Activar una alerta si el número de errores 5xx supera los 500 en un periodo de 15 minutos. La alerta debe enumerar los hosts específicos que devolvieron errores.
La configuración es la siguiente: la consulta de Query and Statistics 0 es
status > 500 | select count(1) as cnt, y la set operation está establecida en No merge. La consulta de Query and Statistics 1 esstatus > 500 | select host, count(1) as pv group by host order by pv desc limit 5. La group evaluation está configurada como No Grouping, y la trigger condition está establecida en has data, con la condicióncnt > 500.-
Resultado
-
Resultados de Query and Statistics 0
Cuenta el número de errores 5xx dentro de un periodo de 15 minutos.
cnt
1234
-
Resultados de Query and Statistics 1
Identifica los 5 principales hosts con mayor cantidad de errores 5xx en un periodo de 15 minutos y sus respectivos conteos de errores.
host
pv
host1
60
host2
55
host3
47
host4
45
host5
30
-
Resultado de la operación de conjuntos
Cuando la set operation se establece en No merge, la operación devuelve el resultado de Query and Statistics 0.
-
CROSS JOIN
-
Ejemplo 1
-
Requisito
Monitorear registros de acceso de Object Storage Service (OSS) y Server Load Balancer (SLB). Activar una alerta si la suma combinada de errores 4xx de OSS y errores 5xx de SLB supera los 1,000 en un periodo de 15 minutos.
Configuración: la consulta de Query Statement 0 es
status >= 400 and status < 500 | select count(1) as pv, y Set Operations está establecida en CROSS JOIN. La consulta de Query Statement 1 esstatus >= 500 | select count(1) as pv. Para la regla de alerta, Group Evaluation está configurada como Ungrouped, y la Trigger Condition está establecida en Data exists con la condición($0.pv + $1.pv) > 1000.-
Resultados
-
Resultados de la instrucción de consulta 0
Número de errores 4xx de OSS en un periodo de 15 minutos.
pv
890
-
Resultados de la instrucción de consulta 1
Número de errores 5xx de SLB en un periodo de 15 minutos.
pv
567
-
Resultados de la operación de conjuntos
Cuando Set Operations se establece en CROSS JOIN, los resultados son los siguientes:
$0.pv
$1.pv
890
567
-
-
-
Ejemplos adicionales
-
Resultados de la instrucción de consulta 0
a
b
a1
b1
a2
b2
a5
b5
-
Resultados de la instrucción de consulta 1
a
c
a1
c1
a3
c3
-
Resultados de la operación de conjuntos
Cuando Set Operations se establece en CROSS JOIN, los resultados son los siguientes:
$0.a
b
$1.a
c
a1
b1
a1
c1
a1
b1
a3
c3
a2
b2
a1
c1
a2
b2
a3
c3
a5
b5
a1
c1
a5
b5
a3
c3
-
Join
-
Ejemplo 1
-
Requisito
Monitorear registros de acceso de Nginx desde dos LogStores, uno en la región China (Beijing) y otro en la región China (Shanghai). Activar una alerta si el número total de hosts con más de 30 errores 5xx en ambos LogStores supera los 10 en un intervalo de 15 minutos.
La configuración es la siguiente: para Query Statistics 0, la instrucción de consulta es
status > 500 | select host, count(*) as pv group by host having pv > 30, y la Set Operation es JOIN. Para Query Statistics 1, la instrucción de consulta esstatus > 500 | select host, count(*) as pv group by host having pv > 30, Group Evaluation es No Grouping, y la Trigger Condition es has specific number of results mayor que 10.-
Resultado
-
Resultados de la instrucción de consulta 0
Esta consulta identifica los hosts con más de 30 errores 5xx en un periodo de 15 minutos y enumera sus respectivos conteos de errores.
Host
Pv
host1
60
host2
55
host3
47
host4
45
host5
31
-
Resultados de la instrucción de consulta 1
Esta consulta identifica los hosts con más de 30 errores 5xx en un periodo de 15 minutos y enumera sus respectivos conteos de errores.
Host
Pv
hosta
70
hostb
45
hostc
44
hostd
42
-
Resultado de la operación de conjuntos
Cuando Set Operations se establece en JOIN, el resultado combinado es:
Host
Pv
host1
60
host2
55
host3
47
host4
45
host5
31
hosta
70
hostb
45
hostc
44
hostd
42
-
-
-
Otros ejemplos
-
Si los campos de resultado de dos instrucciones de consulta no coinciden, la operación JOIN rellena los campos no coincidentes con None.
-
Resultados de la instrucción de consulta 0
A
B
a1
b1
a2
b2
-
Resultados de la instrucción de consulta 1
B
C
b1
c1
b2
c2
-
Resultado de la operación de conjuntos
A
B
C
a1
b1
None
a2
b2
None
None
b1
c1
None
b2
c2
-
-
Al utilizar tres instrucciones de consulta, el sistema realiza primero una operación de conjunto entre la instrucción de consulta 0 y la instrucción de consulta 1, y luego une ese resultado con los resultados de la instrucción de consulta 2.
-
Resultados de la instrucción de consulta 0
A
B
a1
b1
a2
b2
-
Resultados de la instrucción de consulta 1
A
B
a1
b11
a2
b22
a3
b33
-
Resultado de unir la instrucción de consulta 0 y la instrucción de consulta 1
El resultado de la operación INNER JOIN con la condición $0.a == $1.a es:
A
$0.b
$1.b
a1
b1
b11
a2
b2
b22
-
Resultados de la instrucción de consulta 2
A
B
a3
b333
a4
b444
-
Resultado de la operación de conjuntos final
El resultado final de la operación JOIN es:
NotaLos valores del campo b en los resultados de la instrucción de consulta 2 completan la columna $0.b en el resultado final.
A
$0.b
$1.b
a1
b1
b11
a2
b2
b22
a3
b333
None
a4
b444
None
-
-
Inner join
-
Ejemplo 1
-
Requisito
Monitorear el número de errores 5xx en un bucket específico. Activar una alerta si el conteo supera los 1,000 en un periodo de 15 minutos. Para cumplir este requisito, debe agregar datos de recursos para mantener una lista de permitidos de buckets.
La configuración es la siguiente: la instrucción de consulta para Query Statement 0 es
status >=500 | select bucket, count(*) as pv group by bucket having pv > 1000 limit 1000. Set Operations está establecida en INNER JOIN con la condición de unión$0.bucket = $1.bucket. Para Query Statement 1, se selecciona el origen de datos OSS (user.test), que especifica los buckets bucket_03, bucket_04, bucket_05 y bucket_06. Group Evaluation está configurada como Ungrouped, y la Trigger Condition está establecida en Data exists.-
Resultados
-
Resultados de la instrucción de consulta 0
Identifica los buckets que tienen más de 1,000 errores 5xx en un periodo de 15 minutos.
Bucket
Pv
bucket_01
1600
bucket_02
1550
bucket_03
1470
bucket_04
1450
-
Resultados de la instrucción de consulta 1
Datos de recursos de los buckets.
Bucket
Description
bucket_03
for dev team
bucket_04
for test team
bucket_05
for service team
bucket_06
for support team
-
Resultados de la operación de conjuntos
Cuando la Set Operation se establece en INNER JOIN con la condición $0.bucket == $1.bucket, el resultado de la operación de conjuntos es el siguiente:
Bucket
Pv
Description
bucket_03
1470
for dev team
bucket_04
1450
for test team
-
-
-
Ejemplo 2
-
Requisito
Dos logstores, uno en la región China (Beijing) y otro en la región China (Shanghai), almacenan registros de acceso de Nginx. Cada 15 minutos, el sistema busca clientes con más de 30 errores 5xx. Se activa una alerta si ocurren errores 5xx en ambas regiones y el conteo de errores en la región China (Beijing) supera al de la región China (Shanghai).
La configuración es la siguiente: la instrucción de consulta para Query Statement 0 es
status >= 500 | select client_ip, count(1) as pv group by client_ip having pv > 30. Set Operations está establecida en INNER JOIN con las condiciones de unión$0.client_ip = $1.client_ipy$0.pv > $1.pv. La instrucción de consulta para Query Statement 1 esstatus >= 500 | select client_ip, count(1) as pv group by client_ip having pv > 30. Group Evaluation está configurada como Ungrouped, y la Trigger Condition está establecida en Data exists.-
Resultados
-
Resultados de la instrucción de consulta 0
Identifica los clientes en la región China (Beijing) que tienen más de 30 errores 5xx en un periodo de 15 minutos y sus conteos de errores.
Client ip
Pv
192.0.2.4
60
192.0.2.5
55
192.0.2.6
47
192.0.2.7
45
192.0.2.8
31
-
Resultados de la instrucción de consulta 1
Identifica los clientes en la región China (Shanghai) que tienen más de 30 errores 5xx en un periodo de 15 minutos y sus conteos de errores.
Client ip
Pv
192.0.2.5
70
192.0.2.6
45
192.0.2.7
44
192.0.2.8
42
192.0.2.9
42
-
Resultados de la operación de conjuntos
Cuando Set Operations se establece en INNER JOIN, $0.client_ip == $1.client_ip y $0.pv > $1.pv, el resultado de la operación de conjuntos es el siguiente:
Client ip
Pv
192.0.2.6
47
192.0.2.7
45
-
-
-
Otros ejemplos
Si los conjuntos de resultados de dos instrucciones de consulta contienen campos con nombres idénticos que no son claves de unión, el sistema agrega automáticamente los prefijos $0. y $1. a estos nombres de campo en el conjunto de resultados final.
-
Resultados de la instrucción de consulta 0
A
B
C
D
a1
b1
c1
d1
a2
b2
c2
d2
a3
b3
c3
d3
-
Resultados de la instrucción de consulta 1
A
B
C
a1
b11
c11
a2
b22
c22
-
Resultados de la operación de conjuntos
Cuando la Set Operation es INNER JOIN y $0.a == $1.a, el resultado de la operación de conjuntos es el siguiente:
A
$0.b
$0.c
D
$1.b
$1.c
a1
b1
c1
d1
b11
c11
a2
b2
c2
d2
b22
c22
-
LEFT JOIN
-
Resultados de la instrucción de consulta 0
A
B
a1
b1
a2
b2
a3
b3
-
Resultados de la instrucción de consulta 1
A
B
C
a1
b11
c1
a2
b22
c2
-
Resultados de la operación de conjuntos
Cuando Set Operations se establece en LEFT JOIN con la condición de unión $0.a == $1.a, el resultado es el siguiente:
A
$0.b
$1.b
C
a1
b1
b11
c1
a2
b2
b22
c2
a3
b3
None
None
Right join
-
Resultados de la consulta 0
a
b
c
a1
b11
c1
a2
b22
c2
-
Resultados de la consulta 1
a
b
a1
b1
a2
b2
a3
b3
-
Resultado de la operación de conjuntos
Cuando Set Operations se establece en RIGHT JOIN con la condición $0.a == $1.a, el resultado es:
a
$0.b
c
$1.b
a1
b11
c1
b1
a2
b22
c2
b2
a3
NULL
NULL
b3
Full join
-
Datos de origen 0
a
b
c
a1
b1
c1
a2
b2
c2
a5
b5
c3
-
Datos de origen 1
a
b
d
a1
b11
d1
a2
b22
d2
a3
b33
d3
-
Resultados de la operación de conjuntos
Cuando establece el parámetro Set Operations en FULL JOIN con la condición de unión $0.a == $1.a, el resultado es el siguiente:
a
$0.b
c
$1.b
d
a1
b1
c1
b11
d1
a2
b2
c2
b22
d2
a5
b5
c3
None
None
a3
None
None
b33
d3
LEFT EXCLUDE JOIN
-
Requisito
Monitorear errores 5xx para todos los buckets excepto aquellos en la lista de bloqueados. Activar una alerta si el conteo de errores supera los 1,000 en un periodo de 15 minutos. Para ello, utilice datos de recursos para mantener la lista de bloqueados de buckets.
La configuración es la siguiente: la consulta de Query Statement 0 es
status >=500 | select bucket, count(*) as pv group by bucket having pv > 1000 limit 1000. La set operation está establecida en LEFT EXCLUDE JOIN con la condición de unión$0.bucket = $1.bucket. Para Query Statement 1, el origen de datos OSS es (user.test) y los buckets son bucket_03 y bucket_04. Group Evaluation está configurada como Ungrouped, y la trigger condition está establecida en data exists.-
Resultado
-
Resultados de la instrucción de consulta 0
Identifica los buckets que tienen más de 1,000 errores 5xx en un periodo de 15 minutos.
Bucket
Pv
bucket_01
1060
bucket_02
1055
bucket_03
1047
bucket_04
1045
-
Resultados de la instrucción de consulta 1
Datos de recursos de los buckets.
Bucket
Description
bucket_03
for dev team
bucket_04
for test team
-
Resultado de la operación de conjuntos
Cuando la set operation se establece en LEFT EXCLUDE JOIN con la condición $0.bucket = $1.bucket, el resultado es el siguiente:
Bucket
Pv
bucket_01
1060
bucket_02
1055
-
Right exclude join
-
Requisito
Monitorear errores 5xx para todos los buckets que no estén en la lista de bloqueados. Activar una alerta si el conteo de errores supera los 1,000 en un periodo de 15 minutos. Para ello, agregue datos de recursos para mantener la lista de bloqueados de buckets.
Configure los ajustes de la siguiente manera: para Query Statement 0, seleccione el origen de datos OSS (user.test) y especifique bucket_03 y bucket_04. Establezca Set Operations en RIGHT EXCLUDE JOIN, con la condición de unión
$0.bucket = $1.bucket. Para Query Statement 1, establezca la instrucción de consulta enstatus > 500 | select bucket, count(*) as pv group by bucket having pv > 1000 limit 1000. Configure Group Evaluation en No Grouping y establezca la Trigger Condition en Data exists.-
Resultado
-
Resultados de la instrucción de consulta 0
Devuelve los datos de recursos de los buckets en la lista de bloqueados.
Bucket
Description
bucket_03
for dev team
bucket_04
for test team
-
Resultados de la instrucción de consulta 1
Devuelve los buckets con más de 1,000 errores 5xx en un periodo de 15 minutos.
Bucket
Pv
bucket_01
60
bucket_02
55
bucket_03
47
bucket_04
45
-
Resultado de la operación de conjuntos
Cuando Set Operations se establece en RIGHT EXCLUDE JOIN con la condición de unión $0.bucket = $1.bucket, el resultado es el siguiente:
Bucket
Pv
bucket_01
60
bucket_02
55
-
Alerta por falta de datos
Las alertas por falta de datos detectan pérdidas de información inadvertidas durante la recolección. Por ejemplo, puede crear una regla de alerta para monitorear la utilización de CPU de cada host y recibir una notificación de alerta si se cumple alguna de las siguientes condiciones:
La utilización de CPU supera el 95 %.
La consulta y el análisis no devuelven datos.
Configure la regla de alerta de la siguiente manera:
-
Query statistics: especifique una consulta para calcular la utilización de CPU.
* | select promql_query_range('cpu_util') from metrics limit 1000 -
Trigger Condition: Data matches the expression, value>95, Severity: Medium
Si el campo value en los resultados de consulta y análisis supera 95, se activa una alerta de gravedad media.
Threshold of Continuous Triggers: número de veces consecutivas que debe cumplirse la condición de activación antes de generar una alerta.
-
No-data alert: active el interruptor de no-data alert y configure la gravedad y la anotación.
Cuando esta opción está habilitada, se activa una alerta si el número de consultas consecutivas sin datos supera el umbral de activación continua.
Puede establecer una gravedad y una anotación independientes para las alertas por falta de datos.
La página se configura de la siguiente manera:
Para grouping evaluation, seleccione Automatic by label. En la sección Add annotation, establezca el título en ${alert_name} alert triggered y la descripción en ${alert_name} alert triggered. Deshabilite automatic annotation y recovery notification. En advanced settings, establezca el continuous trigger threshold en 1. Habilite no-data alert, configure su severity en Medium, su título de anotación en ${alert_name}: No data y su descripción en No data was returned when this alert rule was evaluated.