Este tema describe la sintaxis y los parámetros de las funciones de recursos. También se proporcionan ejemplos sobre cómo utilizar estas funciones.
Funciones
Al llamar a las siguientes funciones de recursos, debe configurar el modo Advanced preview para extraer los datos que necesita. Para obtener más información sobre cómo configurar el modo Advanced preview, consulte Advanced preview.
|
Función |
Descripción |
|
Extrae los valores de los parámetros avanzados del trabajo de transformación de datos actual. Esta función puede utilizarse junto con otras funciones. Para obtener más información, consulte Enrich data from ApsaraDB RDS for MySQL. |
|
|
Extrae datos de una tabla específica en una base de datos creada en una instancia de ApsaraDB RDS for MySQL u obtiene el resultado de ejecución de una sentencia SQL. Los datos y el resultado pueden actualizarse a intervalos regulares. Esta función puede utilizarse junto con otras funciones. Para obtener más información, consulte Enrich data from ApsaraDB RDS for MySQL. |
|
|
Extrae datos de otro logstore mientras transforma datos en un logstore. Puede extraer datos de forma continua. Esta función puede utilizarse junto con otras funciones. Para obtener más información, consulte Pull data from one Logstore to enrich log data in another Logstore. |
|
|
Extrae datos de un objeto en un bucket de Object Storage Service (OSS) específico. Los datos pueden actualizarse a intervalos regulares. Esta función puede utilizarse junto con otras funciones. Para obtener más información, consulte Pull a CSV file from OSS to enrich data. |
res_local
La función res_local extrae los valores de los parámetros avanzados del trabajo de transformación de datos actual.
-
Sintaxis
res_local(param, default=None, type="auto") -
Parámetros
Parámetro
Tipo
Obligatorio
Descripción
param
String
Sí
La clave especificada en Advanced Parameter Settings para el trabajo de transformación de datos actual.
default
String
No
El valor que se devuelve si la clave especificada para el parámetro param no existe. Valor predeterminado: None.
type
String
No
El formato de los datos de salida. Valores válidos:
-
auto: Los datos sin procesar se convierten a una cadena JSON. Si la conversión falla, se devuelven los datos sin procesar. Este es el valor predeterminado.
-
JSON: Los datos sin procesar se convierten a una cadena JSON. Si la conversión falla, se devuelve el valor del parámetro default.
-
raw: Se devuelven los datos sin procesar.
-
-
Respuesta
Se devuelve una cadena JSON o datos sin procesar según la configuración de los parámetros.
-
Conversiones exitosas
Datos sin procesar
Valor devuelto
Tipo de dato del valor devuelto
1
1
Integer
1.2
1.2
Float
true
True
Boolean
false
False
Boolean
"123"
123
String
null
None
None
["v1", "v2", "v3"]
["v1", "v2", "v3"]
List
["v1", 3, 4.0]
["v1", 3, 4.0]
List
{"v1": 100, "v2": "good"}
{"v1": 100, "v2": "good"}
List
{"v1": {"v11": 100, "v2": 200}, "v3": "good"}
{"v1": {"v11": 100, "v2": 200}, "v3": "good"}
List
-
Conversiones con errores
La siguiente tabla muestra algunos ejemplos de conversiones con errores. Los siguientes datos sin procesar no se pueden convertir a cadenas JSON, por lo que se devuelven como cadenas.
Datos sin procesar
Valor devuelto
Descripción
(1,2,3)
"(1,2,3)"
No se admiten tuplas. Deben utilizarse listas.
True
"True"
Un valor del tipo de dato Boolean solo puede ser true o false. Los valores deben estar en minúsculas.
{1: 2, 3: 4}
"{1: 2, 3: 4}"
La clave de un diccionario solo puede ser una cadena.
-
-
Ejemplos
Obtenga la clave especificada en Advanced Parameter Settings y asigne el valor de la clave obtenida al parámetro local.
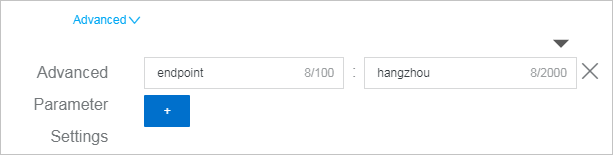
En Advanced Parameter Settings, la clave es endpoint y el valor es hangzhou.
-
Registro sin procesar
content: 1 -
Regla de transformación
e_set("local", res_local('endpoint')) -
Resultado
content: 1
local: hangzhou
-
-
Referencias
Esta función puede utilizarse junto con otras funciones. Para obtener más información, consulte Enrich data from ApsaraDB RDS for MySQL.
res_rds_mysql
La función res_rds_mysql extrae datos de una tabla específica en una base de datos creada en una instancia de ApsaraDB RDS for MySQL u obtiene el resultado de ejecución de una sentencia SQL. Log Service permite extraer datos mediante los siguientes métodos:
Si utiliza la función res_rds_mysql para extraer datos de una base de datos creada en una instancia de ApsaraDB RDS for MySQL, debe crear una lista de permitidos en la instancia y agregar
0.0.0.0a dicha lista. Esto permite el acceso a la base de datos desde todas las direcciones IP; sin embargo, puede generar riesgos para la base de datos. Si desea agregar la dirección IP de Log Service a la lista de permitidos, debe enviar un ticket.Log Service puede acceder a una base de datos creada en una instancia de ApsaraDB RDS for MySQL mediante un endpoint público o interno de la instancia. Si se utiliza un endpoint interno, debe configurar los parámetros avanzados. Para obtener más información, consulte Enrich data from ApsaraDB RDS for MySQL.
-
Extraer todos los datos una sola vez
Cuando ejecuta un trabajo de transformación de datos por primera vez, Log Service extrae todos los datos de una tabla específica y luego deja de extraer datos. Si su base de datos no se actualiza, se recomienda utilizar este método.
-
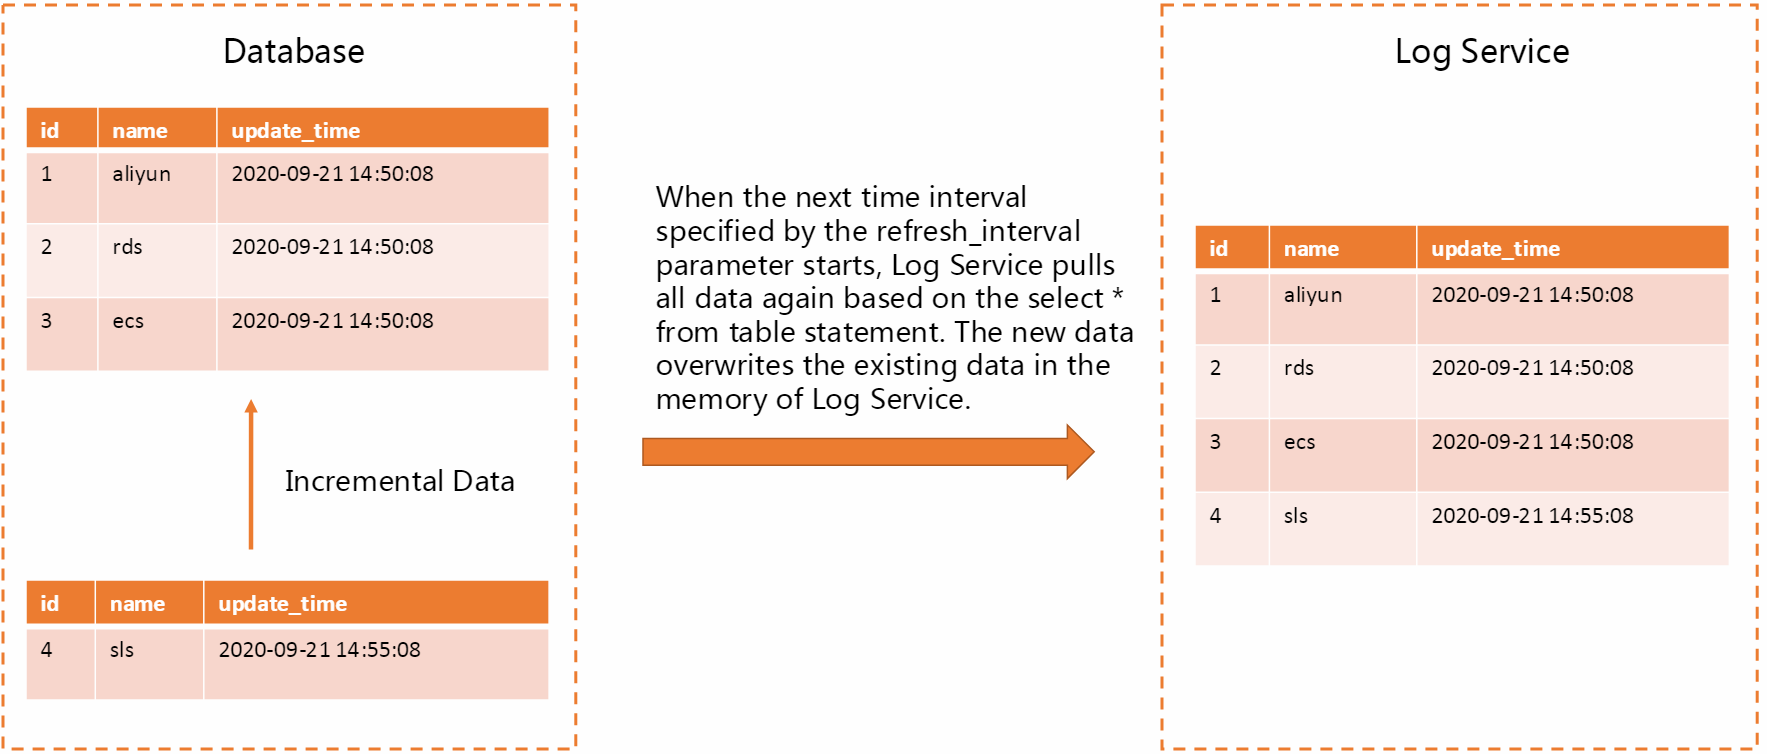
Extraer todos los datos a intervalos regulares
Al ejecutar un trabajo de transformación de datos, Log Service extrae todos los datos de una tabla específica a intervalos regulares. De esta manera, Log Service puede sincronizar los datos con su base de datos oportunamente. No obstante, este método requiere un periodo prolongado. Si el volumen de datos de su base de datos es menor o igual a 2 GB y el valor del parámetro refresh_interval es mayor o igual a 300 segundos, se recomienda utilizar este método.
-
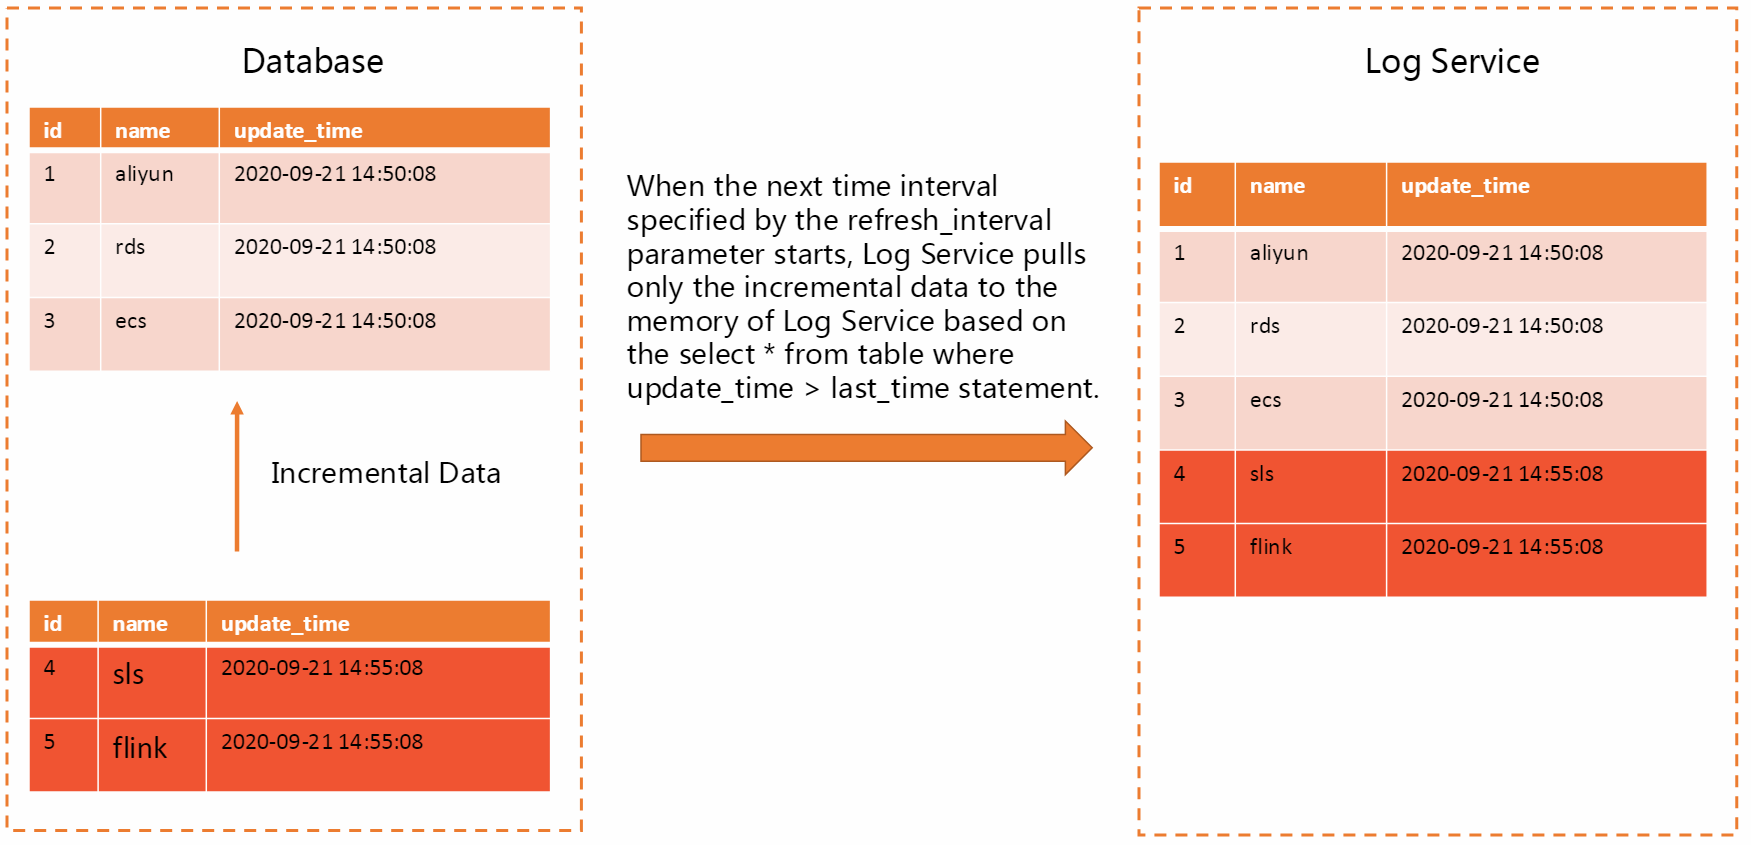
Extraer datos incrementales a intervalos regulares
Al ejecutar un trabajo de transformación de datos, Log Service extrae únicamente datos incrementales basándose en el campo de marca de tiempo de una base de datos específica. Si utiliza este método, Log Service extrae solo los datos recién agregados. Este método es eficiente. Puede establecer el parámetro refresh_interval en 1 segundo para sincronizar datos en cuestión de segundos. Si el volumen de datos de su base de datos es grande, sus datos se actualizan con frecuencia o requiere que los datos se extraigan oportunamente, se recomienda utilizar este método.
-
Sintaxis
res_rds_mysql(address="The address of the database from which data is pulled", username="The username used to connect to the database", password="The password used to connect to the database", database="The name of the database", table=None, sql=None, fields=None, fetch_include_data=None, fetch_exclude_data=None, refresh_interval=0, base_retry_back_off=1, max_retry_back_off=60, primary_keys=None, use_ssl=false, update_time_key=None, deleted_flag_key=None)NotaTambién puede utilizar la función res_rds_mysql para extraer datos de una base de datos creada en un clúster de AnalyticDB for MySQL o PolarDB for MySQL. En estos escenarios, solo necesita reemplazar la dirección, el nombre de usuario, la contraseña y el nombre de la base de datos en la regla de transformación con los valores reales.
-
Parámetros
Parámetro
Tipo
Obligatorio
Descripción
address
String
Sí
El endpoint o la dirección IP de la base de datos a la que desea conectarse. Si el número de puerto no es 3306, especifique un valor en el formato
IP address:Port. Para obtener más información, consulte View or modify endpoints and ports.username
String
Sí
El nombre de usuario que se utiliza para conectarse a la base de datos.
password
String
Sí
La contraseña que se utiliza para conectarse a la base de datos.
database
String
Sí
El nombre de la base de datos a la que desea conectarse.
table
String
Sí
El nombre de la tabla de la que desea extraer datos. Si el parámetro sql está configurado, este parámetro no es obligatorio.
sql
String
Sí
Utilice una sentencia SQL SELECT para recuperar todos los datos relevantes de la base de datos y cargarlos en la memoria de procesamiento. SQL puede optimizar el uso de memoria al filtrar campos y filas, lo que reduce el espacio ocupado por la tabla en la memoria de procesamiento. Si el parámetro table está configurado, este parámetro no es obligatorio.
fields
String list
No
La lista de cadenas o la lista de alias de cadenas. Si no configura este parámetro, se utilizan todas las columnas devueltas para el parámetro sql o table. Por ejemplo, si desea cambiar el nombre de la columna name en la lista ["user_id", "province", "city", "name", "age"] a user_name, debe establecer el parámetro fields en ["user_id", "province", "city", ("name", "user_name"), ("nickname", "nick_name"), "age"].
NotaSi configura los parámetros sql, table y fields simultáneamente, se ejecuta la sentencia SQL del parámetro sql. Los parámetros table y fields no surten efecto.
fetch_include_data
String
No
La lista de permitidos de campos. Se conservan los registros cuyos campos coinciden con el parámetro fetch_include_data. Los registros cuyos campos no coinciden con este parámetro se descartan.
-
Si no configura este parámetro o lo establece en None, la función de lista de permitidos de campos se deshabilita.
-
Si establece este parámetro en un campo y un valor de campo específicos, se conservan los registros que contienen dicho campo y valor.
fetch_exclude_data
String
No
La lista de bloqueados de campos. Se descartan los registros cuyos campos coinciden con el parámetro fetch_exclude_data. Los registros cuyos campos no coinciden con este parámetro se conservan.
-
Si no configura este parámetro o lo establece en None, la función de lista de bloqueados de campos se deshabilita.
-
Si establece este parámetro en un campo y un valor de campo específicos, se descartan los registros que contienen dicho campo y valor.
NotaSi configura tanto el parámetro fetch_include_data como el parámetro fetch_exclude_data, los datos se extraen primero según la configuración del parámetro fetch_include_data y posteriormente según la configuración del parámetro fetch_exclude_data.
refresh_interval
Numeric string or number
No
El intervalo en el que se extraen datos de ApsaraDB RDS for MySQL. Unidad: segundos. Valor predeterminado: 0. Este valor indica que todos los datos se extraen una sola vez.
base_retry_back_off
Number
No
El intervalo en el que el sistema intenta extraer datos nuevamente después de un error de extracción. Valor predeterminado: 1. Unidad: segundos.
max_retry_back_off
Int
No
El intervalo máximo entre dos reintentos consecutivos tras un error de extracción. Valor predeterminado: 60. Unidad: segundos. Se recomienda utilizar el valor predeterminado.
primary_keys
String/List
No
La clave principal en el almacén de pares clave-valor de la tabla de dimensiones en memoria. Si configura este parámetro, los datos de la tabla se guardan en la memoria como un diccionario en formato Key:Value. Una clave en el diccionario corresponde al valor del parámetro primary_keys. Un valor en el diccionario representa una fila completa de datos en la tabla.
Nota-
Debe establecer el parámetro primary_keys. De lo contrario, el rendimiento se verá afectado significativamente y podrían producirse retrasos en la tarea.
-
El valor del parámetro primary_keys debe existir en los campos que se extraen de la tabla.
-
El valor del parámetro primary_keys distingue entre mayúsculas y minúsculas.
use_ssl
Boolean
No
Especifica si se debe utilizar el protocolo SSL para conectarse a la instancia de ApsaraDB RDS for MySQL. Valor predeterminado: false.
NotaSi el cifrado SSL está habilitado en la instancia de ApsaraDB RDS for MySQL, Log Service se conecta a la instancia mediante SSL. Sin embargo, no se verifica el certificado del servidor. El certificado del servidor no puede utilizarse para establecer conexiones.
update_time_key
String
No
El campo de tiempo que se utiliza para extraer datos incrementales. Si no configura este parámetro, se extraen todos los datos. Por ejemplo, update_time en update_time_key="update_time" indica el campo de tiempo de actualización de datos en la base de datos. El campo de tiempo admite los siguientes tipos de datos: datetime, timestamp, integer, float y decimal. Asegúrese de que los valores del campo de tiempo aumenten en orden cronológico.
NotaLog Service extrae datos incrementales basándose en el campo de tiempo. Asegúrese de que exista un índice configurado para este campo en la tabla. Si no se configura el índice, se realiza un escaneo completo de la tabla. Además, se reporta un error que indica un fallo en la extracción de datos incrementales.
deleted_flag_key
String
No
Los datos que no necesitan transformarse y se descartan al extraer datos incrementales. Por ejemplo, si el valor de key en update_time_key="key" cumple la siguiente condición, el valor se interpreta como datos eliminados:
-
Boolean: true
-
Datetime y timestamp: no vacío
-
Char y varchar: 1, true, t, yes y y
-
Integer: distinto de cero
Nota-
Debe configurar el parámetro deleted_flag_key junto con el parámetro update_time_key.
-
Si configura el parámetro update_time_key pero no configura el parámetro deleted_flag_key, no se descarta ningún dato durante la extracción de datos incrementales.
connector
String
No
El conector que se utiliza para conectarse remotamente a la base de datos. Valores válidos: mysql y pgsql. Valor predeterminado: mysql.
-
-
Respuesta
Se devuelve una tabla que contiene varias columnas. Las columnas se definen mediante el parámetro fields.
-
Manejo de errores
Si ocurre un error durante la extracción de datos, se reporta el error, pero el trabajo de transformación de datos continúa ejecutándose. Los reintentos se realizan según el valor del parámetro base_retry_back_off. Por ejemplo, el primer intervalo de reintento es de 1 segundo y falla. El segundo intervalo de reintento duplica la duración del primero. El proceso continúa hasta que el intervalo alcanza el valor del parámetro max_retry_back_off. Si el error persiste, los reintentos se realizan según el valor del parámetro max_retry_back_off. Si un reintento tiene éxito, el intervalo de reintento se restablece al valor inicial, que es 1 segundo.
-
Ejemplos
-
Extraer todos los datos
-
Ejemplo 1: Extraer datos de la tabla test_table en la base de datos test_db a intervalos de 300 segundos.
res_rds_mysql( address="rm-uf6wjk5****mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", refresh_interval=300, ) -
Ejemplo 2: Extraer datos de la tabla test_table, excluyendo los registros cuyo valor de status sea delete.
res_rds_mysql( address="rm-uf6wjk5****mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", refresh_interval=300, fetch_exclude_data="'status':'delete'", ) -
Ejemplo 3: Extraer de la tabla test_table los registros cuyo valor de status sea exit.
res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", refresh_interval=300, fetch_include_data="'status':'exit'", ) -
Ejemplo 4: Extraer de la tabla test_table los registros cuyo valor de status sea exit, excluyendo aquellos cuyo valor de name sea aliyun.
res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", refresh_interval=300, fetch_include_data="'status':'exit'", fetch_exclude_data="'name':'aliyun'", ) -
Ejemplo 5: Utilizar el conector pgsql para conectarse a una base de datos Hologres y extraer datos de la tabla test_table.
res_rds_mysql( address="hgpostcn-cn-****-cn-hangzhou.hologres.aliyuncs.com:80", username="test_username", password="****", database="aliyun", table="test_table", connector="pgsql", ) -
Ejemplo 6: Extraer datos utilizando el parámetro primary_keys.
Si configura el parámetro primary_keys, su valor se extrae como clave. Los datos extraídos de la tabla se guardan en la memoria en el formato {"10001":{"userid":"10001","city_name":"beijing","city_number":"12345"}}. En este caso, los datos se extraen a alta velocidad. Si desea extraer un gran volumen de datos, se recomienda utilizar este método. Si no configura el parámetro primary_keys, la función recorre la tabla fila por fila. Luego, la función extrae los datos y los guarda en la memoria en el formato [{"userid":"10001","city_name":"beijing","city_number":"12345"}]. En este escenario, la extracción de datos es más lenta, pero solo se ocupa una pequeña porción de memoria. Si desea extraer un volumen pequeño de datos, se recomienda utilizar este método.
-
Tabla
userid
city_name
city_number
10001
beijing
12345
-
Registro sin procesar
# Data Record 1 userid:10001 gdp:1000 # Data Record 2 userid:10002 gdp:800 -
Regla de transformación
e_table_map( res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", primary_keys="userid", ), "userid", ["city_name", "city_number"], ) -
Resultado
# Data Record 1
userid:10001
gdp:1000
city_name: beijing
city_number:12345
# Data Record 2
userid:10002
gdp:800
-
-
-
Extraer datos incrementales
-
Ejemplo 1: Extraer datos incrementales.
NotaSolo puede extraer datos incrementales de una tabla si se cumplen las siguientes condiciones:
La tabla tiene una clave principal única y un campo de tiempo, como los campos item_id y update_time.
Están configurados los parámetros primary_keys, refresh_interval y update_time_key.
-
Tabla
item_id
item_name
price
1001
Orange
10
1002
Apple
12
1003
Mango
16
-
Registro sin procesar
# Data Record 1 item_id: 1001 total: 100 # Data Record 2 item_id: 1002 total: 200 # Data Record 3 item_id: 1003 total: 300 -
Regla de transformación
e_table_map( res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", primary_key="item_id", refresh_interval=1, update_time_key="update_time", ), "item_id", ["item_name", "price"], ) -
Resultado
# Data Record 1
item_id: 1001
total: 100
item_name: Orange
price:10

# Data Record 2
item_id: 1002
total: 200
item_name: Apple
price:12

# Data Record 3
item_id: 1003
total: 300
item_name: Mango
price:16
-
Ejemplo 2: Configurar el parámetro deleted_flag_key para descartar datos específicos durante la extracción de datos incrementales.
-
Tabla
item_id
item_name
price
update_time
Is_deleted
1001
Orange
10
1603856138
False
1002
Apple
12
1603856140
False
1003
Mango
16
1603856150
False
-
Registro sin procesar
# Data Record 1 item_id: 1001 total: 100 # Data Record 2 item_id: 1002 total: 200 # Data Record 3 item_id: 1003 total: 300 -
Regla de transformación
e_table_map( res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", primary_key="item_id", refresh_interval=1, update_time_key="update_time", deleted_flag_key="is_deleted", ), "item_id", ["item_name", "price"], ) -
Resultado
La función res_rds_mysql extrae tres registros de la tabla hacia la memoria del servidor donde se ejecuta Log Service. Estos registros se comparan con los registros existentes en el logstore de origen para verificar si coinciden. Si desea descartar el registro cuyo item_id es 1001, busque el registro con item_id 1001 en la tabla y cambie el valor del campo Is_deleted a true. De esta manera, el registro 1001 se descartará la próxima vez que se actualice la tabla de dimensiones en memoria.
# Data Record 2
item_id: 1002
total: 200
item_name: Apple
price:12

# Data Record 3
item_id: 1003
total: 300
item_name: Mango
price:1
-
-
-
Referencias
Esta función puede utilizarse junto con otras funciones. Para obtener más información, consulte Enrich data from ApsaraDB RDS for MySQL.
-
Sintaxis
res_log_logstore_pull(endpoint, ak_id, ak_secret, project, logstore, fields, from_time="begin", to_time=None, fetch_include_data=None, fetch_exclude_data=None, primary_keys=None, fetch_interval=2, delete_data=None, base_retry_back_off=1, max_retry_back_off=60, ttl=None, role_arn=None) -
Parámetros
Parámetro
Tipo
Obligatorio
Descripción
endpoint
String
Sí
El endpoint. Para más información, consulte Endpoint. De forma predeterminada, se utiliza un endpoint HTTPS. También puede usar un endpoint HTTP. En casos especiales, es posible que deba utilizar un puerto distinto al 80 o 443.
ak_id
String
Sí
El AccessKey ID de su cuenta de Alibaba Cloud. Para garantizar la seguridad de los datos, se recomienda configurar este parámetro en Advanced Parameter Settings. Para más información sobre cómo configurar los parámetros avanzados, consulte Create a data transformation job.
ak_secret
String
Sí
El AccessKey secret de su cuenta de Alibaba Cloud. Para garantizar la seguridad de los datos, se recomienda configurar este parámetro en Advanced Parameter Settings. Para más información sobre cómo configurar los parámetros avanzados, consulte Create a data transformation job.
project
String
Sí
El nombre del proyecto del cual desea extraer datos.
logstore
String
Sí
El nombre del logstore del cual desea extraer datos.
fields
Lista de cadenas
Sí
La lista de cadenas o la lista de alias de cadenas. Si un registro no contiene un campo especificado, el valor de dicho campo será una cadena vacía. Por ejemplo, si desea cambiar el nombre de la columna name en la lista ["user_id", "province", "city", "name", "age"] a user_name, debe establecer este parámetro en ["user_id", "province", "city", ("name", "user_name"), ("nickname", "nick_name"), "age"].
from_time
String
No
La hora del servidor en la que comienza la primera extracción de datos del logstore. Valor predeterminado: begin. Este valor indica que Log Service comienza a extraer datos desde el primer registro. Se admiten los siguientes formatos de hora:
-
Marca de tiempo UNIX.
-
Cadena de tiempo.
-
Cadena personalizada, como begin o end.
-
Expresión: la hora devuelta por la función dt_. Por ejemplo, la función dt_totimestamp(dt_truncate(dt_today(tz="Asia/Shanghai"), day=op_neg(-1))) devuelve la hora de inicio de la extracción de datos, que corresponde a un día antes de la hora actual. Si la hora actual es 2019-5-5 10:10:10 (UTC+8), la hora devuelta será 2019-5-4 10:10:10 (UTC+8).
to_time
String
No
La hora del servidor en la que finaliza la primera extracción de datos del logstore. Valor predeterminado: None. Este valor indica que Log Service deja de extraer datos en el último registro. Se admiten los siguientes formatos de hora:
-
Marca de tiempo UNIX.
-
Cadena de tiempo.
-
Cadena personalizada, como begin o end.
-
Expresión: la hora devuelta por la función dt_.
Si no configura este parámetro o lo establece en None, los datos se extraen de los registros más recientes de manera continua.
NotaSi establece este parámetro en un momento posterior a la hora actual, solo se extraerán los datos existentes en el logstore. No se extraerán datos nuevos.
fetch_include_data
String
No
La lista de permitidos de campos. Se conservan los registros cuyos campos coinciden con el parámetro fetch_include_data. Los registros cuyos campos no coinciden con este parámetro se descartan.
-
Si no configura este parámetro o lo establece en None, la función de lista de permitidos de campos se deshabilita.
-
Si establece este parámetro en un campo y un valor de campo específicos, se conservan los registros que contienen dicho campo y valor.
fetch_exclude_data
String
No
La lista de bloqueados de campos. Se descartan los registros cuyos campos coinciden con el parámetro fetch_exclude_data. Los registros cuyos campos no coinciden con este parámetro se conservan.
-
Si no configura este parámetro o lo establece en None, la función de lista de bloqueados de campos se deshabilita.
-
Si establece este parámetro en un campo y un valor de campo específicos, se descartan los registros que contienen dicho campo y valor.
NotaSi configura tanto los parámetros de lista de bloqueados como de lista de permitidos, primero se descartan los registros cuyos campos coinciden con la lista de bloqueados y luego se conservan los registros restantes cuyos campos coinciden con la lista de permitidos.
primary_keys
Lista de cadenas
No
La lista de campos de clave principal que se utilizan para mantener una tabla. Si cambia el nombre de un campo de clave principal mediante el parámetro fields, debe usar el nuevo nombre para especificar el campo de clave principal en este parámetro.
Nota-
El valor del parámetro primary_keys solo puede contener las cadenas de valor único especificadas en el valor del parámetro fields.
-
Este parámetro es válido únicamente cuando existe un solo shard en el logstore del cual se extraen los datos.
-
Debe establecer el parámetro primary_keys. De lo contrario, el rendimiento se verá significativamente afectado y podrían producirse retrasos en la tarea.
-
El valor del parámetro primary_keys distingue entre mayúsculas y minúsculas.
fetch_interval
Int
No
El intervalo entre dos solicitudes consecutivas de extracción de datos cuando estos se obtienen de manera continua. Valor predeterminado: 2. Unidad: segundos. El valor debe ser mayor o igual a 1 segundo.
delete_data
String
No
La operación para eliminar datos de la tabla. Se eliminan los registros de datos que cumplen con las condiciones especificadas y contienen el valor de
primary_keys. Para más información, consulte Query string syntax.base_retry_back_off
Number
No
El intervalo en el que el sistema intenta extraer datos nuevamente después de un error de extracción. Valor predeterminado: 1. Unidad: segundos.
max_retry_back_off
Int
No
El intervalo máximo entre dos reintentos consecutivos después de un error de extracción. Valor predeterminado: 60. Unidad: segundos. Se recomienda utilizar el valor predeterminado.
ttl
Int
No
El número de segundos utilizado para determinar el rango de extracción de datos de manera continua. La extracción de datos comienza cuando se generan los datos de registro y finaliza transcurridos los segundos indicados en ttl después de la generación de dichos datos. Unidad: segundos. Valor predeterminado: None. Este valor indica que se extraen todos los datos de registro.
role_arn
String
No
El Alibaba Cloud Resource Name (ARN) del rol de RAM que se utiliza. El rol de RAM debe tener permisos de lectura en el logstore del cual se extraen los datos. En la consola de RAM, puede consultar el ARN de un rol de RAM en la sección Basic Information de la página de detalles del rol. Ejemplo:
acs:ram::137944:role/role-a. Para más información sobre cómo obtener el ARN de un rol de RAM, consulte View a RAM role. -
-
Respuesta
Se devuelve una tabla que contiene varias columnas.
-
Manejo de errores
Si ocurre un error durante la extracción de datos, se notifica el error, pero el trabajo de transformación de datos continúa ejecutándose. Los reintentos se realizan según el valor del parámetro base_retry_back_off. Por ejemplo, si el primer intervalo de reintento es de 1 segundo y falla, el segundo intervalo de reintento será el doble que el primero. Este proceso continúa hasta que el intervalo alcanza el valor del parámetro max_retry_back_off. Si el error persiste, los reintentos se realizan según el valor del parámetro max_retry_back_off. Si un reintento tiene éxito, el intervalo de reintento se restablece al valor inicial, que es 1 segundo.
-
Ejemplos
-
En este ejemplo, se extraen los datos de los campos key1 y key2 del logstore test_logstore del proyecto test_project. La extracción de datos comienza cuando se escriben los datos de registro en el logstore y finaliza al completarse la operación de escritura. Los datos se extraen una sola vez.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LT****Gw", "ab****uu", "test_project", "test_logstore", ["key1", "key2"], from_time="begin", to_time="end", ) -
En este ejemplo, se extraen los datos de los campos key1 y key2 del logstore test_logstore del proyecto test_project. La extracción de datos comienza cuando se escriben los datos de registro en el logstore y finaliza al completarse la operación de escritura. Los datos se extraen de manera continua en intervalos de 30 segundos.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LT****Gw", "ab****uu", "test_project", "test_logstore", ["key1", "key2"], from_time="begin", to_time=None, fetch_interval=30, ) -
En este ejemplo, se configura una lista de bloqueados para omitir los registros de datos que contienen key1:value1 al extraer datos de un logstore.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LT****Gw", "ab****uu", "test_project", "test_logstore", ["key1", "key2"], from_time="begin", to_time=None, fetch_interval=30, fetch_exclude_data="key1:value1", ) -
En este ejemplo, se configura una lista de permitidos para extraer los registros de datos que contienen key1:value1 de un logstore.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LT****Gw", "ab****uu", "test_project", "test_logstore", ["key1", "key2"], from_time="begin", to_time=None, fetch_interval=30, fetch_include_data="key1:value1", ) -
En este ejemplo, se extraen los datos de los campos key1 y key2 del logstore test_logstore del proyecto test_project. La extracción de datos comienza cuando se generan los datos de registro y finaliza 40,000,000 segundos después de la generación de dichos datos.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LTAI*****Cajvr", "qO0Tp*****jJ9", "test_project", "test_logstore", fields=["key1","key2"], ttl="40000000" ) -
En este ejemplo, se extraen los datos de los campos key1 y key2 del logstore test-logstore del proyecto project-test1. Se utiliza el rol vinculado al servicio de Log Service para la autorización. La extracción de datos comienza cuando se escriben los datos de registro en el logstore y finaliza al completarse la operación de escritura. Los datos se extraen una sola vez.
res_log_logstore_pull( "pub-cn-hangzhou-staging-intranet.log.aliyuncs.com", "", "", "project-test1", "test-logstore", ["key1", "key2"], from_time="2022-7-27 10:10:10 8:00", to_time="2022-7-27 14:30:10 8:00", role_arn="acs:ram::***:role/aliyunserviceroleforslsaudit", ) -
En este ejemplo, se extraen los datos de los campos key1 y key2 del logstore test-logstore del proyecto project-test1. Se utiliza un rol predeterminado para la autorización. La extracción de datos comienza cuando se escriben los datos de registro en el logstore y finaliza al completarse la operación de escritura. Los datos se extraen una sola vez.
res_log_logstore_pull(
    "cn-chengdu.log.aliyuncs.com",
    "",
    "",
    "project-test1",
    "test-logstore",
     ["key1", "key2"],
    from_time="2022-7-21 10:10:10 8:00",
    to_time="2022-7-21 10:30:10 8:00",
    role_arn="acs:ram::***:role/aliyunlogetlrole",
)
-
-
Referencias
Esta función puede utilizarse junto con otras funciones. Para más información, consulte Pull data from one Logstore to enrich log data in another Logstore.
-
Sintaxis
res_oss_file(endpoint, ak_id, ak_key, bucket, file, format='text', change_detect_interval=0, base_retry_back_off=1, max_retry_back_off=60, encoding='utf8', error='ignore') -
Parámetros
Parámetro
Tipo
Obligatorio
Descripción
endpoint
String
Sí
El endpoint del bucket de OSS. Para más información, consulte Regions and endpoints. De forma predeterminada, se utiliza un endpoint HTTPS. También puede usar un endpoint HTTP. En casos especiales, es posible que deba utilizar un puerto distinto al 80 o 443.
ak_id
String
Sí
El AccessKey ID de su cuenta de Alibaba Cloud. Para garantizar la seguridad de los datos, se recomienda configurar este parámetro en Advanced Parameter Settings. Para más información sobre cómo configurar los parámetros avanzados, consulte Create a data transformation job.
ak_key
String
Sí
El AccessKey secret de su cuenta de Alibaba Cloud. Para garantizar la seguridad de los datos, se recomienda configurar este parámetro en Advanced Parameter Settings. Para más información sobre cómo configurar los parámetros avanzados, consulte Create a data transformation job.
bucket
String
Sí
El nombre del bucket de OSS del cual desea extraer datos.
file
String
Sí
La ruta al objeto del cual desea extraer datos. Ejemplo: test/data.txt. No introduzca una barra diagonal (/) al inicio de la ruta.
format
String
Sí
El formato del archivo de salida. Valores válidos:
-
Text: formato de texto
-
Binary: formato de flujo de bytes
change_detect_interval
String
No
El intervalo en el que Log Service extrae los datos del objeto de OSS. Unidad: segundos. El sistema comprueba si el objeto se ha actualizado al extraer los datos. Si el objeto se actualizó, se extraen los datos incrementales. Valor predeterminado: 0. Este valor indica que no se extraen datos incrementales. Todos los datos se extraen una sola vez cuando se llama a la función.
base_retry_back_off
Number
No
El intervalo en el que el sistema intenta extraer datos nuevamente después de un error de extracción. Valor predeterminado: 1. Unidad: segundos.
max_retry_back_off
Int
No
El intervalo máximo entre dos reintentos consecutivos después de un error de extracción. Valor predeterminado: 60. Unidad: segundos. Se recomienda utilizar el valor predeterminado.
encoding
String
No
El formato de codificación. Si establece el parámetro format en Text, este parámetro se establece automáticamente en utf8.
error
String
No
El método utilizado para manejar errores. Este parámetro es válido únicamente cuando se reporta el mensaje UnicodeError. Valores válidos:
-
ignore: El sistema omite los datos con formato no válido y continúa codificando los datos.
-
xmlcharrefreplace: El sistema utiliza referencias de caracteres XML apropiadas para reemplazar los caracteres que no pueden codificarse.
Para más información, consulte Error Handlers.
decompress
String
No
Especifica si se debe descomprimir el objeto. Valores válidos:
-
None: El objeto no se descomprime. Este es el valor predeterminado.
-
gzip: El objeto se descomprime mediante gzip.
-
-
Respuesta
Los datos del objeto se devuelven en formato de flujo de bytes o de texto.
-
Manejo de errores
Si ocurre un error durante la extracción de datos, se notifica el error, pero el trabajo de transformación de datos continúa ejecutándose. Los reintentos se realizan según el valor del parámetro base_retry_back_off. Por ejemplo, si el primer intervalo de reintento es de 1 segundo y falla, el segundo intervalo de reintento será el doble que el primero. Este proceso continúa hasta que el intervalo alcanza el valor del parámetro max_retry_back_off. Si el error persiste, los reintentos se realizan según el valor del parámetro max_retry_back_off. Si un reintento tiene éxito, el intervalo de reintento se restablece al valor inicial, que es 1 segundo.
-
Ejemplos
-
Ejemplo 1: Extraer datos JSON de OSS.
-
Datos JSON
{ "users": [ { "name": "user1", "login_historys": [ { "date": "2019-10-10 0:0:0", "login_ip": "203.0.113.10" }, { "date": "2019-10-10 1:0:0", "login_ip": "203.0.113.10" } ] }, { "name": "user2", "login_historys": [ { "date": "2019-10-11 0:0:0", "login_ip": "203.0.113.20" }, { "date": "2019-10-11 1:0:0", "login_ip": "203.0.113.30" }, { "date": "2019-10-11 1:1:0", "login_ip": "203.0.113.50" } ] } ] } -
Registro sin procesar
content: 123 -
Regla de transformación
e_set( "json_parse", json_parse( res_oss_file( endpoint="http://oss-cn-hangzhou.aliyuncs.com", ak_id="LT****Gw", ak_key="ab****uu", bucket="log-etl-staging", file="testjson.json", ) ), ) -
Resultado
content: 123
    prjson_parse:
'{
  "users": [
    {
        "name": "user1",
        "login_historys": [
          {
            "date": "2019-10-10 0:0:0",
            "login_ip": "203.0.113.10"
          },
          {
            "date": "2019-10-10 1:0:0",
            "login_ip": "203.0.113.10"
          }
        ]
    },
    {
        "name": "user2",
        "login_historys": [
          {
            "date": "2019-10-11 0:0:0",
            "login_ip": "203.0.113.20"
          },
          {
            "date": "2019-10-11 1:0:0",
            "login_ip": "203.0.113.30"
          },
          {
            "date": "2019-10-11 1:1:0",
            "login_ip": "203.0.113.50"
          }
        ]
    }
  ]
}'
-
-
Ejemplo 2: Extraer contenido de texto de OSS.
-
Contenido de texto
Test bytes -
Registro sin procesar
content: 123 -
Regla de transformación
e_set( "test_txt", res_oss_file( endpoint="http://oss-cn-hangzhou.aliyuncs.com", ak_id="LT****Gw", ak_key="ab****uu", bucket="log-etl-staging", file="test.txt", ), ) -
Resultado
content: 123
test_txt: Test bytes
-
-
Ejemplo 3: Extraer datos de un objeto comprimido de OSS y descomprimir el objeto.
-
Contenido del objeto comprimido
Test bytes\nupdate\n123 -
Registro sin procesar
content:123 -
Regla de transformación
e_set( "text", res_oss_file( endpoint="http://oss-cn-hangzhou.aliyuncs.com", ak_id="LT****Gw", ak_key="ab****uu", bucket="log-etl-staging", file="test.txt.gz", format="binary", change_detect_interval=30, decompress="gzip", ), ) -
Resultado
content:123
text: Test bytes\nupdate\n123
-
-
Ejemplo 4: Acceder a un objeto en un bucket de OSS cuya ACL es public-read-write. No se utilizan pares de AccessKey.
-
Contenido del objeto comprimido
Test bytes -
Registro sin procesar
content:123 -
Regla de transformación
e_set( "test_txt", res_oss_file( endpoint="http://oss-cn-hangzhou.aliyuncs.com", bucket="log-etl-staging", file="test.txt", ), ) -
Resultado
content: 123
test_txt: Test bytes
-
-
-
Referencias
Esta función puede utilizarse junto con otras funciones. Para más información, consulte Pull a CSV file from OSS to enrich data.
res_log_logstore_pull
La función res_log_logstore_pull extrae datos de otro logstore durante la transformación de datos en un logstore.
res_oss_file
La función res_oss_file extrae datos de un objeto en un bucket de OSS especificado. Los datos pueden actualizarse a intervalos regulares.
NotaSe recomienda utilizar un proyecto de Log Service que se encuentre en la misma región que el bucket de OSS. De esta manera, los datos del objeto en el bucket pueden extraerse a través de la red interna de Alibaba Cloud. Una red interna es estable y rápida.
-