Simple Log Service (SLS) admite el consumo basado en reglas, que utiliza instrucciones SPL del lado del servidor para preprocesar los datos de registro antes de entregarlos a su consumidor.
Funcionamiento
El consumo basado en reglas aplica instrucciones SPL del lado del servidor para preprocesar datos de registro semiestructurados. Esto incluye filtrado de filas, eliminación de columnas, extracción mediante expresiones regulares y extracción de campos JSON. Posteriormente, entrega datos limpios y estructurados a su cliente. SPL syntax.
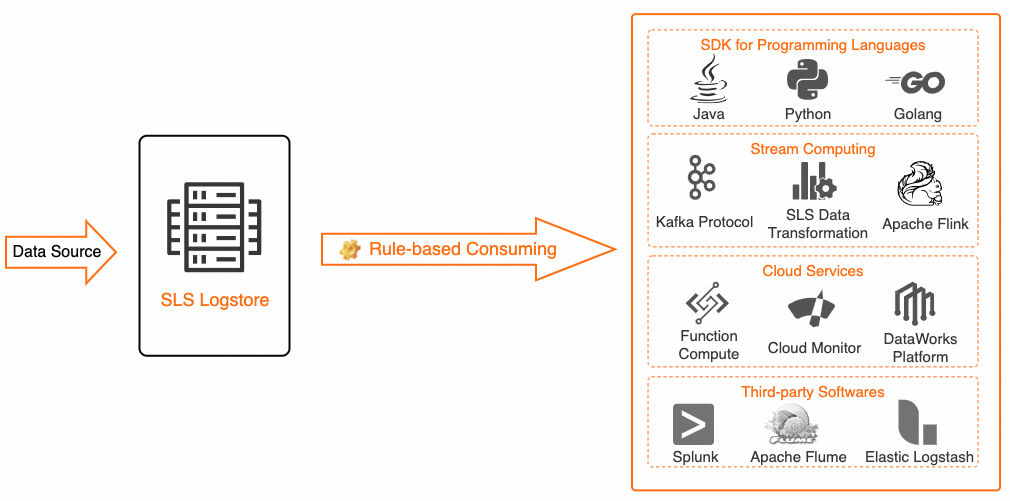
Tanto el consumo basado en reglas como la consulta y el análisis leen datos. Differences between log consumption and log query.
Casos de uso
El consumo basado en reglas es adecuado para escenarios de cómputo de flujos y en tiempo real que requieren preprocesamiento de datos antes del consumo, como filtrado de filas, eliminación de columnas o extracción mediante expresiones regulares y rutas JSON. Ofrece baja latencia, generalmente de unos pocos segundos, y admite periodos de retención de datos personalizados.
Beneficios
-
Menores costos de tráfico de Internet.
El filtrado del lado del servidor elimina los datos innecesarios antes de la transmisión, lo que reduce el tráfico de red.
-
Ahorro de recursos locales de CPU y aceleración del procesamiento.
Descarga los cálculos complejos a SLS, libera recursos locales y acelera el flujo de trabajo general.
Facturación
Si su logstore utiliza el modo de facturación por datos ingeridos, el consumo basado en reglas no tiene costo. Sin embargo, extraer datos desde un endpoint público de SLS genera cargos por tráfico de lectura de Internet según el tamaño de los datos comprimidos. Billable items of the pay-by-ingested-data mode.
Si su logstore utiliza el modo de facturación por función, se le cobrará por el cómputo del lado del servidor y también podría incurrir en cargos por tráfico de Internet al usar un endpoint público de SLS. Billable items of the pay-by-feature mode.
Consumidores
La siguiente tabla enumera los consumidores compatibles.
|
Tipo |
Consumidor |
Descripción |
|
Aplicaciones multilenguaje |
Aplicaciones multilenguaje |
Las aplicaciones Java, Python y Go pueden consumir datos de SLS mediante un grupo de consumidores basado en reglas. Consume data by using an API y Consume logs by using a consumer group. Mejor práctica: Use an SDK to consume logs based on a consumption processor (SPL) |
|
Servicio en la nube |
Realtime Compute for Apache Flink |
Realtime Compute for Apache Flink puede consumir datos de SLS en tiempo real. Simple Log Service. Mejores prácticas: |
|
Cómputo de flujos |
Kafka |
Para solicitar esta integración, envíe un ticket. |
Notas de uso
El procesamiento SPL del lado del servidor puede añadir entre 10 y 100 ms de latencia de lectura por cada 5 MB, según la complejidad de la consulta y las características de los datos. No obstante, la latencia de extremo a extremo —desde la extracción de datos hasta la finalización del cálculo local— suele ser menor.
Los errores de sintaxis SPL o la ausencia de campos de origen pueden provocar resultados incompletos o fallos. Error handling.
La longitud máxima de una instrucción SPL es de 4 KB.
Los límites de lectura de shards son los mismos para el consumo basado en reglas y el consumo regular. El tráfico de lectura se calcula según el tamaño de los datos sin procesar antes del procesamiento SPL. Data reads and writes.
Preguntas frecuentes
-
¿Cómo resuelvo el error
ShardReadQuotaExceeddurante el consumo basado en reglas?-
Solución:
Configure su cliente consumidor para esperar y reintentar cuando ocurra este error.
Divida manualmente el shard para reducir la velocidad de lectura por shard para los nuevos datos.
-
-
¿Cómo se limita el tráfico para el consumo basado en reglas?
-
La directiva de limitación es la misma que para el consumo regular. El tráfico se calcula según el tamaño de los datos sin procesar antes del procesamiento SPL. Data reads and writes.
Por ejemplo, si los datos sin procesar comprimidos tienen 100 MB y la instrucción SPL
* | where method = 'POST'devuelve 20 MB al cliente, el tráfico de lectura se sigue calculando con base en los 100 MB originales.
-
-
¿Por qué es bajo el tráfico de salida en el gráfico Tráfico/min de la página Project Monitoring después de habilitar el consumo basado en reglas?
El gráfico Tráfico/min muestra el tamaño de los datos después del procesamiento SPL. Si su instrucción SPL filtra filas o elimina columnas, el flujo de salida será menor que el de entrada.