Sintaxis y ejemplos de las funciones matemáticas y estadísticas en Simple Log Service.
SLS admite las siguientes funciones matemáticas y estadísticas.
Si desea utilizar cadenas en instrucciones analíticas, debe encerrarlas entre comillas simples (''). Las cadenas sin comillas o las encerradas entre comillas dobles ("") indican nombres de campo o de columna. Por ejemplo, 'status' indica la cadena status, mientras que status o "status" indica el campo de registro status.
|
Categoría |
Función |
Sintaxis |
Descripción |
SQL |
SPL |
|
Funciones de correlación |
corr(x, y) |
Devuelve el coeficiente de correlación entre x y y. El valor devuelto se encuentra en el rango [-1, 1]. |
√ |
× |
|
|
Funciones de varianza y desviación estándar |
covar_pop(x, y) |
Devuelve la covarianza poblacional de x y y. |
√ |
× |
|
|
covar_samp(x, y) |
Devuelve la covarianza muestral de x y y. |
√ |
× |
||
|
stddev(x) |
Devuelve la desviación estándar muestral de x. Esta función es un alias de la función |
√ |
× |
||
|
stddev_samp(x) |
Devuelve la desviación estándar muestral de x. |
√ |
× |
||
|
stddev_pop(x) |
Devuelve la desviación estándar poblacional de x. |
√ |
× |
||
|
variance(x) |
Devuelve la varianza muestral de x. Alias de la función |
√ |
× |
||
|
var_samp(x) |
Devuelve la varianza muestral de x. |
√ |
× |
||
|
var_pop(x) |
Devuelve la varianza poblacional de x. |
√ |
× |
||
|
Funciones de regresión lineal |
regr_intercept(y, x) |
Ajusta una ecuación lineal a los puntos de entrada |
√ |
× |
|
|
regr_slope(y, x) |
Ajusta una ecuación lineal al punto de entrada |
√ |
× |
||
|
Funciones de distribución acumulativa (CDF) |
beta_cdf(α, β, v) |
Calcula la función de distribución acumulativa (CDF) de la distribución beta, P(N <= v; α, β), donde α y β son los parámetros de forma. |
√ |
× |
|
|
binomial_cdf(x, y, v) |
Calcula la función de distribución acumulativa (CDF) de la distribución binomial, P(N <= v), donde x es el número de ensayos e y es la probabilidad de éxito en cada ensayo. |
√ |
× |
||
|
cauchy_cdf(x, y, v) |
Calcula la función de distribución acumulativa (CDF) de la distribución de Cauchy, P(N <= v; x, y), donde x es el parámetro de ubicación (posición del pico) e y es el parámetro de escala. |
√ |
× |
||
|
chi_squared_cdf(k, v) |
Calcula la función de distribución acumulativa (CDF) de la distribución chi-cuadrado, P(N <= v; k), donde k representa los grados de libertad. |
√ |
× |
||
|
inverse_beta_cdf(α, β, p) |
Para una probabilidad p dada, calcula el valor v tal que P(N <= v; α, β) = p. |
√ |
× |
||
|
inverse_binomial_cdf(x, y, p) |
Para una probabilidad p dada, calcula el valor v tal que P(N <= v) = p. |
√ |
× |
||
|
inverse_cauchy_cdf(x, y, p) |
Para una probabilidad p dada, calcula el valor v tal que P(N <= v; x, y) = p. |
√ |
× |
||
|
inverse_chi_squared_cdf(k, p) |
Para una probabilidad p dada, calcula el valor v tal que P(N <= v; k) = p. |
√ |
× |
||
|
inverse_laplace_cdf(μ, b, p) |
Para una probabilidad p dada, calcula el valor v tal que P(N <= v; μ, b) = p. |
√ |
× |
||
|
inverse_normal_cdf(x, y, p) |
Para una probabilidad p dada, calcula el valor v tal que P(N <= v; x, y) = p. |
√ |
× |
||
|
inverse_poisson_cdf(x, y, p) |
Para una probabilidad p dada, calcula el valor v tal que P(N <= v; λ) = p. |
√ |
× |
||
|
inverse_weibull_cdf(x, y, p) |
Para una probabilidad p dada, calcula el valor v tal que P(N <= v; x, y) = p. |
√ |
× |
||
|
laplace_cdf(μ, b, v) |
Calcula la función de distribución acumulativa (CDF) de la distribución de Laplace, P(N <= v; μ, b), donde μ es el parámetro de ubicación y b es el parámetro de escala. |
√ |
× |
||
|
normal_cdf(x, y, v) |
Calcula la función de distribución acumulativa (CDF) de la distribución normal, P(N <= v; x, y), donde x es la media e y es la desviación estándar. |
√ |
× |
||
|
poisson_cdf(λ, v) |
Calcula la función de distribución acumulativa (CDF) de la distribución de Poisson, P(N <= v; λ), donde λ es la tasa promedio de eventos. |
√ |
× |
||
|
weibull_cdf(x, y, v) |
Calcula la función de distribución acumulativa (CDF) de la distribución de Weibull, P(N <= v; x, y), donde x es el parámetro de escala e y es el parámetro de forma. |
√ |
× |
Función corr
Devuelve el coeficiente de correlación entre x y y. Los valores más altos indican una correlación más fuerte.
-
Sintaxis
corr(x, y) -
Parámetros
Parámetro
Descripción
x
Un valor double.
y
Un valor double.
-
Tipo de valor devuelto
Un valor double en el rango [0, 1].
-
Ejemplos
Calcula el coeficiente de correlación entre los campos request_length y request_time.
-
Instrucción de consulta
* | SELECT corr(request_length,request_time) El coeficiente de correlación entre
request_lengthyrequest_timees0.0008096234574114261.
-
Función covar_pop
Calcula la covarianza poblacional de x y y.
-
Sintaxis
covar_pop(x, y) -
Parámetros
Parámetro
Descripción
x
Un valor double.
y
Un valor double.
-
Tipo de valor devuelto
Un valor double.
-
Ejemplos
Calcula la covarianza poblacional de las ganancias antes de impuestos y la facturación antes de impuestos por minuto.
-
Instrucción de consulta
*|
SELECT
  covar_pop(PretaxGrossAmount, PretaxAmount) AS "population covariance",
  time_series(__time__, '1m', '%H:%i:%s', '0') AS time
GROUP BY
  time
La consulta devuelve dos filas. Los valores de population covariance son 4.402252063414699 y 2.2477524300733857, y los valores de time son 04:24:00 y 04:47:00, respectivamente.
-
Función covar_samp
Calcula la covarianza muestral de x y y.
-
Sintaxis
covar_samp(x, y) -
Parámetros
Parámetro
Descripción
x
Un valor double.
y
Un valor double.
-
Tipo de valor devuelto
Un valor double.
-
Ejemplos
Calcula la covarianza muestral de las ganancias antes de impuestos y la facturación antes de impuestos por minuto.
-
Instrucción de consulta
*|
SELECT
  covar_samp(PretaxGrossAmount, PretaxAmount) AS "Sample covariance",
  time_series(__time__, '1m', '%H:%i:%s', '0') AS time
GROUP BY
  time
La consulta devuelve dos filas. La Sample covariance es 2.2910940581194376 cuando
timees 15:50:00, y 4.721554417070316 cuandotimees 15:49:00.
-
Función stddev
Devuelve la desviación estándar muestral de x. Es un alias de la función stddev_samp.
-
Sintaxis
stddev(x) -
Parámetros
Parámetro
Descripción
x
Un valor double o bigint.
-
Tipo de valor devuelto
Devuelve un valor double.
-
Ejemplos
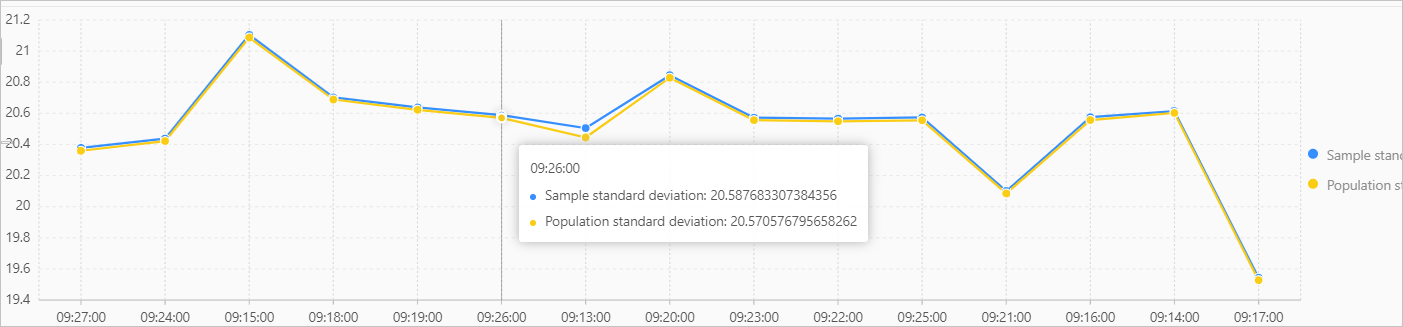
Calcula las desviaciones estándar muestral y poblacional de los ingresos antes de impuestos y muestra los resultados en un gráfico de líneas.
-
Instrucción de consulta
* |
SELECT
  stddev(PretaxGrossAmount) as "Sample standard deviation",
  stddev_pop(PretaxGrossAmount) as "Population standard deviation",
  time_series(__time__, '1m', '%H:%i:%s', '0') AS time
GROUP BY
  time
Resultados de la consulta y el análisis
-
Función stddev_samp
Calcula la desviación estándar muestral de x.
-
Sintaxis
stddev_samp(x) -
Parámetros
Parámetro
Descripción
x
Un valor double o bigint.
-
Tipo de valor devuelto
Un valor double.
-
Ejemplos
Calcula las desviaciones estándar muestral y poblacional de los ingresos antes de impuestos y muestra los resultados en un gráfico de líneas.
-
Instrucción de consulta
* |
SELECT
  stddev_samp(PretaxGrossAmount) as "Sample standard deviation",
  stddev_pop(PretaxGrossAmount) as "Population standard deviation",
  time_series(__time__, '1m', '%H:%i:%s', '0') AS time
GROUP BY
  time
Resultados de la consulta y el análisis
-
Función stddev_pop
Calcula la desviación estándar poblacional de x.
-
Sintaxis
stddev_pop(x) -
Parámetros
Parámetro
Descripción
x
Un valor double o bigint.
-
Tipo de valor devuelto
Un valor double.
-
Ejemplos
Calcula las desviaciones estándar muestral y poblacional de los ingresos antes de impuestos y muestra los resultados en un gráfico de líneas.
-
Instrucción de consulta
* |
SELECT
  stddev(PretaxGrossAmount) as "Sample standard deviation",
  stddev_pop(PretaxGrossAmount) as "Population standard deviation",
  time_series(__time__, '1m', '%H:%i:%s', '0') AS time
GROUP BY
  time
Resultados de la consulta
-
Función variance
Devuelve la varianza muestral de x. Esta función es un alias de la función var_samp.
-
Sintaxis
variance(x) -
Parámetros
Parámetro
Descripción
x
Un valor double o bigint.
-
Tipo de valor devuelto
Un valor double.
-
Ejemplos
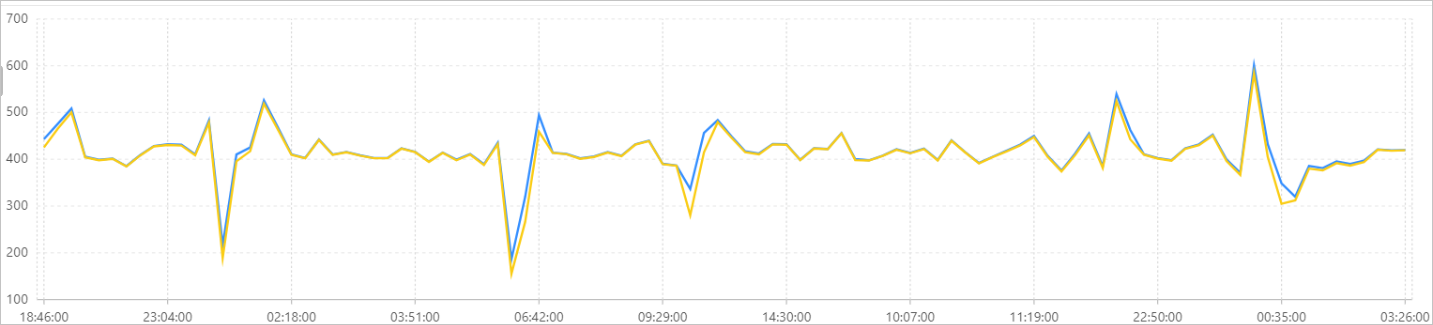
Calcula la varianza muestral y poblacional de los ingresos antes de impuestos y muestra los resultados en un gráfico de líneas.
-
Instrucción de consulta
* |
SELECT
  variance(PretaxGrossAmount) as "Sample variance",
  var_pop(PretaxGrossAmount) as "Population variance",
  time_series(__time__, '1m', '%H:%i:%s', '0') as time
GROUP BY
  time
Resultados de la consulta y el análisis
-
Función var_samp
Calcula la varianza muestral de x.
-
Sintaxis
var_samp(x) -
Parámetros
Parámetro
Descripción
x
Un valor double o bigint.
-
Tipo de valor devuelto
Devuelve un valor double.
-
Ejemplos
Calcula la varianza muestral y poblacional de los ingresos antes de impuestos y muestra los resultados en un gráfico de líneas.
-
Instrucción de consulta y análisis
* |
SELECT
  var_samp(PretaxGrossAmount) as "Sample variance",
  var_pop(PretaxGrossAmount) as "Population variance",
  time_series(__time__, '1m', '%H:%i:%s', '0') as time
GROUP BY
  time
Resultados de la consulta y el análisis
-
Función var_pop
Devuelve la varianza poblacional de x.
-
Sintaxis
var_pop(x) -
Parámetros
Parámetro
Descripción
x
Un valor double o bigint.
-
Tipo de valor devuelto
Un valor double.
-
Ejemplos
Calcula la varianza muestral y poblacional de los ingresos antes de impuestos y muestra los resultados en un gráfico de líneas.
-
Instrucción de consulta
* |
SELECT
  variance(PretaxGrossAmount) as "Sample variance",
  var_pop(PretaxGrossAmount) as "Population variance",
  time_series(__time__, '1m', '%H:%i:%s', '0') as time
GROUP BY
  time
Resultados de la consulta y el análisis
-
Función regr_intercept
Ajusta una ecuación lineal a un conjunto de pares de entrada (x,y) y devuelve la intersección con el eje y de la recta de regresión resultante. y es el valor dependiente y x es el valor independiente.
-
Sintaxis
regr_intercept(y, x) -
Parámetros
Parámetro
Descripción
y
Un valor double.
x
Un valor double.
-
Tipo de valor devuelto
Devuelve un valor double.
-
Ejemplos
Calcula la intersección con el eje y de la recta de regresión a partir de los campos request_time y request_length.
-
Instrucción de consulta
* | SELECT regr_intercept(request_length,request_time) Resultados de la consulta: El valor en la columna _col0 es
4128.22910642988.
-
Función regr_slope
Ajusta una ecuación lineal a los pares de entrada (x,y) y devuelve la pendiente de la recta de regresión. y es el valor dependiente y x es el valor independiente.
-
Sintaxis
regr_slope(y, x) -
Parámetros
Parámetro
Descripción
y
El valor dependiente. Un valor double.
x
El valor independiente. Un valor double.
-
Tipo de valor devuelto
Devuelve un valor double.
-
Ejemplos
Calcula la pendiente de la recta de regresión a partir de los campos request_time y request_length.
-
Instrucción de consulta
* | SELECT regr_slope(request_length,request_time) El resultado de la consulta es
1.9022724330993215.
-
Función beta_cdf
Calcula la CDF de la distribución beta.
-
Sintaxis
beta_cdf(α, β, v) -
Parámetros
Parámetro
Descripción
α
Un parámetro de la
beta distribution. El valor debe ser de tipodoubley mayor que 0.β
Un parámetro de la
beta distribution. El valor debe ser de tipodoubley mayor que 0.v
El valor en el que se evalúa la
cumulative distribution function. El valor debe ser de tipodoubleen el rango [0, 1]. -
Tipo de valor devuelto
double -
Ejemplos
-
Instrucción de consulta
* | SELECT beta_cdf(0.1, 0.5, 0.7) Resultados de la consulta y el análisis:
0.8926585878364057
-
Función binomial_cdf
Calcula la función de distribución acumulativa de la distribución binomial.
-
Sintaxis
binomial_cdf(x, y, v) -
Parámetros
Parámetro
Descripción
x
El número de ensayos. Debe ser un entero positivo.
y
La probabilidad de éxito en cada ensayo. Debe ser un valor double en el rango [0, 1].
v
El número de éxitos. Debe ser un entero.
-
Tipo de valor devuelto
Devuelve un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select binomial_cdf(10, 0.1, 1) La consulta devuelve
0.7360989291000001.
-
Función cauchy_cdf
Calcula la CDF de la distribución de Cauchy.
-
Sintaxis
cauchy_cdf(x, y, v) -
Parámetros
Parámetro
Descripción
x
El parámetro de ubicación, un valor double que define el pico de la distribución.
y
El parámetro de escala, que debe ser un valor double mayor que 0.
v
Un valor double en el que se evalúa la función de distribución acumulativa.
-
Tipo de valor devuelto
Devuelve un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select cauchy_cdf(-10, 5, -12) La consulta devuelve
0.3788810584091566.
-
Función chi_squared_cdf
Calcula la CDF de la distribución chi-cuadrado.
-
Sintaxis
chi_squared_cdf(k, v) -
Parámetros
Parámetro
Descripción
k
Los grados de libertad para la distribución chi-cuadrado. Debe ser un valor double mayor que 0.
v
El valor en el que se evalúa la función de distribución acumulada. Debe ser un valor double mayor o igual que 0.
-
Tipo de valor de retorno
Un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select chi_squared_cdf(3, 10) Resultado:
0.9814338645369567.
-
Función inverse_beta_cdf
Calcula la CDF inversa de la distribución beta.
-
Sintaxis
inverse_beta_cdf(α, β, p) -
Parámetros
Parámetro
Descripción
α
Un parámetro de forma para la distribución beta. El valor debe ser de tipo double y mayor que 0.
β
Un parámetro de forma para la distribución beta. El valor debe ser de tipo double y mayor que 0.
p
La probabilidad de entrada para la función de distribución acumulada inversa. El valor debe ser de tipo double en el rango [0, 1].
-
Tipo de valor de retorno
Devuelve un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select inverse_beta_cdf(0.1, 0.5, 0.8926585878364057) Resultado de la consulta y el análisis: El valor de
_col0es0.699999999279748.
-
Función inverse_binomial_cdf
Calcula la CDF inversa de la distribución binomial.
-
Sintaxis
inverse_binomial_cdf(x, y, p) -
Parámetros
Parámetro
Descripción
x
El número de ensayos, un entero positivo.
y
La probabilidad de éxito para cada ensayo, un valor double en el rango [0, 1].
p
La probabilidad objetivo, un valor double en el rango [0, 1].
-
Tipo de valor de retorno
Devuelve un entero.
-
Ejemplos
-
Instrucción de consulta
* | select inverse_binomial_cdf(10, 0.1, 0.7360989291000001) El resultado de la consulta y el análisis es
1.
-
Función inverse_cauchy_cdf
Calcula la CDF inversa de la distribución de Cauchy.
-
Sintaxis
inverse_cauchy_cdf(x, y, p) -
Parámetros
Parámetro
Descripción
x
El parámetro de ubicación, un
doubleque especifica el pico de la distribución.y
El parámetro de escala, un
doublemayor que 0.p
La probabilidad de entrada, un
doubleen el rango [0, 1]. -
Tipo de valor de retorno
Devuelve un valor
double. -
Ejemplos
-
Instrucción de consulta
* | select inverse_cauchy_cdf(-10, 5, 0.3788810584091566) Resultados de la consulta y el análisis: El valor de la columna
_col0es-12.0.
-
Función inverse_chi_squared_cdf
Calcula la CDF inversa de la distribución chi-cuadrado.
-
Sintaxis
inverse_chi_squared_cdf(k, p) -
Parámetros
Parámetro
Descripción
k
Los grados de libertad para la distribución chi-cuadrado. Debe ser un valor double positivo.
p
La probabilidad utilizada para calcular el valor inverso. Debe ser un valor double en el rango [0, 1].
-
Tipo de valor de retorno
Devuelve un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select inverse_chi_squared_cdf(3, 0.9814338645369567) El resultado de la consulta y el análisis es
9.999999999835746.
-
Función inverse_laplace_cdf
Devuelve la CDF inversa de la distribución de Laplace.
-
Sintaxis
inverse_laplace_cdf(μ, b, p) -
Parámetros
Parámetro
Descripción
μ
El parámetro de ubicación para la distribución de Laplace. Debe ser un valor double.
b
El parámetro de escala para la distribución de Laplace. Debe ser un valor double positivo.
p
La probabilidad acumulada. Debe ser un valor double en el rango [0, 1].
-
Tipo de valor de retorno
Devuelve un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select inverse_laplace_cdf(11, 0.5, 0.18393972058572118) Resultados de la consulta y el análisis: La columna _col0 muestra el valor devuelto
10.5.
-
Función inverse_normal_cdf
Calcula la CDF inversa de la distribución normal.
-
Sintaxis
inverse_normal_cdf(x, y, p) -
Parámetros
Parámetro
Descripción
x
La media de la distribución normal. El valor debe ser de tipo double.
y
La desviación estándar de la distribución normal. El valor debe ser un valor double positivo.
p
La probabilidad acumulada. El valor debe ser de tipo double en el rango (0, 1).
-
Tipo de valor de retorno
Devuelve un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select inverse_normal_cdf(85, 10, 0.06680720126885803) Resultado de la consulta:
70.0.
-
Función inverse_poisson_cdf
Calcula la CDF inversa de la distribución de Poisson.
-
Sintaxis
inverse_poisson_cdf(λ, p) -
Parámetros
Parámetro
Descripción
λ
La tasa promedio con la que ocurre un evento aleatorio.
p
La probabilidad acumulada, un valor double en el rango [0, 1].
-
Tipo de valor de retorno
Un entero.
-
Ejemplos
-
Instrucción de consulta
* | select inverse_poisson_cdf(0.1, 0.9953211598395556) El resultado de la consulta y el análisis es
1.
-
Función inverse_weibull_cdf
Calcula la CDF inversa de la distribución de Weibull.
-
Sintaxis
inverse_weibull_cdf(x, y, p) -
Parámetros
Parámetro
Descripción
x
El parámetro de escala de la distribución de Weibull. El valor debe ser de tipo double y mayor que 0.
y
El parámetro de forma de la distribución de Weibull. El valor debe ser de tipo double y mayor que 0.
p
La probabilidad de entrada. El valor debe ser de tipo double y estar en el rango [0, 1].
-
Tipo de valor de retorno
Un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select inverse_weibull_cdf(1, 5, 0.3296799539643607) El resultado de la consulta y el análisis es
1.9999999999999998.
-
Función laplace_cdf
Calcula la CDF de la distribución de Laplace.
-
Sintaxis
laplace_cdf(μ, b, v) -
Parámetros
Parámetro
Descripción
μ
El parámetro de ubicación de la distribución de Laplace. Debe ser un valor double.
b
El parámetro de escala de la distribución de Laplace. Debe ser un valor double positivo.
v
El valor en el que se evalúa la función de distribución acumulada. Debe ser un valor double.
-
Tipo de valor de retorno
Un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select laplace_cdf(11, 0.5, 10.5) El resultado de la consulta y el análisis es
0.18393972058572118.
-
Función normal_cdf
Calcula la CDF de la distribución normal.
-
Sintaxis
normal_cdf(x, y, v) -
Parámetros
Parámetro
Descripción
x
La media de la distribución normal, un valor double.
y
La desviación estándar de la distribución normal, un valor double positivo.
v
El valor en el que se evalúa la función, un valor double.
-
Tipo de valor de retorno
Devuelve un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select normal_cdf(85, 10, 70) El resultado de la consulta y el análisis es
0.06680720126885803.
-
Función poisson_cdf
Calcula la CDF de la distribución de Poisson.
-
Sintaxis
poisson_cdf(λ, v) -
Parámetros
Parámetro
Descripción
λ
La tasa promedio de eventos.
v
El valor a evaluar. Debe ser un entero mayor o igual que 0.
-
Tipo de valor de retorno
Un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select poisson_cdf(0.1, 1) Resultado de la consulta:
0.99532115983955556.
-
Función weibull_cdf
Calcula la CDF de la distribución de Weibull.
-
Sintaxis
weibull_cdf(x, y, v) -
Parámetros
Parámetro
Descripción
x
El parámetro de escala. Este valor debe ser un valor double mayor que 0.
y
El parámetro de forma. Este valor debe ser un valor double mayor que 0.
v
El valor de entrada para la función. Este valor debe ser de tipo double.
-
Tipo de valor de retorno
Devuelve un valor double.
-
Ejemplos
-
Instrucción de consulta
* | select weibull_cdf(1, 5, 2) El resultado es
0.3296799539643607.
-